


Sensitive Data Protection には、データの検査、変換(匿名化)、検出、分類に使用できる、さまざまなタイプのメソッドが含まれています。これらのメソッドを使用すると、 Google Cloud の内外でデータをスキャンし、さまざまなタイプのワークロードに対して Sensitive Data Protection の動作を最適化できます。
Sensitive Data Protection には次のメソッドタイプがあります。
検査と匿名化の方法
このセクションでは、検査構成に記載されている情報タイプに一致する各データを特定し、必要に応じて匿名化するために使用できる方法について説明します。
コンテンツ メソッド
コンテンツ メソッドは同期型のステートレス メソッドです。検査または変換されるデータは、リクエストで直接 DLP API に送信されます。Sensitive Data Protection の検査結果または変換されたデータが API レスポンスで返されます。リクエスト データは暗号化されて転送され、保存されません。

コンテンツ メソッドを使用するタイミング
一般的なユースケースは次のとおりです。
- ユーザー入力をリアルタイムで検査する: データベースにデータを保存する前に、ウェブ アプリケーションとモバイル アプリケーション内でフォーム フィールド、チャット メッセージ、フィードバック送信を同期的にスキャンします。
- 外部処理の前に機密テキストをマスクする: コンテンツをサードパーティの API または大規模言語モデル(LLM)に渡す前に、テキスト文字列から機密トークンを同期的に匿名化または秘匿化します。
- アップロードされた画像からセンシティブ データを削除する: 画像形式(JPEG、PNG、TIFF など)内の機密テキストを、検出された個人情報(PII)に不透明な長方形を重ねて、画像を保存または表示する前に難読化します。
- トークン化されたデータをオンデマンドで再識別する: 認証されたビジネス ユーザーが元の平文へのアクセスを必要とする場合、承認されたサーバーサイド ワークフローで、以前に仮名化されたトークンをトークン化解除します。
- クライアントサイド アプリケーションでデータ プライバシーを検証する: クラウド ストレージ リポジトリをプロビジョニングしたり、バックエンド ジョブ インフラストラクチャを構成したりすることなく、エンドポイントでステートレス プライバシー チェックを実行します。
詳細については、コンテンツ メソッドの REST API リファレンスをご覧ください。
ストレージ メソッド
ストレージ メソッドは、Cloud Storage、BigQuery、Datastore モードの Firestore(Datastore)などのシステムで Google Cloud に保存されたデータを検査するように設計されています。ストレージ検査を有効にするには、dlpJobs リソースを使用して Sensitive Data Protection ジョブを作成します。各ジョブはマネージド サービスとして実行され、データを検査してから、検出結果の保存や公開などのSensitive Data Protection アクションを実行します。これらのオプションのアクションに加えて、Sensitive Data Protection は、ジョブのステータス、スキャンしたバイト数、infoType ごとの検出結果の概要など、ジョブの詳細を作成して保存します。Google Cloud コンソールの DLP API または Sensitive Data Protection を使用してジョブを管理できます。
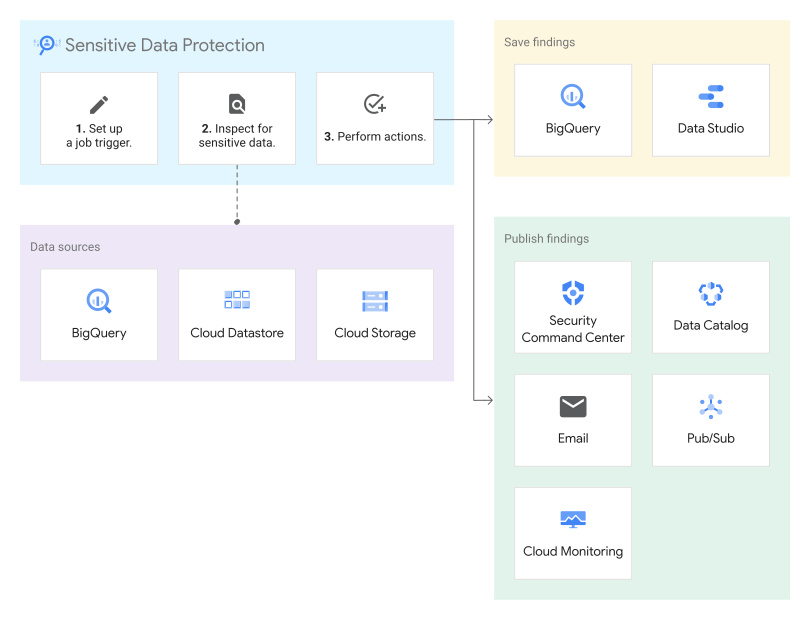
ストレージ メソッドを使用するタイミング
一般的なユースケースは次のとおりです。
- 大規模な分析テーブルをスキャンする: 分散型のサーバーレス バッチ スキャンを使用して、BigQuery のペタバイト規模のデータセットを検査します。
- 非構造化ファイル リポジトリを監査する: Cloud Storage バケットに保存されているドキュメント、アーカイブ、メディア ファイルを検査して、暗号化されていないセンシティブ データや誤って配置されたセンシティブ データを特定します。
- 過去のスキャン結果と傾向を追跡する: 詳細な検査結果を BigQuery テーブルに直接保存して、経時的な結果を追跡し、コンプライアンス監査証跡を生成します。
- イベント ドリブンの修復ワークフローをトリガーする: ストリーム スキャンの完了イベントと高リスクの検出結果アラートを Pub/Sub にストリーミングして、自動化されたセキュリティ対応ハンドブックを開始します。
- 費用対効果を高めるために大規模なデータセットをサンプリングする: サンプリングの上限または行の上限を構成して、データセット全体をスキャンすることなく、大規模なデータベース全体のデータ リスク ポスチャーを推定します。
詳細については、projects.dlpJobs リソースの REST API リファレンスをご覧ください。ストレージの詳細は、StorageConfig オブジェクトで指定します。
ハイブリッド メソッド
ハイブリッド メソッドは、実質すべてのソースから送信されたデータのペイロードをスキャンし、その結果を Google Cloudに保存できるようにする一連の非同期 API メソッドです。ハイブリッド メソッドは、検査対象のデータが 1 つ以上の検査リクエストに含まれているという点で、コンテンツ メソッドと似ています。ただし、コンテンツ メソッドと異なり、ハイブリッド メソッドは API レスポンスで検査結果を返しません。代わりに、検査結果はサーバーサイドで非同期的に処理され、結果が表にまとめられ、ストレージ メソッドに似た方法で保存されます。
ハイブリッド検査を有効にするには、dlpJobs リソースを使用して機密データの保護ジョブを作成します。各ハイブリッド ジョブは、検査リクエストをリッスンし、検出結果の保存や公開などの機密データの保護アクションを実行するマネージド サービスとして実行されます。これらのオプションのアクションに加えて、Sensitive Data Protection は、ジョブのステータス、スキャンしたバイト数、infoType ごとの検出結果の概要など、ジョブの詳細を作成して保存します。Google Cloud コンソールの DLP API または Sensitive Data Protection を使用してジョブを管理できます。
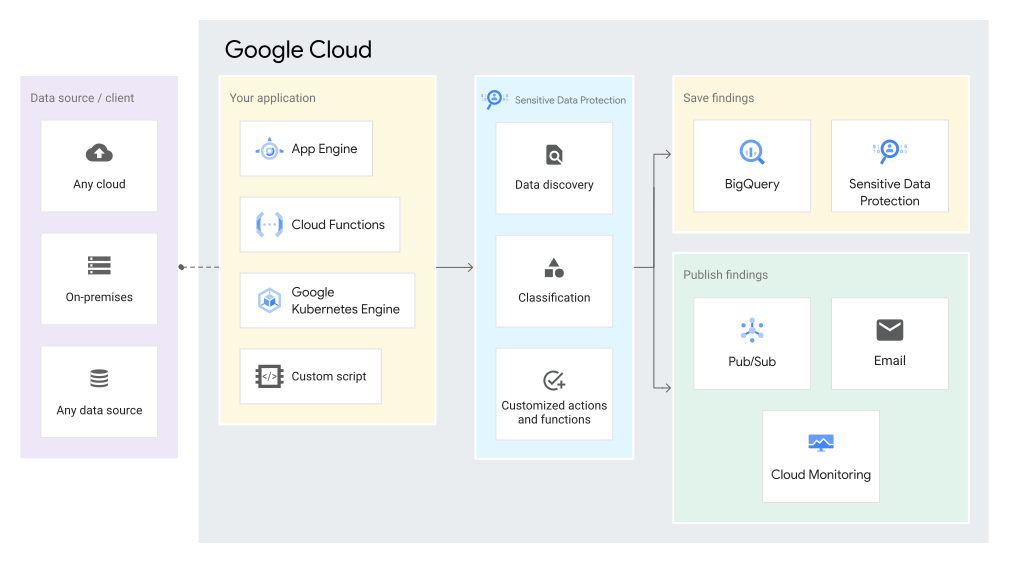
ハイブリッド メソッドを使用するタイミング
一般的なユースケースは次のとおりです。
- ハイブリッド環境とマルチクラウド環境のデータを検査する: オンプレミス データベース、ベアメタル サーバー、他のクラウド プロバイダから Sensitive Data Protection にデータをストリーミングし、検出レポートをGoogle Cloudに一元管理します。
- カスタム アプリケーション データ パイプラインを監査する: ローカル スキャナ ワーカー フリートを管理せずに、カスタム クローラー、マイクロサービス、ETL パイプラインから Sensitive Data Protection にストリーミング データを送信します。
- クラウド移行中にワークロードをサニタイズする: レガシー システムから Google Cloudへのライブ データベース レプリケーション中に、機密性の高いアセットを継続的に検査してトークン化します。
- マルチクラウド コンプライアンス レポートを一元化する: 異なるオペレーティング環境の検査結果を単一の BigQuery データセットに集約し、ガバナンスを統合します。
- カスタム ファイルタイプと独自の形式を処理する: 独自のバイナリ形式からテキストをクライアントサイドで抽出し、抽出したペイロードを Sensitive Data Protection にストリーミングして検査します。
詳細については、projects.dlpJobs リソースの REST API リファレンスをご覧ください。データソースは、StorageConfig オブジェクトの hybridOptions フィールドで指定します。
検出方法
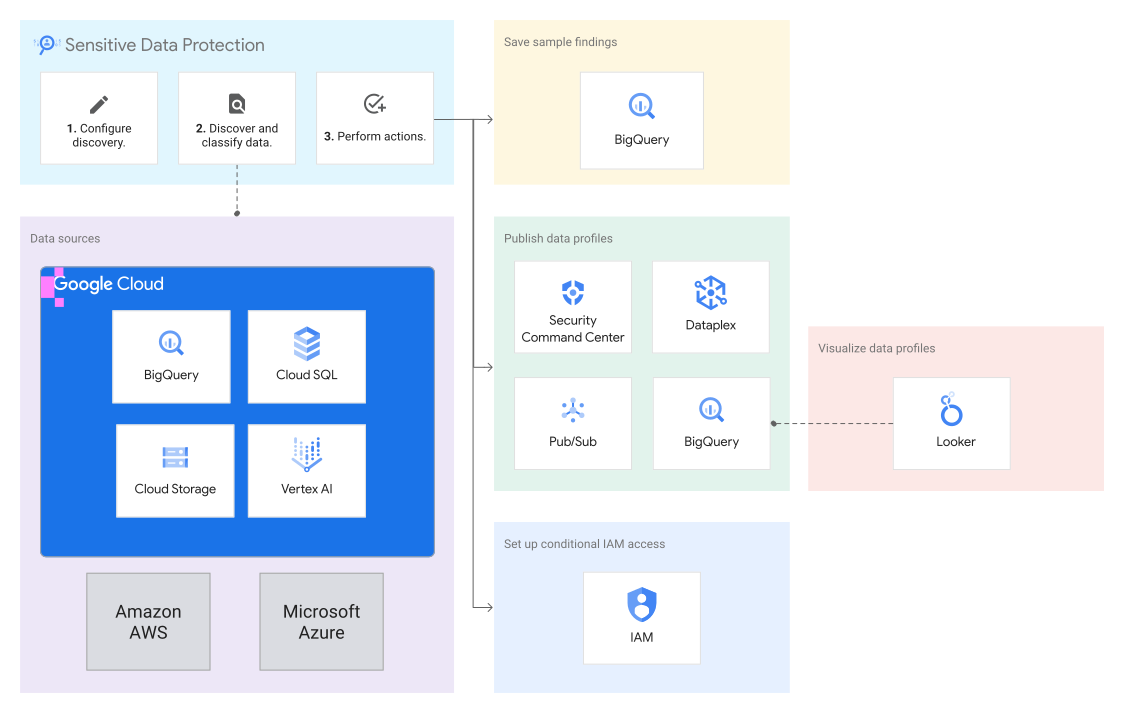
検出方法を使用すると、機密データの検出を構成してデータ プロファイルを生成できます。データ プロファイルは、組織内のセンシティブ データの保存場所、保存しているセンシティブ データの種類、そのデータにアクセス制御が設定されているかどうかを判断するのに役立つ分析情報を提供します。
検出を構成して、BigQuery、Cloud SQL、Cloud Storage、Vertex AI などのシステムに保存されているデータをスキャンできます。 Google Cloud Security Command Center Enterprise を有効にしている場合は、Sensitive Data Protection を使用して他のクラウド プロバイダのデータをスキャンすることもできます。
検出スキャンごとに Sensitive Data Protection で実行するアクションを指定できます。たとえば、スキャン結果を他のGoogle Cloud サービス(Security Command Center や Google Security Operations など)に送信して、組織のデータ セキュリティ ポスチャーの可視性を高めることができます。プロファイリングされたリソースにタグを付けて、それらのリソースへの IAM アクセスを自動的に許可または拒否するように、検出サービスを構成できます。データ プロファイルを BigQuery にエクスポートすることもできます。エクスポートしたプロファイルをデータポータルに接続して、既製のレポートを表示できます。独自のカスタムクエリとレポートを作成することもできます。
検出を有効にするには、DiscoveryConfig リソースを作成します。検出は、検出構成で設定したスコープと頻度に基づいて実行されます。Sensitive Data Protection が生成されたプロファイルを保存する場所については、データ所在地に関する検討事項をご覧ください。
検出構成、データ プロファイル、Cloud SQL 接続は、DLP API または Google Cloud コンソールを使用して管理できます。
検出方法を使用するタイミング
一般的なユースケースは次のとおりです。
- 組織全体のデータ検出を自動化する: 個々のスキャンジョブやスケジュールを作成することなく、BigQuery、Cloud SQL、Cloud Storage のすべてのデータアセットを継続的にスキャンしてプロファイリングします。
- 高リスクのデータ リポジトリを特定する: テーブルとバケットのデータ リスクとデータ機密性スコアを生成して、データ保護とガバナンスの取り組みを優先順位付けします。
- データタグを使用して動的アクセス制御を適用する: 検出された infoType に基づいてプロファイルされたリソースに自動的にタグ付けし、Identity and Access Management ポリシーを使用してアクセス権を付与または制限します。
- データ セキュリティ ポスチャー管理のフィード: 検出プロファイルの分析情報を Security Command Center と Google Security Operations に送信して、データリスクとインフラストラクチャの脅威を関連付けます。
- 経営幹部向けダッシュボードでコンプライアンス ポスチャーを可視化する: データ プロファイルを BigQuery にエクスポートし、事前に作成されたデータポータル ダッシュボードを接続して、組織、フォルダ、プロジェクト全体でのセンシティブ データの分布をモニタリングします。
詳細については、次の REST API リファレンスをご覧ください。
検出の構成
接続
接続は、Cloud SQL の検出にのみ関連します。
データ プロファイル
organizations.locations.projectDataProfilesprojects.locations.projectDataProfilesorganizations.locations.fileStoreDataProfilesprojects.locations.fileStoreDataProfilesorganizations.locations.tableDataProfilesprojects.locations.tableDataProfilesorganizations.locations.columnDataProfilesprojects.locations.columnDataProfiles
次のステップ
- 入門ガイドを読み、テキストや画像に含まれるセンシティブ データの検査と、テキストや画像からのセンシティブ データの削除を開始する。
- ストレージの検査とアクションの使用方法の詳細について、ストレージとデータベースに保存されているセンシティブ データの検査を確認する。
- 機密データの検出の詳細については、データ プロファイルをご覧ください。
- 料金を確認します。