


Hybridjobs und Job-Trigger sind asynchrone API-Methoden, mit denen Sie Nutzlasten von Daten aus praktisch jeder Quelle auf sensible Informationen untersuchen können. Die Ergebnisse werden in Google Cloudgespeichert. Mit Hybridjobs können Sie eigene Daten-Crawler schreiben, die Daten ähnlich wie die Sensitive Data Protection-Speicherprüfmethoden verarbeiten und bereitstellen.
Mit Hybridjobs können Sie Daten aus jeder Quelle in Sensitive Data Protection streamen. Sensitive Data Protection prüft die Daten auf sensible Informationen oder personenidentifizierbare Informationen und speichert die Inspektionsscanergebnisse in einer Sensitive Data Protection-Jobressource. Sie können die Scanergebnisse in der UI oder API der Sensitive Data Protection Console untersuchen oder Aktionen nach dem Scan festlegen, die ausgeführt werden sollen, z. B. das Speichern von Daten aus Inspektionsergebnissen in einer BigQuery-Tabelle oder das Senden einer Pub/Sub-Benachrichtigung.
Der Workflow für Hybridjobs ist im folgenden Diagramm zusammengefasst:
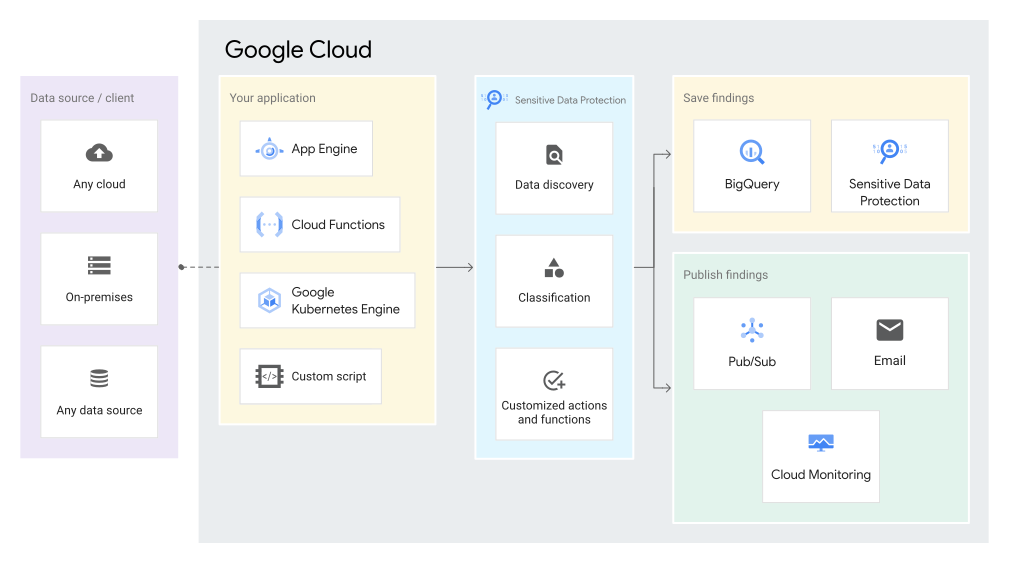
In diesem Konzeptthema werden Hybridjobs und Job-Trigger sowie deren Funktionsweise beschrieben. Informationen zum Implementieren von Hybridjobs und Job-Triggern finden Sie unter Externe Daten mit Hybridjobs prüfen.
Wann sollten Hybrid-Jobs verwendet werden?
Im Folgenden sind einige gängige Anwendungsfälle aufgeführt:
- Daten in Hybrid- und Multi-Cloud-Umgebungen prüfen: Streamen Sie Daten aus lokalen Datenbanken, virtuellen Maschinen oder anderen Cloud-Anbietern in Sensitive Data Protection und speichern Sie die Ergebnisse in Google Cloud.
- Compliance-Berichte aus mehreren Quellen zentralisieren: Fassen Sie Inspektionsergebnisse aus benutzerdefinierten Crawlern und verteilten Mikrodiensten in einer einzigen BigQuery-Tabelle zusammen, um das Risiko einheitlich zu verwalten.
- Daten bei Cloud-Migrationen bereinigen: Sensible Inhalte werden geprüft, validiert und nachverfolgt, wenn Datasets aus alten Systemen inGoogle Cloudmigriert werden.
Informationen zu Hybridumgebungen
"Hybrid"-Umgebungen sind in Organisationen üblich. Viele Organisationen speichern und verarbeiten vertrauliche Daten mithilfe einer Kombination aus folgenden Elementen:
- Andere Cloudanbieter
- Lokale Server oder andere Daten-Repositories
- Nicht native Speichersysteme, z. B. Systeme, die in einer virtuellen Maschine ausgeführt werden
- Web- und mobile Apps
- Google Cloud-basierte Lösungen
Mit Hybridjobs kann Sensitive Data Protection Daten prüfen, die von jeder dieser Quellen gesendet werden. Im Folgenden finden Sie einige Beispielszenarien:
- Prüfen Sie Daten, die im Amazon Relational Database Service (RDS), einem in einer virtuellen Maschine ausgeführten MySQL oder einer lokalen Datenbank gespeichert sind.
- Prüfen und tokenisieren Sie Daten, während Sie Daten von der lokalen Umgebung zur Cloud oder zwischen Produktion, Entwicklung und Analysen migrieren.
- Sie können Transaktionen in einer Web- oder mobilen Anwendung prüfen und entfernen, bevor Sie inaktive Daten speichern.
Prüfungsoptionen
Wie unter Methodentypen genauer beschrieben, bietet Sensitive Data Protection drei Standardoptionen, um Inhalte auf sensible Daten zu prüfen:
- Methoden zur Inhaltsprüfung: Mit der Inhaltsprüfung streamen Sie kleine Nutzlasten an Sensitive Data Protection zusammen mit Anleitungen dazu, was zu prüfen ist. Sensitive Data Protection prüft dann die Daten auf sensible Inhalte und personenidentifizierbare Informationen und gibt die Ergebnisse des Scans an Sie zurück.
- Speichermethoden-Prüfung: Mit der Speicherprüfung prüft Sensitive Data Protection ein Google Cloud-basiertes Speicher-Repository wie eine BigQuery-Datenbank, einen Cloud Storage-Bucket oder eine Datastore-Art. Sie geben Sensitive Data Protection an, was geprüft werden soll und was geprüft werden soll. Sensitive Data Protection führt dann einen Job aus, der das Repository scannt. Nach Abschluss des Scans speichert Sensitive Data Protection eine Zusammenfassung der Scanergebnisse für den Job. Außerdem können Sie angeben, dass die Ergebnisse zur Analyse an ein anderes Google Cloud -Produkt gesendet werden, z. B. eine separate BigQuery-Tabelle.
- Prüfung von Hybridjobs: Hybridjobs bieten die Vorteile der beiden vorherigen Methoden. Sie ermöglichen das Streamen von Daten wie bei Inhaltsmethoden und stellen gleichzeitig Speicher, Visualisierung und Aktionen von Speicherprüfungsjobs bereit. Jede Prüfungskonfiguration wird in Sensitive Data Protection verwaltet, ohne clientseitig weitere Konfigurationen vornehmen zu müssen. Hybridjobs können nützlich sein, um nicht native Speichersysteme wie eine Datenbank zu scannen, die auf einer virtuellen Maschine (VM), lokal oder in einer anderen Cloud ausgeführt wird. Hybridmethoden können auch bei der Prüfung von Verarbeitungssystemen wie Migrationsarbeitslasten und sogar bei der Weiterleitung von Dienst-zu-Dienst-Kommunikation nützlich sein. Dies ist zwar auch mit Inhaltsmethoden möglich, aber Hybridmethoden stellen das Speicher-Back-End bereit, das Ihre Daten über mehrere API-Aufrufe hinweg aggregieren kann.
Informationen zu Hybridjobs und Job-Trigger
Ein Hybridjob ist eine Kombination aus Inhalts- und Speichermethoden. Der grundlegende Workflow zur Verwendung von Hybridjobs und Job-Triggern ist:
- Sie schreiben ein Skript oder erstellen einen Workflow, der Daten zur Prüfung zusammen mit Metadaten an Sensitive Data Protection sendet.
- Sie konfigurieren und erstellen eine Hybridjobressource oder einen Trigger, der aktiviert wird, wenn Daten empfangen werden.
- Ihr Skript oder Workflow wird clientseitig ausgeführt und sendet Daten in Form einer
hybridInspect-Anfrage an Sensitive Data Protection. Die Daten enthalten eine Aktivierungsnachricht und die ID des Jobs oder Job-Triggers, die die Prüfung auslöst. - Sensitive Data Protection prüft die Daten gemäß den Kriterien, die Sie im Hybridjob oder Trigger festgelegt haben.
- Sensitive Data Protection speichert die Ergebnisse des Scans in der Hybridjobressource, zusammen mit den von Ihnen bereitgestellten Metadaten. Sie können die Ergebnisse mit der Sensitive Data Protection-UI in der Google Cloud Console prüfen.
- Optional kann Sensitive Data Protection Aktionen nach dem Scannen ausführen, z. B. das Speichern von Prüfergebnisdaten in einer BigQuery-Tabelle oder das Senden von Benachrichtigungen per E-Mail oder Pub/Sub.
Mit einem Hybridjob-Trigger können Sie Jobs erstellen, aktivieren und beenden, sodass Sie bei Bedarf Aktionen auslösen können. Wenn Sie dafür sorgen, dass Ihr Skript oder Code Daten mit der Kennung des Hybridjobs sendet, müssen Sie das Skript oder den Code nicht aktualisieren, wenn ein neuer Job gestartet wird.
Typische Hybridjobszenarien
Hybridjobs eignen sich gut für Ziele wie die folgenden:
- Sie möchten einen einmaligen Scan einer Datenbank außerhalb von Google Cloud im Rahmen einer vierteljährlichen Prüfung von Datenbanken ausführen.
- Sie möchten alle neuen Inhalte überwachen, die täglich einer Datenbank hinzugefügt werden, die Sensitive Data Protection nicht nativ unterstützt.
- Eingehende Daten in einer Datenbank scannen und gleichzeitig steuern, wie die Daten partitioniert werden.
- Sie möchten den Traffic in einem Netzwerk mit dem WebAssembly-HHTP-Filter für Envoy-Sidecar-Proxys Sensitive Data Protection-Filter für Envoy überwachen, um problematische sensible Datenverschiebungen zu identifizieren.
Informationen dazu, wie Sie in diesen Fällen vorgehen sollten, finden Sie unter Typische Szenarien für die hybride Überprüfung.
Arten von Metadaten, die Sie bereitstellen können
In diesem Abschnitt werden die Arten von Metadaten beschrieben, die Sie an die externen Daten, die Sie prüfen möchten, oder an die Ergebnisse anhängen können.
Sie können Metadaten auf den folgenden Ebenen festlegen:
Metadaten in einem Hybridjob oder Hybridjob-Trigger
In diesem Abschnitt werden die Metadatentypen beschrieben, die Sie an einen Hybridjob oder einen Hybridjob-Trigger anhängen können.
Erforderliche Labels
Im Hybridjob oder Hybridjob-Trigger können Sie eine Liste der erforderlichen Labels angeben, die in allen von Ihnen gesendeten Hybridprüfungsanfragen enthalten sein müssen.
Alle Anfragen für diesen Hybridjob oder Hybridjob-Trigger, die nicht diese erforderlichen Labels enthalten, werden abgelehnt. Weitere Informationen finden Sie unter Labels für hybridInspect-Anfragen erforderlich machen.
Optionale Labels
Sie können Schlüssel/Wert-Paare angeben, die an alle Ergebnisse eines Hybridjobs oder Hybridjob-Triggers angehängt werden sollen. Wenn Sie beispielsweise möchten, dass alle Ergebnisse eines Hybridjobs das Label "env"="prod" haben, geben Sie dieses Schlüssel/Wert-Paar beim Erstellen des Hybridjobs an.
Tabellarische Datenoptionen
Sie können alle Spalten angeben, die Zeilenkennzeichnungen (Primärschlüssel) für Tabellenobjekte in Ihren Daten sind. Wenn die angegebenen Spalten in der Tabelle vorhanden sind, werden die Werte aus den angegebenen Spalten zusammen mit jedem Ergebnis eingeschlossen, sodass Sie das Ergebnis zu der Zeile zurückverfolgen können, aus der es stammt. Diese tabellarischen Optionen gelten nur für Anfragen, die tabellarische Daten senden, beispielsweise ein item.table- oder byteItem-Format wie CSV.
Wenn Sie die Primärschlüssel im Voraus kennen, können Sie sie beim Erstellen des Hybridjobs oder Hybridjob-Triggers als Identifikationsfelder festlegen. Sie können bis zu drei Spaltennamen im Feld hybridOptions.tableOptions.identifyingFields auflisten.
Metadaten in einer hybridInspect-Anfrage
In diesem Abschnitt werden die Arten von Metadaten beschrieben, die Sie an eine hybridInspect-Anfrage anhängen können. Metadaten, die Sie in einer hybridInspect-Anfrage senden, werden nur auf diese Anfrage angewendet.
Containerdetails
In jeder Anfrage, die Sie an einen Hybridjob oder einen Hybridjob-Trigger senden, können Details zur Datenquelle angegeben werden, einschließlich Elemente wie fullPath, rootPath, relativePath, type, version und andere. Wenn Sie beispielsweise Tabellen in einer Datenbank scannen, können Sie die Felder so festlegen:
{
  "hybridItem": {
    "item": {...},
    "findingDetails": {
      "containerDetails": {
        "fullPath": "10.0.0.20/database1/table1",
        "relativePath": "table1",
        "rootPath": "10.0.0.20/database1",
        "type": "postgres",
        "version": "9.6"
      },
      "labels": {...}
    }
  }
}
Sie können keine Containerdetails auf der Ebene des Hybridjobs oder Hybridjob-Triggers festlegen.
Erforderliche Labels
Wenn Sie beim Erstellen eines Hybridjobs oder Hybridjob-Triggers erforderliche Labels festlegen, muss jede hybridInspect-Anfrage, die Sie an diesen Hybridjob oder Hybridjob-Trigger senden, diese erforderlichen Labels enthalten. Weitere Informationen finden Sie unter Labels für hybridInspect-Anfragen erforderlich machen.
Optionale Labels
In jeder hybridInspect-Anfrage können Sie Schlüssel/Wert-Paare angeben, die an alle Ergebnisse in dieser Anfrage angehängt werden sollen. Mit dieser Methode können Sie jeder hybridInspect-Anfrage unterschiedliche Labels zuweisen.
Tabellarische Datenoptionen
Sie können alle Spalten angeben, die Zeilenkennzeichnungen (Primärschlüssel) für Tabellenobjekte in Ihren Daten sind. Wenn die angegebenen Spalten in der Tabelle vorhanden sind, werden die Werte aus den angegebenen Spalten zusammen mit jedem Ergebnis eingeschlossen, sodass Sie das Ergebnis zu der Zeile zurückverfolgen können, aus der es stammt. Diese tabellarischen Optionen gelten nur für Anfragen, die tabellarische Daten senden, beispielsweise ein item.table- oder byteItem-Format wie CSV.
Wenn Sie die Primärschlüssel nicht im Voraus kennen, müssen Sie sie nicht auf der Ebene des Hybridjobs oder Hybridjob-Triggers festlegen. Sie können sie in Ihrer hybridInspect-Anfrage zusammen mit den zu untersuchenden tabellarischen Daten festlegen. Alle Felder, die Sie auf der Ebene des Hybridjobs oder des Hybridjob-Triggers auflisten, werden mit den Feldern kombiniert, die Sie in der hybridInspect-Anfrage auflisten.
Unterstützte Aktionen
Wie andere Sensitive Data Protection-Jobs unterstützen Hybridjobs Aktionen. Nicht alle Aktionen gelten für Hybridjobs. Im Folgenden werden die derzeit unterstützten Aktionen sowie Informationen zu ihrer Funktionsweise aufgeführt. Beachten Sie, dass Ergebnisse mit den Pub/Sub-, E-Mail- und Cloud Monitoring-Aktionen verfügbar werden, wenn der Job endet.
- Ergebnisse in Sensitive Data Protection speichern und Ergebnisse in BigQuery speichern: Die Ergebnisse werden in einer Sensitive Data Protection-Ressource bzw. in einer BigQuery-Tabelle gespeichert. Diese Aktionen funktionieren mit Hybridjobs ähnlich wie mit anderen Jobtypen, mit einem wichtigen Unterschied: Bei Hybridjobs werden Ergebnisse verfügbar, während der Job ausgeführt wird. Bei anderen Jobtypen werden Ergebnisse nach dem Ende des Jobs zur Verfügung gestellt.
Pub/Sub senden: Wenn ein Job abgeschlossen ist, wird eine Pub/Sub-Nachricht ausgegeben.
E-Mail senden: Wenn ein Job abgeschlossen ist, wird eine E-Mail-Nachricht gesendet.
In Cloud Monitoring veröffentlichen: Wenn ein Job abgeschlossen ist, werden die Ergebnisse in Monitoring veröffentlicht.
Fazit
Im Folgenden sind einige wichtige Features und Vorteile der Verwendung von Hybridjobs und Job-Triggern aufgeführt:
- Mit Hybridjobs können Sie Daten aus praktisch jeder Quelle, innerhalb oder außerhalb von der Cloud, nach Sensitive Data Protection streamen.
- Hybridjob-Trigger werden aktiviert, wenn Sensitive Data Protection einen Datenstream empfängt, der eine Aktivierungsnachricht und die ID des Job-Triggers enthält.
- Sie können warten, bis der Scan abgeschlossen ist. Sie können den Job aber auch manuell beenden. Prüfergebnisse werden in Sensitive Data Protection oder BigQuery gespeichert, unabhängig davon, ob der Job fertig abgeschlossen ist oder vorher angehalten wurde.
- Ergebnisse von Sensitive Data Protection-Prüfscans eines Hybridjob-Triggers werden in einer Hybridjobressource in Sensitive Data Protection gespeichert.
- Sie können die Ergebnisse des Prüfscans prüfen, indem Sie die Job-Trigger-Ressource in Sensitive Data Protection aufrufen.
- Sie können Sensitive Data Protection auch anweisen, mithilfe einer Aktion Hybridjobergebnisse an eine BigQuery-Datenbank zu senden und Ihnen Benachrichtigungen per E-Mail oder Pub/Sub zu senden.
Nächste Schritte
- Wie Sie mit Hybridjobs und Job-Triggern Daten zur Prüfung empfangen, erfahren Sie unter Externe Daten mit Hybridjobs an Sensitive Data Protection senden.