


Halaman ini menjelaskan cara Sensitive Data Protection dapat membuat salinan data yang dide-identifikasi yang disimpan di Cloud Storage. Dokumen ini juga mencantumkan batasan operasi ini dan poin-poin yang harus Anda pertimbangkan sebelum memulai.
Untuk mengetahui informasi tentang cara menggunakan Sensitive Data Protection untuk membuat salinan data Cloud Storage Anda yang telah dide-identifikasi, lihat artikel berikut:
- Membuat salinan data yang telah dide-identifikasi yang disimpan di Cloud Storage menggunakan konsol Google Cloud
- Membuat salinan data yang telah dide-identifikasi yang disimpan di Cloud Storage menggunakan API
Tentang de-identifikasi
De-identifikasi adalah proses penghapusan informasi identitas pribadi dari data. Tujuannya adalah untuk memungkinkan penggunaan dan berbagi informasi pribadi—seperti informasi kesehatan, keuangan, atau demografi—sekaligus memenuhi persyaratan privasi. Untuk mengetahui informasi selengkapnya tentang de-identifikasi, lihat Melakukan de-identifikasi data sensitif.
Untuk mengetahui informasi mendalam selengkapnya tentang transformasi de-identifikasi di Sensitive Data Protection, lihat Referensi transformasi. Untuk mengetahui informasi selengkapnya tentang cara Sensitive Data Protection menyamarkan data sensitif dari gambar, lihat Pemeriksaan dan penyamaran gambar.
Kapan harus menggunakan penghapusan identitas penyimpanan
Berikut adalah beberapa kasus penggunaan umum:
- Membuat set data anonim untuk lingkungan non-produksi: Buat salinan file produksi yang telah di-de-identifikasi dan disimpan di Cloud Storage sebelum melakukan penyiapan data ke lingkungan pengembangan, pengujian, atau pelatihan.
- Membagikan repositori file yang telah disanitasi kepada pihak ketiga: Mengaburkan kolom sensitif dalam dokumen massal dan file tidak terstruktur sambil mempertahankan hierarki folder asli untuk partner bisnis atau auditor eksternal.
- Mengotomatiskan pipeline privasi untuk dokumen yang di-ingest: Mengubah data sensitif di seluruh file yang baru diupload ke bucket output yang ditentukan tanpa mengubah file sumber atau mengganggu pipeline upstream.
- Menerapkan residensi dan kompartementalisasi data: Simpan salinan cermin aset sensitif yang telah dide-identifikasi di bucket Cloud Storage terpisah dengan kontrol akses Identity and Access Management yang berbeda.
Proses de-identifikasi
Bagian ini menjelaskan proses de-identifikasi di Sensitive Data Protection untuk konten di Cloud Storage.
Untuk menggunakan fitur ini, Anda membuat
tugas inspeksi (DlpJob) yang dikonfigurasi untuk membuat salinan file Cloud Storage yang dide-identifikasi.
Sensitive Data Protection memindai file di lokasi yang ditentukan, memeriksanya
sesuai dengan konfigurasi Anda. Saat memeriksa setiap file, Sensitive Data Protection akan melakukan de-identifikasi data apa pun yang cocok dengan kriteria Anda untuk data sensitif, lalu menulis konten ke file baru. File baru selalu memiliki
nama file yang sama dengan file asli.
File baru ini disimpan dalam direktori output yang Anda tentukan. Jika file disertakan dalam pemindaian Anda, tetapi tidak ada data yang cocok dengan kriteria penghapusan identitas Anda, dan tidak ada error dalam pemrosesannya, maka file tersebut akan disalin, tanpa diubah, ke direktori output.
Direktori output yang Anda tetapkan harus berada di bucket Cloud Storage yang berbeda dengan bucket yang berisi file input Anda. Di direktori output Anda, Sensitive Data Protection membuat struktur file yang mencerminkan struktur file direktori input.
Misalnya, anggaplah Anda menetapkan direktori input dan output berikut:
- Direktori input:
gs://input-bucket/folder1/folder1a - Direktori output:
gs://output-bucket/output-directory
Selama de-identifikasi, Sensitive Data Protection menyimpan file yang telah di-identifikasi di
gs://output-bucket/output-directory/folder1/folder1a.
Jika ada file di direktori output dengan nama file yang sama dengan file yang tidak diidentifikasi, file tersebut akan ditimpa. Jika Anda tidak ingin file yang ada ditimpa, ubah direktori output sebelum menjalankan operasi ini. Atau, pertimbangkan untuk mengaktifkan pembuatan versi objek di bucket output.
Daftar kontrol akses (ACL) tingkat file untuk file asli disalin ke file baru, terlepas dari apakah data sensitif ditemukan dan dianonimkan. Namun, jika bucket output hanya dikonfigurasi untuk izin tingkat bucket yang seragam, dan bukan izin terperinci (tingkat objek), maka ACL tidak disalin ke file yang di-de-identifikasi.
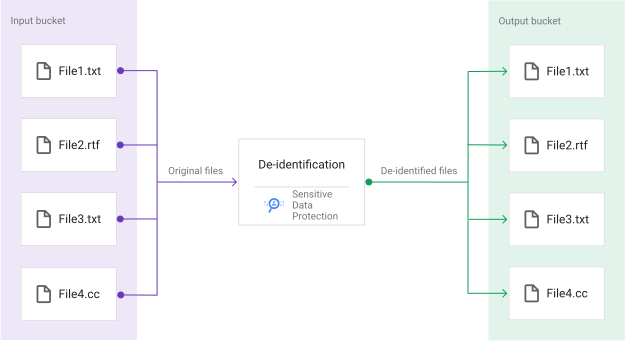
Diagram berikut menunjukkan proses de-identifikasi untuk empat file yang disimpan di bucket Cloud Storage. Setiap file disalin terlepas dari apakah Sensitive Data Protection mendeteksi data sensitif atau tidak. Setiap file yang disalin diberi nama yang sama dengan file aslinya.
Harga
Untuk mengetahui informasi harga, lihat Pemeriksaan dan transformasi data dalam penyimpanan.
Jenis file yang didukung
Sensitive Data Protection dapat mende-identifikasi grup jenis file berikut:
- CSV
- Gambar
- Teks
- TSV
Perilaku de-identifikasi default
Jika ingin menentukan cara Sensitive Data Protection mengubah temuan, Anda dapat memberikan template de-identifikasi untuk jenis file berikut:
- File tidak terstruktur, seperti file teks dengan teks bentuk bebas
- File terstruktur, seperti file CSV
- Gambar
Jika Anda tidak memberikan template de-identifikasi, Sensitive Data Protection akan mentransformasi temuan sebagai berikut:
- Dalam file tidak terstruktur dan terstruktur, Sensitive Data Protection mengganti semua temuan dengan infoType yang sesuai, seperti yang dijelaskan dalam Penggantian infoType.
- Dalam gambar, Sensitive Data Protection menutupi semua temuan dengan kotak hitam.
Batasan dan pertimbangan
Pertimbangkan poin-poin berikut sebelum membuat salinan data Cloud Storage yang telah dide-identifikasi.
Kapasitas disk
Operasi ini hanya mendukung konten yang disimpan di Cloud Storage.
Operasi ini membuat salinan setiap file saat Sensitive Data Protection memeriksanya. Fitur ini tidak mengubah atau menghapus konten asli. Data yang disalin akan menggunakan ruang disk tambahan yang kira-kira sama dengan data asli.
Akses tulis ke penyimpanan
Karena Sensitive Data Protection membuat salinan file asli, agen layanan project Anda harus memiliki akses tulis di bucket output Cloud Storage.
Sampling dan menetapkan batas penemuan
Operasi ini tidak mendukung pengambilan sampel. Secara khusus, Anda tidak dapat membatasi jumlah setiap file yang dipindai dan di-de-identifikasi oleh Sensitive Data Protection. Artinya, jika Anda
menggunakan Cloud Data Loss Prevention API, Anda
tidak dapat menggunakan bytesLimitPerFile dan bytesLimitPerFilePercent dalam
objek CloudStorageOptions dari DlpJob.
Selain itu, Anda tidak dapat mengontrol jumlah maksimum temuan yang akan ditampilkan.
Jika menggunakan DLP API, Anda tidak dapat menetapkan objek FindingLimits
di DlpJob.
Persyaratan untuk memeriksa data
Saat menjalankan tugas inspeksi, Sensitive Data Protection akan memeriksa data terlebih dahulu, sesuai dengan konfigurasi inspeksi Anda, sebelum melakukan de-identifikasi. Proses inspeksi tidak dapat dilewati.
Persyaratan untuk menggunakan ekstensi file
Sensitive Data Protection mengandalkan ekstensi file untuk mengidentifikasi jenis file di direktori input Anda. File mungkin tidak dianonimkan jika tidak memiliki ekstensi file, meskipun file tersebut berjenis yang didukung.
File yang dilewati
Saat melakukan de-identifikasi file dalam penyimpanan, Sensitive Data Protection akan melewati file berikut:
- File yang melebihi 60.000 KB. Jika Anda memiliki file besar yang melampaui batas ini, pertimbangkan untuk membaginya menjadi beberapa bagian yang lebih kecil.
- Jenis file yang tidak tercantum di Jenis file yang didukung di halaman ini.
- Jenis file yang sengaja Anda kecualikan dari konfigurasi de-identifikasi. Jika Anda menggunakan DLP API, jenis file yang Anda kecualikan dari kolom
file_types_to_transformtindakanDeidentifydiDlpJobAnda akan dilewati. - File yang mengalami error transformasi.
Urutan baris output dalam tabel yang tidak berisi informasi pribadi
Tidak ada jaminan bahwa urutan baris dalam tabel yang dianonimkan sama dengan urutan baris dalam tabel asli. Jika ingin membandingkan tabel asli dengan tabel yang tidak diidentifikasi, Anda tidak dapat mengandalkan nomor baris untuk mengidentifikasi baris yang sesuai. Jika Anda ingin membandingkan baris tabel, Anda harus menggunakan ID unik untuk mengidentifikasi setiap catatan.
Kunci sementara
Jika Anda memilih metode kriptografi sebagai metode transformasi, Anda harus membuat kunci terbungkus menggunakan Cloud Key Management Service terlebih dahulu. Kemudian, berikan kunci tersebut di template de-identifikasi Anda. Kunci sementara (mentah) tidak didukung.
Langkah berikutnya
- Pelajari cara melakukan de-identifikasi data sensitif yang disimpan di Cloud Storage menggunakan DLP API.
- Pelajari cara melakukan de-identifikasi data sensitif yang disimpan di Cloud Storage menggunakan Google Cloud konsol.
- Selesaikan codelab Membuat Salinan Data yang Dide-identifikasi di Cloud Storage.
- Pelajari cara memeriksa penyimpanan untuk menemukan data sensitif.