


Questa pagina descrive come Sensitive Data Protection può creare copie anonimizzate dei dati archiviati in Cloud Storage. Elenca inoltre le limitazioni di questa operazione e i punti da considerare prima di iniziare.
Per informazioni su come utilizzare Sensitive Data Protection per creare copie anonimizzate dei dati di Cloud Storage, consulta quanto segue:
- Crea copie anonimizzate dei dati archiviati in Cloud Storage utilizzando la console Google Cloud
- Crea copie anonimizzate dei dati archiviati in Cloud Storage utilizzando l'API
Informazioni sull'anonimizzazione
L'anonimizzazione è il processo di rimozione delle informazioni identificative dai dati. Il suo scopo è consentire l'utilizzo e la condivisione di informazioni personali, come quelle sanitarie, finanziarie o demografiche, rispettando al contempo i requisiti di privacy. Per saperne di più sull'anonimizzazione, consulta Anonimizzazione dei dati sensibili.
Per informazioni più dettagliate sulle trasformazioni di anonimizzazione in Sensitive Data Protection, consulta Riferimento per la trasformazione. Per ulteriori informazioni su come Sensitive Data Protection oscura i dati sensibili dalle immagini, consulta Ispezione e oscuramento delle immagini.
Quando utilizzare la deidentificazione dell'archiviazione
Ecco alcuni casi d'uso comuni:
- Genera set di dati anonimizzati per ambienti non di produzione: crea copie anonimizzate dei file di produzione archiviati in Cloud Storage prima di trasferire i dati negli ambienti di sviluppo, test o addestramento.
- Condividi repository di file sanificati con terze parti: offusca i campi sensibili in documenti collettivi e file non strutturati preservando la gerarchia delle cartelle originale per partner commerciali esterni o revisori.
- Automatizza le pipeline per la privacy per i documenti importati: trasforma i dati sensibili nei file appena caricati in un bucket di output designato senza alterare i file di origine o interrompere le pipeline upstream.
- Applica la residenza e la compartimentazione dei dati: archivia copie mirror anonimizzate di asset sensibili in bucket Cloud Storage separati con controlli dell'accesso Identity and Access Management distinti.
Procedura di anonimizzazione
Questa sezione descrive il processo di anonimizzazione in Sensitive Data Protection per i contenuti in Cloud Storage.
Per utilizzare questa funzionalità, crea un job di ispezione (DlpJob) configurato per creare copie deidentificate dei file Cloud Storage.
Sensitive Data Protection analizza i file nella posizione specificata, ispezionandoli
in base alla configurazione. Durante l'ispezione di ogni file,
Sensitive Data Protection anonimizza tutti i dati che corrispondono ai tuoi criteri per
i dati sensibili e poi scrive i contenuti in un nuovo file. Il nuovo file ha sempre
lo stesso nome del file originale.
Memorizza questo nuovo file in una directory di output specificata. Se un file è
incluso nella scansione, ma nessun dato corrisponde ai criteri di deidentificazione e
non sono presenti errori durante l'elaborazione, il file viene copiato, inalterato, nella
directory di output.
La directory di output che hai impostato deve trovarsi in un bucket Cloud Storage diverso da quello contenente i file di input. Nella directory di output, Sensitive Data Protection crea una struttura di file che rispecchia quella della directory di input.
Ad esempio, supponiamo di impostare le seguenti directory di input e output:
- Directory di input:
gs://input-bucket/folder1/folder1a - Directory di output:
gs://output-bucket/output-directory
Durante l'anonimizzazione, Sensitive Data Protection archivia i file anonimizzati
in gs://output-bucket/output-directory/folder1/folder1a.
Se nella directory di output esiste un file con lo stesso nome di un file anonimizzato, questo file viene sovrascritto. Se non vuoi che i file esistenti vengano sovrascritti, modifica la directory di output prima di eseguire questa operazione. In alternativa, valuta la possibilità di attivare il controllo delle versioni degli oggetti nel bucket di output.
Gli elenchi di controllo dell'accesso (ACL) a livello di file per i file originali vengono copiati nei nuovi file, indipendentemente dal fatto che siano stati trovati e deidentificati dati sensibili. Tuttavia, se il bucket di output è configurato solo per le autorizzazioni uniformi a livello di bucket e non per le autorizzazioni granulari (a livello di oggetto), gli ACL non vengono copiati nei file de-identificati.
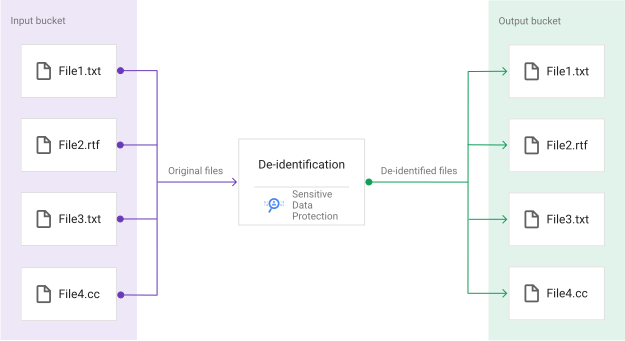
Il seguente diagramma mostra il processo di anonimizzazione per quattro file archiviati in un bucket Cloud Storage. Ogni file viene copiato indipendentemente dal fatto che Sensitive Data Protection rilevi dati sensibili. A ogni file copiato viene assegnato lo stesso nome dell'originale.
Prezzi
Per informazioni sui prezzi, consulta Ispezione e trasformazione dei dati nell'archiviazione.
Tipi di file supportati
Sensitive Data Protection può anonimizzare i seguenti gruppi di tipi di file:
- CSV
- Immagine
- Testo
- TSV
Comportamento di anonimizzazione predefinito
Se vuoi definire il modo in cui Sensitive Data Protection trasforma i risultati, puoi fornire modelli di anonimizzazione per i seguenti tipi di file:
- File non strutturati, come file di testo con testo in formato libero
- File strutturati, come i file CSV
- Immagini
Se non fornisci alcun modello di anonimizzazione, Sensitive Data Protection trasforma i risultati nel seguente modo:
- Nei file strutturati e non strutturati, Sensitive Data Protection sostituisce tutti i risultati con il rispettivo infoType, come descritto in Sostituzione di infoType.
- Nelle immagini, Sensitive Data Protection copre tutti i risultati con una casella nera.
Limitazioni e considerazioni
Considera i seguenti punti prima di creare copie anonimizzate dei dati di Cloud Storage.
Spazio sul disco
Questa operazione supporta solo i contenuti archiviati in Cloud Storage.
Questa operazione crea una copia di ogni file durante l'ispezione di Sensitive Data Protection. Non modifica né rimuove i contenuti originali. I dati copiati occuperanno circa la stessa quantità di spazio su disco aggiuntivo dei dati originali.
Accesso in scrittura allo spazio di archiviazione
Poiché Sensitive Data Protection crea una copia dei file originali, il service agent del tuo progetto deve disporre dell'accesso in scrittura al bucket di output Cloud Storage.
Campionamento e impostazione dei limiti di ricerca
Questa operazione non supporta il campionamento. In particolare, non puoi limitare la quantità di
ogni file che Sensitive Data Protection analizza e deidentifica. ovvero, se utilizzi l'API Cloud Data Loss Prevention, non puoi utilizzare bytesLimitPerFile e bytesLimitPerFilePercent nell'oggetto CloudStorageOptions del tuo DlpJob.
Inoltre, non puoi controllare il numero massimo di risultati da restituire.
Se utilizzi l'API DLP, non puoi impostare un oggetto FindingLimits
nel tuo DlpJob.
Requisito di ispezione dei dati
Quando esegui il job di ispezione, Sensitive Data Protection ispeziona prima i dati in base alla configurazione di ispezione, prima di eseguire la deidentificazione. Non può saltare la procedura di ispezione.
Obbligo di utilizzare le estensioni dei file
Sensitive Data Protection si basa sulle estensioni dei file per identificare i tipi di file nella directory di input. Potrebbe non rimuovere l'identificazione dai file che non hanno estensioni, anche se sono di tipi supportati.
File ignorati
Quando rimuove l'identificazione dei file nello spazio di archiviazione, Sensitive Data Protection ignora i seguenti file:
- File che superano i 60.000 KB. Se hai file di grandi dimensioni che superano questo limite, valuta la possibilità di suddividerli in blocchi più piccoli.
- Tipi di file non elencati nella sezione Tipi di file supportati di questa pagina.
- Tipi di file che hai escluso intenzionalmente dalla configurazione di anonimizzazione. Se utilizzi l'API DLP, i tipi di file che hai escluso dal campo
file_types_to_transformdell'azioneDeidentifydel tuoDlpJobvengono ignorati. - File in cui si sono verificati errori di trasformazione.
Ordine delle righe di output nelle tabelle anonimizzate
Non è garantito che l'ordine delle righe in una tabella anonimizzata corrisponda all'ordine delle righe nella tabella originale. Se vuoi confrontare la tabella originale con quella anonimizzata, non puoi fare affidamento sul numero di riga per identificare le righe corrispondenti. Se intendi confrontare le righe delle tabelle, devi utilizzare un identificatore univoco per identificare ogni record.
Chiavi temporanee
Se scegli un metodo di crittografia come metodo di trasformazione, devi prima creare una chiave sottoposta a wrapping utilizzando Cloud Key Management Service. Poi, fornisci questa chiave nel template di anonimizzazione. Le chiavi temporanee (non elaborate) non sono supportate.
Passaggi successivi
- Scopri come anonimizzare i dati sensibili archiviati in Cloud Storage utilizzando l'API DLP.
- Scopri come anonimizzare i dati sensibili archiviati in Cloud Storage utilizzando la Google Cloud console.
- Segui il codelab Creazione di una copia anonimizzata dei dati in Cloud Storage.
- Scopri come ispezionare lo spazio di archiviazione per individuare dati sensibili.