


本页介绍了 Sensitive Data Protection 如何为存储在 Cloud Storage 中的数据创建去标识化副本。此外,本页面还列出了此操作的限制以及您在开始之前应考虑的事项。
如需了解如何使用 Sensitive Data Protection 创建 Cloud Storage 数据的去标识化副本,请参阅以下内容:
关于去标识化
去标识化是从数据中移除身份信息的过程。其目标是在满足隐私权要求的同时,实现个人信息(例如健康、财务或人口统计信息)的使用和共享。如需详细了解去标识化,请参阅对敏感数据进行去标识化。
如需详细了解 Sensitive Data Protection 中的去标识化转换,请参阅转换参考文档。如需详细了解 Sensitive Data Protection 如何隐去图片中的敏感数据,请参阅图片检查和遮盖。
何时使用存储去标识化
以下是一些常见使用场景:
- 为非生产环境生成匿名化数据集:在将数据暂存到开发、测试或训练环境之前,先创建存储在 Cloud Storage 中的生产文件的去标识化副本。
- 与第三方共享经过清理的文件库:对批量文档和非结构化文件中的敏感字段进行模糊处理,同时保留原始文件夹层次结构,以便与外部业务合作伙伴或审核人员共享。
- 自动运行隐私保护流水线,处理已提取的文档:将新上传文件中的敏感数据转换到指定的输出存储桶,而不会更改源文件或中断上游流水线。
- 强制执行数据留存和隔离:将敏感资产的去标识化镜像副本存储在具有不同 Identity and Access Management 访问权限控制的单独 Cloud Storage 存储桶中。
去标识化流程
本部分介绍 Sensitive Data Protection 如何对 Cloud Storage 中的内容进行去标识化处理。
如需使用此功能,您需要创建检查作业 (DlpJob),该作业配置为创建 Cloud Storage 文件的去标识化副本。Sensitive Data Protection 会扫描指定位置中的文件,并根据您的配置检查这些文件。在检查每个文件时,Sensitive Data Protection 会对符合敏感数据条件的任何数据进行去标识化处理,然后将内容写入新文件。新文件的文件名始终与原始文件相同。它会将此新文件存储在您指定的输出目录中。如果某个文件包含在扫描中,但没有数据符合去标识化条件,并且在处理过程中没有出现任何错误,则该文件会原封不动地复制到输出目录。
您设置的输出目录必须位于与包含输入文件的存储桶不同的 Cloud Storage 存储桶中。在输出目录中,Sensitive Data Protection 会创建一个与输入目录的文件结构相对应的文件结构。
例如,假设您设置了以下输入和输出目录:
- 输入目录:
gs://input-bucket/folder1/folder1a - 输出目录:
gs://output-bucket/output-directory
在去标识化期间,Sensitive Data Protection 会将去标识化的文件存储在 gs://output-bucket/output-directory/folder1/folder1a 中。
如果输出目录中存在与去标识化文件同名的文件,则该文件会被覆盖。如果您不希望现有文件被覆盖,请在运行此操作之前更改输出目录。或者,考虑在输出存储桶上启用对象版本控制。
原始文件的文件级访问权限控制列表 (ACL) 会复制到新文件中,无论是否发现并去标识化了敏感数据。不过,如果输出存储桶仅配置了统一的存储桶级权限,而未配置精细的(对象级)权限,则 ACL 不会复制到去标识化的文件中。
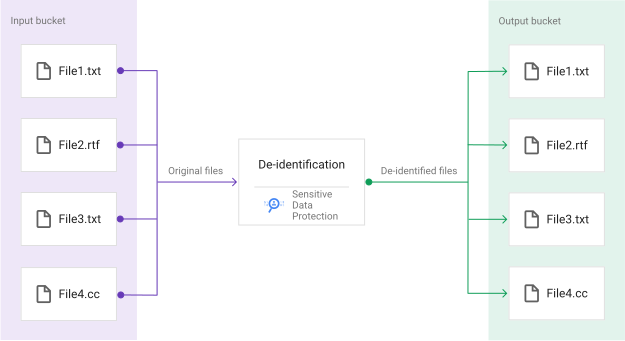
下图展示了存储在 Cloud Storage 存储桶中的四个文件的去标识化流程。无论 Sensitive Data Protection 是否检测到任何敏感数据,系统都会复制每个文件。每个复制的文件都与原始文件同名。
价格
如需了解价格信息,请参阅检查和转换存储空间中的数据。
支持的文件类型
Sensitive Data Protection 可以对以下文件类型组进行去标识化处理:
- CSV
- 映像
- 文本
- TSV
默认去标识化行为
如果您想定义 Sensitive Data Protection 如何转换发现的结果,可以为以下类型的文件提供去标识化模板:
- 非结构化文件,例如包含自由格式文本的文本文件
- 结构化文件,例如 CSV 文件
- 图片
如果您未提供任何去标识化模板,Sensitive Data Protection 会按如下方式转换检测结果:
- 在非结构化文件和结构化文件中,Sensitive Data Protection 会将所有发现结果替换为对应的 infoType,如 infoType 替换中所述。
- 在图片中,Sensitive Data Protection 会用黑色方框遮盖所有发现结果。
限制和注意事项
在创建 Cloud Storage 数据的去标识化副本之前,请考虑以下几点。
磁盘空间
此操作仅支持存储在 Cloud Storage 中的内容。
此操作会在 Sensitive Data Protection 检查每个文件时复制相应文件。它不会修改或移除原始内容。复制的数据将占用与原始数据大致相同的额外磁盘空间。
对存储空间的写入权限
由于 Sensitive Data Protection 会创建原始文件的副本,因此项目的服务代理必须具有对 Cloud Storage 输出存储桶的写入权限。
抽样和设置发现限制
此操作不支持抽样。具体来说,您无法限制 Sensitive Data Protection 扫描和去标识化每个文件的程度。也就是说,如果您使用的是 Cloud Data Loss Prevention API,则无法在 DlpJob 的 CloudStorageOptions 对象中使用 bytesLimitPerFile 和 bytesLimitPerFilePercent。
此外,您也无法控制要返回的发现数量上限。
如果您使用的是 DLP API,则无法在 DlpJob 中设置 FindingLimits 对象。
检查数据的要求
在运行检查作业时,Sensitive Data Protection 会先根据您的检查配置检查数据,然后再执行去标识化。无法跳过检查流程。
使用文件扩展名的要求
Sensitive Data Protection 依靠文件扩展名来识别输入目录中文件的文件类型。即使文件属于受支持的类型,但如果文件没有扩展名,系统也可能不会对这些文件进行去标识化处理。
跳过的文件
对存储空间中的文件进行去标识化处理时,Sensitive Data Protection 会跳过以下文件:
- 超过 60,000 KB 的文件。如果您有超出此限制的大文件,请考虑将其拆分为较小的块。
- 此页面上的支持的文件类型中未列出的文件类型。
- 您有意从去标识化配置中排除的文件类型。如果您使用的是 DLP API,系统会跳过您在
DlpJob的Deidentify操作的file_types_to_transform字段中排除的文件类型。 - 遇到转换错误的文件。
去标识化表格中输出行的顺序
无法保证去标识化表中的行顺序与原始表中的行顺序一致。如果您想将原始表与去标识化表进行比较,则无法依靠行号来识别对应的行。如果您打算比较表的行,则必须使用唯一标识符来标识每条记录。
临时密钥
如果您选择加密方法作为转换方法,则必须先使用 Cloud Key Management Service 创建封装密钥。然后,在去标识化模板中提供该密钥。不支持临时(原始)密钥。
后续步骤
- 了解如何使用 DLP API 对存储在 Cloud Storage 中的敏感数据进行去标识化。
- 了解如何使用 Google Cloud 控制台对存储在 Cloud Storage 中的敏感数据进行去标识化处理。
- 完成在 Cloud Storage 中创建去标识化的数据副本 Codelab。
- 了解如何检查存储空间是否存在敏感数据。