


En esta página, se describe cómo Sensitive Data Protection puede crear copias desidentificadas de los datos almacenados en Cloud Storage. También se enumeran las limitaciones de esta operación y los puntos que debes tener en cuenta antes de comenzar.
Si quieres obtener información para usar Sensitive Data Protection y crear copias desidentificadas de tus datos de Cloud Storage, consulta lo siguiente:
- Crea copias desidentificadas de los datos almacenados en Cloud Storage con la Google Cloud consola
- Crea copias desidentificadas de los datos almacenados en Cloud Storage con la API
Acerca de la desidentificación
La desidentificación es el proceso de quitar información de identificación de los datos. Su objetivo es permitir el uso y el intercambio de información personal, como la información de salud, financiera o demográfica, y, al mismo tiempo, cumplir con los requisitos de privacidad. Para obtener más información sobre la desidentificación, consulta Desidentifica datos sensibles.
Para obtener información más detallada sobre las transformaciones de desidentificación en Sensitive Data Protection, consulta la Referencia de transformación. Para obtener más información sobre cómo Sensitive Data Protection oculta datos sensibles en imágenes, consulta Ocultamiento y revisión de imágenes.
Cuándo usar la seudoanonimización del almacenamiento
A continuación, se muestran algunos casos de uso comunes:
- Genera conjuntos de datos anonimizados para entornos que no son de producción: Crea copias desidentificadas de los archivos de producción almacenados en Cloud Storage antes de transferir los datos a entornos de desarrollo, prueba o entrenamiento.
- Compartir repositorios de archivos saneados con terceros: Ofusca los campos sensibles en documentos masivos y archivos no estructurados, y conserva la jerarquía de carpetas original para los socios comerciales externos o los auditores.
- Automatiza las canalizaciones de privacidad para los documentos transferidos: Transforma los datos sensibles de los archivos recién subidos en un bucket de salida designado sin alterar los archivos fuente ni interrumpir las canalizaciones ascendentes.
- Aplica la residencia y la compartimentación de datos: Almacena copias duplicadas desidentificadas de los recursos sensibles en buckets de Cloud Storage separados con controles de acceso distintos de Identity and Access Management.
Proceso de desidentificación
En esta sección, se describe el proceso de desidentificación de Sensitive Data Protection para el contenido de Cloud Storage.
Para usar esta función, crea un trabajo de inspección (DlpJob) configurado para crear copias desidentificadas de los archivos de Cloud Storage.
Sensitive Data Protection analiza los archivos en la ubicación especificada y los inspecciona según tu configuración. A medida que inspecciona cada archivo, Sensitive Data Protection desidentifica los datos que coinciden con tus criterios de datos sensibles y, luego, escribe el contenido en un archivo nuevo. El archivo nuevo siempre tiene el mismo nombre que el archivo original.
Almacena este archivo nuevo en un directorio de salida que tú especificas. Si se incluye un archivo en tu análisis, pero no hay datos que coincidan con tus criterios de seudonimización y no hay errores en su procesamiento, el archivo se copia sin alteraciones en el directorio de salida.
El directorio de salida que establezcas debe estar en un bucket de Cloud Storage diferente del bucket que contiene tus archivos de entrada. En tu directorio de salida, Sensitive Data Protection crea una estructura de archivos que refleja la estructura de archivos del directorio de entrada.
Por ejemplo, supón que estableces los siguientes directorios de entrada y salida:
- Directorio de entrada:
gs://input-bucket/folder1/folder1a - Directorio de salida:
gs://output-bucket/output-directory
Durante la desidentificación, Sensitive Data Protection almacena los archivos desidentificados en gs://output-bucket/output-directory/folder1/folder1a.
Si existe un archivo en el directorio de salida con el mismo nombre que un archivo anonimizado, se reemplazará. Si no quieres que se reemplacen los archivos existentes, cambia el directorio de salida antes de ejecutar esta operación. Como alternativa, considera habilitar el control de versiones de objetos en el bucket de salida.
Las listas de control de acceso (LCA) a nivel de archivo de los archivos originales se copian en los archivos nuevos, independientemente de si se encontraron datos sensibles y se anonimizaron. Sin embargo, si el bucket de salida solo está configurado para permisos uniformes a nivel del bucket y no para permisos detallados (a nivel del objeto), las LCA no se copiarán a los archivos anonimizados.
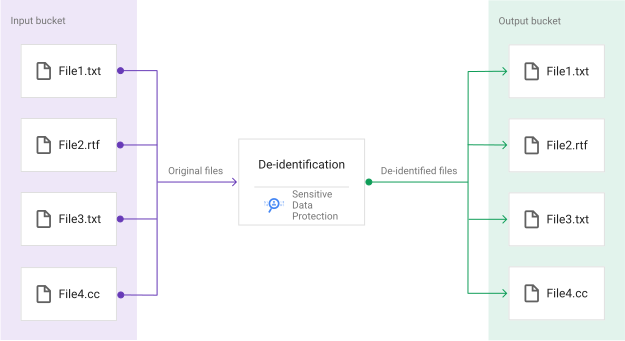
En el siguiente diagrama, se muestra el proceso de seudoanonimización para cuatro archivos almacenados en un bucket de Cloud Storage. Cada archivo se copia independientemente de si Sensitive Data Protection detecta datos sensibles. Cada archivo copiado tiene el mismo nombre que el original.
Precios
Para obtener información sobre los precios, consulta Inspección y transformación de datos en el almacenamiento.
Tipos de archivos admitidos
Sensitive Data Protection puede desidentificar los siguientes grupos de tipos de archivos:
- CSV
- Imagen
- Texto
- TSV
Comportamiento de desidentificación predeterminado
Si deseas definir cómo transforma los resultados Sensitive Data Protection, puedes proporcionar plantillas de desidentificación para los siguientes tipos de archivos:
- Archivos no estructurados, como archivos de texto con texto de formato libre
- Archivos estructurados, como los archivos CSV
- Imágenes
Si no proporcionas ninguna plantilla de desidentificación, Sensitive Data Protection transformará los hallazgos de la siguiente manera:
- En los archivos estructurados y no estructurados, Sensitive Data Protection reemplaza todos los hallazgos por su Infotipo correspondiente, como se describe en Reemplazo de infoType.
- En las imágenes, Sensitive Data Protection cubre todos los hallazgos con un cuadro negro.
Limitaciones y consideraciones
Ten en cuenta los siguientes puntos antes de crear copias desidentificadas de datos de Cloud Storage.
Espacio en el disco
Esta operación solo admite contenido almacenado en Cloud Storage.
Esta operación crea una copia de cada archivo a medida que Sensitive Data Protection lo inspecciona. No modifica ni quita el contenido original. Los datos copiados ocuparán aproximadamente la misma cantidad de espacio en disco adicional que los datos originales.
Acceso de escritura al almacenamiento
Dado que Protección de datos sensibles crea una copia de los archivos originales, el agente de servicio de tu proyecto debe tener acceso de escritura en el bucket de salida de Cloud Storage.
Muestreo y configuración de límites de búsqueda
Esta operación no admite el muestreo. Específicamente, no puedes limitar la cantidad de cada archivo que analiza y desidentifica Sensitive Data Protection. Es decir, si usas la API de Cloud Data Loss Prevention, no puedes usar bytesLimitPerFile ni bytesLimitPerFilePercent en el objeto CloudStorageOptions de tu DlpJob.
Además, no puedes controlar la cantidad máxima de hallazgos que se devolverán.
Si usas la API de DLP, no puedes establecer un objeto FindingLimits en tu DlpJob.
Requisito para inspeccionar los datos
Cuando ejecutas tu trabajo de inspección, Sensitive Data Protection primero inspecciona los datos según tu configuración de inspección antes de realizar la desidentificación. No se puede omitir el proceso de inspección.
Requisito para usar extensiones de archivo
Sensitive Data Protection se basa en las extensiones de archivo para identificar los tipos de archivos en tu directorio de entrada. Es posible que no anonimice los archivos que no tienen extensiones, incluso si son de tipos admitidos.
Archivos omitidos
Cuando desidentifica archivos en el almacenamiento, Sensitive Data Protection omite los siguientes archivos:
- Archivos que superan los 60,000 KB Si tienes archivos grandes que superan este límite, considera dividirlos en fragmentos más pequeños.
- Tipos de archivo que no se indican en Tipos de archivo admitidos en esta página
- Tipos de archivos que excluiste intencionalmente de la configuración de desidentificación. Si usas la API de DLP, se omitirán los tipos de archivo que excluyas del campo
file_types_to_transformde la acciónDeidentifyde tuDlpJob. - Archivos que tuvieron errores de transformación.
Orden de las filas de salida en las tablas anonimizadas
No se garantiza que el orden de las filas en una tabla anonimizada coincida con el orden de las filas en la tabla original. Si deseas comparar la tabla original con la tabla anonimizada, no puedes confiar en el número de fila para identificar las filas correspondientes. Si deseas comparar filas de las tablas, debes usar un identificador único para identificar cada registro.
Claves transitorias
Si eliges un método criptográfico como método de transformación, primero debes crear una clave unida con Cloud Key Management Service. Luego, proporciona esa clave en tu plantilla de desidentificación. No se admiten las claves transitorias (sin procesar).
¿Qué sigue?
- Aprende a desidentificar datos sensibles almacenados en Cloud Storage con la API de DLP.
- Obtén información para desidentificar los datos sensibles almacenados en Cloud Storage con la consola de Google Cloud .
- Realiza el codelab Crea una copia desidentificada de los datos en Cloud Storage.
- Obtén más información para inspeccionar el almacenamiento en busca de datos sensibles.