


Ce guide décrit comment Cloud Run gère les déploiements, en les divisant en trois domaines :
- Types de déploiement : ce que vous apportez à Cloud Run, comme du code source ou des images de conteneurs.
- Ressources Cloud Run : ce que votre déploiement exécute dans Cloud Run (service, job, pool de nœuds de calcul ou instance).
- Méthodes de déploiement : comment exécuter le déploiement, par exemple à l'aide de la console Google Cloud , de la gcloud CLI, de YAML ou de Terraform.
Types de déploiement
Cloud Run propose plusieurs options de déploiement. Après le déploiement, tous les déploiements, exécutions ou créations s'exécutent en tant qu'instances de conteneur en bac à sable sur l'infrastructure entièrement gérée et hautement évolutive de Cloud Run. Le tableau suivant indique les options de déploiement compatibles pour chaque type de ressource :
| Options de déploiement | Services | Jobs | Pools de nœuds de calcul | Instances |
|---|---|---|---|---|
| Déployer des images de conteneurs | Compatible | Compatible | Compatible | Compatible |
| Déployer depuis le code source | Compatible | Compatible | Compatible | — |
| Déployer des fonctions1 | Compatible | — | — | — |
| Déploiement continu à partir de git | Compatible | — | — | — |
1 Les fonctions sont une version spécialisée du déploiement de source pour le code à usage unique basé sur des événements.
Déployer des images de conteneurs
Vous pouvez déployer n'importe quelle image de conteneur respectant le contrat d'exécution de conteneur de Cloud Run sur un service, un service, un job, un pool de nœuds de calcul ou une instance Cloud Run.
Déployer depuis le code source
Pour plus de commodité, Cloud Run vous permet de compiler et de déployer du code source à partir d'une seule commande. Pour en savoir plus, consultez Déployer des services à partir du code source, Exécuter des jobs à partir du code source et Déployer des pools de nœuds de calcul à partir du code source.
Lorsque vous déployez à partir du code source, Cloud Build transforme le code en image de conteneur stockée dans Artifact Registry. Vous pouvez déployer du code source qui inclut un fichier Dockerfile ou qui utilise l'un des environnements d'exécution de langage compatibles.
Fonctions
Vous pouvez déployer des fonctions à application unique qui répondent aux événements émis par votre infrastructure et vos services cloud. Cloud Run déclenche votre fonction lorsqu'un événement surveillé est déclenché.
Un déploiement de fonctions est un type spécial de déploiement de code source, où vous n'avez qu'à fournir le code de la fonction. Vous pouvez écrire des fonctions Cloud Run à l'aide d'un certain nombre de langages de programmation compatibles.
Le déploiement d'une fonction crée un service Cloud Run.
Déploiement continu du code source à partir de Git
Cloud Run vous aide à configurer le déploiement continu à partir de Git. Comme pour les déploiements de sources, vous pouvez déployer du code source qui inclut un fichier Dockerfile ou qui est écrit dans l'un des environnements d'exécution de langage compatibles.
Le déploiement continu à partir de Git est disponible pour les services Cloud Run. Vous pouvez les configurer manuellement dans Cloud Build pour les jobs Cloud Run.
Ressources Cloud Run
Les sections suivantes décrivent plus en détail les ressources Cloud Run.
Comparaison des ressources Cloud Run
| Fonctionnalité | Services | Jobs | Pools de nœuds de calcul | Instances |
|---|---|---|---|---|
| Cas d'utilisation principal | Piloté par les requêtes (sites Web, API, microservices) | Axé sur les tâches (scripts, traitement des données, migrations) | Piloté par des événements/pull (consommateurs Kafka/PubSub) | Singleton géré (charges de travail agentiques, besoins de calcul spécifiques) |
| Déclencheur | Requêtes HTTP/gRPC, Eventarc | Modes d'exécution : standard (immédiat), différé. Déclencheurs : exécution manuelle, à l'aide de Scheduler, à l'aide de Workflows |
Toujours activé OU autoscalé à l'aide d'un travail en arrière-plan basé sur l'extraction | Aucun |
| Scaling | Automatique/Manuel : évolue à zéro ou en fonction des requêtes | Automatique : évolue vers N tâches indépendantes qui s'exécutent de manière séquentielle ou en parallèle. | Automatique/Manuel : nombre fixe d'instances utilisant le scaling manuel ou l'autoscaling intégré basé sur l'utilisation du processeur ou le backlog de messages Pub/Sub (autoscaling basé sur KEDA utilisant un autoscaler externe) | Aucun : pas d'autoscaling, gérable individuellement |
| Cycle de vie | Éphémère, réduit la taille en cas d'inactivité | Diffusion jusqu'à sept jours (de courte durée) | Vous pouvez choisir entre des processus en arrière-plan toujours actifs ou des instances éphémères à autoscaling. | Longue durée (peut s'exécuter pendant des jours ou des semaines) et redémarrage automatique indéfini |
| S'adresser à | URL de service stable (à équilibrage de charge) | Aucun point de terminaison public. URL interne pour les déclencheurs (par exemple, le planificateur) |
Aucun point de terminaison public. Accès d'entrée VPC direct basé sur l'adresse IP |
URL individuelle par instance |
| Trafic entrant | HTTP/gRPC public/interne | Aucun | Entrée de couche 4 basée sur l'adresse IP avec VPC direct | URL publique/interne par instance |
| Facturation | Basée sur les requêtes ou sur les instances | Durée par exécution | Durée par instance | Durée par instance |
Services Cloud Run
Un service est le principal type de ressource dans Cloud Run. Il représente une charge de travail axée sur les requêtes qui met automatiquement à l'échelle les instances de conteneurs pour gérer le trafic Web, les requêtes HTTP ou les événements entrants. Chaque service est situé dans une régionGoogle Cloud spécifique. Pour assurer la redondance et le basculement, Cloud Run réplique automatiquement les services dans plusieurs zones d'une même région. Un projetGoogle Cloud donné peut exécuter de nombreux services dans différentes régions.
Chaque service expose un point de terminaison unique. Par défaut, Cloud Run effectue un scaling automatique pour traiter les requêtes entrantes. Si nécessaire, vous pouvez modifier le comportement de scaling et le définir sur scaling manuel. Vous pouvez déployer un service à partir d'un conteneur, d'un dépôt ou d'un code source.
Le schéma suivant illustre le modèle de ressource Cloud Run pour les services :
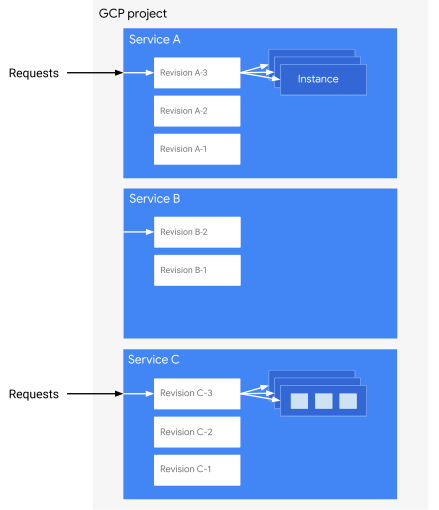
Le schéma montre un projet Google Cloud contenant trois services Cloud Run, le service A, le service B et le service C, chacun ayant plusieurs révisions :
- Le service A reçoit plusieurs requêtes. Cloud Run a donc démarré plusieurs instances pour gérer la charge. Chacune de ces instances n'exécute qu'un seul conteneur (celui de l'application).
- Le service B n'a aucune requête. Il est donc inactif et Cloud Run n'exécute aucune instance.
- Le service C reçoit des requêtes et a été mis à l'échelle pour gérer la charge en créant plusieurs instances. Dans ce cas, chacune de ces instances exécute un ensemble de plusieurs conteneurs. Dans chaque ensemble, seul le conteneur d'entrée reçoit la requête, mais les autres conteneurs aident à la traiter.
Révisions de service Cloud Run
Chaque déploiement sur un service crée une révision. Une révision comprend une ou plusieurs images de conteneurs, ainsi que des paramètres de configuration tels que des variables d'environnement, des limites de mémoire ou une valeur de simultanéité des requêtes.
Vous ne pouvez pas modifier une révision après l'avoir créée. Par exemple, lorsque vous déployez une image de conteneur dans un nouveau service, Cloud Run crée la première révision. Si vous déployez ensuite une image de conteneur différente sur ce même service, Cloud Run crée une deuxième révision. Si vous définissez ensuite une variable d'environnement, Cloud Run crée une troisième révision. Au fil du temps, Cloud Run finit par supprimer les révisions inutilisées.
Cloud Run achemine automatiquement les requêtes dès que possible vers la dernière révision de service opérationnelle.
Instances de service Cloud Run
Cloud Run adapte automatiquement chaque révision de service recevant des requêtes au nombre d'instances nécessaires pour les traiter en totalité. Notez que les instances peuvent recevoir plusieurs requêtes en même temps. Le paramètre de simultanéité des requêtes vous permet de définir le nombre maximal de requêtes pouvant être envoyées en parallèle à chaque instance d'une révision.
Jobs Cloud Run
Chaque job est situé dans une région Google Cloudspécifique et se compose d'une ou de plusieurs tâches de job qui exécutent un ou plusieurs conteneurs jusqu'à la fin. Les tâches de job sont indépendantes et peuvent s'exécuter en parallèle dans une exécution de job donnée.
Exécutions de tâches Cloud Run
Lorsque vous exécutez un job, Cloud Run crée une exécution de job et démarre toutes les tâches du job. Toutes les tâches d'une exécution de job doivent réussir pour que l'exécution du job aboutisse. Vous pouvez définir des délais avant expiration sur des tâches et spécifier le nombre de tentatives en cas d'échec de la tâche.
Si une tâche dépasse son nombre maximal de tentatives, Cloud Run la marque comme ayant échoué, ainsi que le job. Par défaut, les tâches s'exécutent en parallèle jusqu'à un maximum de 100, mais vous pouvez spécifier un maximum inférieur si l'une de vos ressources de sauvegarde, comme une base de données, l'exige.
Tâches de job Cloud Run
Chaque exécution de job exécute un certain nombre de tâches en parallèle, chaque tâche exécutant une instance. Cloud Run tente automatiquement d'exécuter à nouveau les tâches ayant échoué, en fonction de la configuration du job pour maxRetries.
Pools de nœuds de calcul Cloud Run
Les pools de nœuds de calcul sont une ressource Cloud Run spécialement conçue pour les charges de travail sans requête, telles que les files d'attente de récupération. Notez que les pools de nœuds de calcul ne disposent pas des fonctionnalités suivantes :
- Aucun point de terminaison ni URL
- Le conteneur déployé n'est pas tenu d'écouter les requêtes sur un port.
- Pas de scaling automatique
Comme pour un service Cloud Run, le déploiement ou la mise à jour d'un pool de nœuds de calcul crée une révision.
Vous pouvez mettre à l'échelle manuellement les instances du pool de nœuds de calcul selon vos besoins pour gérer les charges de travail. Vous pouvez également autoscaler les pools de nœuds de calcul avec des métriques externes, ce qui gère le scaling des charges de travail pilotées par des sources telles que les abonnements Pub/Sub, les requêtes Prometheus ou les files d'attente Kafka.
Lorsqu'il est connecté à un réseau cloud privé virtuel (VPC), chaque instance de pool de nœuds de calcul reçoit une adresse IP sur le réseau VPC et peut envoyer et recevoir du trafic vers et depuis ce VPC.
Instances Cloud Run
Une instance Cloud Run représente un environnement d'exécution singleton autonome. Contrairement à un service, qui met à l'échelle les instances de conteneur automatiquement ou manuellement pour gérer le trafic, une instance Cloud Run est une ressource de premier niveau avec sa propre adresse URL directe et ses propres opérations de cycle de vie.
Chaque instance Cloud Run inclut les fonctionnalités suivantes :
- Point de terminaison d'URL dédié : attribue une URL d'entrée stable par défaut. Vous pouvez désactiver l'URL par défaut pour n'autoriser que le trafic provenant des autres chemins d'entrée de l'instance.
- Règles de redémarrage : compatibles avec les conditions de redémarrage (
always,on-failure,never) pour récupérer automatiquement le processus de conteneur en cas de plantage. - Allocation de processeur partagée : s'exécute sur un modèle de processeur partagé où le processeur est entièrement alloué sur la base d'un budget de pointe et limité à une limite de ressources de base de 6,25% en dehors de ce budget.