


In diesem Leitfaden wird beschrieben, wie Cloud Run Bereitstellungen verarbeitet. Dabei wird in drei Bereiche unterteilt:
- Bereitstellungstypen: Was Sie in Cloud Run einbringen, z. B. Quellcode oder Container-Images.
- Cloud Run-Ressourcen: Was Ihre Bereitstellung in Cloud Run ausführt (Dienst, Job, Worker-Pool oder Instanz).
- Bereitstellungsmethoden: Wie Sie die Bereitstellung ausführen, z. B. mit der Google Cloud Console, der gcloud CLI, YAML oder Terraform.
Bereitstellungstypen
Cloud Run bietet mehrere Bereitstellungsoptionen. Nach der Bereitstellung werden alle Bereitstellungen, Ausführungen oder Erstellungen als Sandbox-Containerinstanzen in der vollständig verwalteten und hoch skalierbaren Infrastruktur von Cloud Run ausgeführt. In der folgenden Tabelle sind die unterstützten Bereitstellungsoptionen für die einzelnen Ressourcentypen aufgeführt:
| Bereitstellungsoption | Dienste | Jobs | Worker-Pools | Instanzen |
|---|---|---|---|---|
| Container-Images bereitstellen | Unterstützt | Unterstützt | Unterstützt | Unterstützt |
| Über Quellcode bereitstellen | Unterstützt | Unterstützt | Unterstützt | – |
| Funktionen bereitstellen1 | Unterstützt | – | – | – |
| Kontinuierliche Bereitstellung aus Git | Unterstützt | – | – | – |
1 Functions sind eine spezielle Version der Quellcodebereitstellung für ereignisgesteuerten Code mit einem einzigen Zweck.
Container-Images bereitstellen
Sie können jedes Container-Image, das dem Container-Laufzeitvertrag von Cloud Run entspricht, in einem Cloud Run-Dienst, Job, Worker-Pool oder Instanz bereitstellen.
Über Quellcode bereitstellen
Cloud Run bietet die Möglichkeit, Quellcode mit einem einzigen Befehl zu erstellen und bereitzustellen. Weitere Informationen finden Sie unter Dienste aus Quellcode bereitstellen, Jobs aus Quellcode ausführen und Worker-Pools aus Quellcode bereitstellen.
Wenn Sie aus Quellcode bereitstellen, wandelt Cloud Build den Code in ein Container-Image um, das in Artifact Registry gespeichert wird. Sie können Quellcode bereitstellen, der ein Dockerfile enthält oder eine der unterstützten Sprachlaufzeiten verwendet.
Funktionen
Sie können Funktionen, die einem einzigen Zweck dienen, bereitstellen, die auf Ereignisse reagieren, die von Ihrer Cloud-Infrastruktur und Ihren Diensten ausgegeben werden. Cloud Run löst Ihre Funktion aus, wenn ein überwachtes Ereignis ausgelöst wird.
Die Bereitstellung von Funktionen ist eine spezielle Art der Bereitstellung von Quellcode, bei der Sie nur den Funktionscode angeben müssen. Sie können Cloud Run-Funktionen mit einer Reihe von unterstützten Programmiersprachen schreiben.
Wenn Sie eine Funktion bereitstellen, wird ein Cloud Run-Dienst erstellt.
Kontinuierliche Bereitstellung von Quellcode aus Git
Mit Cloud Run können Sie die kontinuierliche Bereitstellung aus Git konfigurieren. Wie bei Quellcodebereitstellungen können Sie Quellcode bereitstellen, der eine Dockerfile enthält oder in einer der unterstützten Sprachlaufzeiten geschrieben ist.
Die kontinuierliche Bereitstellung aus Git ist für Cloud Run-Dienste verfügbar. Sie können sie manuell in Cloud Build für Cloud Run-Jobs konfigurieren.
Cloud Run-Ressourcen
In den folgenden Abschnitten werden Cloud Run-Ressourcen genauer beschrieben.
Vergleich von Cloud Run-Ressourcen
| Funktion | Dienste | Jobs | Worker-Pools | Instanzen |
|---|---|---|---|---|
| Primärer Anwendungsfall | Anfragebasiert (Websites, APIs, Mikrodienste) | Aufgabenorientiert (Skripts, Datenverarbeitung, Migrationen) | Ereignis-/Pull-gesteuert (Kafka-/PubSub-Consumer) | Verwalteter Singleton (Agentic-Arbeitslasten, spezifische Rechenanforderungen) |
| Trigger | HTTP-/gRPC-Anfragen, Eventarc | Ausführungsmodi: Standard (sofort), verzögert. Trigger: Manuelle Ausführung, mit Scheduler, mit Workflows |
Immer aktiv ODER automatisch skaliert mit Pull-basierten Hintergrundaufgaben | Keine |
| Skalieren | Automatisch/Manuell: Skalierung auf null oder basierend auf Anfragen | Automatisch: Skaliert auf N unabhängige Aufgaben, die sequenziell oder parallel ausgeführt werden. | Automatisch/Manuell: Feste Anzahl von Instanzen mit manueller Skalierung oder integriertem Autoscaling basierend auf CPU-Auslastung oder Pub/Sub-Nachrichtenrückstand (KEDA-basiertes Autoscaling mit externem Autoscaler) | Keine: Kein Autoscaling; individuell verwaltbar |
| Lebenszyklus | Sitzungsspezifisch, wird bei Inaktivität herunterskaliert | Wird innerhalb von 7 Tagen abgeschlossen (kurzlebig) | Sie können zwischen Always-On-Hintergrundprozessen und flüchtigen, automatisch skalierten Instanzen wählen. | Langlebig (kann tagelang oder wochenlang ausgeführt werden) und wird automatisch unbegrenzt neu gestartet |
| Adressierung | Stabile Dienst-URL (mit Load-Balancing) | Kein öffentlicher Endpunkt. Interne URL für Trigger (z.B. Scheduler) |
Kein öffentlicher Endpunkt. Privater direkter VPC-IP-basierter Ingress-Zugriff |
Einzelne URL pro Instanz |
| Eingehender Traffic | Öffentliches/Internes HTTP/gRPC | Keine | IP-basierter L4-Ingress mit Direct VPC | Öffentliche/interne URL pro Instanz |
| Abrechnung | Anfragebasiert oder instanzbasiert | Dauer pro Ausführung | Dauer pro Instanz | Dauer pro Instanz |
Cloud Run-Dienste
Ein Dienst ist der primäre Ressourcentyp in Cloud Run. Er stellt eine anfragegesteuerte Arbeitslast dar, die Containerinstanzen automatisch skaliert, um eingehenden Webtraffic, HTTP-Anfragen oder Ereignisse zu verarbeiten. Jeder Dienst befindet sich in einer bestimmten Google Cloud -Region. Zur Bereitstellung von Redundanz und Failover repliziert Cloud Run Dienste automatisch in mehreren Zonen innerhalb einer Region. Ein bestimmtesGoogle Cloud -Projekt kann viele Dienste in verschiedenen Regionen ausführen.
Jeder Dienst stellt einen eindeutigen Endpunkt bereit. Standardmäßig skaliert Cloud Run automatisch, um eingehende Anfragen zu verarbeiten. Bei Bedarf können Sie das Skalierungsverhalten optional in manuelle Skalierung ändern. Sie können einen Dienst aus einem Container, Repository oder Quellcode bereitstellen.
Das folgende Diagramm zeigt das Cloud Run-Ressourcenmodell für Dienste:
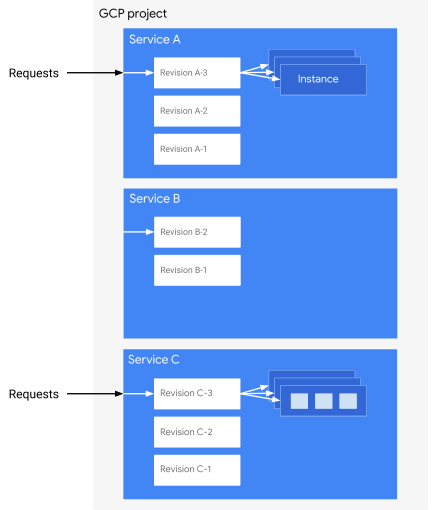
Das Diagramm zeigt ein Google Cloud -Projekt mit drei Cloud Run-Diensten, Dienst A, Dienst B und Dienst C, die jeweils mehrere Überarbeitungen haben:
- Dienst A erhält mehrere Anfragen, sodass Cloud Run mehrere Instanzen gestartet hat, um die Last zu bewältigen. Auf jeder dieser Instanzen wird nur ein Container ausgeführt (der Container der Anwendung).
- Dienst B hat keine Anfragen, ist also inaktiv und Cloud Run führt keine Instanzen aus.
- Dienst C hat Anfragen und wurde skaliert, um die Last zu bewältigen. Dazu wurden mehrere Instanzen erstellt. In diesem Fall wird auf jeder dieser Instanzen eine Reihe von mehreren Containern ausgeführt. In jedem Satz empfängt nur der Ingress-Container die Anfrage, aber die anderen Container helfen bei der Bearbeitung der Anfrage.
Cloud Run-Dienstüberarbeitungen
Bei jedem Deployment in einem Dienst wird eine Überarbeitung erstellt. Eine Version besteht aus einem oder mehreren Container-Images sowie Konfigurationseinstellungen wie Umgebungsvariablen, Arbeitsspeicherlimits oder einem Wert für die Nebenläufigkeit von Anfragen.
Nach dem Erstellen kann eine Überarbeitung nicht mehr geändert werden. Wenn Sie beispielsweise ein Container-Image für einen neuen Dienst bereitstellen, erstellt Cloud Run die erste Revision. Wenn Sie anschließend für denselben Dienst ein anderes Container-Image bereitstellen, wird in Cloud Run eine zweite Überarbeitung erstellt. Wenn Sie anschließend eine Umgebungsvariable festlegen, wird eine dritte Überarbeitung erstellt. Im Laufe der Zeit werden nicht verwendete Überarbeitungen von Cloud Run entfernt.
Cloud Run leitet Anfragen automatisch so schnell wie möglich an die neueste fehlerfreie Dienstversion weiter.
Cloud Run-Dienstinstanzen
Cloud Run skaliert jede Dienstüberarbeitung, die Anfragen empfängt, automatisch auf die Anzahl der Instanzen, die zur Verarbeitung aller Anfragen nötig sind. Instanzen können viele Anfragen gleichzeitig empfangen. Mit der Einstellung für die Nebenläufigkeit von Anfragen können Sie die maximale Anzahl von Anfragen festlegen, die parallel an jede Instanz einer Version gesendet werden können.
Cloud Run-Jobs
Jeder Job befindet sich in einer bestimmten Google Cloud-Region und besteht aus einem oder mehreren Job-Tasks, die einen oder mehrere Container ausführen. Job-Aufgaben sind unabhängig und können in einer bestimmten Job-Ausführung parallel ausgeführt werden.
Cloud Run-Jobausführungen
Wenn Sie einen Job ausführen, erstellt Cloud Run eine Jobausführung und startet alle Jobaufgaben. Alle Aufgaben einer Jobausführung müssen erfolgreich abgeschlossen werden, damit die Jobausführung erfolgreich ist. Sie können Zeitlimits für Aufgaben festlegen und die Anzahl der Wiederholungen im Fall von Aufgabenfehlern angeben.
Wenn eine Aufgabe die maximale Anzahl an Wiederholungsversuchen überschreitet, wird sie von Cloud Run als fehlgeschlagen und der Job als fehlgeschlagen markiert. Standardmäßig werden maximal 100 Aufgaben parallel ausgeführt. Sie können aber auch ein niedrigeres Maximum festlegen, wenn Ihre Sicherungsressourcen, z. B. eine Datenbank, dies erfordern.
Cloud Run-Jobaufgaben
Bei jeder Jobausführung werden mehrere Aufgaben parallel ausgeführt. Für jede Aufgabe wird eine Instanz ausgeführt. Cloud Run versucht automatisch, alle fehlgeschlagenen Aufgaben noch einmal auszuführen, je nach Konfiguration des Jobs für maxRetries.
Cloud Run-Worker-Pools
Worker-Pools sind eine Cloud Run-Ressource, die speziell für Arbeitslasten ohne Anfragen wie Pull-Warteschlangen entwickelt wurde. Worker-Pools haben die folgenden Funktionen nicht:
- Kein Endpunkt/keine URL
- Der bereitgestellte Container muss nicht auf Anfragen an einem Port warten.
- Kein automatisches Skalieren
Ähnlich wie bei einem Cloud Run-Dienst wird beim Bereitstellen oder Aktualisieren eines Worker-Pools eine neue Überarbeitung erstellt.
Sie können Worker-Pool-Instanzen bei Bedarf manuell skalieren, um die Arbeitslasten zu bewältigen. Sie können Worker-Pools auch mit externen Messwerten automatisch skalieren. Dadurch wird die Skalierung für Arbeitslasten verarbeitet, die von Quellen wie Pub/Sub-Abos, Prometheus-Abfragen oder Kafka-Warteschlangen gesteuert werden.
Wenn eine Worker-Pool-Instanz mit einem VPC-Netzwerk (Virtual Private Cloud) verbunden ist, erhält sie eine IP-Adresse im VPC-Netzwerk und kann Traffic an dieses VPC-Netzwerk senden und von diesem empfangen.
Cloud Run-Instanzen
Eine Cloud Run-Instanz stellt eine eigenständige Singleton-Laufzeitumgebung dar. Im Gegensatz zu einem Dienst, bei dem Containerinstanzen automatisch oder manuell skaliert werden, um Traffic zu verarbeiten, ist eine Cloud Run-Instanz eine Ressource der obersten Ebene mit eigener direkter URL-Adressierbarkeit und eigenen Lebenszyklusvorgängen.
Jede Cloud Run-Instanz bietet die folgenden Funktionen:
- Dedizierter URL-Endpunkt: Weist standardmäßig eine stabile Ingress-URL zu. Sie können die Standard-URL deaktivieren, um nur Traffic von den anderen Ingress-Pfaden der Instanz zuzulassen.
- Neustartrichtlinien: Unterstützt Neustartbedingungen (
always,on-failure,never), um den Containerprozess bei Abstürzen automatisch wiederherzustellen. - Gemeinsame CPU-Zuweisung: Die Ausführung erfolgt auf einem gemeinsamen CPU-Modell, bei dem die CPU vollständig auf der Grundlage eines Burst-Budgets zugewiesen und außerhalb dieses Budgets auf ein Ressourcenlimit von 6,25% gedrosselt wird.