


בדף הזה מוסבר איך להגדיר GPU למאגרי העובדים של Cloud Run. Google מספקת GPU מסוג NVIDIA RTX PRO 6000 Blackwell עם זיכרון GPU (VRAM) בנפח 96GB ו-GPU מסוג NVIDIA L4 עם זיכרון GPU (VRAM) בנפח 24GB, שהוא נפרד מזיכרון האינסטנס.
השימוש ב-GPU ב-Cloud Run הוא מנוהל לחלוטין, ולא נדרשים מנהלי התקנים או ספריות נוספים. תכונת ה-GPU מציעה זמינות על פי דרישה ללא צורך בהזמנות, בדומה לאופן שבו מעבד על פי דרישה וזיכרון על פי דרישה פועלים ב-Cloud Run.
מופעים של Cloud Run עם יחידת GPU מסוג NVIDIA RTX PRO 6000 Blackwell או L4 עם דרייברים מותקנים מראש מתחילים לפעול תוך כ-5 שניות, ובשלב הזה התהליכים שפועלים בקונטיינר יכולים להתחיל להשתמש ב-GPU.
אפשר להגדיר GPU אחד לכל מופע של Cloud Run. אם משתמשים במאגרי sidecar, חשוב לזכור שאפשר לצרף את ה-GPU רק למאגר אחד.
סוגי GPU נתמכים
Cloud Run תומך בשני סוגים של יחידות GPU:
- NVIDIA RTX PRO 6000 Blackwell GPU עם הגרסה הנוכחית של הדרייבר של NVIDIA: 580.x.x (13.0). כדי להשתמש ב-GPU NVIDIA RTX PRO 6000 Blackwell, צריך להשתמש ב-20 ליבות CPU לפחות ובזיכרון בנפח 80GiB.
- L4 GPU עם הגרסה הנוכחית של הדרייבר של NVIDIA: 580.x.x (13.0). ב-GPU מסוג L4, צריך להשתמש ב-4 מעבדים לפחות ובזיכרון בנפח 16GiB.
אזורים נתמכים
האזורים הבאים נתמכים על ידי NVIDIA RTX PRO 6000 Blackwell GPU:
asia-southeast1(סינגפור).-
asia-south2(דלהי, הודו). europe-west4(הולנד) רמה נמוכה של CO2
us-central1(אייווה) רמה נמוכה של CO2
האזורים הבאים נתמכים על ידי L4 GPU:
asia-southeast1(סינגפור)asia-south1(מומבאי) <0x האזור הזה זמין רק בהזמנה. אם אתם מעוניינים באזור הזה, תוכלו לפנות לצוות התמיכה בחשבונות Google.europe-west1(בלגיה) רמה נמוכה של CO2
europe-west4(הולנד) רמה נמוכה של CO2
us-central1(אייווה) רמה נמוכה של CO2
. יכול להיות שיהיה צורך בבקשה להגדלת המכסה כדי להרחיב את המשאבים באזור הזה. אם אתם מעוניינים באזור הזה, תוכלו לפנות לצוות התמיכה בחשבונות Google. -
us-east4(צפון וירג'יניה) <0x0A יכול להיות שיהיה צורך בבקשה להגדלת המכסה כדי להרחיב את המשאבים באזור הזה. אם אתם מעוניינים באזור הזה, תוכלו לפנות לצוות התמיכה בחשבונות Google.
השפעה על התמחור
פרטים על תמחור של GPU זמינים במאמר תמחור של Cloud Run. שימו לב לדרישות ולשיקולים הבאים:
- יש הבדל בעלות בין יתירות אזורית של GPU לבין יתירות לא אזורית. פרטים על תמחור של GPU זמינים במאמר תמחור של Cloud Run.
- אי אפשר להגדיר שינוי גודל אוטומטי למאגרי עובדים עם GPU. תחויבו על ה-GPU גם אם הוא לא מריץ אף תהליך, וכל עוד מופעלת דוגמה של GPU במאגר העובדים.
- התמחור של מעבד וזיכרון למאגרי עובדים שונה מהתמחור של שירותים ומשימות. עם זאת, המחיר של מק"ט GPU זהה למחיר של שירותים ועבודות.
- הגדרות המעבד (CPU) והזיכרון של המשאב.
- החיוב על ה-GPU מתבצע למשך כל מחזור החיים של המופע.
אפשרויות של יתירות אזורית ב-GPU
כברירת מחדל, Cloud Run פורס את מאגר העובדים בכמה אזורים בתוך אזור. הארכיטקטורה הזו מספקת חוסן מובנה: אם יש הפסקת חשמל באזור מסוים, Cloud Run מעביר באופן אוטומטי את התעבורה מהאזור המושפע לאזורים תקינים באותו אזור.
כשעובדים עם משאבי GPU, חשוב לזכור שיש מגבלות קיבולת ספציפיות למשאבי GPU. במהלך הפסקת חשמל אזורית, מנגנון המעבר לגיבוי (failover) הרגיל לעומסי עבודה של GPU מסתמך על כך שקיבולת GPU פנויה מספיקה תהיה זמינה באזורים הבריאים שנותרו. בגלל המגבלות של יחידות GPU, יכול להיות שהקיבולת הזו לא תמיד תהיה זמינה.
כדי להגדיל את הזמינות של מאגרי העובדים עם האצת GPU במהלך הפסקות זמניות באזור, אפשר להגדיר יתירות אזורית במיוחד עבור מעבדי GPU:
הפעלה של יתירות אזורית (ברירת מחדל): Cloud Run שומר קיבולת GPU עבור מאגר העובדים שלכם בכמה אזורים. השימוש באפשרות הזו מגדיל באופן משמעותי את הסיכוי שמאגר העובדים יוכל לטפל בהצלחה בתנועה שהופנתה מחדש מאזור מושפע, ומציע אמינות גבוהה יותר במהלך כשלים אזוריים עם עלות נוספת לשנייה לכל GPU.
היתירות האזורית מושבתת: Cloud Run מנסה לבצע מעבר לגיבוי במקרה של עומסי עבודה של GPU, אבל לא מובטח שהמעבר יצליח. התעבורה מנותבת לתחומים אחרים רק אם יש מספיק קיבולת של GPU באותו רגע. האפשרות הזו לא מבטיחה קיבולת שמורה לתרחישי יתירות כשל, אבל העלות שלה נמוכה יותר לשנייה של GPU.
SLA
הסכם רמת השירות (SLA) של Cloud Run GPU תלוי באפשרות שבה נעשה שימוש במאגר העובדים: יתירות אזורית או יתירות לא אזורית. פרטים נוספים זמינים בדף הסכם רמת השירות (SLA).
שליחת בקשה להגדלת המכסה
המיכסה של יחידות GPU ב-Cloud Run nvidia-rtx-pro-6000 ניתנת במילי-GPU.
בפרויקטים שמשתמשים ב-nvidia-rtx-pro-6000 GPU באזור מסוים בפעם הראשונה, תוקצה באופן אוטומטי מכסת 3,000 מילי-GPU (יתירות אזורית מושבתת) כשיוצרים את הפריסה הראשונה. המשמעות היא 3 מעבדי GPU. כשיוצרים פריסה ראשונה בפרויקטים שמשתמשים ב-GPU של Cloud Runnvidia-l4 באזור מסוים בפעם הראשונה, מקבלים אוטומטית מכסת GPU של 3 (יתירות אזורית מושבתת).
אם אתם צריכים עוד מעבדי GPU ב-Cloud Run, אתם צריכים לבקש הגדלה של המכסה של מאגר העובדים ב-Cloud Run. כדי לבקש את המכסה שדרושה לכם, אתם יכולים להשתמש בקישורים שמופיעים בלחצנים הבאים.
| נדרשת מכסה | קישור למכסה |
|---|---|
| NVIDIA RTX PRO 6000 Blackwell GPU עם יתירות אזורית מושבתת (מחיר נמוך יותר) | בקשה למכסת GPU בלי יתירות אזורית |
| NVIDIA RTX PRO 6000 Blackwell GPU עם יתירות אזורית מופעלת (מחיר גבוה יותר) | שליחת בקשה למכסת GPU עם יתירות אזורית |
| L4 GPU עם יתירות אזורית מושבתת (מחיר נמוך יותר) | בקשה למכסת GPU בלי יתירות אזורית |
| L4 GPU עם יתירות אזורית מופעלת (מחיר גבוה יותר) | שליחת בקשה למכסת GPU עם יתירות אזורית |
מידע נוסף על בקשות להגדלת מכסות זמין במאמר איך מגדילים את המכסה.
לפני שמתחילים
ברשימה הבאה מפורטות הדרישות והמגבלות כשמשתמשים ב-GPU ב-Cloud Run:
- נכנסים לחשבון Google Cloud . אנחנו ממליצים למשתמשים חדשים ב- Google Cloud ליצור חשבון כדי שיוכלו להעריך את הביצועים של המוצרים שלנו בתרחישים מהעולם האמיתי. לקוחות חדשים מקבלים בחינם גם קרדיט בשווי 300$ להרצה, לבדיקה ולפריסה של עומסי העבודה.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
מפעילים את Cloud Run API, אם הוא עדיין לא מופעל.
תפקידים שנדרשים להפעלת ממשקי API
כדי להפעיל ממשקי API, נדרשת ההרשאה
serviceusage.services.enable. אם יצרתם את הפרויקט, סביר להניח שכבר יש לכם את ההרשאה הזו דרך התפקיד 'בעלים' (roles/owner). אחרת, תוכלו לקבל את ההרשאה הזו דרך התפקיד 'אדמין בממשק Service Usage' (roles/serviceusage.serviceUsageAdmin). איך מקצים תפקידים- שליחת בקשה להגדלת המכסה.
- במאמר שיטות מומלצות לשימוש ב-GPU: מאגרי עובדים ב-Cloud Run עם GPU יש המלצות ליצירת קובץ אימג' של קונטיינר ולטעינת מודלים גדולים.
- צריך לוודא שמאגר העובדים של Cloud Run כולל את ההגדרות הבאות:
- מגדירים את הגדרות החיוב לחיוב לפי מופע. הערה: מאגרי עובדים שמוגדרים לחיוב לפי מופע עדיין יכולים להצטמצם לאפס.
- עבור NVIDIA RTX PRO 6000 Blackwell GPU, צריך להגדיר מינימום של 20 CPU ומינימום של 80 GiB של זיכרון.
- עבור GPU מסוג L4, צריך להגדיר לפחות 4 מעבדים למאגר העובדים, מומלץ להגדיר 8 מעבדים, ולפחות 16GiB של זיכרון, מומלץ להגדיר 32GiB.
- קובעים ומגדירים את מספר התהליכים המקסימלי האופטימלי לשימוש ב-GPU.
התפקידים הנדרשים
כדי לקבל את ההרשאות שדרושות להגדרה ולפריסה של מאגרי עובדים ב-Cloud Run, אתם צריכים לבקש מהאדמין להקצות לכם את תפקידי ה-IAM הבאים ב-workerpools:
- Cloud Run Developer (
roles/run.developer) – מאגר העובדים של Cloud Run - משתמש בחשבון שירות (
roles/iam.serviceAccountUser) – זהות השירות
רשימת ההרשאות והתפקידים ב-IAM שמשויכים ל-Cloud Run מופיעה במאמרים תפקידי IAM ב-Cloud Run והרשאות IAM ב-Cloud Run. אם מאגר העובדים של Cloud Run מתקשר עםGoogle Cloud ממשקי API, כמו ספריות לקוח ב-Cloud, כדאי לעיין במדריך להגדרת זהות שירות. מידע נוסף על מתן תפקידים זמין במאמרים הרשאות פריסה וניהול גישה.
הגדרת מאגר עובדים ב-Cloud Run עם GPU
כל שינוי בהגדרות מוביל ליצירה של גרסה חדשה. גם גרסאות מאוחרות יותר יקבלו את הגדרת התצורה הזו באופן אוטומטי, אלא אם תבצעו עדכונים מפורשים כדי לשנות אותה.
אפשר להשתמש במסוף Google Cloud , ב-Google Cloud CLI או ב-YAML כדי להגדיר GPU.
המסוף
נכנסים ל-Cloud Run במסוף Google Cloud :
בתפריט הניווט של Cloud Run, בוחרים באפשרות Worker Pools (מאגרי עובדים) ולוחצים על Deploy container (פריסת קונטיינר) כדי להגדיר מאגר עובדים חדש. אם אתם מגדירים מאגר עובדים קיים, לוחצים על מאגר העובדים ואז על עריכה ופריסה של עדכון חדש.
אם אתם מגדירים מאגר עובדים חדש, ממלאים את הדף של ההגדרות הראשוניות של מאגר העובדים ולוחצים על Containers, Networking, Security כדי להרחיב את דף ההגדרות של מאגר העובדים.
לוחצים על הכרטיסייה Containers (מאגרי תגים).
- מגדירים את המעבד, הזיכרון, בו-זמניות (concurrency), סביבת ההרצה ובקשה לבדיקת תקינות (probe) בהתאם להמלצות שבקטע לפני שמתחילים.
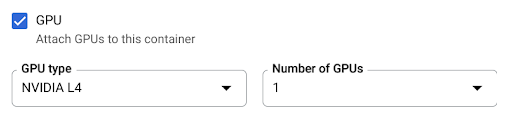
- מסמנים את תיבת הסימון GPU, בוחרים את סוג ה-GPU בתפריט סוג ה-GPU ואת מספר ה-GPU בתפריט מספר ה-GPU.
- כברירת מחדל, יתירות אזורית מופעלת. כדי לשנות את ההגדרה הנוכחית, מסמנים את תיבת הסימון GPU כדי להציג את האפשרויות של GPU redundancy.
- בוחרים באפשרות ללא יתירות אזורית כדי להשבית את היתירות האזורית.
- בוחרים באפשרות יתירות אזורית כדי להפעיל יתירות אזורית.
לוחצים על יצירה או על פריסה.
gcloud
כדי ליצור מאגר עובדים עם תמיכה ב-GPU, משתמשים בפקודה gcloud run worker-pools deploy:
  gcloud run worker-pools deploy WORKER_POOL \
    --image IMAGE_URL \
    --gpu 1
מחליפים את מה שכתוב בשדות הבאים:
- WORKER_POOL: השם של מאגר העובדים של Cloud Run.
-
IMAGE_URL: הפניה לקובץ האימג' של הקונטיינר שמכיל את מאגר העובדים, כמוus-docker.pkg.dev/cloudrun/container/worker-pool:latest.
כדי לעדכן את הגדרות ה-GPU של מאגר עובדים, משתמשים בפקודה gcloud run worker-pools update:
  gcloud run worker-pools update WORKER_POOL \
    --image IMAGE_URL \
    --cpu CPU \
    --memory MEMORY \
    --gpu GPU_NUMBER \
    --gpu-type GPU_TYPE \
    --GPU_ZONAL_REDUNDANCY
מחליפים את מה שכתוב בשדות הבאים:
- WORKER_POOL: השם של מאגר העובדים של Cloud Run.
-
IMAGE_URL: הפניה לקובץ האימג' של הקונטיינר שמכיל את מאגר העובדים, כמוus-docker.pkg.dev/cloudrun/container/worker-pool:latest. - CPU: מספר יחידות ה-CPU. ב-GPU NVIDIA RTX PRO 6000 Blackwell, צריך לציין לפחות
20מעבדים. במקרה של NVIDIA L4 GPU, צריך לציין לפחות4מעבד. - MEMORY: נפח הזיכרון. במקרה של NVIDIA RTX PRO 6000 Blackwell
GPU, צריך לציין לפחות
80Gi (80 GiB). ב-GPU מסוג NVIDIA L4, צריך לציין לפחות16Gi(16 GiB). - GPU_NUMBER: הערך
1(אחד). אם לא מציינים את הערך הזה אבל מציינים GPU_TYPE, ברירת המחדל היא1. - GPU_TYPE: סוג ה-GPU. NVIDIA RTX PRO 6000 Blackwell GPU,
enter
nvidia-rtx-pro-6000. עבור L4 GPU, מזינים את הערךnvidia-l4(nvidia-L4 באותיות קטנות, לא הערך המספרי 14). - GPU_ZONAL_REDUNDANCY:
no-gpu-zonal-redundancyכדי להשבית את יתירות האזורים, אוgpu-zonal-redundancyכדי להפעיל את יתירות האזורים.
YAML
אם אתם יוצרים מאגר עובדים חדש, דלגו על השלב הזה. אם אתם מעדכנים מאגר עובדים קיים, מורידים את הגדרת ה-YAML שלו:
gcloud run worker-pools describe WORKER_POOL --format export > worker-pool.yaml
מעדכנים את המאפיין
nvidia.com/gpu:ואתnodeSelector::
run.googleapis.com/accelerator:apiVersion: run.googleapis.com/v1 kind: WorkerPool metadata: name: WORKER_POOL spec: template: metadata: annotations: run.googleapis.com/gpu-zonal-redundancy-disabled: 'GPU_ZONAL_REDUNDANCY' spec: containers: - image: IMAGE_URL resources: limits: cpu: 'CPU' memory: 'MEMORY' nvidia.com/gpu: '1' nodeSelector: run.googleapis.com/accelerator: GPU_TYPE
מחליפים את מה שכתוב בשדות הבאים:
- WORKER_POOL: השם של מאגר העובדים של Cloud Run.
-
IMAGE_URL: הפניה לקובץ האימג' של הקונטיינר שמכיל את מאגר העובדים, כמוus-docker.pkg.dev/cloudrun/container/worker-pool:latest. - CPU: מספר יחידות ה-CPU. עבור NVIDIA RTX PRO 6000 Blackwell
GPU, צריך לציין לפחות
20מעבדים. ב-L4 GPU, צריך לציין לפחות4מעבדים. - MEMORY: נפח הזיכרון. במקרה של NVIDIA RTX PRO 6000 Blackwell
GPU, צריך לציין לפחות
80Gi (80 GiB). ב-L4 GPU, צריך לציין לפחות16Gi(16 GiB). - GPU_TYPE: סוג ה-GPU. אם משתמשים ב-GPU NVIDIA RTX PRO 6000 Blackwell,
מזינים
nvidia-rtx-pro-6000. עבור L4 GPU, מזינים את הערךnvidia-l4(nvidia-L4 באותיות קטנות, לא הערך המספרי 14). - GPU_ZONAL_REDUNDANCY:
falseלהפעלת יתירות אזורית של GPU אוtrueלהשבתה שלה.
יוצרים או מעדכנים את מאגר העובדים באמצעות הפקודה הבאה:
gcloud run worker-pools replace worker-pool.yaml
אם קיים קובץ
worker-pool.yaml, הפקודהgcloud run worker-pools replaceמשתמשת בו כברירת מחדל.
Terraform
כדי ללמוד איך להחיל הגדרות ב-Terraform או להסיר אותן, ראו פקודות בסיסיות ב-Terraform.
resource "google_cloud_run_v2_worker_pool" "default" {
  provider = google-beta
  name     = "WORKER_POOL"
  location = "REGION"

  template {
    gpu_zonal_redundancy_disabled = "GPU_ZONAL_REDUNDANCY"
    containers {
      image = "IMAGE_URL"
      resources {
        limits = {
          "cpu" = "CPU"
          "memory" = "MEMORY"
          "nvidia.com/gpu" = "1"
        }
      }
    }
    node_selector {
      accelerator = "GPU_TYPE"
    }
  }
}
מחליפים את מה שכתוב בשדות הבאים:
- WORKER_POOL: השם של מאגר העובדים של Cloud Run.
- GPU_ZONAL_REDUNDANCY:
falseלהפעלת יתירות אזורית של GPU אוtrueלהשבתה שלה. -
IMAGE_URL: הפניה לקובץ האימג' של הקונטיינר שמכיל את מאגר העובדים, כמוus-docker.pkg.dev/cloudrun/container/worker-pool:latest. - CPU: מספר יחידות ה-CPU. ב-GPU NVIDIA RTX PRO 6000 Blackwell, צריך לציין לפחות
20מעבדים. במקרה של NVIDIA L4 GPU, צריך לציין לפחות4מעבד. - MEMORY: נפח הזיכרון. במקרה של NVIDIA RTX PRO 6000 Blackwell
GPU, צריך לציין לפחות
80Gi (80 GiB). ב-GPU מסוג NVIDIA L4, צריך לציין לפחות16Gi(16 GiB). - GPU_TYPE: סוג ה-GPU. NVIDIA RTX PRO 6000 Blackwell GPU,
enter
nvidia-rtx-pro-6000. עבור L4 GPU, מזינים את הערךnvidia-l4(nvidia-L4 באותיות קטנות, לא הערך המספרי 14).
הצגת הגדרות ה-GPU
כדי לראות את הגדרות ה-GPU הנוכחיות של מאגר העובדים של Cloud Run, משתמשים במסוף Google Cloud או ב-Google Cloud CLI:
המסוף
במסוף Google Cloud , עוברים לדף Cloud Run worker pools:
לוחצים על מאגר העובדים כדי לפתוח את הדף פרטי מאגרי העובדים.
לוחצים על עריכה ופריסה של גרסה חדשה.
מחפשים את הגדרת ה-GPU בפרטי התצורה.
gcloud
מריצים את הפקודה הבאה:
gcloud run worker-pools describe WORKER_POOL
מחפשים את ההגדרה של ה-GPU בתצורה שמוחזרת.
הסרת GPU
אפשר להסיר GPU באמצעות מסוף Google Cloud , Google Cloud CLI או YAML.
המסוף
נכנסים ל-Cloud Run במסוף Google Cloud :
בתפריט הניווט של Cloud Run, בוחרים באפשרות Worker Pools (מאגרי עובדים) ולוחצים על Deploy container (פריסת קונטיינר) כדי להגדיר מאגר עובדים חדש. אם אתם מגדירים מאגר עובדים קיים, לוחצים על מאגר העובדים ואז על עריכה ופריסה של עדכון חדש.
אם אתם מגדירים מאגר עובדים חדש, ממלאים את הדף של ההגדרות הראשוניות של מאגר העובדים ולוחצים על Containers, Networking, Security כדי להרחיב את דף ההגדרות של מאגר העובדים.
לוחצים על הכרטיסייה Containers (מאגרי תגים).
- מבטלים את הסימון בתיבת הסימון GPU.
- לוחצים על יצירה או על פריסה.
gcloud
כדי להסיר GPU, מגדירים את מספר יחידות ה-GPU ל-0:
gcloud run worker-pools update WORKER_POOL --gpu 0
מחליפים את WORKER_POOL בשם של מאגר העובדים של Cloud Run.
YAML
אם אתם יוצרים מאגר עובדים חדש, דלגו על השלב הזה. אם אתם מעדכנים מאגר עובדים קיים, מורידים את הגדרת ה-YAML שלו:
gcloud run worker-pools describe WORKER_POOL --format export > worker-pool.yaml
מוחקים את השורות
nvidia.com/gpu:ו-nodeSelector: run.googleapis.com/accelerator: GPU_TYPE.יוצרים או מעדכנים את מאגר העובדים באמצעות הפקודה הבאה:
gcloud run worker-pools replace worker-pool.yaml
אם קיים קובץ
worker-pool.yaml, הפקודהgcloud run worker-pools replaceמשתמשת בו כברירת מחדל.
ספריות של מנהלי התקנים
כברירת מחדל, כל ספריות הדרייברים של NVIDIA RTX PRO 6000 Blackwell GPU ו-NVIDIA L4 GPU מותקנות בתיקייה /usr/local/nvidia/lib64. מערכת Cloud Run מוסיפה אוטומטית את הנתיב הזה למשתנה הסביבה LD_LIBRARY_PATH (כלומר ${LD_LIBRARY_PATH}:/usr/local/nvidia/lib64) של הקונטיינר עם ה-GPU. כך המקשר הדינמי יכול למצוא את ספריות מנהלי ההתקנים של NVIDIA. ה-linker מחפש ומזהה נתיבים לפי הסדר שמופיע במשתנה הסביבה LD_LIBRARY_PATH. לכל הערכים שמציינים במשתנה הזה יש עדיפות על פני נתיב ברירת המחדל של ספריות מנהלי ההתקנים של Cloud Run /usr/local/nvidia/lib64.
אם רוצים להשתמש בגרסת CUDA שגבוהה מ-13.0, הדרך הכי קלה היא להסתמך על תמונת בסיס חדשה יותר של NVIDIA עם חבילות תאימות קדימה שכבר מותקנות. אפשרות נוספת היא להתקין ידנית את חבילות התאימות קדימה של NVIDIA ולהוסיף אותן ל-LD_LIBRARY_PATH. כדי לדעת אילו גרסאות של CUDA תואמות לגרסה של מנהל ההתקן של NVIDIA שצוינה, אפשר לעיין בטבלת התאימות של NVIDIA.