


Questa guida fornisce una panoramica e un quadro generale delle funzionalità di affidabilità di Pub/Sub.
Perché Pub/Sub?
Come paradigma di messaggistica, il modello publish-subscribe è progettato per disaccoppiare i producer dei messaggi dai consumer di questi messaggi. Anziché inviare richieste dirette ai consumer con i dati, i producer pubblicano i dati in un servizio Pub/Sub come Pub/Sub. Il servizio recapita i messaggi in modo asincrono ai consumer interessati che si sono iscritti.
Il risultato è che il servizio assorbe tutte le complessità della ricerca di consumatori interessati ai dati. Il servizio gestisce anche la frequenza con cui i consumer ricevono i dati, in base alla loro capacità. Il disaccoppiamento consente ai producer di dati di scrivere messaggi su larga scala con bassa latenza, indipendentemente dal comportamento dei consumer.
Pub/Sub offre un recapito dei messaggi altamente scalabile e affidabile. Sebbene il servizio gestisca gran parte di questo processo automaticamente, hai il controllo su diversi aspetti dei publisher e dei sottoscrittori che possono influire sulla disponibilità e sulle prestazioni. Il resto di questa guida fornisce alcuni dettagli su questi aspetti.
Isolamento
Per impostazione predefinita, Pub/Sub è un servizio globale: gli argomenti e le sottoscrizioni non sono intrinsecamente legati a regioni specifiche e i messaggi fluiscono all'interno del servizio Pub/Sub tra le regioni quando necessario. Quando utilizzi l'endpoint globale, pubsub.googleapis.com, i publisher e i sottoscrittori si connettono alla regione più vicina alla rete in cui viene eseguito Pub/Sub. Quando utilizzi gli
endpoint regionali,
come pubsub.us-central1.rep.googleapis.com, o gli
endpoint di località,
come us-central1-pubsub.googleapis.com, i publisher e i sottoscrittori
si connettono a Pub/Sub nella regione specificata. Quando esegui publisher o sottoscrittori al di fuori di Google Cloud, è consigliabile utilizzare endpoint regionali o di località per garantire che i messaggi vengano trasmessi in modo coerente tra le regioni previste.
Isolamento regionale
Per ridurre al minimo l'infrastruttura da cui dipendono le operazioni di pubblicazione e sottoscrizione al di fuori di una singola regione e per garantire che tutti i dati rimangano isolati in quella regione, segui questi passaggi:
Crea un argomento per regione.
Sebbene lo spazio dei nomi di Pub/Sub sia globale e non sia possibile collegare argomenti e sottoscrizioni a una regione specifica, i metadati di tutte le risorse vengono replicati nei datastore locali all'interno della regione. Pertanto, una volta creata una risorsa, la sua configurazione è disponibile anche in caso di problemi in un'altra regione. Tieni presente che gli aggiornamenti alle configurazioni di argomenti o sottoscrizioni potrebbero non essere propagati immediatamente in caso di interruzione.
Evita di utilizzare endpoint globali.
Utilizza invece gli endpoint regionali, se disponibili, e gli endpoint di località, se gli endpoint regionali non sono disponibili. Gli endpoint regionali offrono un maggiore isolamento regionale, ma non sono ancora disponibili in tutte le regioni.
Utilizza una policy di archiviazione dei messaggi e imposta
enforceInTransitsuTrue.Con Applica in transito, i dati non lasciano mai la regione e tutti i client che si connettono all'argomento in una regione specifica impostano la policy di archiviazione dei messaggi su quella regione.
Con gli argomenti configurati in questo modo, puoi avere la certezza che tutte le operazioni di pubblicazione e sottoscrizione scrivano e leggano i dati esclusivamente all'interno della regione. In caso di errori del publisher, del sottoscrittore o di Pub/Sub in una singola regione, la distribuzione dei messaggi si interrompe in quella regione. La pubblicazione dei messaggi su argomenti e sottoscrizioni per altre regioni non è interessata.
Se hai bisogno che anche le operazioni amministrative e lo spazio dei nomi degli argomenti e delle sottoscrizioni siano isolati a livello di regione, valuta la possibilità di utilizzare Managed Service per Apache Kafka.
Failover
Se non hai bisogno dell'isolamento regionale, ti consigliamo di sfruttare la capacità di Pub/Sub di recapitare i messaggi in modo efficiente in più regioni per ottenere funzionalità di failover multiregionale. Il resto di questa sezione spiega come creare argomenti e sottoscrizioni e posizionare publisher e sottoscrittori per supportare diversi tipi di failover e ridondanza dei dati.
Semantica di failover predefinita
Prendiamo il caso in cui siano presenti un singolo argomento e una singola sottoscrizione. I publisher si trovano nelle regioni degli Stati Uniti e dell'Australia, mentre i sottoscrittori si trovano nelle regioni Google Cloud dell'Europa e dell'Australia. Nel caso in cui tutti i sottoscrittori abbiano una capacità sufficiente per ricevere i messaggi, il flusso dei messaggi è il seguente:
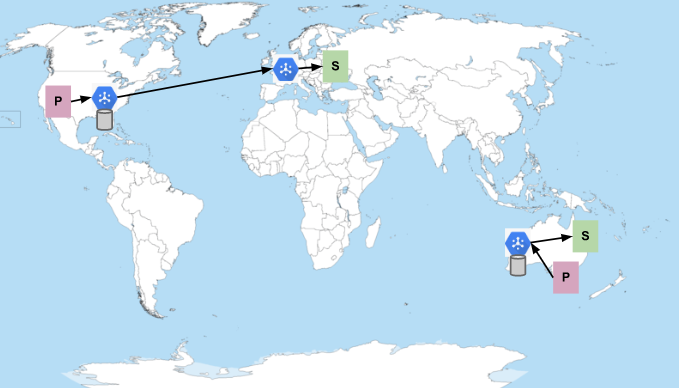
Le P rappresentano i publisher, le S rappresentano i sottoscrittori. L'esagono blu rappresenta il servizio Pub/Sub. I cilindri rappresentano i luoghi in cui vengono archiviati i messaggi (i messaggi vengono sempre resi persistenti in più zone della regione in cui vengono pubblicati). Pub/Sub preferisce inviare i messaggi nella stessa regione in cui sono stati pubblicati quando sono disponibili sottoscrittori. In caso contrario, invia i messaggi alla regione più vicina alla rete con sottoscrittori che hanno capacità. Pertanto, come mostrato nell'immagine precedente, i messaggi pubblicati negli Stati Uniti vengono recapitati ai sottoscrittori in Europa e i messaggi pubblicati in Australia rimangono in Australia.
Le sezioni seguenti descrivono cosa succede in diversi scenari di errore.
I sottoscrittori in Europa non sono disponibili
Supponiamo che i sottoscrittori in Europa siano stati rifiutati o che si siano arrestati in modo anomalo di frequente e non siano in grado di mantenere una connessione a Pub/Sub. In questo caso, il servizio inizierebbe a recapitare i messaggi agli abbonati in Australia:
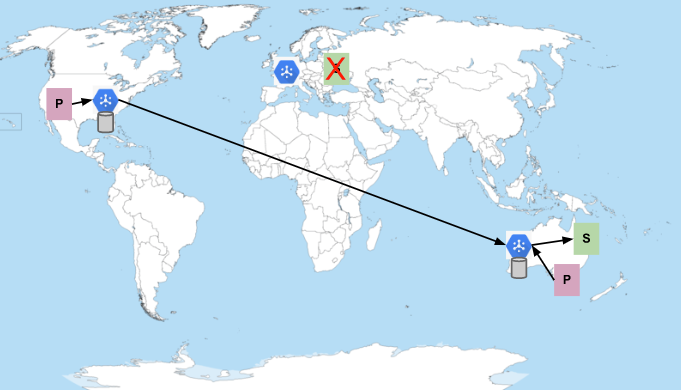
Iscritti in Europa e Australia non disponibili
Nel caso in cui tutti i sottoscrittori non siano disponibili, Pub/Sub archivia i messaggi fino alla durata di conservazione dei messaggi configurata.
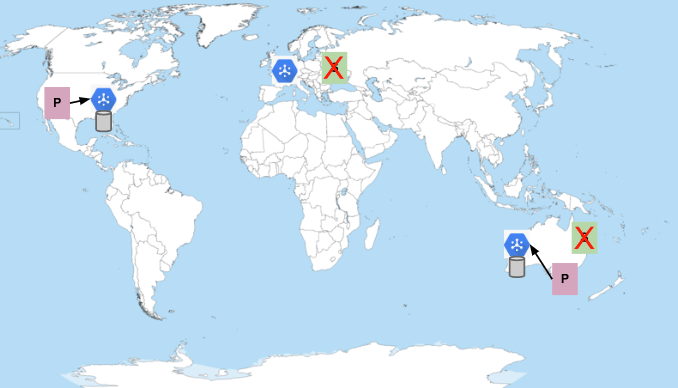
Una volta che i sottoscrittori si riconnettono, i messaggi vengono recapitati, a meno che l'interruzione non duri più della durata di conservazione dei messaggi configurata. Per impostazione predefinita, la conservazione dei messaggi della sottoscrizione è impostata su 7 giorni. Puoi anche configurare la conservazione dei messaggi su un argomento per un massimo di 31 giorni. Non scegliere una durata di conservazione dei messaggi inferiore all'interruzione massima che prevedi o che sei disposto a tollerare.
Pub/Sub non è disponibile in Europa
Anche se rari, potresti anche voler gestire i casi in cui Pub/Sub stesso non è disponibile. La mancata disponibilità di Pub/Sub si manifesta con periodi prolungati di errori imprevisti nelle richieste di pubblicazione o sottoscrizione o con l'impossibilità di recapitare i messaggi pubblicati ai sottoscrittori. Ad esempio, se Pub/Sub non fosse disponibile nella regione in Europa, lo scenario sarebbe molto simile a quello in cui i sottoscrittori non sono disponibili:
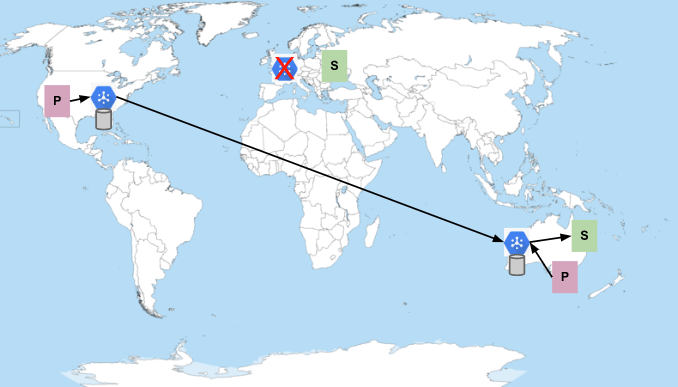
Tieni presente che, in questo caso, i sottoscrittori in Europa non eseguono il failover in un'altra regione, anche se utilizzano l'endpoint globale. Pub/Sub non esegue intenzionalmente il failover automatico. Immagina che siano i sottoscrittori stessi a causare un problema imprevisto in Pub/Sub che ne determina la non disponibilità. Un problema di questo tipo viene trattato come un'interruzione grave. Tuttavia, l'ambito dell'impatto dell'interruzione può essere limitato alla regione a cui si sono connessi i sottoscrittori. Se il servizio consentisse il failover in un'altra regione, i sottoscrittori potrebbero causare l'indisponibilità anche lì, con un conseguente errore a cascata in tutto il servizio.
I publisher in Australia non sono disponibili
Se i publisher in una regione non sono più disponibili, i messaggi già pubblicati vengono comunque recapitati ai sottoscrittori più vicini:
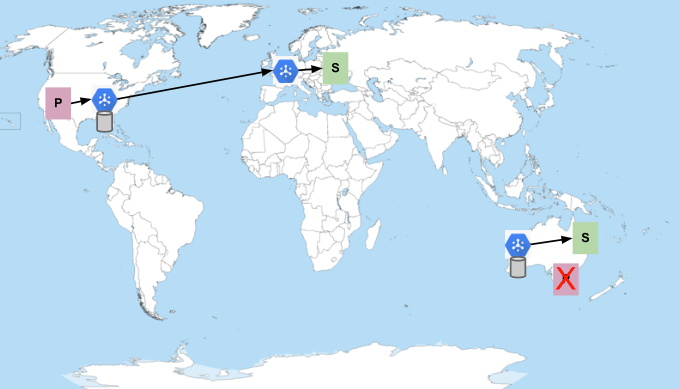
Alla fine, tutti i messaggi vengono utilizzati e confermati dagli iscritti. Quando invia messaggi, Pub/Sub cerca di ridurre al minimo la distanza di rete. Pertanto, i sottoscrittori nella regione in Australia possono smettere di ricevere messaggi se i sottoscrittori in Europa hanno capacità sufficiente per gestire tutti i messaggi pubblicati negli Stati Uniti.
Pub/Sub non è disponibile negli Stati Uniti
Pub/Sub scrive i messaggi in modo sincrono in più zone all'interno di una regione. Pertanto, un'interruzione a livello di zona non è sufficiente per impedire la consegna dei messaggi; l'intera regione deve essere non disponibile. Se Pub/Sub non è disponibile in una regione in cui i publisher inviano messaggi, i messaggi in quella regione potrebbero non essere recapitati fino al completo ripristino del servizio:
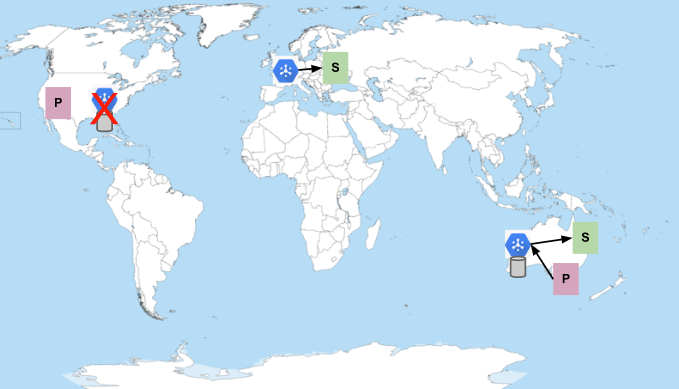
Il messaggio viene comunque recapitato (supponendo che il periodo di conservazione dei messaggi non sia trascorso), con un ritardo pari alla durata dell'interruzione. Tieni presente che, analogamente ai sottoscrittori, anche i publisher negli Stati Uniti non eseguono il failover in un'altra regione in caso di errore del servizio. Questo comportamento contribuisce a prevenire la probabilità di errori a cascata tra regioni a causa di un publisher o un sottoscrittore difettoso.
Failover e ridondanza controllati dal cliente
La semantica di failover predefinita di Pub/Sub potrebbe non garantire completamente che i messaggi possano sempre passare dai publisher ai sottoscrittori in caso di interruzione in qualsiasi punto intermedio. Le interruzioni potrebbero verificarsi in diversi punti, tra cui i client, il servizio su cui vengono eseguiti i publisher o i sottoscrittori, la rete o, anche se raramente, in Pub/Sub stesso. Se hai bisogno che i tuoi servizi siano resilienti a queste interruzioni, devi implementare le tue ridondanze. In genere, queste ridondanze includono l'utilizzo di più istanze di client publisher e subscriber, ognuna delle quali utilizza un endpoint di località diverso.
Potresti voler garantire la resilienza a due diversi ambiti di impatto: a livello di zona o di regione. Di seguito sono riportate le opzioni di configurazione per ciascuna.
Resilienza a livello di zona
Pub/Sub ha una replica tra zone integrata. Non devi adottare misure speciali per gestire le interruzioni in una singola zona che interessano il servizio stesso. Tuttavia, per garantire la resilienza alle interruzioni per i client o la rete, è consigliabile eseguire publisher e sottoscrittori con capacità sufficiente in più zone all'interno della regione. Se una singola zona non è disponibile, i client nell'altra zona possono rilevare il traffico ed elaborare i messaggi. È una best practice non pubblicare contemporaneamente le modifiche a questi client, in modo che, se viene introdotto un bug, le altre zone non modificate possano continuare a elaborare i messaggi.
Resilienza regionale
Per garantire la resilienza in caso di errori a livello di regione, configura ridondanze aggiuntive nei publisher e nei sottoscrittori. Puoi eseguire publisher e sottoscrittori in più regioni per far fronte alla possibilità di interruzioni in questi client o nel networking.
Se vuoi essere resiliente contro potenziali errori di Pub/Sub in una regione, devi disporre di un meccanismo di failover pronto per gestire un'interruzione di questo tipo. I possibili approcci rappresentano un compromesso tra la latenza di recapito dei messaggi end-to-end e i costi.
Per ridurre al minimo la latenza nel caso in cui i costi non siano un problema, la strategia migliore è pubblicare e sottoscrivere sempre contemporaneamente in regioni diverse. Innanzitutto, scegli il numero di regioni in cui vuoi la ridondanza. Successivamente, anche se non è strettamente necessario, puoi configurare un argomento e una sottoscrizione per ciascuna di queste regioni.
Ogni publisher crea un numero di client publisher pari al numero di regioni (uno per ogni regione) e utilizza un endpoint di località diverso per garantire che i messaggi vengano indirizzati a regioni distinte. Se utilizzi argomenti separati, ogni client publisher deve pubblicare nell'argomento corrispondente per regione. Per ogni messaggio, il publisher chiama publish su ogni client. Con le pubblicazioni ridondanti, non è necessario riprovare a pubblicare se una singola pubblicazione non va a buon fine.
Allo stesso modo, ogni sottoscrittore crea un numero di client sottoscrittori pari al numero di regioni (uno per ogni regione) e utilizza un endpoint di località per connettersi a una regione diversa. Se utilizzi abbonamenti diversi per ogni regione, ogni client sottoscrittore deve utilizzare l'abbonamento corrispondente. Tieni presente che le regioni utilizzate per publisher e sottoscrittori non devono necessariamente essere le stesse. I sottoscrittori ricevono i messaggi nelle tre sottoscrizioni e li elaborano.
Questa configurazione presenta diverse funzionalità e requisiti chiave:
- Un'interruzione in una singola regione non influisce sull'elaborazione dei messaggi già pubblicati, né su quelli pubblicati durante l'interruzione. Poiché i messaggi sono stati pubblicati in più regioni, sono ancora disponibili in altre regioni nel caso in cui una regione non sia disponibile. Durante l'interruzione, le chiamate di pubblicazione non vanno a buon fine nella regione interessata, ma vengono eseguite correttamente nelle altre.
- La latenza di elaborazione dei messaggi non è influenzata, purché sia disponibile una delle regioni attraverso cui i messaggi fluiscono.
- L'elaborazione dei messaggi deve essere idempotente. Poiché ogni messaggio verrà recapitato più volte, l'elaborazione dei messaggi deve essere resiliente ai duplicati. In caso di interruzione a livello di regione, alcuni di questi duplicati potrebbero arrivare molto più tardi rispetto alla prima consegna del messaggio. Questi duplicati probabilmente provenivano da una regione diversa che non stava riscontrando un'interruzione.
L'esecuzione con questo tipo di ridondanza offre la massima resilienza a qualsiasi tipo di interruzione. Questa configurazione è preferibile per i servizi Google interni che si basano su Pub/Sub e richiedono la massima disponibilità. Tuttavia, questa configurazione comporta il compromesso di moltiplicare il costo per la distribuzione dei messaggi per il numero di regioni utilizzate. È previsto anche il costo aggiuntivo dell'utilizzo della rete tra regioni per i messaggi che devono essere spostati tra regioni.
Un altro approccio alla ridondanza consiste nel eseguire il failover solo quando le richieste non vanno a buon fine o i messaggi non vengono trasmessi dai publisher ai sottoscrittori come previsto. In questo scenario, hai una regione principale a cui indirizzi i publisher e i sottoscrittori tramite endpoint di località. Come prima, non è necessario che si tratti della stessa regione. Inoltre, hai una regione di riserva per publisher e sottoscrittori che viene utilizzata quando la regione principale non è disponibile.
I publisher pubblicano solo nella regione principale (tramite l'endpoint di località) quando le richieste vengono inviate correttamente. Ogni volta che viene rilevato un problema nella regione, i publisher iniziano a pubblicare nella regione di fallback. La determinazione del fatto che la regione non è attiva e il failover possono essere eseguiti in due modi. Può essere eseguita tramite una procedura manuale e la configurazione viene aggiornata dinamicamente nei publisher. I publisher possono anche aggiornare la configurazione autonomamente se il tasso di errore nelle richieste di pubblicazione è sufficientemente elevato.
I sottoscrittori devono sempre connettersi alla regione principale tramite l'endpoint di località. Puoi decidere che il sottoscrittore può utilizzare la regione di failover con uno o più dei seguenti trigger:
- Sottoscrivi sempre la regione di riserva. In questo caso, il sottoscrittore mantiene sempre una connessione sia alla regione principale sia alla regione di fallback. Le stesse regioni possono essere utilizzate per la regione principale e quella di riserva sia per i publisher che per i sottoscrittori. In questo caso, il sottoscrittore deve ricevere i messaggi tramite la regione di backup solo se il publisher ha eseguito il failover.
- Rileva e trasferisci manualmente i sottoscrittori alla regione di riserva tramite una configurazione. Se rilevi un'interruzione, puoi eseguire il failover alla regione di riserva e poi tornare alla regione principale quando l'interruzione è terminata.
- Failover in caso di errori del sottoscrittore. Se le richieste del sottoscrittore restituiscono errori, puoi utilizzarle come indicazione che devi eseguire il failover nella regione di fallback. Tieni presente che le librerie client Pub/Sub riprovano internamente le richieste di pull in modalità flusso in caso di errori temporanei, pertanto potresti non essere in grado di rilevare la presenza di lunghi periodi di errori imprevisti. Inoltre, il tasso di errore di pull in streaming dovrebbe essere del 100%, anche durante il normale funzionamento.
- Esegui il failover se il sottoscrittore trascorre un periodo di tempo inaspettatamente lungo senza ricevere messaggi. Supponendo che la pubblicazione dei messaggi sia coerente, gli abbonati possono sempre ricevere messaggi. Se trascorre un periodo di tempo prolungato senza ricevere messaggi, potrebbe esserci un problema lato sottoscrizione in Pub/Sub nella regione principale. Questo problema viene risolto eseguendo il failover alla regione di failover.
Tra le quattro opzioni, la prima è quella ideale. Una connessione di un sottoscrittore non comporta costi se non vengono trasmessi messaggi. L'unico costo è l'impatto dell'istanza aggiuntiva della libreria client del sottoscrittore, che può essere trascurabile. Devi anche tenere presente la quota del numero di connessioni pull di streaming aperte per regione.
Il vantaggio di questo secondo modello è che non esiste un moltiplicatore nel costo di Pub/Sub, poiché i messaggi vengono pubblicati una sola volta. Tuttavia, il compromesso è che per determinati tipi di interruzioni, i messaggi pubblicati prima dell'inizio dell'interruzione potrebbero non essere disponibili fino alla risoluzione dell'interruzione. I messaggi archiviati nella regione non disponibile potrebbero non essere recapitati agli iscritti, indipendentemente dalla loro posizione. I messaggi pubblicati durante l'interruzione nella regione di fallback possono essere disponibili. Inoltre, potrebbe verificarsi un periodo di indisponibilità con tassi di errore più elevati per i publisher o i sottoscrittori. Questo dipende dal metodo utilizzato per rilevare un'interruzione e dal tempo necessario per eseguire il failover nella regione di riserva.
Indipendentemente dall'opzione scelta, tieni presente come questa potrebbe interagire con le funzionalità di Pub/Sub. Sia la consegna ordinata sia la consegna "exactly-once" offrono le loro garanzie all'interno di una regione. Ad esempio, se utilizzi la tecnica di ridondanza del failover, la consegna dei messaggi è garantita solo per i messaggi pubblicati nella stessa regione. Il sottoscrittore potrebbe ricevere i messaggi pubblicati nella regione di riserva prima di quelli pubblicati nella regione principale, anche se i messaggi sono stati pubblicati prima nella regione principale.
Publisher di ottimizzazione
Indipendentemente dalle opzioni di failover scelte, esistono alcuni passaggi di ottimizzazione aggiuntivi da eseguire all'interno dei publisher stessi. La regolazione del comportamento del publisher garantisce prestazioni ottimali in caso di carico elevato. L'invio di messaggi in batch è un modo per scambiare la latenza con un costo ridotto, ma non è un problema di affidabilità e pertanto non viene trattato qui. Concentrati invece su alcuni degli altri parametri utili per ottimizzare l'affidabilità, tra cui le impostazioni dei nuovi tentativi e del controllo di flusso.
Le pubblicazioni possono non riuscire per diversi motivi, tra cui problemi temporanei come la mancata disponibilità della rete o problemi che richiedono l'intervento dell'utente, come le modifiche alle autorizzazioni. La libreria client Pub/Sub riprova gli errori temporanei utilizzando i parametri specificati nelle impostazioni dei nuovi tentativi. Queste impostazioni controllano il comportamento del backoff esponenziale sui nuovi tentativi di RPC di pubblicazione che non vanno a buon fine per motivi temporanei. Sebbene le impostazioni predefinite possano funzionare bene nella maggior parte degli scenari, in alcune situazioni potresti voler ottimizzare questi valori.
Le due proprietà che molto probabilmente vorrai ottimizzare sono il timeout RPC iniziale e il timeout totale. Il timeout RPC iniziale è il tempo concesso alla prima RPC di pubblicazione per essere completata. Se una RPC non riesce o scade, ne viene provata un'altra con un timeout più lungo fino a quando non viene superato il numero totale di richieste o il timeout totale.
Il timeout iniziale può essere ottimizzato se il publisher ha una rete limitata o si trova lontano dal data center Google Cloud più vicino che esegue Pub/Sub. I vincoli di rete potrebbero essere limitazioni alla velocità effettiva della macchina su cui è in esecuzione il publisher o potrebbero essere il risultato di altri servizi in esecuzione sulla stessa macchina che richiedono un uso intensivo della rete. Se il timeout è impostato su un valore troppo breve, le RPC iniziali potrebbero non riuscire ripetutamente, richiedendo più tentativi (con timeout più lunghi) per la pubblicazione. La necessità ripetuta di nuovi tentativi aumenta la latenza di pubblicazione. In questo caso, l'aumento del timeout iniziale potrebbe velocizzare le pubblicazioni.
Se la connessione di rete non è affidabile, potrebbe essere utile aumentare il timeout totale e il timeout iniziale. Un timeout totale maggiore offre all'RPC di pubblicazione più tempo per essere completato correttamente. Quando le RPC di pubblicazione non vanno a buon fine in modo coerente con errori di scadenza superata, valuta la possibilità di ottimizzare questi valori.
Gli errori di superamento della scadenza continui durante la pubblicazione possono anche indicare la necessità di ottimizzare il controllo di flusso del publisher. Queste impostazioni ti consentono di assicurarti che i publisher siano resilienti ai picchi di traffico in entrata che generano più messaggi da inviare a Pub/Sub. Un aumento significativo delle richieste in uscita potrebbe sovraccaricare la CPU, la memoria o la capacità di rete del publisher. Quando la pubblicazione è sovraccarica, non è in grado di elaborare le richieste o le risposte di pubblicazione prima dei timeout. Ciò comporta un numero ancora maggiore di richieste di pubblicazione e, in ultima analisi, il raggiungimento del timeout totale. Il controllo di flusso del publisher limita il numero di messaggi o byte che possono essere in sospeso senza una risposta dalla richiesta di pubblicazione. Limitare il numero di richieste in questo modo mantiene l'utilizzo delle risorse a un livello gestibile, anche durante i picchi. A seconda di come opera il publisher, puoi consentire alle RPC di pubblicazione successive di attendere la capacità consentendo alla pubblicazione di bloccare ulteriori richieste. In alternativa, puoi respingere i chiamanti del tuo servizio facendo in modo che il controllo di flusso restituisca un errore quando viene raggiunta la capacità. Puoi configurare il modo in cui la libreria client del publisher risponde con il comportamento di superamento del limite.
Iscritti all'ottimizzazione
Potrebbe anche essere necessario ottimizzare i sottoscrittori per garantire che funzionino in modo affidabile. Come per i publisher, puoi regolare le impostazioni di controllo del flusso dei sottoscrittori per assicurarti che non vengano sovraccaricati. La libreria client del sottoscrittore utilizza la modalità pull in streaming, in cui il client apre uno stream permanente verso il server e il server invia i messaggi non appena diventano disponibili. In caso di un forte aumento dei messaggi pubblicati, il sottoscrittore potrebbe ricevere più messaggi di quanti ne possa elaborare. Con il controllo di flusso attivo, il numero di messaggi non confermati in sospeso per il client alla volta è limitato. In questo modo, il numero di messaggi gestiti contemporaneamente viene ridotto e la loro elaborazione viene distribuita su un periodo di tempo più lungo. La distribuzione del carico consente ai sottoscrittori di rispettare eventuali limitazioni delle risorse che influiscono sull'elaborazione dei messaggi, il che potrebbe comportare un effetto a cascata che si traduce nell'impossibilità di elaborare i messaggi.
Il controllo di flusso da solo è sufficiente se prevedi solo picchi nella quantità di dati da elaborare che alla fine diminuiscono. Se il traffico aumenta generalmente nel tempo a causa di un maggiore utilizzo, il controllo di flusso protegge i sottoscrittori. Tuttavia, potrebbe generare un backlog che continua ad accumularsi e impedisce la consegna dei messaggi prima della scadenza della durata di conservazione dei messaggi. In questi casi, potresti anche voler impostare la scalabilità automatica in modo da attivare più sottoscrittori in risposta a un numero crescente di messaggi non confermati. La configurazione dipende dalla piattaforma di computing che utilizzi per i tuoi sottoscrittori. Ad esempio, il gestore della scalabilità automatica di Compute Engine ti consente di scalare in base a metriche come il numero di messaggi non recapitati. L'utilizzo della scalabilità automatica e del controllo di flusso consente di garantire che i sottoscrittori siano resilienti ad altri picchi a breve termine nel throughput dei messaggi e alla crescita a lungo termine che richiede una maggiore potenza di calcolo. Assicurati di seguire le best practice per l'utilizzo delle metriche Pub/Sub come indicatore di scalabilità.
Utilizza la versione regionale delle metriche di backlog anziché le versioni globali
Quando monitori il backlog delle sottoscrizioni, configuri le policy di avviso o
esegui la scalabilità automatica dei sottoscrittori, Pub/Sub offre due versioni di ogni
metrica di backlog. Assicurati di utilizzare le versioni con il suffisso by_region:
Non utilizzare le versioni globali di queste metriche (subscription/num_undelivered_messages e subscription/oldest_unacked_message_age) se vuoi che il monitoraggio, gli avvisi e la scalabilità automatica siano resilienti alle interruzioni in una singola regione. Le versioni globali di queste metriche richiedono il calcolo del backlog in tutte le regioni in cui sono presenti messaggi, il che significa che l'indisponibilità in una singola regione comporta un gap di dati. Al contrario, le versioni by_region delle metriche calcolano e segnalano il backlog su base regionale. Se non è possibile calcolare il backlog per una singola regione, la metrica continua a segnalare i valori per le altre regioni.
Utilizza snapshot e ricerca per deployment sicuri
La perdita di messaggi è in genere un evento catastrofico. Pub/Sub offre la distribuzione "at-least-once" per tutti i messaggi pubblicati. Tuttavia, l'elaborazione corretta di questi messaggi dipende dal comportamento del sottoscrittore. Se i messaggi vengono confermati correttamente, Pub/Sub non li invia nuovamente. Pertanto, un bug introdotto nel nuovo codice del sottoscrittore di cui esegui il deployment che conferma i messaggi senza averli elaborati correttamente potrebbe comportare la perdita di messaggi indotta dal sottoscrittore. Pub/Sub offre la funzionalità di snapshot e ricerca, che può aiutarti a garantire l'elaborazione corretta di ogni messaggio, anche in presenza di bug del sottoscrittore.
Il pattern per ogni deployment di un sottoscrittore deve essere il seguente:
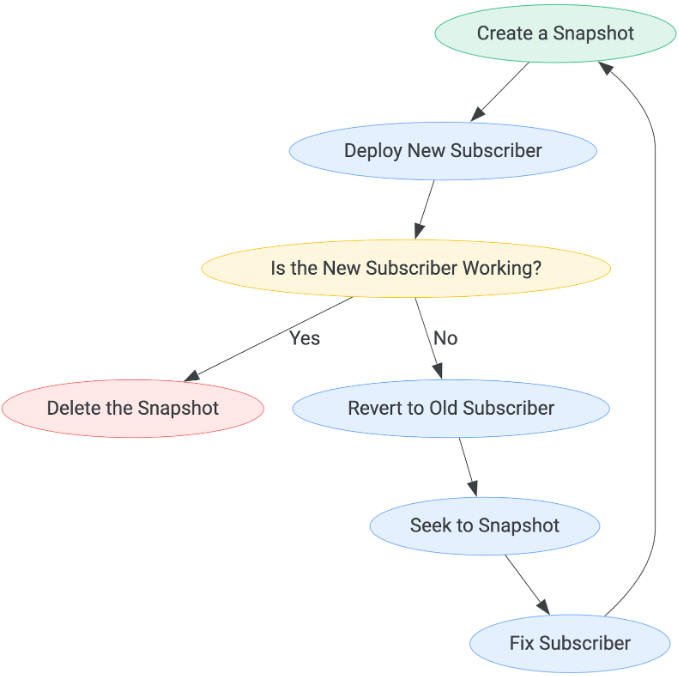
Il tempo di attesa prima di determinare se il nuovo sottoscrittore funziona può variare in base al caso d'uso. L'unico modo per uscire dal flusso di passaggi è quando un sottoscrittore viene considerato funzionante, momento in cui lo snapshot può essere eliminato.
L'utilizzo di snapshot e ricerca non è destinato a sostituire le best practice relative alla prima esecuzione del software in un ambiente non di produzione e al deployment graduale in produzione. Forniscono un livello di protezione aggiuntivo per garantire l'elaborazione affidabile dei dati. Il compromesso è che la ricerca dello snapshot potrebbe comportare la consegna duplicata dei messaggi che il sottoscrittore ha elaborato correttamente. Tuttavia, dato che Pub/Sub ha una semantica di distribuzione "at-least-once" per impostazione predefinita, i tuoi sottoscrittori sono già resilienti al nuovo invio dei messaggi.