


Ce guide décrit les fonctionnalités de fiabilité de Pub/Sub et en fournit une vue d'ensemble.
Pourquoi Pub/Sub ?
En tant que paradigme de messagerie, le modèle de publication/abonnement est conçu pour dissocier les producteurs de messages des consommateurs de ces messages. Au lieu que les producteurs envoient des requêtes directes aux consommateurs avec les données, ils les publient dans un service Pub/Sub tel que Pub/Sub. Le service distribue ces messages de manière asynchrone aux clients intéressés qui se sont abonnés.
Le service absorbe ainsi toutes les complexités liées à la recherche de consommateurs intéressés par les données. Le service gère également le débit auquel les consommateurs reçoivent les données, en fonction de leur capacité. Le découplage permet aux producteurs de données d'écrire des messages à grande échelle avec une faible latence, indépendamment du comportement des consommateurs.
Pub/Sub offre une distribution de messages hautement évolutive et fiable. Bien que le service gère automatiquement une grande partie de ces aspects, vous pouvez contrôler différents aspects de vos éditeurs et abonnés qui peuvent affecter la disponibilité et les performances. Le reste de ce guide fournit des détails sur ces aspects.
Isolation
Par défaut, Pub/Sub est un service mondial : les sujets et les abonnements ne sont pas intrinsèquement liés à des régions spécifiques, et les messages circulent au sein du service Pub/Sub entre les régions si nécessaire. Lorsque vous utilisez le point de terminaison mondial, pubsub.googleapis.com, les éditeurs et les abonnés se connectent à la région la plus proche du réseau où Pub/Sub s'exécute. Lorsque vous utilisez des points de terminaison régionaux, tels que pubsub.us-central1.rep.googleapis.com, ou des points de terminaison localisés, tels que us-central1-pubsub.googleapis.com, les éditeurs et les abonnés se connectent à Pub/Sub dans la région spécifiée. Lorsque vous exécutez des éditeurs ou des abonnés en dehors de Google Cloud, il est préférable d'utiliser des points de terminaison régionaux ou géographiques pour vous assurer que les messages circulent de manière cohérente entre les régions attendues.
Isolation régionale
Pour minimiser l'infrastructure dont dépendent les opérations de publication et d'abonnement en dehors d'une seule région et pour vous assurer que toutes les données restent isolées dans cette région, procédez comme suit :
Créez un sujet par région.
Bien que l'espace de noms de Pub/Sub soit global et que vous ne puissiez pas lier des sujets et des abonnements à une région spécifique, les métadonnées de toutes les ressources sont répliquées dans des datastores locaux de la région. Par conséquent, une fois que vous avez créé une ressource, sa configuration est disponible même en cas de problème dans une autre région. Notez que les mises à jour des configurations de sujet ou d'abonnement peuvent ne pas se propager immédiatement en cas de panne.
Évitez d'utiliser des points de terminaison globaux.
Utilisez plutôt des points de terminaison régionaux lorsqu'ils sont disponibles et des points de terminaison localisés lorsqu'ils ne le sont pas. Les points de terminaison régionaux offrent une meilleure isolation régionale, mais ne sont pas encore disponibles dans toutes les régions.
Utilisez une règle de stockage des messages et définissez
enforceInTransitsurTrue.Avec l'option Appliquer en transit, les données ne quittent jamais la région, et tous les clients qui se connectent au sujet dans une région spécifique définissent la règle de stockage des messages sur cette région.
Avec des sujets configurés de cette manière, vous pouvez être sûr que toutes les opérations de publication et d'abonnement écrivent et lisent des données exclusivement dans la région. En cas de défaillance d'un éditeur, d'un abonné ou de Pub/Sub dans une seule région, la distribution des messages s'arrête dans cette région. La distribution des messages sur les sujets et les abonnements des autres régions n'est pas affectée.
Si vous avez besoin que les opérations d'administration et l'espace de noms de vos sujets et abonnements soient également isolés au niveau régional, envisagez d'utiliser Managed Service pour Apache Kafka.
Basculement
Si vous n'avez pas besoin d'isolation régionale, vous pouvez tirer parti de la capacité de Pub/Sub à distribuer efficacement des messages dans plusieurs régions afin d'obtenir des fonctionnalités de basculement multirégional. Le reste de cette section explique comment créer des sujets et des abonnements, et placer des éditeurs et des abonnés afin de prendre en charge différents types de basculement et de redondance des données.
Sémantique de basculement par défaut
Prenons l'exemple d'un sujet et d'un abonnement uniques. Les éditeurs se trouvent dans des régions des États-Unis et d'Australie, et les abonnés se trouvent dans les régions Google Cloud d'Europe et d'Australie. Si tous les abonnés disposent d'une capacité suffisante pour recevoir des messages, le flux de messages se présente comme suit :
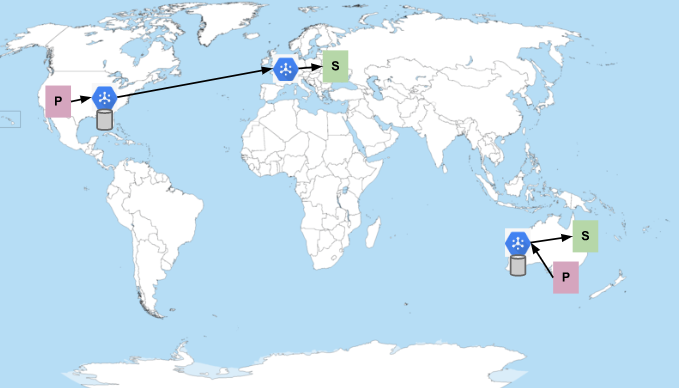
Les P représentent les éditeurs, et les S, les abonnés. L'hexagone bleu représente le service Pub/Sub. Les cylindres représentent les emplacements où les messages sont stockés (les messages sont toujours conservés dans plusieurs zones de la région où ils sont publiés). Pub/Sub préfère envoyer les messages dans la région où ils ont été publiés lorsque des abonnés sont disponibles. Sinon, il envoie les messages à la région la plus proche du réseau avec des abonnés disposant de capacité. Par conséquent, comme illustré dans l'image précédente, les messages publiés aux États-Unis sont distribués aux abonnés en Europe, et les messages publiés en Australie restent en Australie.
Les sections suivantes décrivent ce qui se passe dans différents scénarios de défaillance.
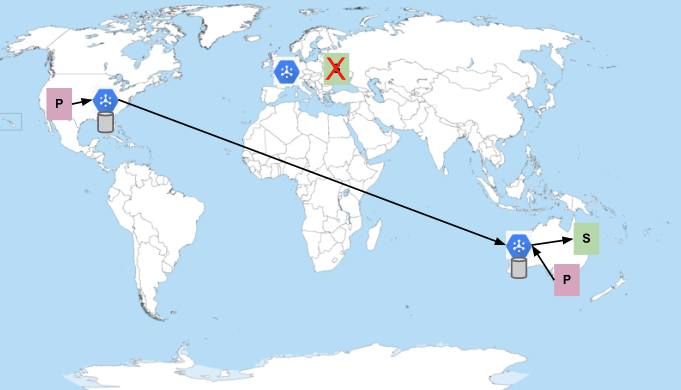
Les abonnés en Europe ne sont pas disponibles
Supposons que les abonnés en Europe soient refusés ou qu'ils plantent fréquemment, et qu'ils ne puissent pas maintenir une connexion à Pub/Sub. Dans ce cas, le service commencerait à envoyer des messages aux abonnés en Australie :
Les abonnés en Europe et en Australie ne sont pas disponibles
Si tous les abonnés sont indisponibles, Pub/Sub stocke les messages jusqu'à la durée de conservation des messages configurée.
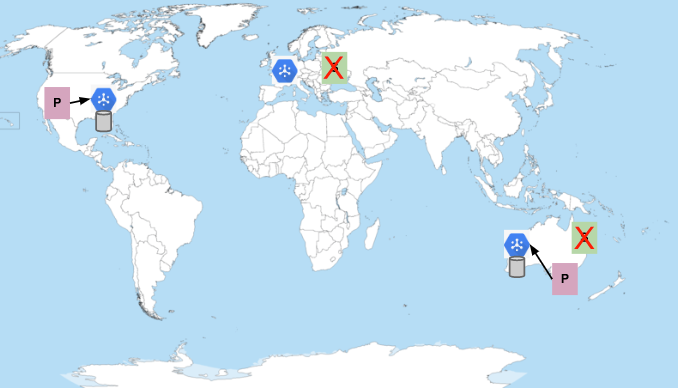
Une fois que les abonnés se reconnectent, les messages sont distribués, sauf si la panne dure plus longtemps que la durée de conservation des messages configurée. Par défaut, la conservation des messages d'abonnement est définie sur sept jours. Vous pouvez également configurer la conservation des messages sur un sujet pendant 31 jours maximum. Ne choisissez pas une durée de conservation des messages inférieure à la durée d'indisponibilité maximale que vous prévoyez ou que vous êtes prêt à tolérer.
Pub/Sub n'est pas disponible en Europe
Bien que cela soit rare, vous pouvez également être amené à gérer les cas où Pub/Sub n'est pas disponible. L'indisponibilité de Pub/Sub se manifeste par des périodes prolongées d'erreurs inattendues sur les requêtes de publication ou d'abonnement, ou par l'impossibilité de distribuer les messages publiés aux abonnés. Par exemple, si Pub/Sub était indisponible dans la région européenne, le scénario serait très similaire à celui où les abonnés sont indisponibles :
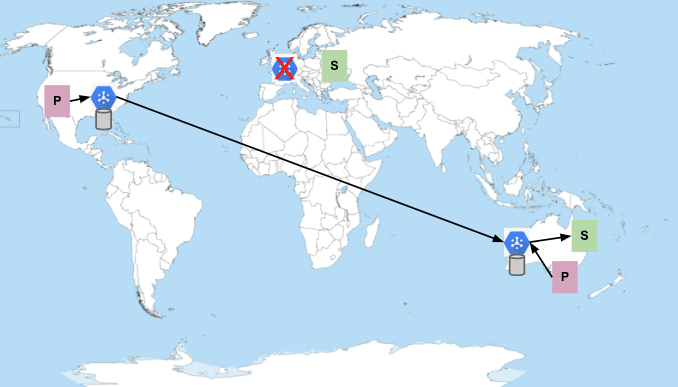
Notez que, dans ce cas, les abonnés en Europe ne basculent pas vers une autre région, même s'ils utilisent le point de terminaison global. Pub/Sub ne bascule pas automatiquement, et ce de manière intentionnelle. Imaginez que ce sont les abonnés eux-mêmes qui causent un problème inattendu dans Pub/Sub, entraînant une indisponibilité. Un tel problème est traité comme une panne majeure. Toutefois, l'impact de la panne peut être limité à la région à laquelle les abonnés se sont connectés. Si le service leur permettait de basculer vers une autre région, les abonnés pourraient également y provoquer une indisponibilité, ce qui entraînerait une défaillance en cascade dans l'ensemble du service.
Les éditeurs en Australie ne sont pas disponibles
Si les éditeurs d'une région deviennent indisponibles, les messages déjà publiés sont toujours distribués aux abonnés les plus proches :
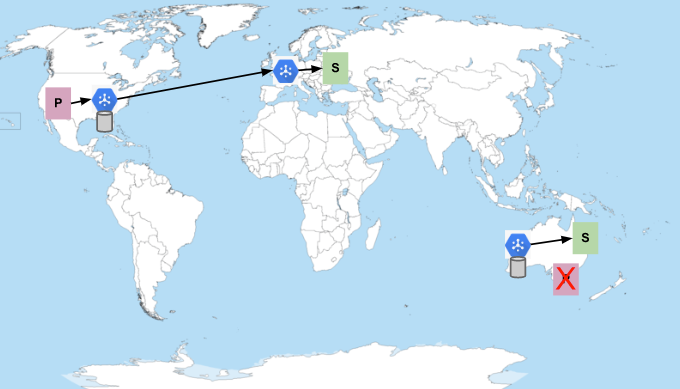
Tous les messages sont ensuite consommés et confirmés par les abonnés. Lors de l'envoi de messages, Pub/Sub tente de minimiser la distance réseau. Par conséquent, les abonnés de la région Australie peuvent cesser de recevoir des messages si les abonnés d'Europe ont une capacité suffisante pour gérer tous les messages publiés aux États-Unis.
Pub/Sub n'est pas disponible aux États-Unis
Pub/Sub écrit les messages de manière synchrone dans plusieurs zones d'une région. Par conséquent, une panne zonale ne suffit pas à empêcher la distribution des messages. Il faut que toute la région soit indisponible. Si Pub/Sub devient indisponible dans une région où les éditeurs envoient des messages, il est possible que les messages de cette région ne soient pas distribués tant que le service n'est pas entièrement restauré :
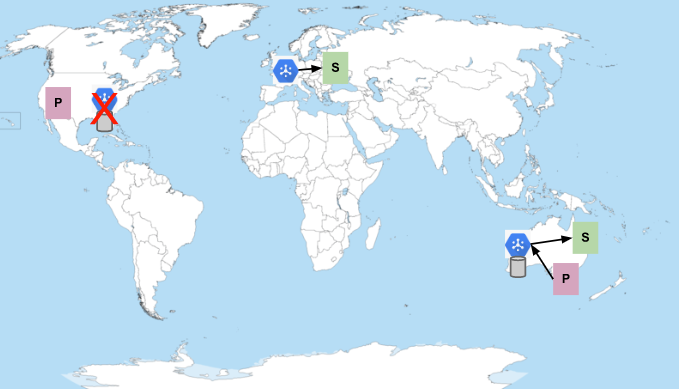
Le message est toujours distribué (en supposant que la durée de conservation du message n'est pas dépassée), avec un retard correspondant à la durée de la panne. Notez que, comme les abonnés, les éditeurs situés aux États-Unis ne basculent pas vers une autre région en cas de défaillance du service. Ce comportement permet d'éviter les défaillances en cascade dans plusieurs régions en raison d'un éditeur ou d'un abonné défaillant.
Basculement et redondance contrôlés par le client
La sémantique de basculement par défaut de Pub/Sub ne garantit pas toujours que les messages puissent circuler des éditeurs aux abonnés en cas de panne entre les deux. Des pannes peuvent se produire à plusieurs endroits, y compris au niveau de vos clients, du service sur lequel vos éditeurs ou abonnés s'exécutent, du réseau ou, plus rarement, de Pub/Sub lui-même. Si vous avez besoin que vos services soient résilients à de telles pannes, vous devez mettre en œuvre vos propres redondances. En règle générale, ces redondances incluent l'utilisation de plusieurs instances de clients éditeurs et abonnés, chacune utilisant un point de terminaison d'emplacement différent.
Vous pouvez souhaiter une résilience pour deux champs d'application différents : zonal ou régional. Voici les options de configuration pour chacune d'elles.
Résilience zonale
Pub/Sub intègre une fonctionnalité de réplication interzone. Vous n'avez pas besoin de prendre de mesures particulières pour gérer les pannes monozones qui affectent le service lui-même. Toutefois, pour assurer la résilience de vos clients ou de votre réseau en cas de panne, il est préférable d'exécuter des éditeurs et des abonnés avec une capacité suffisante dans plusieurs zones de la région. Si une seule zone est indisponible, les clients de l'autre zone peuvent récupérer le trafic et traiter les messages. Il est recommandé de ne pas publier simultanément les modifications apportées à ces clients afin que, si un bug est introduit, les autres zones non affectées puissent continuer à traiter les messages.
Résilience régionale
Pour assurer la résilience face aux défaillances régionales, configurez des redondances supplémentaires dans vos éditeurs et abonnés. Vous pouvez exécuter des éditeurs et des abonnés dans plusieurs régions pour faire face à d'éventuelles pannes de ces clients ou du réseau.
Si vous souhaitez être résilient face aux défaillances potentielles de Pub/Sub dans une région, vous devez disposer d'un mécanisme de basculement prêt à gérer une telle panne. Les approches possibles sont un compromis entre la latence de distribution des messages de bout en bout et votre coût.
Pour minimiser la latence dans le cas où le coût n'est pas un problème, la meilleure stratégie consiste à toujours publier et s'abonner simultanément dans différentes régions. Tout d'abord, choisissez le nombre de régions dans lesquelles vous souhaitez une redondance. Ensuite, même si ce n'est pas strictement nécessaire, vous pouvez configurer un sujet et un abonnement pour chacune de ces régions.
Chaque éditeur crée autant de clients éditeurs qu'il y a de régions (un pour chaque région) et utilise un point de terminaison d'emplacement différent pour s'assurer que les messages sont dirigés vers des régions distinctes. Si vous utilisez des sujets distincts, chaque client éditeur doit publier dans le sujet correspondant à chaque région. Pour chaque message, l'éditeur appelle la méthode publish sur chaque client. Grâce aux publications redondantes, il n'est pas nécessaire de relancer les publications si l'une d'elles échoue.
De même, chaque abonné crée autant de clients d'abonné (un pour chaque région) et utilise un point de terminaison d'emplacement pour se connecter à une autre région. Si vous utilisez des abonnements différents pour chaque région, chaque client abonné doit utiliser l'abonnement correspondant. Notez que les régions utilisées pour les éditeurs et les abonnés ne doivent pas nécessairement être les mêmes. Les abonnés reçoivent les messages via les trois abonnements et les traitent.
Cette configuration présente plusieurs caractéristiques et exigences clés :
- Une panne limitée à une seule région n'affecte pas le traitement des messages déjà publiés, ni ceux publiés pendant la panne. Comme les messages ont été publiés dans plusieurs régions, ils restent disponibles dans les autres régions en cas de panne de l'une d'entre elles. Pendant la panne, les appels de publication échouent dans la région concernée, mais aboutissent dans les autres.
- La latence de traitement des messages n'est pas affectée tant que l'une des régions par lesquelles les messages transitent est disponible.
- Le traitement des messages doit être idempotent. Étant donné que chaque message sera distribué plusieurs fois, le traitement des messages doit être résilient aux doublons. En cas de panne régionale, certains de ces doublons peuvent arriver bien plus tard que la première distribution du message. Ces doublons provenaient probablement d'une autre région qui ne subissait pas de panne.
L'exécution avec ce type de redondance offre la plus grande résilience à tout type de panne. Cette configuration est privilégiée pour les services Google internes qui s'appuient sur Pub/Sub et nécessitent une disponibilité maximale. Cependant, cette configuration implique de multiplier le coût de distribution des messages par le nombre de régions utilisées. Il faut également prendre en compte le coût supplémentaire de l'utilisation du réseau interrégional pour les messages qui doivent être transférés d'une région à l'autre.
Une autre approche de la redondance consiste à ne basculer que lorsque les requêtes échouent ou que les messages ne circulent pas comme prévu entre les éditeurs et les abonnés. Dans ce scénario, vous disposez d'une région principale vers laquelle vous dirigez vos éditeurs et vos abonnés via des points de terminaison d'emplacement. Comme précédemment, il n'est pas nécessaire qu'il s'agisse de la même région. Vous disposez également d'une région de remplacement pour les éditeurs et les abonnés, qui est utilisée lorsque la région principale n'est pas disponible.
Les éditeurs ne publient que dans la région principale (via le point de terminaison localisé) lorsque ses requêtes sont envoyées avec succès. Chaque fois que la région est considérée comme indisponible, les éditeurs commencent à publier dans la région de remplacement. Il existe deux façons de déterminer si la région est indisponible et de basculer vers une autre région. Cela peut être fait manuellement, et la configuration est mise à jour de manière dynamique dans les éditeurs. Les éditeurs peuvent également mettre à jour eux-mêmes la configuration si le taux d'erreur dans les requêtes de publication est suffisamment élevé.
Les abonnés doivent toujours se connecter à la région principale via le point de terminaison régional. Vous pouvez décider que l'abonné peut utiliser la région de remplacement avec un ou plusieurs des déclencheurs suivants :
- Abonnez-vous toujours à la région de remplacement. Dans ce cas, l'abonné maintient une connexion à la fois à la région principale et à la région de remplacement. Les mêmes régions peuvent être utilisées pour la région principale et la région de remplacement pour les éditeurs et les abonnés. Dans ce cas, l'abonné ne doit recevoir des messages via la région de sauvegarde que si l'éditeur a basculé.
- Détectez et basculez manuellement les abonnés vers la région de remplacement via une configuration. Si vous détectez une panne, vous pouvez basculer vers la région de remplacement, puis revenir à la région principale une fois la panne résolue.
- Basculer en cas d'erreurs d'abonné. Si les requêtes des abonnés renvoient des erreurs, cela peut indiquer que vous devez basculer vers la région de remplacement. Notez que les bibliothèques clientes Pub/Sub relancent en interne les requêtes d'extraction par flux en cas d'erreurs temporaires. Il se peut donc que vous ne puissiez pas détecter les longues périodes d'erreurs inattendues. De plus, le taux d'erreur de la requête pull en flux continu devrait être de 100 %, même en fonctionnement normal.
- Effectuez un basculement si l'abonné passe un temps anormalement long sans recevoir de messages. En supposant que la publication des messages est cohérente, les abonnés peuvent toujours recevoir des messages. Si une période prolongée s'écoule sans qu'ils ne reçoivent de messages, il peut y avoir un problème côté abonnement dans Pub/Sub dans la région principale. Ce problème est résolu par le basculement vers la région de remplacement.
Parmi les quatre options, la première est idéale. Une connexion d'abonné ne coûte rien si aucun message n'y circule. Le seul coût est l'empreinte de l'instance supplémentaire de la bibliothèque cliente de l'abonné, qui peut être négligeable. Vous devez également tenir compte du quota de connexions d'extraction en flux continu ouvertes par région.
L'avantage de ce deuxième modèle est qu'il n'y a pas de multiplicateur dans le coût de Pub/Sub, car les messages ne sont publiés qu'une seule fois. Toutefois, le compromis est que, pour certains types de pannes, les messages publiés avant le début de la panne peuvent ne pas être disponibles tant que la panne n'est pas résolue. Les messages stockés dans la région indisponible ne peuvent pas être distribués aux abonnés, quel que soit l'endroit où ils sont connectés. Les messages publiés dans la région de remplacement pendant la panne peuvent être disponibles. De plus, il peut y avoir une période d'indisponibilité avec des taux d'erreur accrus pour les éditeurs ou les abonnés. Cela dépend de la méthode utilisée pour détecter une panne et du temps nécessaire pour basculer vers la région de remplacement.
Quelle que soit l'option choisie, tenez compte de la manière dont elle peut interagir avec les fonctionnalités de Pub/Sub. La distribution ordonnée et la distribution de type "exactement une fois" offrent leurs garanties dans une région. Par exemple, si vous utilisez la technique de redondance de basculement, la distribution des messages n'est garantie que pour les messages publiés dans la même région. L'abonné peut recevoir des messages publiés dans la région de remplacement avant les messages publiés dans la région principale, même si les messages ont d'abord été publiés dans la région principale.
Affinage des éditeurs
Quelle que soit l'option de basculement que vous choisissez, vous devez effectuer des étapes de réglage supplémentaires dans les éditeurs eux-mêmes. Le réglage du comportement de l'éditeur garantit des performances optimales en cas de charge élevée. Le traitement par lot des messages est un moyen de réduire les coûts au détriment de la latence, mais il ne s'agit pas d'un problème de fiabilité. Il n'est donc pas abordé ici. Concentrez-vous plutôt sur d'autres paramètres utiles pour régler la fiabilité, y compris les paramètres de nouvelle tentative et de contrôle de flux.
Les publications peuvent échouer pour différentes raisons, y compris des raisons temporaires comme l'indisponibilité du réseau ou des raisons nécessitant l'intervention de l'utilisateur, comme des modifications d'autorisation. La bibliothèque cliente Pub/Sub relance les erreurs temporaires à l'aide des paramètres spécifiés dans les paramètres de nouvelle tentative. Ces paramètres contrôlent le comportement de l'intervalle exponentiel entre les tentatives de publication de RPC qui échouent pour des raisons temporaires. Bien que les paramètres par défaut fonctionnent généralement bien dans la plupart des scénarios, il peut arriver que vous souhaitiez ajuster ces valeurs.
Les deux propriétés que vous êtes le plus susceptible de vouloir régler sont le délai RPC avant expiration initial et le délai avant expiration total. Le délai RPC avant expiration initial correspond au temps accordé au premier RPC de publication pour se terminer. Si un RPC échoue ou expire, un autre est tenté avec un délai avant expiration plus long, jusqu'à ce que le nombre total de requêtes ou le délai avant expiration total soit dépassé.
Le délai avant expiration initial peut être ajusté si votre éditeur est limité par le réseau ou s'il est éloigné du centre de données Google Cloud le plus proche qui exécute Pub/Sub. Les contraintes réseau peuvent être des limites de débit de la machine sur laquelle le diffuseur s'exécute, ou elles peuvent résulter d'autres services s'exécutant sur la même machine et utilisant le réseau de manière intensive. Si le délai avant expiration est trop court, les RPC initiaux peuvent échouer à plusieurs reprises, ce qui nécessite davantage de tentatives (avec des délais avant expiration plus longs) pour réussir la publication. La nécessité de répéter les tentatives augmente la latence de publication. Dans ce cas, augmenter le délai avant expiration initial pourrait accélérer les publications.
Si la connexion réseau n'est pas fiable, il peut être utile d'augmenter le délai avant expiration total ainsi que le délai avant expiration initial. Un délai avant expiration total plus long donne plus de temps au RPC de publication pour se terminer correctement. Lorsque les RPC de publication échouent systématiquement avec des erreurs de dépassement de délai, envisagez d'ajuster ces valeurs.
Des erreurs de dépassement de délai continu lors de la publication peuvent également indiquer la nécessité d'ajuster le contrôle de flux de l'éditeur. Ces paramètres vous permettent de vous assurer que vos éditeurs sont résilients aux pics de trafic entrant qui génèrent davantage de messages à envoyer à Pub/Sub. Une forte augmentation des requêtes sortantes peut surcharger le processeur, la mémoire ou la capacité réseau de l'éditeur. Lorsque la publication est surchargée, elle ne peut pas traiter les requêtes ou les réponses de publication avant l'expiration des délais. Cela entraîne encore plus de requêtes de publication et, au final, l'atteinte du délai avant expiration total. Le contrôle de flux de l'éditeur limite le nombre de messages ou d'octets pouvant être en attente sans réponse de la requête de publication. Limiter le nombre de requêtes de cette manière permet de maintenir l'utilisation des ressources à un niveau gérable, même en cas de pics. Selon le fonctionnement de votre éditeur, vous pouvez autoriser les RPC de publication ultérieurs à attendre la capacité en autorisant la publication à bloquer d'autres requêtes. Vous pouvez également renvoyer une erreur aux appelants de votre service lorsque la capacité est atteinte. Vous configurez la façon dont la bibliothèque cliente de l'éditeur répond au comportement de dépassement de limite.
Abonnés gagnés via l'affinage
Il peut également être nécessaire d'ajuster les abonnés pour s'assurer qu'ils fonctionnent de manière fiable. Comme pour les éditeurs, vous pouvez régler les paramètres de contrôle de flux des abonnés pour vous assurer qu'ils ne sont pas submergés. La bibliothèque cliente de l'abonné utilise l'extraction par flux, où le client ouvre un flux persistant vers le serveur, et le serveur envoie les messages dès qu'ils sont disponibles. En cas d'augmentation importante du nombre de messages publiés, l'abonné peut recevoir plus de messages qu'il ne peut en traiter. Lorsque le contrôle de flux est en place, le nombre de messages non confirmés en attente pour le client à un moment donné est limité. Cela réduit le nombre de messages traités simultanément et répartit leur traitement sur une période plus longue. La répartition de la charge permet aux abonnés de rester sous les limites de ressources qui ont un impact sur le traitement des messages, ce qui peut entraîner un effet en cascade qui se traduit par l'incapacité de traiter les messages.
Le contrôle de flux seul suffit si vous ne prévoyez que des pics de quantité de données à traiter qui finissent par diminuer. Si le trafic augmente généralement au fil du temps en raison d'une utilisation accrue, le contrôle de flux protège les abonnés. Toutefois, cela peut entraîner une accumulation de messages en attente qui ne pourront pas être distribués avant l'expiration de la durée de conservation des messages. Dans ce cas, vous pouvez également configurer l'autoscaling pour augmenter le nombre d'abonnés en réponse à un nombre croissant de messages non confirmés. La configuration dépend de la plate-forme de calcul que vous utilisez pour vos abonnés. Par exemple, l'autoscaler de Compute Engine vous permet d'effectuer un scaling en fonction de métriques telles que le nombre de messages non distribués. L'utilisation de l'autoscaling et du contrôle de flux vous permet de vous assurer que vos abonnés sont résilients face à d'autres pics de débit de messages à court terme et à une croissance à plus long terme qui nécessite davantage de puissance de calcul. Veillez à suivre les bonnes pratiques d'utilisation des métriques Pub/Sub comme signal de scaling.
Utiliser la version régionale des métriques de backlog au lieu des versions globales
Lorsque vous surveillez votre backlog d'abonnement, configurez des règles d'alerte ou effectuez un autoscaling des abonnés, Pub/Sub propose deux versions de chaque métrique de backlog. Veillez à utiliser les versions avec le suffixe by_region :
N'utilisez pas les versions globales de ces métriques (subscription/num_undelivered_messages et subscription/oldest_unacked_message_age) si vous souhaitez que votre surveillance, vos alertes et l'autoscaling soient résilients aux pannes d'une seule région. Les versions globales de ces métriques nécessitent de calculer le backlog dans toutes les régions connues pour contenir des messages, ce qui signifie que l'indisponibilité dans une seule région entraîne un manque de données. En revanche, les versions by_region des métriques calculent et signalent le backlog par région. Si le backlog ne peut pas être calculé pour une seule région, la métrique indique toujours les valeurs pour les autres régions.
Utiliser les instantanés et la recherche pour des déploiements sécurisés
La perte de messages est généralement un événement catastrophique. Pub/Sub propose une distribution au moins une fois pour tous les messages publiés. Toutefois, le traitement correct de ces messages dépend du comportement de l'abonné. Si les messages sont bien confirmés, Pub/Sub ne les renvoie pas. Par conséquent, un bug introduit dans le nouveau code d'abonné que vous déployez et qui accuse réception des messages sans les avoir traités correctement peut entraîner une perte de messages induite par l'abonné. Pub/Sub propose la fonctionnalité Instantané et recherche, qui vous permet de vous assurer que vous traitez correctement chaque message, même en cas de bugs d'abonné.
Le modèle de chaque déploiement d'abonné doit être le suivant :
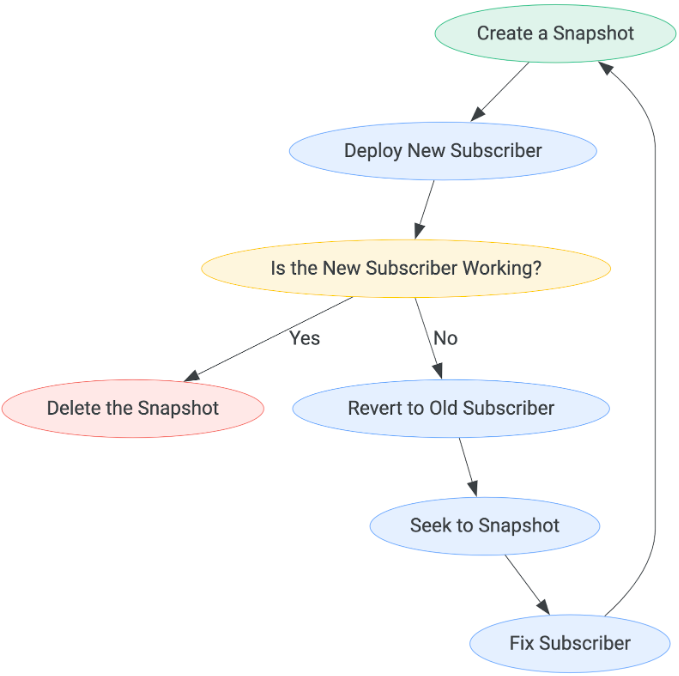
Le temps d'attente avant de déterminer si le nouvel abonné fonctionne peut varier en fonction de votre cas d'utilisation. La seule façon de quitter le flux d'étapes est lorsqu'un abonné est considéré comme fonctionnel, auquel cas l'instantané peut être supprimé.
L'utilisation d'instantanés et de la recherche n'est pas destinée à remplacer les bonnes pratiques concernant l'exécution initiale du logiciel dans un environnement hors production et le déploiement progressif en production. Ils fournissent un niveau de protection supplémentaire pour garantir un traitement fiable des données. En contrepartie, la recherche de l'instantané peut entraîner la distribution en double des messages que votre abonné a bien traités. Toutefois, étant donné que Pub/Sub utilise par défaut une sémantique de distribution de type "au moins une fois", vos abonnés sont déjà résilients à la nouvelle distribution des messages.