


本文說明應用程式失敗,或效能不符合定義條件時,如何接收相關通知。
警報的運作方式
Cloud Monitoring 警告程序包含三個部分:
警告政策:說明快訊發送時機及通知方式。警告政策可以監控 Monitoring 儲存的時間序列資料,或 Cloud Logging 儲存的記錄。當資料符合警告政策條件時,Monitoring 會建立警告並傳送通知。
每則快訊都會記錄受監控的資料類型,以及符合條件的時間。這項資訊有助於排解導致警報的問題。
通知管道會定義 Monitoring 建立快訊時,您接收通知的方式。舉例來說,您可以設定警告政策,透過電子郵件
my-support-team@example.com和 Slack 訊息#my-support-team通知管道。每個警告政策可包含一或多個通知管道。
快訊政策可以評估三種資料:
時間序列資料 (也稱為指標資料),由 Monitoring 儲存。這類政策稱為「以指標為準」的快訊政策。
如要瞭解如何設定以指標為準的警告政策,請參閱 Compute Engine 快速入門導覽課程。
Cloud Logging 儲存的記錄項目資料。評估個別記錄項目的快訊政策稱為「記錄檔」快訊政策。記錄式警告政策會在記錄中出現特定訊息時通知您。詳情請參閱「監控記錄」。
在 Observability Analytics 中,針對 Logging 儲存的記錄項目資料執行 SQL 查詢的結果。監控 SQL 查詢結果的快訊政策稱為「以 SQL 為準的快訊政策」。詳情請參閱「使用警告政策監控 SQL 查詢結果」。
以 SQL 為基礎的警告政策目前為公開預先發布版。
如果應用程式效能未達合理值,警告程序可協助您因應問題。舉例來說,您將網頁應用程式部署到 Compute Engine 虛擬機器 (VM) 執行個體。您預期 HTTP 回應延遲時間會波動,但希望支援團隊在應用程式長時間延遲時做出回應。您可以建立以指標為準的警告政策,監控應用程式的 HTTP 回應延遲指標。如果回應延遲時間至少有五分鐘超過兩秒,Monitoring 就會建立快訊,並傳送電子郵件通知給支援團隊。
如何建立警告政策
建立警告政策的方法有很多種。舉例來說,您可以啟用整合服務或 Google Cloud 控制台特定頁面中的建議快訊,使用預先設定的快訊政策。您也可以使用Google Cloud 控制台、Cloud Monitoring API、Google Cloud CLI 和 Terraform,設定新的警告政策。
使用整合功能和建議的快訊政策
Monitoring 提供預先建構的套件,方便您為Google Cloud 服務和第三方整合項目建立警告政策。這些套件包含建議的快訊政策、範例資訊主頁,以及服務的重要指標。這些套件適用於 Google Kubernetes Engine、Compute Engine 和 Cloud SQL 等服務,以及 MongoDB、Kafka 和 Elasticsearch 等常見的第三方整合服務。Google Cloud
安裝套件時,您可以啟用套件的建議快訊政策。啟用建議的警告政策時,請設定通知管道,並視需要修改其他值。設定完成後,系統會立即開始監控目標,不需使用者進一步輸入內容。
部署新服務並想針對重要指標發出警告時,建議採用建議的警告政策。舉例來說,Cloud SQL 整合套件隨附建議的快訊政策,可偵測失敗的執行個體和緩慢的交易:
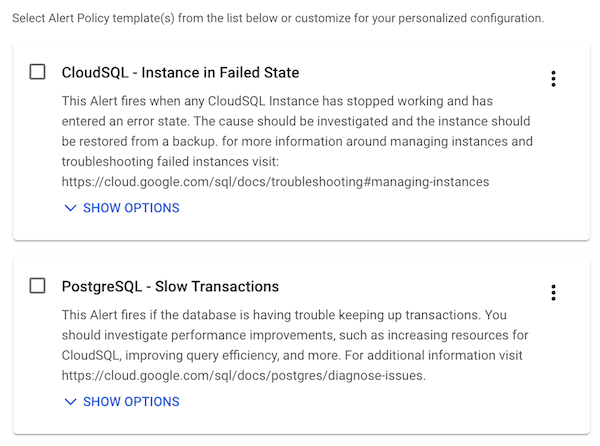
詳情請參閱下列文件:
建立新的快訊政策
您可以根據快訊需求,建立快訊政策來監控不同類型的資料。以下各節列出可透過快訊政策監控的各種資料類型。
監控時間序列資料
| 條件類型 | 說明 | 範例 |
|---|---|---|
| 指標門檻條件 | 當指標值在特定重測時間範圍內高於或低於門檻時,即符合指標門檻條件。 詳情請參閱「建立指標門檻警告政策」和「使用 API 建立警告政策」。 |
您希望制定警告政策,在連續五次運作時間檢查中,回應延遲時間超過 10 分鐘且達到 500 毫秒以上時,傳送通知。 |
| 指標不存在條件 | 如果受監控的時間序列在特定重測時間範圍內沒有資料,就會符合指標不存在條件。重新測試時間上限為 24 小時。 詳情請參閱「建立指標缺席警告政策」和「使用 API 建立警告政策」。 |
您希望制定快訊政策,在資源五分鐘內未回應任何 HTTP 要求時,向支援團隊發出快訊。 |
| Prometheus 查詢語言 (PromQL) 條件 | PromQL 是函式查詢語言,用於即時評估時間序列資料。PromQL 查詢可使用任何有效運算式,例如指標組合、比率,以及根據指標的動態門檻。 詳情請參閱「在 Cloud Monitoring 中使用 PromQL」和「PromQL 警報總覽」。 |
您想使用公開存放區中的 PromQL 快訊運算式、建立以多個指標 (例如比率) 為依據的警告政策,或是建立以超過 25 小時資料為依據的警告政策。 |
| 預測指標值條件 | 當警告政策預測在即將到來的預測時間範圍內,會違反閾值時,即符合預測指標值條件。預測時間範圍可從 1 小時到 7 天。 詳情請參閱「建立預測指標值警告政策」和「使用 API 建立警告政策」。 |
您希望建立快訊政策,在資源可能於 24 小時內達到 80% 的磁碟空間使用量時,向支援團隊發出快訊。 |
建議您盡可能根據受監控資源類型定義的標籤進行篩選,而非根據指標類型定義的標籤篩選,特別是查詢高基數指標時。如果您有資源標籤和指標標籤會擷取類似資訊,請在查詢中使用資源標籤。
舉例來說,如果受監控資源包含 cluster 標籤,而指標包含擷取類似資訊的 kubernetes_cluster_name 標籤,請依資源 cluster 標籤篩選。
資源中繼資料標籤會非同步新增至時間序列,且不受與標籤值相同的 延遲時間預期限制,這些標籤值定義了指標類型或受監控資源類型。因此,如果資源中繼資料標籤的填入作業延遲,依據中繼資料值觸發動作的快訊政策可能會出現異常行為。
監控記錄項目資料
如要監控個別記錄項目,請使用以記錄為準的警告政策。當警告政策偵測到記錄項目中的詞組符合警告政策條件時,就會符合記錄檔警告政策的條件。舉例來說,您希望在記錄檔項目包含 message 時,快訊政策會向支援團隊發出快訊。product_ids=['tier_1_support', 'tier_2_support']
詳情請參閱 Logging 說明文件中的「設定以記錄為準的快訊政策」。
監控 SQL 查詢結果
如要監控 SQL 查詢結果,請使用以 SQL 為基礎的警告政策。
以 SQL 為基礎的警告政策條件會定期分析記錄項目資料,並在查詢結果資料表符合特定條件時建立警告。如果您需要監控多個記錄項目中的資料匯總或複雜模式,這類警告政策就非常實用。舉例來說,您希望在過去 60 分鐘內,有超過 50 個記錄項目的嚴重程度為 WARNING 時收到通知。
詳情請參閱 Logging 說明文件中的「使用警告政策監控 SQL 查詢結果」。
警告政策元件
每項警告政策都包含下列元件:
條件:說明資源或資源群組何時處於需要您回應的狀態。條件包括資料來源、靜態或動態門檻,以及資料匯總方法,例如篩選器和 groupby。條件可以監控單一指標、多個指標或指標比率。您也可以使用 Prometheus 查詢語言 (PromQL),納入動態門檻和條件式邏輯等複雜運算式。
如果您使用整合功能啟用建議的警告政策,系統會預先填入警告政策條件。
通知管道清單,說明需要採取行動時要通知哪些人。詳情請參閱「建立及管理通知管道」。
通知和快訊頁面中顯示的文件。您可以設定通知的主旨行,並在通知內文中加入實用資訊。舉例來說,您可以設定通知,顯示內部手冊或自訂資訊主頁等 Google Cloud 頁面的連結。如要進一步瞭解說明文件 (包括範例),請參閱「使用使用者定義的說明文件為快訊加上註解」。
管理快訊政策和快訊
啟用警告政策後,Monitoring 會持續監控該政策的條件。您無法設定警告政策,只監控特定時間範圍內的狀況。如要暫時停用快訊政策,請建立暫緩通知。
如果快訊處於開啟狀態,且 Monitoring 判斷以指標為準的政策條件不再符合,Monitoring 就會自動關閉快訊,並傳送快訊關閉通知。
定價
如要瞭解 Cloud Monitoring 的定價,請參閱「Google Cloud Observability 定價」頁面。
如要瞭解如何監控擷取的追蹤跨度或記錄數量,或在記錄項目中包含特定內容時收到通知,請參閱下列文件:
後續步驟
如要瞭解通知延遲,以及警告政策參數的選擇如何影響通知傳送時間,請參閱「以指標為基準的警告政策行為」。
如需指標型政策範例清單,包括如何使用 JSON 撰寫指標閾值條件來監控指標類型比例,請參閱「範例快訊政策摘要」。