


Os clientes podem se conectar a um cluster do Serviço Gerenciado para Apache Kafka de qualquer rede de nuvem privada virtual (VPC) nos seus projetos doGoogle Cloud . Também é possível ativar o acesso de intervalos de IP confiáveis pela Internet pública.
Nesta página, explicamos como a rede é configurada no Serviço Gerenciado para Apache Kafka e como ativar conexões entre clientes do Kafka e seu cluster.
Sub-redes conectadas
Ao criar um cluster do Serviço Gerenciado para Apache Kafka, você especifica pelo menos uma sub-rede VPC para se conectar ao cluster. Depois, é possível atualizar o cluster para adicionar ou remover sub-redes. É possível conectar várias sub-redes a um cluster, mas no máximo uma sub-rede por rede VPC. Os aplicativos cliente podem se conectar ao cluster de qualquer sub-rede que compartilhe a rede VPC de uma sub-rede conectada, em qualquer região.
Quando o serviço provisiona um cluster, ele coloca os agentes do cluster e os endpoints de rede em uma rede VPC separada em um projeto gerenciado pelo Google. Esse projeto é chamado de projeto de locatário, e a rede é chamada de rede de locatário. Cada cluster do Serviço Gerenciado para Apache Kafka tem a própria rede de locatário isolada. Não é necessário gerenciar ou configurar a rede de locatário.
O recurso Google Cloud que representa o cluster reside no seu próprio projeto doGoogle Cloud . Por exemplo, ao executar comandos da Google Cloud CLI, você especifica o projeto do Google Cloud , não o projeto de locatário. Da mesma forma, quando você conecta uma sub-rede a um cluster, ela reside no seu projeto doGoogle Cloud .
Nas seções a seguir, projeto se refere ao seu próprio projeto do Google Cloud , a menos que o projeto de locatário gerenciado pelo Google seja especificado.
Entradas de DNS do cluster
Quando você conecta uma sub-rede a um cluster, o serviço cria entradas DNS na rede da sub-rede para o endereço de inicialização e os agentes do cluster. Os clientes do Kafka usam o endereço de inicialização para localizar os agentes e estabelecer uma conexão. Quando o servidor de bootstrap redireciona um cliente para um agente específico, ele usa o URL do agente em vez de um endereço IP.
Os nomes DNS de um cluster são os mesmos em todas as sub-redes conectadas do cluster, embora correspondam a endereços IP diferentes em cada sub-rede. Como os nomes DNS são consistentes, todos os aplicativos cliente do Kafka usam o mesmo endereço de inicialização.
Os URLs de inicialização e do agente são fixos durante o ciclo de vida de um cluster. Para conferir o endereço de inicialização de um cluster, consulte Ver o endereço de inicialização de um cluster. O formato dos URLs pode variar de acordo com o cluster.
Dimensionamento de sub-rede
Ao adicionar uma sub-rede a um cluster, ela precisa ter endereços IP suficientes. Cada sub-rede requer um endereço IP para cada agente do Kafka, além de um endereço IP para o endereço de inicialização.
O número inicial de agentes é calculado da seguinte forma:
number of brokers = max(3, ceiling(vCPUs / 15))
Por exemplo, um cluster com 60 vCPUs tem quatro agentes (60/15) e, portanto, precisa de pelo menos cinco endereços IP utilizáveis, incluindo o endereço de inicialização. À medida que você escalonar verticalmente um cluster, o serviço adiciona mais agentes. Ao planejar o tamanho da sub-rede, baseie seus cálculos no tamanho máximo que você espera que o cluster seja escalonado. O Google pode mudar a proporção de agentes para vCPUs. Por isso, recomendamos alocar três vezes o número mínimo calculado de endereços IP. Para mais informações, consulte Planejar o tamanho do cluster do Serviço Gerenciado para Apache Kafka.
Se você planeja usar o Kafka Connect, considere também os requisitos de sub-rede para o cluster do Connect. Para mais informações, consulte Sub-rede do worker (principal).
Intervalos de IP públicos usados de maneira privada
É possível conectar o cluster a sub-redes que usam intervalos de endereços IP públicos usados de modo particular sem configuração adicional. As sub-redes precisam usar um intervalo IPv4 válido que não seja um intervalo de sub-rede IPv4 proibido.
Clusters do Connect em vários projetos
Para permitir que os clientes do Kafka em um projeto do Google Cloud diferente se conectem ao cluster por IP privado, use um dos seguintes métodos:
- Conecte uma sub-rede do projeto do cliente do Kafka ao cluster.
- Use a VPC compartilhada para conectar os projetos.
As seções a seguir descrevem tais opções.
Conectar sub-redes entre projetos
Para conectar uma sub-rede em um projeto diferente ao cluster, o agente de serviço do Managed Kafka associado ao cluster precisa de permissão para acessar os recursos de rede no projeto dessa sub-rede. Conceda ao agente de serviço o papel do IAM de Agente de serviço do Kafka gerenciado no projeto que contém a sub-rede. Esse papel permite que o cluster crie os recursos de rede e as entradas de DNS necessários.
Por exemplo, se você criar um cluster em project-1 e quiser conectar uma sub-rede
em project-2, conceda ao agente de serviço do Kafka gerenciado para project-1 o papel de
Agente de serviço do Kafka gerenciado em project-2. Em seguida, conecte uma sub-rede de
project-2 ao cluster, conforme descrito em
Conectar sub-redes ao cluster.
Para conceder os papéis necessários, siga estas etapas:
Console
No console do Google Cloud , acesse a página IAM do projeto que contém a sub-rede.
Clique em Conceder acesso.
No campo Novos participantes, insira o seguinte:
service-CLUSTER_PROJECT_NUMBER@gcp-sa-managedkafka.iam.gserviceaccount.comSubstitua
CLUSTER_PROJECT_NUMBERpelo número do projeto que contém o cluster do Serviço Gerenciado para Apache Kafka.Clique em Adicionar funções.
No campo Pesquisar papéis, insira
Managed Kafka Service Agent.Nos resultados da pesquisa, selecione Agente de serviço do Kafka gerenciado.
Clique em Aplicar.
Clique em Salvar.
gcloud
Para conceder o papel do IAM, use o comando gcloud projects add-iam-policy-binding:
gcloud projects add-iam-policy-binding CLIENT_PROJECT_ID \
  --member=serviceAccount:service-CLUSTER_PROJECT_NUMBER@gcp-sa-managedkafka.iam.gserviceaccount.com \
  --role=roles/managedkafka.serviceAgent
Substitua:
- CLIENT_PROJECT_ID: o nome do projeto que contém a sub-rede a ser conectada.
- CLUSTER_PROJECT_NUMBER: o número do projeto que contém o cluster do Serviço Gerenciado para Apache Kafka
Usar a VPC compartilhada para conectar projetos
Com a VPC compartilhada, uma organização pode conectar recursos de vários projetos a uma rede VPC comum. Para usar a VPC compartilhada com o Serviço Gerenciado para Apache Kafka, siga estas etapas:
Criar um cluster do Serviço Gerenciado para Apache Kafka.
Conceda ao agente de serviço do Managed Kafka o papel de agente de serviço do Managed Kafka no projeto host da VPC compartilhada, conforme descrito na seção anterior.
Conecte o cluster a uma sub-rede na rede VPC compartilhada.
Os clientes no projeto host da VPC compartilhada ou nos projetos de serviço podem se conectar ao cluster.
Para saber quando usar a VPC compartilhada, consulte Práticas recomendadas e arquiteturas de referência para o design da VPC.
Conectar clientes pela Internet pública
Se você tiver aplicativos cliente fora da rede VPC, poderá ativar o acesso público ao cluster. Um cluster público ainda requer uma sub-rede conectada. No entanto, não é necessário enviar tráfego por ele.
Quando você ativa o recurso de cluster público, o serviço provisiona endereços IPv4 externos para os endpoints de agente e de inicialização do cluster. O serviço também torna as entradas DNS do cluster publicamente resolvíveis para esses endereços IP públicos. Os clientes externos podem usar o endereço de inicialização do cluster para localizar os agentes e estabelecer uma conexão.
Essa implementação usa o DNS split-horizon. Os clientes em redes VPC que contêm uma sub-rede conectada continuam resolvendo os endpoints particulares, enquanto os clientes em outras redes resolvem os endpoints públicos. Ativar o recurso de cluster público não cria outros recursos no projeto.
O Serviço Gerenciado para Apache Kafka usa o Cloud Next Generation Firewall para restringir o acesso a clusters públicos. Ao ativar o recurso de cluster público, é necessário especificar um ou mais intervalos de IP de origem permitidos. Para mais informações, consulte Clusters públicos.
É possível atualizar um cluster para adicionar ou remover intervalos de IP de origem permitidos. Se você remover os intervalos de IP de origem permitidos, a mudança será aplicada apenas às novas conexões.
O serviço toma várias precauções para garantir a segurança dos clusters públicos. Todas as conexões são criptografadas em trânsito usando TLS, e todas as conexões exigem autenticação. É preciso autenticar usando uma identidade do IAM com SASL ou um certificado do cliente com mTLS. O acesso anônimo não é permitido. Para mais informações, consulte Tipos de autenticação para agentes do Kafka.
Os administradores de segurança podem proibir clusters públicos ativando a restrição de política da organização gerenciada Restringir clusters públicos do Kafka gerenciado (constraints/managedkafka.managed.restrictPublicClusters). Para mais informações sobre restrições gerenciadas,
consulte Restrições gerenciadas.
Configurar firewalls de saída de redes externas
Em alguns cenários, talvez seja necessário determinar os endereços IPv4 externos dos endpoints de agente e de inicialização. Para ver esses endereços, consulte Detalhes do cluster público.
O serviço também mantém um ou mais registros DNS de descoberta. Esses são registros DNS A
que contêm todos os endereços IPv4 externos associados ao
cluster. É possível usar esses registros em firewalls baseados em FQDN, como o
Cloud NGFW, que atualiza
automaticamente as regras quando a lista de endpoints muda. Para mais informações, consulte
Mapear objetos FQDN para endereços IP.
Considere o seguinte ao usar os endereços IP públicos associados ao cluster:
A lista de endereços IPv4 públicos pode mudar ou aumentar. Por esse motivo, automatize como você consome essas informações ou defina um processo para considerar novos registros DNS de descoberta ao escalonar verticalmente o cluster. As mudanças podem ocorrer quando:
Você escalonar verticalmente o cluster verticalmente. O escalonamento vertical pode adicionar um ou mais endereços IPv4 externos à medida que novos agentes são adicionados. Para mais informações, consulte Como escalonar o cluster.
Desativar e ativar o recurso de cluster público. Essa ação atribui um novo conjunto de endereços IPv4 externos ao cluster.
Cada registro DNS de descoberta contém no máximo 30 endereços IP, um valor que está dentro dos limites comuns aplicados por firewalls de FQDN. Os clusters com 29 ou menos agentes têm um registro DNS de descoberta que inclui o registro de endereço de inicialização. O serviço adiciona um registro DNS de descoberta para cada 30 agentes adicionais.
Os registros DNS de descoberta são destinados apenas à configuração de firewalls de saída baseados em FQDN. Não configure os clientes do Kafka para se conectarem aos registros DNS de descoberta. Em vez disso, configure os clientes para se conectarem ao endereço de inicialização.
Se você usar essas informações para configurar firewalls de saída, permita a conectividade com as portas TCP
9092(SASL) e9192(mTLS).
Arquitetura de rede de um cluster
Nesta seção, descrevemos os detalhes da arquitetura de rede usada no Serviço Gerenciado para Apache Kafka.
Um cluster do Kafka abrange uma rede de locatário e uma ou mais redes de consumidor.
Na rede de locatário, o cluster tem um único endereço IP de inicialização e um URL. Esse endereço de inicialização corresponde a um balanceador de carga conectado a todos os agentes no cluster. Cada agente individualmente também pode atuar como um servidor de bootstrap, mas recomendamos que você use o endereço de bootstrap para garantir a confiabilidade.
Em cada rede de consumidor, o serviço cria um endpoint do Private Service Connect para o endereço de inicialização e um endpoint para cada agente.
O URL do endereço de inicialização é o mesmo em todas as redes VPC a que um cluster está conectado. O endereço IP é local para a rede do consumidor.
Os clientes se conectam aos agentes do Kafka usando nomes DNS. Esses nomes são registrados automaticamente em todas as rede VPC às quais um cluster do Kafka está conectado. O endereço de inicialização e o número da porta estão disponíveis como uma propriedade do cluster.
Os clientes usam o endereço de inicialização para recuperar URLs de agente. Esses URLs são resolvidos para endereços IP locais de cada rede VPC. É possível encontrar os endereços IP e URLs reais do agente no Cloud DNS.
O diagrama a seguir mostra um exemplo de arquitetura de uma rede de cluster do Serviço Gerenciado para Apache Kafka.
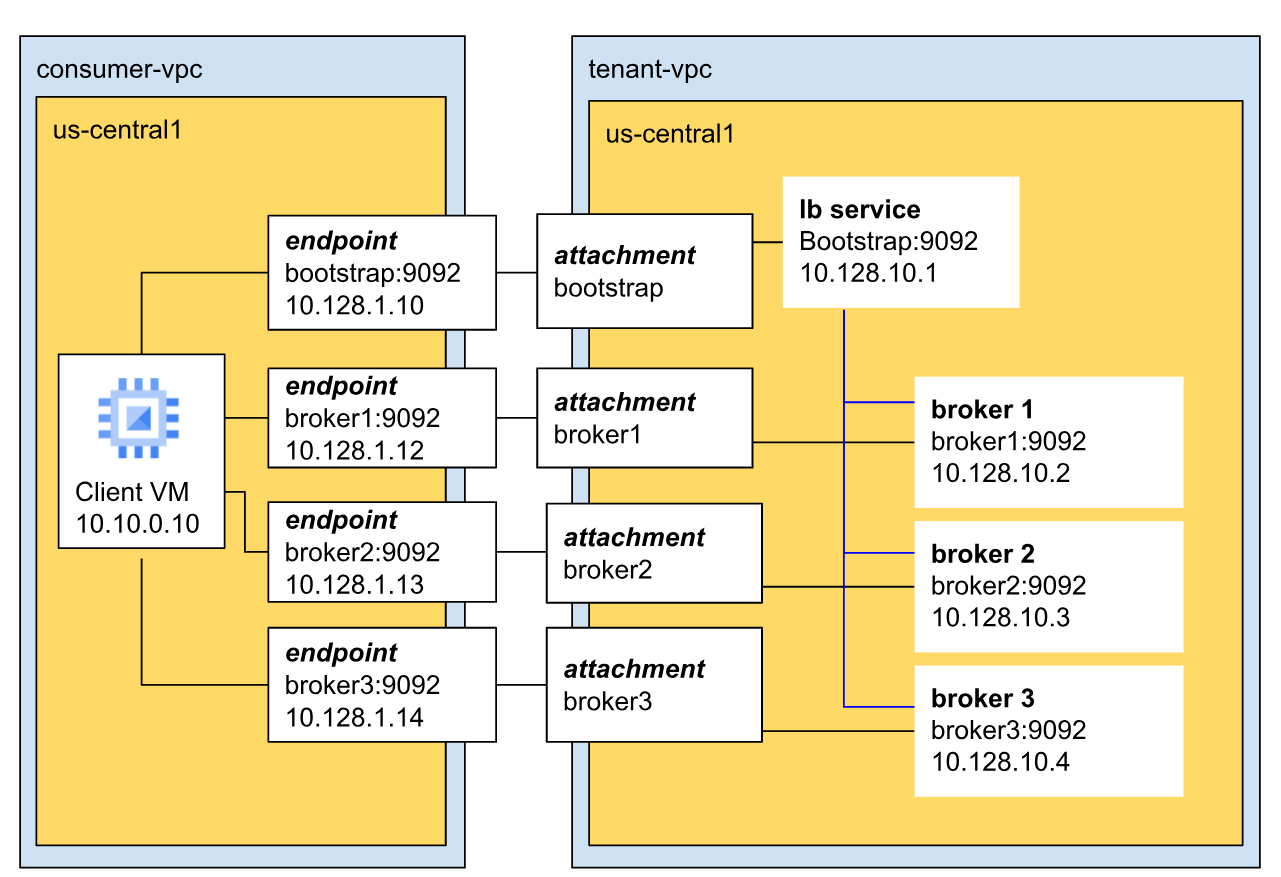 *
Neste exemplo, o cluster tem três agentes e está na VPC do locatário.
Os agentes se comunicam com os clientes pela porta padrão do Kafka (9092) e têm endereços IP exclusivos. Neste exemplo, os três agentes têm os endereços IP 10.128.10.2, 10.128.10.3 e 10.128.10.4, respectivamente.
Os três agentes se conectam ao balanceador de carga de inicialização. Isso garante alta disponibilidade e tolerância a falhas regionais, porque o endereço de inicialização não está confinado a um único agente ou zona.
Limitações
As seguintes limitações se aplicam a conexões VPC e clusters públicos:
Região da sub-rede. As sub-redes conectadas precisam estar na mesma região do cluster.
Contagem de sub-redes. É possível conectar no mínimo uma e no máximo dez sub-redes a um cluster.
Sub-redes por rede. É possível conectar no máximo uma sub-rede por rede VPC a um cluster.
Tamanho da sub-rede. Cada sub-rede conectada requer pelo menos um endereço IP para cada agente e um endereço IP para o endereço de inicialização. É necessário ter pelo menos quatro endereços IP utilizáveis. Para mais informações, consulte Dimensionamento de sub-redes.
Sub-redes conectadas para clusters públicos. Para ativar o acesso público, o cluster ainda precisa ter pelo menos uma sub-rede conectada, embora não seja necessário enviar tráfego por ela.
Intervalos de IP de origem permitidos. Cada intervalo de IP de origem permitido para um cluster público precisa ser especificado na notação CIDR IPv4. Cada tamanho de sub-rede CIDR precisa estar entre
/16e/32. Os intervalos CIDR não podem se sobrepor. Não há suporte para endereços IPv6. É possível especificar no máximo 500 intervalos de IP de origem permitidos.Resolução de DNS do registro de descoberta. Os registros DNS de descoberta são projetados apenas para configurar firewalls de saída baseados em FQDN. Não configure os clientes do Kafka para se conectarem a esses registros de descoberta. Em vez disso, configure os clientes para se conectarem ao endereço de inicialização.
Resolver problemas
Para informações sobre como resolver problemas de rede, consulte Erros de rede.
A seguir
Para mais informações sobre como criar um cluster, consulte Criar um cluster do Serviço Gerenciado para Apache Kafka.
Para mais informações sobre como atualizar um cluster, consulte Atualizar um cluster do Serviço Gerenciado para Apache Kafka.
Para mais informações sobre como visualizar as sub-redes e os agentes ativos de um cluster, consulte Visualizar um cluster.
Para mais informações sobre como publicar e consumir mensagens, consulte Publicar e consumir mensagens.