


Questo documento descrive come eseguire la migrazione dei workload Apache Kafka a Managed Service per Apache Kafka.
L'approccio mostrato in questo documento utilizza Kafka Connect con MirrorMaker 2.0. Kafka Connect è un framework per connettere Kafka a sistemi esterni e MirrorMaker 2.0 è uno strumento per replicare i dati tra cluster Kafka in tempo reale.
Architettura
Il seguente diagramma mostra l'architettura per la migrazione dei dati a Managed Service per Apache Kafka:
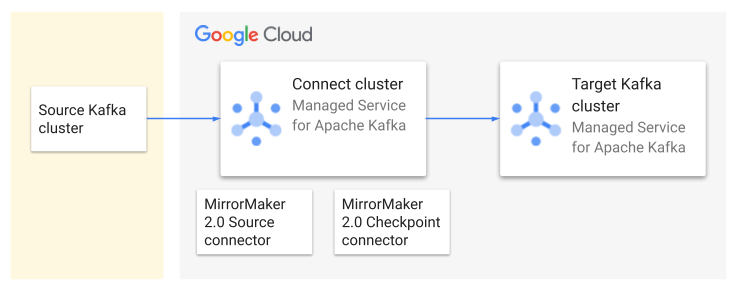
L'architettura è costituita dai seguenti componenti:
Cluster Kafka di origine: il cluster Kafka esistente, che può trovarsi on-premise o in un altro ambiente cloud. Contiene gli argomenti di cui vuoi eseguire la migrazione.
Cluster Kafka di destinazione: il cluster Managed Service per Apache Kafka in cui sposterai i dati Kafka.
Cluster di connessione: un deployment distribuito di Kafka Connect associato al cluster Kafka di destinazione.
Connettore di origine MirrorMaker 2.0: replica gli argomenti dal cluster di origine al cluster di destinazione. Crea automaticamente gli argomenti e le partizioni corrispondenti nel cluster di destinazione se non esistono. Inoltre, configura gli ACL degli argomenti sul cluster di destinazione in modo che corrispondano agli ACL degli argomenti di origine.
Connettore checkpoint MirrorMaker 2.0. Replica gli offset dei consumer in modo che i consumer possano passare al cluster Kafka secondario e leggere dal punto in cui hanno interrotto la lettura.
Workflow di alto livello
Questa sezione descrive il flusso di lavoro di alto livello per il processo di migrazione.
Pianificare la migrazione
Documenta la configurazione Kafka esistente, inclusi dimensioni del cluster, argomenti, throughput e gruppi di consumer.
Pianifica la tua strategia di migrazione, incluso il modo in cui sposterai i workload attivi nel nuovo cluster.
Stima le dimensioni del cluster richieste. Questo calcolo fornisce una dimensione iniziale per il tuo cluster Managed Service per Apache Kafka, per garantire che disponga di risorse sufficienti per eseguire i tuoi carichi di lavoro. In un secondo momento, puoi scalare il cluster se necessario.
Esegui la migrazione dei dati
Crea Google Cloud risorse, tra cui un cluster Managed Service per Apache Kafka, un cluster Connect e i connettori MirrorMaker 2.0 che replicano i tuoi dati.
Dopo aver confermato la replica di argomenti e gruppi di consumatori, migra i consumatori e i produttori al cluster Managed Service per Apache Kafka.
Passa al nuovo cluster
Convalida l'integrità dei dati e la funzionalità dell'applicazione con il cluster Managed Service per Apache Kafka.
Esegui il cutover finale, reindirizzando il traffico al cluster Managed Service per Apache Kafka.
Dismetti il vecchio cluster Kafka.
Monitora
Monitora continuamente le prestazioni del tuo cluster Managed Service per Apache Kafka. Per saperne di più, consulta Monitorare un cluster Managed Service per Apache Kafka.
Rivedi e aggiorna la documentazione in modo che rifletta le modifiche.
Documenta la configurazione di Kafka
Prima di iniziare una migrazione, documenta la configurazione Kafka attuale. Raccogli le seguenti informazioni:
Controlla la versione del cluster Apache Kafka. MirrorMaker 2.0 richiede che il cluster sia alla versione 2.4.0 o successive.
Identifica gli argomenti di cui eseguire la migrazione. Documenta anche il fattore di replica e il conteggio delle partizioni di ogni argomento.
Misura il throughput dei messaggi a livello di cluster e argomento.
Identifica i producer e i consumer associati a ogni argomento. Per i consumatori, identifica tutti i gruppi di consumatori.
Documenta le configurazioni dei consumatori, in particolare i protocolli di sicurezza e qualsiasi integrazione con altri Google Cloud servizi.
Con queste informazioni, puoi calcolare le dimensioni richieste del cluster Managed Service per Apache Kafka e scegliere le impostazioni di configurazione per i connettori MirrorMaker 2.0.
Per evitare interruzioni durante la migrazione, mappa tutte le dipendenze delle applicazioni correlate al cluster Kafka di origine.
Pianifica la tua strategia di migrazione
Questa sezione elenca alcune considerazioni operative per la migrazione dei dati Kafka. Per ridurre al minimo i tempi di inattività durante la procedura di migrazione, valuta queste strategie:
Deployment paralleli: prima di passare al nuovo cluster, esegui istanze parallele delle tue applicazioni sia sul cluster precedente che su quello nuovo. Durante questo periodo di transizione, disattiva temporaneamente qualsiasi azione nella tua applicazione che deve essere eseguita una sola volta per messaggio, per evitare conseguenze indesiderate dall'elaborazione dello stesso messaggio due volte. Una volta che le nuove istanze sono completamente aggiornate, reindirizza tutto il traffico al nuovo cluster e riattiva tutte le funzionalità.
Implementazioni in più fasi: esegui la migrazione in fasi più piccole e gestibili, a partire dalle applicazioni meno critiche. Questo approccio aiuta a isolare i potenziali problemi e riduce al minimo l'impatto di eventuali interruzioni.
Deployment blu e verde: crea una replica completa del tuo ambiente di produzione (verde) accanto a quello esistente (blu). Sposta gradualmente il traffico da blu a verde. Testa e convalida il nuovo ambiente di produzione prima del passaggio definitivo. Questo approccio riduce al minimo i tempi di inattività, ma richiede più risorse durante la migrazione.
Dry run. Prima di eseguire la migrazione dell'ambiente di produzione, esegui un test di migrazione in un ambiente di sviluppo. Convalida la procedura e identifica eventuali potenziali problemi.
Ecco alcune considerazioni aggiuntive da tenere presenti quando pianifichi una migrazione:
Requisiti di elaborazione dei messaggi: comprendi la tolleranza della tua applicazione per i messaggi duplicati o mancanti e configura i consumer di conseguenza.
Comunicazione e coordinamento: stabilisci canali di comunicazione chiari e coordina i tempi di transizione.
Rollback. Crea un piano di rollback per ripristinare il cluster originale, se necessario.
Stimare la dimensione del cluster
Per stimare la memoria e il numero di vCPU necessari per il tuo cluster Managed Service per Apache Kafka, calcola innanzitutto il throughput di scrittura e di lettura totale dei tuoi workload. Puoi utilizzare le seguenti metriche JMX per misurare questi valori:
kafka.server:type=BrokerTopicMetrics,name=BytesInPerSec: la velocità in byte in entrata dai client in tutti gli argomenti. Per ottenere la tariffa aggregata per tutti gli argomenti, ometti il parametrotopic={...}.kafka.server:type=BrokerTopicMetrics,name=BytesOutPerSec: il byte rate in uscita per i client in tutti gli argomenti. Per ottenere la tariffa complessiva, ometti il parametrotopic={...}.
Queste metriche vengono riportate a livello di broker. Per calcolare il throughput del cluster, aggrega i dati di tutti i broker.
Monitorando queste metriche JMX per un periodo di tempo, puoi raccogliere punti dati per calcolare le seguenti metriche:
Media dati in entrata, MBps: la velocità media con cui i dati vengono inseriti nel cluster Kafka.
Picco di dati in entrata, MBps: la velocità più elevata con cui i dati vengono importati nel cluster Kafka.
Media dati in uscita, MBps: la velocità media con cui i dati vengono utilizzati dal cluster Kafka.
Dati di picco in uscita, MBps La velocità massima con cui i dati vengono utilizzati dal cluster Kafka.
Utilizzando questi valori calcolati, stima il tasso di equivalenza di scrittura nel seguente modo:
Write-equivalent rate (Avg/Peak) = (total write bandwidth) + (total read bandwidth / 4)
Il tasso equivalente di scrittura tiene conto del fatto che la larghezza di banda di lettura è più efficiente da elaborare rispetto alla larghezza di banda di scrittura. Utilizza la velocità equivalente di scrittura per scegliere una dimensione appropriata per il tuo cluster Managed Service per Apache Kafka. Per maggiori dettagli, vedi Pianificare le dimensioni del cluster Kafka.
Connetti Apache Kafka on-premise a Google Cloud
Se il cluster Apache Kafka di origine si trova on-premise, devi stabilire una connessione sicura tra la rete on-premise e il Virtual Private Cloud (VPC) in cui si trova il cluster Managed Service per Apache Kafka. Utilizza una delle seguenti opzioni da Google Cloud.
Cloud VPN: una soluzione conveniente adatta a esigenze di larghezza di banda inferiori o a esperimenti di migrazione iniziali. Crea un tunnel criptato sulla rete internet pubblica. Per ulteriori informazioni su Cloud VPN, consulta la panoramica di Cloud VPN.
Cloud Interconnect: fornisce una connessione dedicata a larghezza di banda elevata tra la tua rete on-premise e Google Cloud. È ideale per implementazioni di livello enterprise che richiedono un throughput più elevato e una latenza inferiore. Puoi scegliere tra Dedicated Interconnect (per la connessione fisica diretta) o Partner Interconnect (connessione tramite un fornitore di servizi supportato). Per saperne di più, consulta la panoramica di Cloud Interconnect.
Quando crei un cluster Managed Service per Apache Kafka, devi selezionare almeno una subnet nella rete VPC. Questa subnet fornisce gli indirizzi IP utilizzati dal cluster per comunicare con altre risorse nella rete VPC.
Per connetterti in modo sicuro al tuo cluster Managed Service per Apache Kafka da reti on-premise o altre reti VPC, puoi utilizzare Private Service Connect tramite Cloud VPN o Cloud Interconnect. Non è necessario configurare esplicitamente gli endpoint Private Service Connect. Quando selezioni una subnet durante la creazione del cluster, il servizio Managed Service per Apache Kafka crea automaticamente gli endpoint Private Service Connect necessari. Ciò semplifica la configurazione di rete consentendoti di accedere al cluster utilizzando indirizzi IP interni all'interno della rete VPC, senza dover gestire regole firewall complesse o indirizzi IP pubblici.
Per ulteriori informazioni, vedi Networking per Managed Service per Apache Kafka.
Crea Google Cloud risorse
Crea le seguenti risorse:
Un cluster Managed Service per Apache Kafka. Per maggiori informazioni, vedi Creare e visualizzare un cluster Managed Service per Apache Kafka.
Un cluster di connessione il cui cluster Kafka principale è il cluster che hai creato nel passaggio precedente. Per saperne di più, consulta Creare un cluster Connect.
Posiziona il cluster Connect nella stessa regione del cluster Managed Service per Apache Kafka.
Un connettore di origine MirrorMaker 2.0 per replicare i dati. Per saperne di più, vedi Crea un connettore di origine MirrorMaker 2.0.
Un connettore di checkpoint MirrorMaker 2.0 per replicare i checkpoint dei consumer. Per maggiori informazioni, vedi Crea un connettore di checkpoint MirrorMaker 2.0.
Impostazioni di MirrorMaker 2.0
Le seguenti impostazioni determinano la frequenza con cui vengono creati e replicati i checkpoint, il che può influire sulla precisione della conversione dell'offset consumer tra i cluster.
Consumer:
auto.commit.interval.ms: La frequenza con cui un consumatore compensa le emissioni.
Connettore di origine MirrorMaker 2.0:
offset.lag.max: la frequenza con cui il connettore di origine scrive le sincronizzazioni dell'offset.
Connettore di checkpoint MirrorMaker 2.0:
sync.group.offsets.enabled: setrue, il connettore Checkpoint copia i checkpoint da un argomento interno all'argomento__consumer_offsetsche i consumer utilizzano. Per consentire ai consumer di eseguire il failover senza problemi, imposta questa proprietà sutrue.emit.checkpoints.interval.seconds: la frequenza con cui il connettore Checkpoint scrive i checkpoint.sync.group.offsets.interval.seconds: la frequenza con cui il connettore Checkpoint copia i checkpoint in__consumer_offsets.
Per saperne di più, consulta Come funziona il connettore di checkpoint MirrorMaker 2.0.
Monitorare la replica dei dati
Monitora il processo MirrorMaker 2.0 per assicurarti che venga eseguito correttamente e che i dati vengano replicati come previsto. Per saperne di più, vedi Monitorare un cluster Connect.
Dopo aver eseguito la migrazione delle applicazioni, monitora le seguenti metriche per convalidare l'operazione:
Tassi di velocità effettiva downstream: assicurati che non vi siano variazioni significative nei tassi di velocità effettiva downstream.
Utilizzo di CPU e memoria: monitora l'utilizzo di CPU e memoria del tuo cluster Managed Service per Apache Kafka. Per saperne di più, consulta Monitorare l'affidabilità dei cluster Kafka.
Log degli errori: controlla regolarmente Cloud Logging per eventuali log degli errori relativi al tuo cluster Managed Service per Apache Kafka o alle tue applicazioni.
Passaggi successivi
- Panoramica di Kafka Connect
- Replica gli argomenti Kafka con MirrorMaker 2.0
- Monitorare un cluster Managed Service per Apache Kafka