


Dokumen ini menjelaskan cara memigrasikan workload Apache Kafka Anda ke Managed Service untuk Apache Kafka.
Pendekatan yang ditunjukkan dalam dokumen ini menggunakan Kafka Connect dengan MirrorMaker 2.0. Kafka Connect adalah framework untuk menghubungkan Kafka dengan sistem eksternal, dan MirrorMaker 2.0 adalah alat untuk mereplikasi data antar-cluster Kafka secara real time.
Arsitektur
Diagram berikut menunjukkan arsitektur untuk memigrasikan data ke Managed Service untuk Apache Kafka:
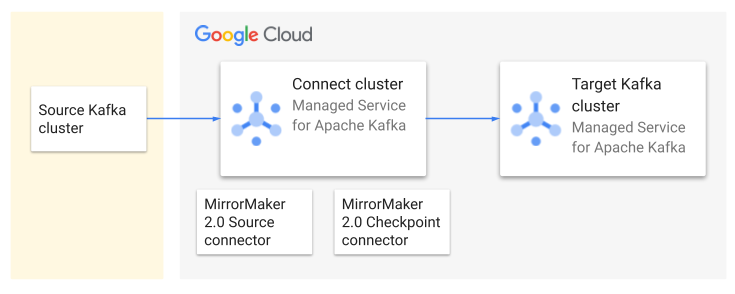
Arsitektur ini terdiri dari komponen berikut:
Cluster Kafka sumber: Cluster Kafka yang ada, yang dapat berada di lokal atau di lingkungan cloud lain. File ini berisi topik yang ingin Anda migrasikan.
Cluster Kafka target: Cluster Managed Service untuk Apache Kafka tempat Anda akan memindahkan data Kafka.
Cluster Connect: Deployment terdistribusi Kafka Connect yang terkait dengan cluster Kafka target.
Konektor Sumber MirrorMaker 2.0: Mereplikasi topik dari cluster sumber ke cluster target. Alat ini akan otomatis membuat topik dan partisi yang sesuai di cluster target jika belum ada. Alat ini juga mengonfigurasi ACL topik pada cluster target agar cocok dengan ACL pada topik sumber.
Konektor Checkpoint MirrorMaker 2.0. Mereplikasi offset konsumen sehingga konsumen dapat beralih ke cluster Kafka sekunder dan membaca dari titik yang sama saat mereka berhenti.
Alur kerja tingkat tinggi
Bagian ini menjelaskan alur kerja umum untuk proses migrasi.
Merencanakan migrasi
Dokumentasikan penyiapan Kafka yang ada, termasuk ukuran cluster, topik, throughput, dan grup konsumen.
Rencanakan strategi migrasi Anda, termasuk cara Anda akan mengalihkan workload aktif ke cluster baru.
Perkirakan ukuran cluster yang diperlukan. Penghitungan ini memberi Anda ukuran awal untuk cluster Managed Service untuk Apache Kafka, guna membantu memastikan bahwa cluster tersebut memiliki sumber daya yang cukup untuk menjalankan workload Anda. Selanjutnya, Anda dapat meningkatkan skala cluster jika diperlukan.
Memigrasikan data
Buat Google Cloud resource, termasuk cluster Managed Service untuk Apache Kafka, cluster Connect, dan konektor MirrorMaker 2.0 yang mereplikasi data Anda.
Setelah Anda mengonfirmasi bahwa topik dan grup konsumen sedang direplikasi, migrasikan konsumen dan produsen ke cluster Managed Service untuk Apache Kafka.
Beralih ke cluster baru
Validasi integritas data dan fungsi aplikasi dengan cluster Managed Service untuk Apache Kafka.
Lakukan migrasi sistem akhir, dengan mengalihkan traffic ke cluster Managed Service untuk Apache Kafka.
Nonaktifkan cluster Kafka lama Anda.
Monitor
Pantau terus performa cluster Managed Service untuk Apache Kafka Anda. Untuk mengetahui informasi selengkapnya, lihat Memantau cluster Managed Service untuk Apache Kafka.
Tinjau dan perbarui dokumentasi untuk mencerminkan perubahan.
Mendokumentasikan penyiapan Kafka Anda
Sebelum memulai migrasi, dokumentasikan penyiapan Kafka Anda saat ini. Kumpulkan informasi berikut:
Periksa versi cluster Apache Kafka Anda. MirrorMaker 2.0 mengharuskan cluster memiliki versi 2.4.0 atau yang lebih tinggi.
Identifikasi topik yang perlu dimigrasikan. Selain itu, catat faktor replikasi dan jumlah partisi setiap topik.
Ukur throughput pesan di tingkat cluster dan topik.
Identifikasi produsen dan konsumen yang terkait dengan setiap topik. Untuk konsumen, identifikasi semua grup konsumen.
Mendokumentasikan konfigurasi konsumen, terutama protokol keamanan dan integrasi apa pun dengan layanan Google Cloud lainnya.
Dengan informasi ini, Anda dapat menghitung ukuran cluster Managed Service untuk Apache Kafka yang diperlukan dan memilih setelan konfigurasi untuk konektor MirrorMaker 2.0.
Untuk menghindari gangguan selama migrasi, petakan semua dependensi aplikasi yang terkait dengan cluster Kafka sumber Anda.
Merencanakan strategi migrasi Anda
Bagian ini mencantumkan beberapa pertimbangan operasional untuk memigrasikan data Kafka Anda. Untuk meminimalkan periode nonaktif selama proses migrasi, pertimbangkan strategi berikut:
Deployment paralel: Sebelum beralih ke cluster baru, jalankan instance paralel aplikasi Anda di cluster lama dan baru. Selama periode transisi ini, nonaktifkan sementara tindakan apa pun di aplikasi Anda yang hanya boleh terjadi satu kali per pesan, untuk mencegah konsekuensi yang tidak diinginkan dari pemrosesan pesan yang sama dua kali. Setelah instance baru sepenuhnya siap, alihkan semua traffic ke cluster baru dan aktifkan kembali semua fitur.
Peluncuran bertahap: Lakukan migrasi dalam fase yang lebih kecil dan mudah dikelola, dimulai dengan aplikasi yang kurang penting. Pendekatan ini membantu mengisolasi potensi masalah dan meminimalkan dampak gangguan apa pun.
Deployment biru dan hijau: Buat replika lengkap lingkungan produksi (hijau) bersama dengan lingkungan yang ada (biru). Mengalihkan traffic secara bertahap dari biru ke hijau. Uji dan validasi lingkungan produksi baru sebelum migrasi akhir. Cara ini meminimalkan waktu nonaktif, tetapi memerlukan lebih banyak resource selama migrasi.
Uji coba. Sebelum memigrasikan lingkungan produksi, lakukan migrasi pengujian di lingkungan pengembangan. Validasi proses dan identifikasi potensi masalah.
Berikut beberapa pertimbangan tambahan saat merencanakan migrasi:
Persyaratan pemrosesan pesan: Pahami toleransi aplikasi Anda terhadap pesan duplikat atau yang hilang dan konfigurasi konsumen yang sesuai.
Komunikasi dan koordinasi: Buat saluran komunikasi yang jelas dan koordinasikan waktu pengalihan.
Rollback. Buat rencana rollback untuk kembali ke cluster asli jika perlu.
Perkirakan ukuran cluster
Untuk memperkirakan memori dan jumlah vCPU yang diperlukan untuk cluster Managed Service untuk Apache Kafka, pertama-tama hitung total throughput tulis dan throughput baca workload Anda. Anda dapat menggunakan metrik JMX berikut untuk mengukur nilai ini:
kafka.server:type=BrokerTopicMetrics,name=BytesInPerSec: Kecepatan byte masuk dari klien di semua topik. Untuk mendapatkan tingkat gabungan untuk semua topik, hapus parametertopic={...}.kafka.server:type=BrokerTopicMetrics,name=BytesOutPerSec: Kecepatan byte keluar ke klien di semua topik. Untuk mendapatkan rasio keseluruhan, hapus parametertopic={...}.
Metrik ini dilaporkan di tingkat broker. Untuk menghitung throughput cluster, gabungkan data di semua broker.
Dengan memantau metrik JMX ini selama jangka waktu tertentu, Anda dapat mengumpulkan titik data untuk menghitung metrik berikut:
Rata-rata data masuk, MBps: Rata-rata kecepatan penyerapan data ke dalam cluster Kafka.
Data masuk puncak, MBps: Kecepatan tertinggi saat data dimasukkan ke dalam cluster Kafka.
Data rata-rata keluar, MBps: Rata-rata kecepatan data yang digunakan dari cluster Kafka.
Data keluar puncak, MBps Kecepatan tertinggi saat data digunakan dari cluster Kafka.
Dengan menggunakan nilai yang dihitung ini, perkirakan rasio setara penulisan sebagai berikut:
Write-equivalent rate (Avg/Peak) = (total write bandwidth) + (total read bandwidth / 4)
Tingkat setara operasi tulis memperhitungkan fakta bahwa bandwidth baca lebih efisien untuk diproses daripada bandwidth tulis. Gunakan rasio setara penulisan untuk memilih ukuran yang sesuai untuk cluster Managed Service untuk Apache Kafka Anda. Untuk mengetahui detailnya, lihat Merencanakan ukuran cluster Kafka.
Menghubungkan Apache Kafka lokal ke Google Cloud
Jika cluster Apache Kafka sumber Anda berada di infrastruktur lokal, Anda harus membuat koneksi aman antara jaringan lokal dan Virtual Private Cloud (VPC) tempat cluster Managed Service untuk Apache Kafka Anda berada. Gunakan salah satu opsi berikut dari Google Cloud.
Cloud VPN: Solusi hemat biaya yang cocok untuk kebutuhan bandwidth yang lebih rendah atau eksperimen migrasi awal. Layanan ini membuat tunnel terenkripsi melalui internet publik. Untuk mengetahui informasi selengkapnya tentang Cloud VPN, lihat Ringkasan Cloud VPN.
Cloud Interconnect: Menyediakan koneksi khusus berbandwidth tinggi antara jaringan lokal Anda dan Google Cloud. Hal ini ideal untuk deployment tingkat perusahaan yang memerlukan throughput lebih tinggi dan latensi lebih rendah. Anda dapat memilih antara Dedicated Interconnect (untuk koneksi fisik langsung) atau Partner Interconnect (koneksi melalui penyedia layanan yang didukung). Untuk mengetahui informasi selengkapnya, lihat ringkasan Cloud Interconnect.
Saat membuat cluster Managed Service untuk Apache Kafka, Anda harus memilih setidaknya satu subnet di Jaringan VPC Anda. Subnet ini menyediakan alamat IP yang digunakan cluster Anda untuk berkomunikasi dengan resource lain di jaringan VPC Anda.
Untuk terhubung secara aman ke cluster Managed Service untuk Apache Kafka dari jaringan lokal atau Jaringan VPC lainnya, Anda dapat menggunakan Private Service Connect melalui Cloud VPN atau Cloud Interconnect. Anda tidak perlu secara eksplisit menyiapkan endpoint Private Service Connect. Saat Anda memilih subnet selama pembuatan cluster, layanan Managed Service untuk Apache Kafka akan otomatis membuat endpoint Private Service Connect yang diperlukan. Hal ini menyederhanakan konfigurasi jaringan dengan memungkinkan Anda mengakses cluster menggunakan alamat IP internal dalam jaringan VPC, tanpa perlu mengelola aturan firewall yang rumit atau alamat IP publik.
Untuk mengetahui informasi selengkapnya, lihat Jaringan untuk Managed Service untuk Apache Kafka.
Membuat Google Cloud resource
Buat resource berikut:
Cluster Managed Service untuk Apache Kafka. Untuk mengetahui informasi selengkapnya, lihat Membuat dan melihat cluster Managed Service untuk Apache Kafka.
Cluster Connect yang cluster Kafka utamanya adalah cluster yang Anda buat pada langkah sebelumnya. Untuk mengetahui informasi selengkapnya, lihat Membuat cluster Connect.
Tempatkan cluster Connect di region yang sama dengan cluster Managed Service untuk Apache Kafka.
Konektor Sumber MirrorMaker 2.0 untuk mereplikasi data. Untuk mengetahui informasi selengkapnya, lihat Membuat konektor Sumber MirrorMaker 2.0.
Konektor Checkpoint MirrorMaker 2.0 untuk mereplikasi checkpoint konsumen. Untuk mengetahui informasi selengkapnya, lihat Membuat konektor Checkpoint MirrorMaker 2.0.
Setelan MirrorMaker 2.0
Setelan berikut menentukan frekuensi pembuatan dan replikasi titik pemeriksaan, yang dapat memengaruhi presisi terjemahan offset konsumen di antara cluster.
Konsumen:
auto.commit.interval.ms: Seberapa sering konsumen melakukan offset.
Konektor Sumber MirrorMaker 2.0:
offset.lag.max: Seberapa sering konektor Sumber menulis sinkronisasi offset.
Konektor Checkpoint MirrorMaker 2.0:
sync.group.offsets.enabled: Jikatrue, konektor Checkpoint akan menyalin checkpoint dari topik internal ke topik__consumer_offsetsyang digunakan konsumen. Untuk memungkinkan konsumen melakukan failover dengan lancar, tetapkan properti ini ketrue.emit.checkpoints.interval.seconds: Seberapa sering konektor Checkpoint menulis checkpoint.sync.group.offsets.interval.seconds: Seberapa sering konektor Checkpoint menyalin checkpoint ke__consumer_offsets.
Untuk mengetahui informasi selengkapnya, lihat Cara kerja konektor Checkpoint MirrorMaker 2.0.
Memantau replikasi data
Pantau proses MirrorMaker 2.0 untuk memastikan proses berjalan dengan benar dan mereplikasi data seperti yang diharapkan. Untuk mengetahui informasi selengkapnya, lihat Memantau cluster Connect.
Setelah memigrasikan aplikasi, pantau metrik berikut untuk memvalidasi keberhasilan:
Kecepatan throughput downstream: Pastikan tidak ada perubahan signifikan pada kecepatan throughput downstream.
Penggunaan CPU dan memori: Pantau penggunaan CPU dan memori cluster Managed Service untuk Apache Kafka Anda. Untuk mengetahui informasi selengkapnya, lihat Memantau keandalan cluster Kafka.
Log error: Periksa Cloud Logging secara rutin untuk melihat log error yang terkait dengan cluster Managed Service untuk Apache Kafka atau aplikasi Anda.
Langkah berikutnya
- Ringkasan Kafka Connect
- Mereplikasi topik Kafka dengan MirrorMaker 2.0
- Memantau cluster Managed Service untuk Apache Kafka