


במאמר הזה מוסבר איך להעביר את עומסי העבודה של Apache Kafka אל השירות המנוהל ל-Apache Kafka.
הגישה שמוצגת במסמך הזה משתמשת ב-Kafka Connect עם MirrorMaker 2.0. Kafka Connect היא מסגרת לחיבור Kafka למערכות חיצוניות, ו-MirrorMaker 2.0 הוא כלי לשכפול נתונים בין אשכולות Kafka בזמן אמת.
ארכיטקטורה
הדיאגרמה הבאה מציגה את הארכיטקטורה למיגרציה של נתונים אל שירות מנוהל ל-Apache Kafka:
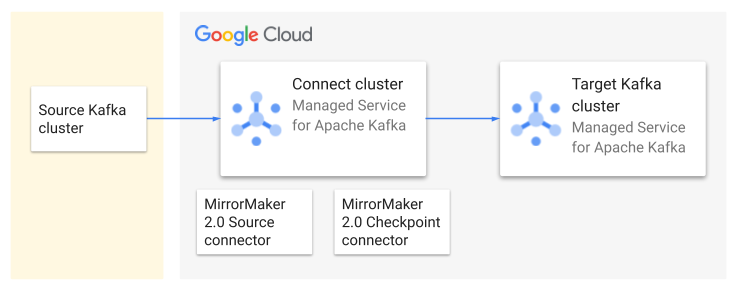
הארכיטקטורה מורכבת מהרכיבים הבאים:
אשכול Kafka של המקור: אשכול Kafka הקיים, שיכול להיות ממוקם במקום או בסביבת ענן אחרת. הוא מכיל את הנושאים שרוצים להעביר.
אשכול Kafka של היעד: אשכול השירות המנוהל ל-Apache Kafka שאליו תעבירו את נתוני Kafka.
Connect cluster: פריסה מבוזרת של Kafka Connect שמשויכת לאשכול היעד של Kafka.
MirrorMaker 2.0 Source connector: משכפל נושאים מאשכול המקור לאשכול היעד. אם הנושאים והמחיצות המתאימים לא קיימים באשכול היעד, הם נוצרים באופן אוטומטי. הכלי גם מגדיר רשימות ACL של נושאים באשכול היעד כך שיתאימו לרשימות ה-ACL של נושאי המקור.
מחבר של נקודת ביקורת MirrorMaker 2.0. משכפל את ההיסטים של הצרכנים כדי שהצרכנים יוכלו לעבור לאשכול Kafka המשני ולקרוא מאותה נקודה שבה הם הפסיקו.
תהליך עבודה כללי
בקטע הזה מתואר תהליך העבודה הכללי של תהליך ההעברה.
תכנון ההעברה
מתעדים את ההגדרה הקיימת של Kafka, כולל גודל האשכול, הנושאים, קצב העברת הנתונים והקבוצות של הצרכנים.
תכנון אסטרטגיית ההעברה, כולל איך תעבירו עומסי עבודה פעילים לאשכול החדש.
הערכת גודל האשכול הנדרש. החישוב הזה נותן לכם גודל ראשוני של אשכול בשירות המנוהל ל-Apache Kafka, כדי לוודא שיש לו מספיק משאבים להפעלת עומסי העבודה. בהמשך תוכלו להגדיל את האשכול לפי הצורך.
העברת נתונים
יצירת Google Cloud משאבים, כולל אשכול של שירות מנוהל ל-Apache Kafka, אשכול Connect ומחברי MirrorMaker 2.0 שמשכפלים את הנתונים.
אחרי שמוודאים שהנושאים וקבוצות הצרכנים משוכפלים, מעבירים את הצרכנים והבעלים אל אשכול השירות המנוהל ל-Apache Kafka.
מעבר לאשכול החדש
אימות של תקינות הנתונים והפונקציונליות של האפליקציה באמצעות אשכול של שירות מנוהל ל-Apache Kafka.
מבצעים את המעבר החד למערכת אחרת (cutover) ומפנים את תעבורת הנתונים אל אשכול השירות המנוהל ל-Apache Kafka.
מוציאים משימוש את אשכול Kafka הישן.
מעקב
חשוב לעקוב באופן רציף אחרי הביצועים של אשכול שירות מנוהל ל-Apache Kafka. מידע נוסף זמין במאמר בנושא מעקב אחרי אשכול של שירות מנוהל ל-Apache Kafka.
בודקים ומעדכנים את התיעוד בהתאם לשינויים.
תיעוד ההגדרה של Kafka
לפני שמתחילים בהעברה, כדאי לתעד את ההגדרה הנוכחית של Kafka. אוספים את הפרטים הבאים:
בודקים את הגרסה של אשכול Apache Kafka. כדי להשתמש ב-MirrorMaker 2.0, הגרסה של האשכול צריכה להיות 2.4.0 ומעלה.
מזהים את הנושאים שצריך להעביר. כדאי גם לתעד את גורם השכפול ואת מספר המחיצות של כל נושא.
מדידת קצב העברת הנתונים של ההודעות ברמת האשכול וברמת הנושא.
לזהות את היצרנים והצרכנים שמשויכים לכל נושא. לצרכנים, מזהים את כל קבוצות הצרכנים.
תיעוד של הגדרות צרכנים, במיוחד פרוטוקולי אבטחה וכל שילוב עם שירותים Google Cloud אחרים.
בעזרת המידע הזה, תוכלו לחשב את הגודל הנדרש של אשכול השירות המנוהל ל-Apache Kafka ולבחור הגדרות תצורה למחברי MirrorMaker 2.0.
כדי למנוע שיבושים במהלך ההעברה, צריך למפות את כל התלות של האפליקציה שקשורה לאשכול Kafka של המקור.
תכנון אסטרטגיית ההעברה
בקטע הזה מפורטים כמה שיקולים תפעוליים להעברת נתונים מ-Kafka. כדי לצמצם את זמן ההשבתה במהלך תהליך ההעברה, כדאי להשתמש בשיטות הבאות:
פריסות מקבילות: לפני המעבר לאשכול החדש, מריצים מופעים מקבילים של האפליקציות באשכול הישן ובאשכול החדש. במהלך תקופת המעבר הזו, כדאי להשבית באופן זמני את כל הפעולות באפליקציה שצריכות להתבצע רק פעם אחת לכל הודעה, כדי למנוע השלכות לא מכוונות כתוצאה מעיבוד של אותה הודעה פעמיים. אחרי שהמופעים החדשים יתעדכנו באופן מלא, צריך להפנות את כל התנועה לאשכול החדש ולהפעיל מחדש את כל התכונות.
השקות בשלבים: מעבירים את האפליקציות בשלבים קטנים ונוחים לניהול, ומתחילים באפליקציות פחות קריטיות. הגישה הזו עוזרת לבודד בעיות פוטנציאליות ולמזער את ההשפעה של שיבושים.
פריסות כחול-ירוק: יוצרים העתק מלא של סביבת הייצור (ירוק) לצד הסביבה הקיימת (כחול). העברת התנועה בהדרגה מכחול לירוק. לפני המעבר הסופי, חשוב לבדוק ולאמת את סביבת הייצור החדשה. הגישה הזו מצמצמת את זמן ההשבתה, אבל דורשת יותר משאבים במהלך ההעברה.
הרצה יבשה. לפני שמעבירים את סביבת הייצור, צריך לבצע העברה לצורך בדיקה בסביבת פיתוח. מאמתים את התהליך ומזהים בעיות פוטנציאליות.
ריכזנו כאן כמה דברים נוספים שכדאי לקחת בחשבון כשמתכננים העברה:
דרישות לעיבוד הודעות: חשוב להבין את רמת הסבילות של האפליקציה להודעות כפולות או חסרות, ולהגדיר את הצרכנים בהתאם.
תקשורת ותיאום: צריך ליצור ערוצי תקשורת ברורים ולתאם את התזמון של המעבר.
החזרה לגרסה קודמת. יוצרים תוכנית חזרה לגרסה הקודמת כדי לחזור לאשכול המקורי אם צריך.
הערכת גודל האוסף
כדי להעריך את הזיכרון ואת מספר ה-vCPU שדרושים לאשכול שלכם בשירות המנוהל ל-Apache Kafka, קודם צריך לחשב את התפוקה הכוללת של עומסי העבודה שלכם. אפשר להשתמש במדדי JMX הבאים כדי למדוד את הערכים האלה:
kafka.server:type=BrokerTopicMetrics,name=BytesInPerSec: קצב הבייטים הנכנסים מלקוחות בכל הנושאים. כדי לקבל את השיעור המצטבר של כל הנושאים, משמיטים את הפרמטרtopic={...}.
kafka.server:type=BrokerTopicMetrics,name=BytesOutPerSec: קצב הבייטים היוצאים ללקוחות בכל הנושאים. כדי לקבל את השיעור הכולל, משמיטים את הפרמטרtopic={...}.
המדדים האלה מדווחים ברמת הברוקר. כדי לחשב את התפוקה של האשכול, צריך לצבור את הנתונים מכל הברוקרים.
אם תעקבו אחרי מדדי JMX האלה לאורך זמן, תוכלו לאסוף נקודות נתונים כדי לחשב את המדדים הבאים:
ממוצע הנתונים הנכנסים, ב-MBps: קצב ממוצע של הכנסת נתונים לאשכול Kafka.
נתוני שיא של קצב העברת הנתונים, ב-MBps: הקצב הכי גבוה שבו הנתונים מוטמעים לאשכול Kafka.
ממוצע הנתונים, MBps: קצב הצריכה הממוצע של הנתונים מאשכול Kafka.
נתוני שיא של נתונים יוצאים, MBps הקצב הכי גבוה שבו הנתונים נצרכים מאשכול Kafka.
בעזרת הערכים המחושבים האלה, אפשר לאמוד את קצב הכתיבה המקבילה באופן הבא:
Write-equivalent rate (Avg/Peak) = (total write bandwidth) + (total read bandwidth / 4)
השיעור המקביל לכתיבה מתחשב בעובדה שרוחב הפס לקריאה יעיל יותר לעיבוד מרוחב הפס לכתיבה. משתמשים בקצב שווה ערך לכתיבה כדי לבחור גודל מתאים לאשכול שלכם בשירות המנוהל ל-Apache Kafka. פרטים נוספים מופיעים במאמר בנושא תכנון הגודל של אשכול Kafka.
התחברות ל- Google Cloudמ-Apache Kafka מקומי
אם אשכול Apache Kafka של המקור נמצא בשרת מקומי, צריך ליצור חיבור מאובטח בין הרשת המקומית לבין הענן הווירטואלי הפרטי (VPC) שבו נמצא אשכול השירות המנוהל ל-Apache Kafka. בוחרים אחת מהאפשרויות הבאות מתוך Google Cloud.
Cloud VPN: פתרון משתלם שמתאים לצרכים של רוחב פס נמוך יותר או לניסויים ראשוניים של העברה. היא יוצרת מנהרה מוצפנת באינטרנט הציבורי. מידע נוסף על Cloud VPN זמין בסקירה הכללית על Cloud VPN.
Cloud Interconnect: מספק חיבור ייעודי עם רוחב פס גבוה בין הרשת המקומית שלכם לבין Google Cloud. האפשרות הזו מתאימה במיוחד לפריסות ברמה שמתאימה לארגונים שדורשות תפוקה גבוהה יותר וזמן אחזור נמוך יותר. אתם יכולים לבחור בין Dedicated Interconnect (לחיבור פיזי ישיר) לבין Partner Interconnect (חיבור דרך ספק שירות נתמך). מידע נוסף מופיע במאמר סקירה כללית על Cloud Interconnect.
כשיוצרים אשכול של שירות מנוהל ל-Apache Kafka, צריך לבחור לפחות תת-רשת אחת ברשת ה-VPC. תת-הרשת הזו מספקת את כתובות ה-IP שבהן האשכול משתמש כדי לתקשר עם משאבים אחרים ברשת ה-VPC.
כדי להתחבר באופן מאובטח לאשכול שירות מנוהל ל-Apache Kafka מרשתות מקומיות או מרשתות VPC אחרות, אפשר להשתמש ב-Private Service Connect דרך Cloud VPN או Cloud Interconnect. אין צורך להגדיר במפורש נקודות קצה של Private Service Connect. כשבוחרים רשת משנה במהלך יצירת האשכול, שירות מנוהל ל-Apache Kafka יוצר באופן אוטומטי את נקודות הקצה הנדרשות של Private Service Connect. התכונה הזו מפשטת את הגדרת הרשת, כי היא מאפשרת לכם לגשת לאשכול באמצעות כתובות IP פנימיות ברשת ה-VPC, בלי שתצטרכו לנהל כללי חומת אש מורכבים או כתובות IP ציבוריות.
מידע נוסף זמין במאמר בנושא רשתות בשירות מנוהל ל-Apache Kafka.
יצירת Google Cloud משאבים
יוצרים את המשאבים הבאים:
קלאסטר של שירות מנוהל ל-Apache Kafka. מידע נוסף מופיע במאמר בנושא יצירה והצגה של אשכול שירות מנוהל ל-Apache Kafka.
קלאסטר Connect שקלאסטר Kafka הראשי שלו הוא הקלאסטר שיצרתם בשלב הקודם. מידע נוסף זמין במאמר בנושא יצירת אשכול Connect.
ממקמים את אשכול Connect באותו אזור כמו אשכול השירות המנוהל ל-Apache Kafka.
מחבר מקור של MirrorMaker 2.0 לשכפול נתונים. מידע נוסף זמין במאמר יצירת מחבר מקור של MirrorMaker 2.0.
מחבר של MirrorMaker 2.0 Checkpoint לשכפול של נקודות ביקורת של צרכנים. מידע נוסף זמין במאמר בנושא יצירת מחבר של MirrorMaker 2.0 Checkpoint.
הגדרות של MirrorMaker 2.0
ההגדרות הבאות קובעות את התדירות שבה נוצרות נקודות ביקורת ומשוכפלות, מה שיכול להשפיע על הדיוק של תרגום ההיסטים של הצרכנים בין האשכולות.
צרכנים:
-
auto.commit.interval.ms: באיזו תדירות צרכן מבצע פעולות של קביעת היסט.
-
מחבר המקור של MirrorMaker 2.0:
-
offset.lag.max: באיזו תדירות מחבר המקור כותב סנכרון של היסטים.
-
MirrorMaker 2.0 Checkpoint connector:
-
sync.group.offsets.enabled: אםtrue, מחבר Checkpoint מעתיק נקודות ביקורת מנושא פנימי לנושא__consumer_offsetsשמשמש צרכנים. כדי לאפשר לצרכנים לבצע מעבר לגיבוי ללא הפרעה, צריך להגדיר את המאפיין הזה לערךtrue. -
emit.checkpoints.interval.seconds: באיזו תדירות מחבר Checkpoint כותב נקודות עצירה. -
sync.group.offsets.interval.seconds: באיזו תדירות מחבר Checkpoint מעתיק נקודות ביקורת ל-__consumer_offsets.
-
מידע נוסף זמין במאמר איך פועל מחבר MirrorMaker 2.0 Checkpoint.
מעקב אחרי שכפול נתונים
עוקבים אחרי התהליך של MirrorMaker 2.0 כדי לוודא שהוא פועל בצורה תקינה ומשכפל את הנתונים כצפוי. מידע נוסף זמין במאמר בנושא מעקב אחרי אשכול Connect.
אחרי העברת האפליקציות, חשוב לעקוב אחרי המדדים הבאים כדי לוודא שההעברה הצליחה:
שיעורי העברת נתונים במורד הזרם: חשוב לוודא שאין שינויים משמעותיים בשיעורי העברת הנתונים במורד הזרם.
השימוש במעבד (CPU) ובזיכרון: מעקב אחרי השימוש במעבד ובזיכרון באשכול של שירות מנוהל ל-Apache Kafka. מידע נוסף זמין במאמר בנושא מעקב אחרי אמינות של אשכולי Kafka.
יומני שגיאות: מומלץ לבדוק באופן קבוע את Cloud Logging כדי לראות אם יש יומני שגיאות שקשורים לאשכול של השירות המנוהל ל-Apache Kafka או לאפליקציות שלכם.
המאמרים הבאים
- סקירה כללית על Kafka Connect
- שכפול נושאים ב-Kafka באמצעות MirrorMaker 2.0
- מעקב אחרי אשכול של שירות מנוהל ל-Apache Kafka