


In diesem Dokument wird beschrieben, wie Sie Ihre Apache Kafka-Arbeitslasten zu Managed Service for Apache Kafka migrieren.
Bei dem in diesem Dokument beschriebenen Ansatz wird Kafka Connect mit MirrorMaker 2.0 verwendet. Kafka Connect ist ein Framework zum Verbinden von Kafka mit externen Systemen und MirrorMaker 2.0 ist ein Tool zum Replizieren von Daten zwischen Kafka-Clustern in Echtzeit.
Architektur
Das folgende Diagramm zeigt die Architektur für die Migration von Daten zu Managed Service for Apache Kafka:
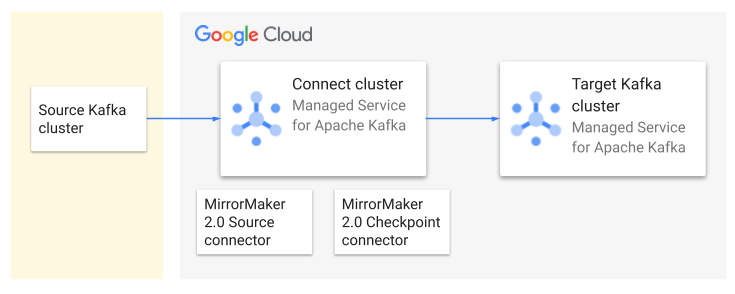
Die Architektur besteht aus den folgenden Komponenten:
Kafka-Quellcluster: Ihr vorhandener Kafka-Cluster, der sich lokal oder in einer anderen Cloud-Umgebung befinden kann. Sie enthält die Themen, die Sie migrieren möchten.
Ziel-Kafka-Cluster: Der Managed Service for Apache Kafka-Cluster, in den Sie Ihre Kafka-Daten verschieben.
Connect-Cluster: Eine verteilte Bereitstellung von Kafka Connect, die dem Ziel-Kafka-Cluster zugeordnet ist.
MirrorMaker 2.0-Quell-Connector: Repliziert Themen vom Quellcluster in den Zielcluster. Die entsprechenden Themen und Partitionen werden automatisch im Zielcluster erstellt, sofern sie nicht vorhanden sind. Außerdem werden die ACLs für Themen im Zielcluster so konfiguriert, dass sie den ACLs für die Quellthemen entsprechen.
MirrorMaker 2.0-Checkpoint-Connector Er repliziert Nutzer-Offsets, sodass Nutzer zum sekundären Kafka-Cluster wechseln und an der Stelle fortfahren können, an der sie aufgehört haben.
Allgemeiner Workflow
In diesem Abschnitt wird der allgemeine Workflow für den Migrationsprozess beschrieben.
Migration planen
Dokumentieren Sie Ihre vorhandene Kafka-Einrichtung, einschließlich Clustergröße, Themen, Durchsatz und Nutzergruppen.
Planen Sie Ihre Migrationsstrategie, einschließlich der Art und Weise, wie Sie aktive Arbeitslasten auf den neuen Cluster umstellen.
Erforderliche Clustergröße schätzen Mit dieser Berechnung erhalten Sie eine erste Größe für Ihren Managed Service for Apache Kafka-Cluster, damit er genügend Ressourcen für die Ausführung Ihrer Arbeitslasten hat. Bei Bedarf können Sie den Cluster später hochskalieren.
Daten migrieren
Ressourcen Google Cloud erstellen, einschließlich eines Managed Service for Apache Kafka-Clusters, eines Connect-Clusters und der MirrorMaker 2.0-Connectors, die Ihre Daten replizieren.
Nachdem Sie bestätigt haben, dass Themen und Verbrauchergruppen repliziert werden, migrieren Sie Verbraucher und Produzenten zum Managed Service for Apache Kafka-Cluster.
Zum neuen Cluster wechseln
Prüfen Sie die Datenintegrität und Anwendungsfunktionen mit dem Managed Service for Apache Kafka-Cluster.
Führen Sie die endgültige Umstellung durch und leiten Sie den Traffic zum Managed Service for Apache Kafka-Cluster um.
Stellen Sie den Betrieb Ihres alten Kafka-Clusters ein.
Überwachen
Überwachen Sie die Leistung Ihres Managed Service for Apache Kafka-Clusters kontinuierlich. Weitere Informationen finden Sie unter Managed Service for Apache Kafka-Cluster überwachen.
Überprüfen und aktualisieren Sie die Dokumentation, um die Änderungen zu berücksichtigen.
Kafka-Einrichtung dokumentieren
Dokumentieren Sie Ihre aktuelle Kafka-Einrichtung, bevor Sie mit der Migration beginnen. Halten Sie die folgenden Informationen bereit:
Prüfen Sie die Version Ihres Apache Kafka-Clusters. Für MirrorMaker 2.0 muss der Cluster Version 2.4.0 oder höher haben.
Ermitteln Sie die Themen, die migriert werden müssen. Dokumentieren Sie außerdem den Replikationsfaktor und die Anzahl der Partitionen für jedes Thema.
Messen Sie den Nachrichtendurchsatz sowohl auf Cluster- als auch auf Themenebene.
Identifizieren Sie die Ersteller und Nutzer, die mit den einzelnen Themen in Verbindung stehen. Geben Sie für Verbraucher alle Verbrauchergruppen an.
Dokumentieren Sie die Konfigurationen der Nutzer, insbesondere Sicherheitsprotokolle und die Integration mit anderen Google Cloud Diensten.
Anhand dieser Informationen können Sie die erforderliche Größe des Managed Service for Apache Kafka-Clusters berechnen und Konfigurationseinstellungen für die MirrorMaker 2.0-Connectors auswählen.
Um Unterbrechungen während der Migration zu vermeiden, müssen Sie alle Anwendungsabhängigkeiten im Zusammenhang mit Ihrem Quell-Kafka-Cluster ermitteln.
Migrationsstrategie planen
In diesem Abschnitt werden einige betriebliche Überlegungen zur Migration Ihrer Kafka-Daten aufgeführt. Mit den folgenden Strategien können Sie Ausfallzeiten während der Migration minimieren:
Parallele Bereitstellungen: Bevor Sie zum neuen Cluster wechseln, sollten Sie parallele Instanzen Ihrer Anwendungen sowohl im alten als auch im neuen Cluster ausführen. Deaktivieren Sie während dieser Übergangszeit vorübergehend alle Aktionen in Ihrer Anwendung, die nur einmal pro Nachricht ausgeführt werden dürfen, um unbeabsichtigte Folgen durch die doppelte Verarbeitung derselben Nachricht zu vermeiden. Wenn die neuen Instanzen vollständig synchronisiert sind, leiten Sie den gesamten Traffic zum neuen Cluster um und aktivieren Sie alle Funktionen wieder.
Schrittweise Einführung: Führen Sie die Migration in kleineren, überschaubaren Phasen durch und beginnen Sie mit weniger kritischen Anwendungen. So lassen sich potenzielle Probleme eingrenzen und die Auswirkungen von Störungen minimieren.
Blau/Grün-Bereitstellungen: Erstellen Sie neben der vorhandenen Produktionsumgebung (blau) eine vollständige Replik (grün). Leiten Sie den Traffic nach und nach von Blau zu Grün um. Testen und validieren Sie die neue Produktionsumgebung vor der endgültigen Umstellung. Dieser Ansatz minimiert Ausfallzeiten, erfordert aber während der Migration mehr Ressourcen.
Probelauf Bevor Sie Ihre Produktionsumgebung migrieren, sollten Sie eine Testmigration in einer Entwicklungsumgebung durchführen. Prozess validieren und potenzielle Probleme identifizieren
Hier sind einige zusätzliche Überlegungen bei der Planung einer Migration:
Anforderungen an die Nachrichtenverarbeitung: Machen Sie sich mit der Toleranz Ihrer Anwendung für doppelte oder fehlende Nachrichten vertraut und konfigurieren Sie die Consumer entsprechend.
Kommunikation und Koordination: Richten Sie klare Kommunikationskanäle ein und koordinieren Sie die Umstellungszeiten.
Rollback Erstellen Sie einen Rollback-Plan, um bei Bedarf zum ursprünglichen Cluster zurückzukehren.
Clustergröße schätzen
Um den Arbeitsspeicher und die Anzahl der vCPUs zu schätzen, die für Ihren Managed Service for Apache Kafka-Cluster erforderlich sind, berechnen Sie zuerst den gesamten Schreib- und Lesedurchsatz Ihrer Arbeitslasten. Sie können die folgenden JMX-Messwerte verwenden, um diese Werte zu messen:
kafka.server:type=BrokerTopicMetrics,name=BytesInPerSec: Die eingehende Byte-Rate von Clients für alle Themen. Wenn Sie die zusammengefasste Rate für alle Themen abrufen möchten, lassen Sie den Parametertopic={...}weg .kafka.server:type=BrokerTopicMetrics,name=BytesOutPerSec: Die ausgehende Byte-Rate zu Clients für alle Themen. Wenn Sie die Gesamtrate abrufen möchten, lassen Sie den Parametertopic={...}weg.
Diese Messwerte werden auf Maklerebene erfasst. Um den Clusterdurchsatz zu berechnen, aggregieren Sie die Daten über alle Broker hinweg.
Wenn Sie diese JMX-Messwerte über einen bestimmten Zeitraum hinweg beobachten, können Sie Datenpunkte erfassen, um die folgenden Messwerte zu berechnen:
Durchschnittliche Datenrate (MB/s): Die durchschnittliche Rate, mit der Daten in den Kafka-Cluster aufgenommen werden.
Maximale Datenübertragungsrate (MB/s): Die höchste Rate, mit der Daten in den Kafka-Cluster aufgenommen werden.
Durchschnittliche Datenmenge (MB/s): Die durchschnittliche Rate, mit der Daten aus dem Kafka-Cluster abgerufen werden.
Maximale Datenübertragungsrate, MBps: Die höchste Rate, mit der Daten aus dem Kafka-Cluster abgerufen werden.
Schätzen Sie anhand dieser berechneten Werte die Schreibäquivalentrate so:
Write-equivalent rate (Avg/Peak) = (total write bandwidth) + (total read bandwidth / 4)
Die schreibäquivalente Rate berücksichtigt, dass die Verarbeitung der Lesebandbreite effizienter ist als die der Schreibbandbreite. Anhand der Rate, die dem Schreiben entspricht, können Sie eine geeignete Größe für Ihren Managed Service for Apache Kafka-Cluster auswählen. Weitere Informationen finden Sie unter Größe des Kafka-Clusters planen.
On-Premise-Apache Kafka mit Google Cloudverbinden
Wenn sich Ihr Apache Kafka-Quellcluster lokal befindet, müssen Sie eine sichere Verbindung zwischen Ihrem lokalen Netzwerk und der Virtual Private Cloud (VPC) herstellen, in der sich Ihr Managed Service for Apache Kafka-Cluster befindet. Verwenden Sie eine der folgenden Optionen aus Google Cloud.
Cloud VPN: Eine kostengünstige Lösung, die sich für geringere Bandbreitenanforderungen oder erste Migrationsversuche eignet. Er erstellt einen verschlüsselten Tunnel über das öffentliche Internet. Weitere Informationen zu Cloud VPN finden Sie unter Cloud VPN – Übersicht.
Cloud Interconnect: Bietet eine dedizierte Verbindung mit hoher Bandbreite zwischen Ihrem lokalen Netzwerk und Google Cloud. Das ist ideal für Bereitstellungen auf Unternehmensniveau, die einen höheren Durchsatz und eine geringere Latenz erfordern. Sie können zwischen Dedicated Interconnect (für eine direkte physische Verbindung) und Partner Interconnect (Verbindung über einen unterstützten Dienstanbieter) wählen. Weitere Informationen finden Sie unter Cloud Interconnect – Übersicht.
Wenn Sie einen Managed Service for Apache Kafka-Cluster erstellen, müssen Sie mindestens ein Subnetz in Ihrem VPC-Netzwerk auswählen. Dieses Subnetz stellt die IP-Adressen bereit, die Ihr Cluster für die Kommunikation mit anderen Ressourcen in Ihrem VPC-Netzwerk verwendet.
Wenn Sie eine sichere Verbindung zu Ihrem Managed Service for Apache Kafka-Cluster aus lokalen Netzwerken oder anderen VPC-Netzwerken herstellen möchten, können Sie Private Service Connect über Cloud VPN oder Cloud Interconnect verwenden. Sie müssen Private Service Connect-Endpunkte nicht explizit einrichten. Wenn Sie beim Erstellen eines Clusters ein Subnetzwerk auswählen, erstellt der Managed Service for Apache Kafka-Dienst automatisch die erforderlichen Private Service Connect-Endpunkte. Dies vereinfacht die Netzwerkkonfiguration, da Sie über interne IP-Adressen in Ihrem VPC-Netzwerk auf Ihren Cluster zugreifen können, ohne komplexe Firewallregeln oder öffentliche IP-Adressen verwalten zu müssen.
Weitere Informationen finden Sie unter Netzwerk für Managed Service for Apache Kafka.
Google Cloud -Ressourcen erstellen
Erstellen Sie die folgenden Ressourcen:
Ein Managed Service for Apache Kafka-Cluster. Weitere Informationen finden Sie unter Managed Service for Apache Kafka-Cluster erstellen und ansehen.
Ein Connect-Cluster, dessen primärer Kafka-Cluster der Cluster ist, den Sie im vorherigen Schritt erstellt haben. Weitere Informationen finden Sie unter Connect-Cluster erstellen.
Platzieren Sie den Connect-Cluster in derselben Region wie den Managed Service for Apache Kafka-Cluster.
Ein MirrorMaker 2.0-Quell-Connector zum Replizieren von Daten. Weitere Informationen finden Sie unter MirrorMaker 2.0-Quellconnector erstellen.
Ein MirrorMaker 2.0-Prüfpunkt-Connector zum Replizieren von Nutzerprüfpunkten. Weitere Informationen finden Sie unter MirrorMaker 2.0-Checkpoint-Connector erstellen.
MirrorMaker 2.0-Einstellungen
Die folgenden Einstellungen bestimmen, wie oft Checkpoints erstellt und repliziert werden. Dies kann sich auf die Genauigkeit der Übersetzung des Consumer-Offsets zwischen den Clustern auswirken.
Nutzung:
auto.commit.interval.ms: Wie oft ein Nutzer Ausgleichsmaßnahmen vornimmt.
MirrorMaker 2.0-Quellconnector:
offset.lag.max: Wie oft der Quell-Connector Offset-Synchronisierungen schreibt.
MirrorMaker 2.0-Prüfpunkt-Connector:
sync.group.offsets.enabled: Wenntrue, kopiert der Checkpoint-Connector Checkpoints aus einem internen Thema in das Thema__consumer_offsets, das von Nutzern verwendet wird. Damit Nutzer nahtlos auf ein anderes Gerät wechseln können, legen Sie diese Property auftruefest.emit.checkpoints.interval.seconds: Wie oft der Checkpoint-Connector Checkpoints schreibt.sync.group.offsets.interval.seconds: Wie oft der Checkpoint-Connector Checkpoints in__consumer_offsetskopiert.
Weitere Informationen finden Sie unter Funktionsweise des MirrorMaker 2.0-Checkpoint-Connectors.
Datenreplikation überwachen
Überwachen Sie den MirrorMaker 2.0-Prozess, um sicherzustellen, dass er korrekt ausgeführt wird und Daten wie erwartet repliziert werden. Weitere Informationen finden Sie unter Connect-Cluster überwachen.
Nach der Migration Ihrer Anwendungen sollten Sie die folgenden Messwerte im Blick behalten, um den Erfolg zu prüfen:
Downstream-Durchsatzraten: Achten Sie darauf, dass es keine signifikanten Änderungen bei den Downstream-Durchsatzraten gibt.
CPU- und Speicherauslastung: Überwachen Sie die CPU- und Speicherauslastung Ihres Managed Service for Apache Kafka-Clusters. Weitere Informationen finden Sie unter Kafka-Cluster auf Zuverlässigkeit überwachen.
Fehlerlogs: Prüfen Sie Cloud Logging regelmäßig auf Fehlerlogs, die sich auf Ihren Managed Service for Apache Kafka-Cluster oder Ihre Anwendungen beziehen.
Nächste Schritte
- Kafka Connect – Übersicht
- Kafka-Themen mit MirrorMaker 2.0 replizieren
- Managed Service for Apache Kafka-Cluster überwachen