


이 튜토리얼에서는 MirrorMaker 2.0 소스 커넥터를 사용하여 Managed Service for Apache Kafka 클러스터 간에 데이터를 복제하는 방법을 보여줍니다.
클러스터는 동일한 프로젝트 또는 다른 프로젝트에 있을 수 있으며 동일한 리전 또는 다른 리전에 있을 수 있습니다. 이 튜토리얼에서는 리전 간에 복제를 설정하지만 동일한 프로젝트 내에서 설정합니다. 다른 조합의 경우 단계는 동일합니다.
아키텍처
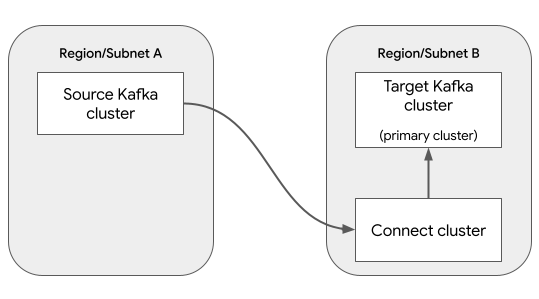
이 시나리오에는 다음 세 개의 클러스터가 있습니다.
데이터가 복제되는 Kafka 클러스터입니다. 이 클러스터는 데이터의 소스이므로 소스 클러스터라고 합니다.
복제된 데이터가 작성되는 Kafka 클러스터입니다. 이 클러스터를 타겟 클러스터라고 합니다.
MirrorMaker 2.0 소스 커넥터를 만들고 관리할 수 있는 클러스터 연결
Connect 클러스터가 타겟 클러스터에 연결됩니다. 쓰기 작업의 지연 시간을 최소화하려면 Connect 클러스터를 타겟 클러스터와 동일한 리전에 배치하세요.
다음 다이어그램은 이러한 구성요소를 보여줍니다.
데이터 복제는 MirrorMaker 2.0 소스 커넥터에 의해 실행됩니다. 이 시나리오에서는 다른 두 개의 MirrorMaker 2.0 커넥터가 선택사항입니다.
MirrorMaker 2.0 체크포인트 커넥터: 타겟 클러스터의 소비자가 소스 클러스터와 동일한 지점에서 처리를 재개할 수 있도록 하여 원활한 장애 조치를 지원합니다.
MirrorMaker 2.0 하트비트 커넥터: 소스 Kafka 클러스터에서 주기적인 하트비트 메시지를 생성하여 데이터 복제의 상태와 상태를 모니터링할 수 있습니다.
이 튜토리얼에서는 이러한 선택적 커넥터를 사용하지 않습니다. 자세한 내용은 MirrorMaker 2.0을 사용하는 경우를 참고하세요.
시작하기 전에
콘솔
- Google Cloud 계정에 로그인합니다. Google Cloud를 처음 사용하는 경우 계정을 만들고 Google 제품의 실제 성능을 평가해 보세요. 신규 고객에게는 워크로드를 실행, 테스트, 배포하는 데 사용할 수 있는 $300의 무료 크레딧이 제공됩니다.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Managed Kafka API, if it is not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
프로젝트에 다음 역할이 있는지 확인합니다. 관리형 Kafka 클러스터 편집자, 관리형 Kafka Connect 클러스터 편집자, 관리형 Kafka 커넥터 편집자
역할 확인
-
Google Cloud 콘솔에서 IAM 페이지로 이동합니다.
IAM으로 이동 - 프로젝트를 선택합니다.
-
주 구성원 열에서 나 또는 내가 속한 그룹을 식별하는 모든 행을 찾습니다. 내가 속한 그룹을 알아보려면 관리자에게 문의하세요.
- 나를 지정하거나 포함하는 모든 행의 역할 열을 확인하여 역할 목록에 필요한 역할이 포함되어 있는지 확인합니다.
역할 부여
-
Google Cloud 콘솔에서 IAM 페이지로 이동합니다.
IAM으로 이동 - 프로젝트를 선택합니다.
- 액세스 권한 부여를 클릭합니다.
-
새 주 구성원 필드에 사용자 식별자를 입력합니다. 일반적으로 Google 계정의 이메일 주소입니다.
- 역할 선택을 클릭한 다음 역할을 검색합니다.
- 역할을 추가로 부여하려면 다른 역할 추가를 클릭하고 각 역할을 추가합니다.
- 저장을 클릭합니다.
-
gcloud
- Google Cloud 계정에 로그인합니다. Google Cloud를 처음 사용하는 경우 계정을 만들고 Google 제품의 실제 성능을 평가해 보세요. 신규 고객에게는 워크로드를 실행, 테스트, 배포하는 데 사용할 수 있는 $300의 무료 크레딧이 제공됩니다.
-
Google Cloud CLI를 설치합니다.
-
외부 ID 공급업체 (IdP)를 사용하는 경우 먼저 제휴 ID로 gcloud CLI에 로그인해야 합니다.
-
gcloud CLI를 초기화하려면, 다음 명령어를 실행합니다.
gcloud init -
Google Cloud 프로젝트를 만들거나 선택합니다.
프로젝트를 선택하거나 만드는 데 필요한 역할
- 프로젝트 선택: 프로젝트를 선택하는 데는 특정 IAM 역할이 필요하지 않습니다. 역할이 부여된 프로젝트를 선택하면 됩니다.
-
프로젝트 만들기: 프로젝트를 만들려면
resourcemanager.projects.create권한이 포함된 프로젝트 생성자 역할(roles/resourcemanager.projectCreator)이 필요합니다. 역할 부여 방법 알아보기
-
Google Cloud 프로젝트를 만듭니다.
gcloud projects create PROJECT_ID
PROJECT_ID를 만들려는 Google Cloud 프로젝트의 이름으로 바꿉니다. -
만든 Google Cloud 프로젝트를 선택합니다.
gcloud config set project PROJECT_ID
PROJECT_ID을 Google Cloud 프로젝트 이름으로 바꿉니다.
아직 사용 설정되지 않은 경우 Managed Kafka API를 사용 설정합니다.
API 사용 설정에 필요한 역할
API를 사용 설정하려면
serviceusage.services.enable권한이 필요합니다. 프로젝트를 만든 경우 소유자 역할 (roles/owner)을 통해 이 권한이 이미 있을 수 있습니다. 그렇지 않은 경우 서비스 사용량 관리자 역할 (roles/serviceusage.serviceUsageAdmin)을 통해 이 권한을 얻을 수 있습니다. 역할을 부여하는 방법 알아보기gcloud services enable managedkafka.googleapis.com
-
사용자 계정에 역할을 부여합니다. 다음 IAM 역할마다 다음 명령어를 1회 실행합니다.
  roles/managedkafka.clusterEditor,
  roles/managedkafka.connectClusterEditor,
  roles/managedkafka.connectorEditor
gcloud projects add-iam-policy-binding PROJECT_ID --member="user:USER_IDENTIFIER" --role=ROLE
다음을 바꿉니다.
PROJECT_ID: 프로젝트 ID입니다.USER_IDENTIFIER: 사용자 계정의 식별자입니다. 예를 들면myemail@example.com입니다.ROLE: 사용자 계정에 부여하는 IAM 역할입니다.
소스 Kafka 클러스터 만들기
이 단계에서는 Managed Service for Apache Kafka 클러스터를 만듭니다. 이 클러스터는 복제할 데이터가 포함된 소스 클러스터입니다.
콘솔
Managed Service for Apache Kafka > 클러스터 페이지로 이동합니다.
만들기를 클릭합니다.
클러스터 이름 체크박스에 클러스터 이름을 입력합니다.
리전 목록에서 클러스터의 위치를 선택합니다.
네트워크 구성에서 클러스터에 액세스할 수 있는 서브넷을 구성합니다.
- 프로젝트에서 사용자 프로젝트를 선택합니다.
- 네트워크에서 프로젝트의 VPC 네트워크를 선택합니다.
- 서브넷에서 서브넷을 선택합니다.
- 완료를 클릭합니다.
만들기를 클릭합니다.
클러스터가 생성되는 동안 클러스터 상태는 Creating입니다. 클러스터 생성이 완료되면 상태가 Active입니다.
gcloud
소스 Kafka 클러스터를 만들려면 managed-kafka clusters create 명령어를 실행합니다.
gcloud managed-kafka clusters create SOURCE_KAFKA_CLUSTER \
--location=SOURCE_REGION \
--cpu=3 \
--memory=3GiB \
--subnets=projects/PROJECT_ID/regions/SOURCE_REGION/subnetworks/SOURCE_SUBNET \
--async
다음을 바꿉니다.
SOURCE_KAFKA_CLUSTER: Kafka 클러스터의 이름SOURCE_REGION: 클러스터의 위치지원되는 위치에 대한 자세한 내용은 Managed Service for Apache Kafka 위치를 참고하세요.
PROJECT_ID: 프로젝트 ID입니다.SOURCE_SUBNET: 클러스터를 배포할 서브넷(예:default)
이 명령어는 비동기적으로 실행되며 작업 ID를 반환합니다.
Check operation [projects/PROJECT_ID/locations/SOURCE_SUBNET/operations/OPERATION_ID] for status.
생성 작업의 진행 상황을 추적하려면 gcloud managed-kafka operations describe 명령어를 사용합니다.
gcloud managed-kafka operations describe OPERATION_ID \
  --location=SOURCE_REGION
자세한 내용은 클러스터 생성 작업 모니터링을 참고하세요.
Kafka 주제 만들기
소스 클러스터가 준비되면 다음과 같이 주제를 만듭니다.
콘솔
Managed Service for Apache Kafka > 클러스터 페이지로 이동합니다.
클러스터 이름을 클릭합니다.
클러스터 세부정보 페이지에서 주제 만들기를 클릭합니다.
주제 이름 체크박스에 주제 이름을 입력합니다.
만들기를 클릭합니다.
gcloud
Kafka 주제를 만들려면 managed-kafka topics create 명령어를 실행합니다.
gcloud managed-kafka topics create TOPIC_NAME \
--cluster=SOURCE_KAFKA_CLUSTER \
--location=SOURCE_REGION \
--partitions=10 \
--replication-factor=3
다음을 바꿉니다.
TOPIC_NAME: 만들 Kafka 주제의 이름SOURCE_KAFKA_CLUSTER: 소스 클러스터의 이름SOURCE_REGION: 소스 클러스터를 만든 리전입니다.
타겟 Kafka 클러스터 만들기
이 단계에서는 두 번째 Managed Service for Apache Kafka 클러스터를 만듭니다. 이 클러스터는 MirrorMaker 2.0이 데이터를 복제하는 대상 클러스터입니다.
콘솔
Managed Service for Apache Kafka > 클러스터 페이지로 이동합니다.
만들기를 클릭합니다.
클러스터 이름 체크박스에 클러스터 이름을 입력합니다.
리전 목록에서 클러스터의 위치를 선택합니다. 소스 클러스터가 위치한 리전과 다른 리전을 선택합니다.
네트워크 구성에서 타겟 클러스터에 액세스할 수 있는 서브넷을 구성합니다. 서브넷은 소스 클러스터의 서브넷과 동일한 VPC 네트워크에 있어야 합니다.
- 프로젝트에서 사용자 프로젝트를 선택합니다.
- 네트워크에서 소스 클러스터의 서브넷과 동일한 VPC 네트워크를 선택합니다.
- 서브넷에서 서브넷을 선택합니다.
- 완료를 클릭합니다.
만들기를 클릭합니다.
클러스터가 생성되는 동안 클러스터 상태는 Creating입니다. 클러스터 생성이 완료되면 상태가 Active입니다.
gcloud
타겟 Kafka 클러스터를 만들려면 managed-kafka clusters create 명령어를 실행합니다.
gcloud managed-kafka clusters create TARGET_KAFKA_CLUSTER \
--location=TARGET_REGION \
--cpu=3 \
--memory=3GiB \
--subnets=projects/PROJECT_ID/regions/TARGET_REGION/subnetworks/TARGET_SUBNET \
--async
다음을 바꿉니다.
TARGET_KAFKA_CLUSTER: Kafka 클러스터의 이름TARGET_REGION: 클러스터의 위치입니다. 소스 클러스터가 있는 리전과 다른 리전을 선택합니다.지원되는 위치에 대한 자세한 내용은 Managed Service for Apache Kafka 위치를 참고하세요.
PROJECT_ID: 프로젝트 ID입니다.TARGET_SUBNET: 클러스터를 배포할 서브넷(예:default)소스 클러스터와 동일한 VPC의 서브넷을 선택합니다.
Connect 클러스터 만들기
이 단계에서는 Connect 클러스터를 만듭니다. Connect 클러스터를 만드는 데는 보통 20~30분이 걸립니다.
이 단계를 시작하기 전에 이전 단계의 대상 Kafka 클러스터가 완전히 생성되었는지 확인합니다.
콘솔
Managed Service for Apache Kafka > Connect Clusters 페이지로 이동합니다.
만들기를 클릭합니다.
Connect 클러스터 이름에 문자열을 입력합니다. 예를 들면
my-connect-cluster입니다.기본 Kafka 클러스터에서 이전 단계에서 만든 타겟 Kafka 클러스터를 선택합니다. (소스 Kafka 클러스터는 선택하지 마세요.)
위치, 네트워크 구성, 작업자 서브넷의 경우 기본값을 사용하거나 특정 요구사항에 맞게 맞춤설정할 수 있습니다.
Connect 클러스터가 소스 클러스터의 DNS 도메인을 확인할 수 있도록 하려면 다음 단계를 수행하세요.
변환 가능한 DNS 도메인을 펼칩니다.
DNS 도메인 추가를 클릭합니다.
Kafka 클러스터 목록에서 소스 Kafka 클러스터를 선택합니다.
만들기를 클릭합니다.
클러스터가 생성되는 동안 클러스터 상태는 Creating입니다. 클러스터 생성이 완료되면 상태가 Active입니다.
gcloud
Connect 클러스터를 만들려면 gcloud managed-kafka connect-clusters create 명령어를 실행합니다.
gcloud managed-kafka connect-clusters create CONNECT_CLUSTER \
  --location=TARGET_REGION \
  --cpu=12 \
  --memory=12GiB \
  --primary-subnet=projects/PROJECT_ID/regions/TARGET_REGION/subnetworks/TARGET_SUBNET \
  --kafka-cluster=TARGET_KAFKA_CLUSTER \
  --dns-name=SOURCE_KAFKA_CLUSTER.SOURCE_REGION.managedkafka.PROJECT_ID.cloud.goog. \
  --async
다음을 바꿉니다.
CONNECT_CLUSTER: Connect 클러스터의 이름TARGET_REGION: 대상 Kafka 클러스터를 만든 리전PROJECT_ID: 프로젝트 ID입니다.TARGET_SUBNET: 대상 Kafka 클러스터를 만든 서브넷TARGET_KAFKA_CLUSTER: 대상 Kafka 클러스터의 이름SOURCE_KAFKA_CLUSTER: 소스 Kafka 클러스터의 이름SOURCE_REGION: 소스 Kafka 클러스터를 만든 리전입니다.
이 명령어는 비동기적으로 실행되며 작업 ID를 반환합니다.
Check operation [projects/PROJECT_ID/locations/TARGET_REGION/operations/OPERATION_ID] for status.
생성 작업의 진행 상황을 추적하려면 gcloud managed-kafka operations describe 명령어를 사용합니다.
gcloud managed-kafka operations describe OPERATION_ID \
  --location=TARGET_REGION
자세한 내용은 클러스터 생성 작업 모니터링을 참고하세요.
MirrorMaker 2.0 소스 커넥터 만들기
이 단계에서는 MirrorMaker 2.0 소스 커넥터를 만듭니다. 이 커넥터는 소스 Kafka 클러스터에서 타겟 Kafka 클러스터로 메시지를 복제합니다.
콘솔
Managed Service for Apache Kafka > Connect Clusters 페이지로 이동합니다.
Connect 클러스터 이름을 클릭합니다.
커넥터 만들기를 클릭합니다.
커넥터 이름에 문자열을 입력합니다. 예:
mm2-connector커넥터 플러그인 목록에서
MirrorMaker 2.0 Source를 선택합니다.소스 클러스터에서 Managed Service for Apache Kafka 클러스터를 선택합니다.
Kafka 클러스터 목록에서 소스 클러스터를 선택합니다.
쉼표로 구분된 주제 이름 또는 주제 정규식 상자에 복제하려는 Kafka 주제의 이름을 입력합니다.
만들기를 클릭합니다.
gcloud
gcloud managed-kafka clusters describe명령어를 실행하여 소스 Kafka 클러스터의 부트스트랩 주소를 가져옵니다.gcloud managed-kafka clusters describe SOURCE_KAFKA_CLUSTER \ --location=SOURCE_REGION \ --project=PROJECT_ID \ --format="value(bootstrapAddress)"다음을 바꿉니다.
SOURCE_KAFKA_CLUSTER: 소스 Kafka 클러스터의 이름SOURCE_REGION: 소스 클러스터의 리전PROJECT_ID: 프로젝트 ID입니다.
이전 명령어를 다시 실행하여 대상 Kafka 클러스터의 부트스트랩 주소를 가져옵니다.
gcloud managed-kafka clusters describe TARGET_KAFKA_CLUSTER \
  --location=TARGET_REGION \
  --project=PROJECT_ID \
  --format="value(bootstrapAddress)"
다음을 바꿉니다.
TARGET_KAFKA_CLUSTER: 대상 Kafka 클러스터의 이름TARGET_REGION: 대상 클러스터의 리전
MirrorMaker 2.0 소스 커넥터를 만들려면
gcloud managed-kafka connectors create명령어를 실행합니다.gcloud managed-kafka connectors create CONNECTOR_NAME \ --location=TARGET_REGION \ --connect-cluster=CONNECT_CLUSTER \ --configs=connector.class=org.apache.kafka.connect.mirror.MirrorSourceConnector,\ source.cluster.alias=source,\ source.cluster.bootstrap.servers=SOURCE_CLUSTER_BOOTSTRAP_ADDRESS,\ target.cluster.alias=target,\ target.cluster.bootstrap.servers=TARGET_CLUSTER_BOOTSTRAP_ADDRESS,\ tasks.max=3,\ topics=TOPIC_NAME다음을 바꿉니다.
CONNECTOR_NAME: 커넥터의 이름(예:mm2-connector)CONNECT_CLUSTER: Connect 클러스터의 이름SOURCE_CLUSTER_BOOTSTRAP_ADDRESS: 1단계의 소스 클러스터 부트스트랩 주소TARGET_CLUSTER_BOOTSTRAP_ADDRESS: 2단계의 타겟 클러스터 부트스트랩 주소TOPIC_NAME: 복제할 주제의 이름입니다. 이 매개변수는 쉼표로 구분된 주제 이름 목록이나 정규 표현식을 지정할 수도 있습니다.
MirrorMaker 2.0 소스 커넥터는 대상 클러스터에 "source.TOPIC_NAME"라는 새 주제를 만듭니다. 여기서 TOPIC_NAME은 소스 클러스터의 주제 이름입니다.
결과 보기
메시지가 복제되고 있는지 확인하려면 Kafka 명령줄 도구를 사용하면 됩니다. Kafka CLI 설정에 대한 자세한 내용은 CLI로 메시지 생성 및 사용 문서의 클라이언트 머신 설정을 참고하세요.
예를 들어 소스 클러스터에 메시지를 보내려면 명령줄에 다음을 입력합니다.
export BOOTSTRAP=$(gcloud managed-kafka clusters describe SOURCE_KAFKA_CLUSTER \
 --location=SOURCE_REGION \
 --project=PROJECT_ID \
 --format="value(bootstrapAddress)"
)

for msg in {1..10}; do
  echo "message $msg"
done | kafka-console-producer.sh --topic TOPIC_NAME \
       --bootstrap-server $BOOTSTRAP --producer.config client.properties
대상 클러스터에서 중복된 메시지를 읽으려면 명령줄에 다음을 입력합니다.
export BOOTSTRAP=$(gcloud managed-kafka clusters describe TARGET_KAFKA_CLUSTER \
 --location=TARGET_REGION \
 --project=PROJECT_ID \
 --format="value(bootstrapAddress)"
)

kafka-console-consumer.sh --topic source.TOPIC_NAME --from-beginning \
 --bootstrap-server $BOOTSTRAP --consumer.config client.properties
출력은 다음과 같이 표시됩니다.
message 1
message 2
message 3
message 4
[...]
삭제
이 튜토리얼에서 사용된 리소스 비용이 Google Cloud 계정에 청구되지 않도록 하려면 리소스가 포함된 프로젝트를 삭제하거나 프로젝트를 유지하고 개별 리소스를 삭제하세요.
콘솔
연결 클러스터를 삭제합니다.
Managed Service for Apache Kafka > Connect Clusters 페이지로 이동합니다.
'Connect' 클러스터를 선택하고 삭제를 클릭합니다.
소스 Kafka 클러스터를 삭제합니다.
Managed Service for Apache Kafka > 클러스터 페이지로 이동합니다.
Kafka 클러스터를 선택하고 삭제를 클릭합니다.
이전 단계를 반복하여 타겟 Kafka 클러스터를 삭제합니다.
gcloud
연결 클러스터를 삭제하려면
gcloud managed-kafka connect-clusters delete명령어를 사용합니다.gcloud managed-kafka connect-clusters delete CONNECT_CLUSTER \ --location=TARGET_REGION --async소스 Kafka 클러스터를 삭제하려면
gcloud managed-kafka clusters delete명령어를 사용합니다.gcloud managed-kafka clusters delete SOURCE_KAFKA_CLUSTER \ --location=SOURCE_REGION --async이전 단계를 반복하여 타겟 Kafka 클러스터를 삭제합니다.
gcloud managed-kafka clusters delete TARGET_KAFKA_CLUSTER \
  --location=TARGET_REGION --async
다음 단계
- MirrorMaker 2.0 커넥터 문제 해결하기
- MirrorMaker 2.0 커넥터에 대해 자세히 알아보세요.
- Kafka Connect에 대해 자세히 알아보세요.