


Visão geral
O Looker usa a lógica de reconhecimento agregado para encontrar a menor e mais eficiente tabela disponível no seu banco de dados para executar uma consulta, mantendo a acurácia.
Para tabelas muito grandes no seu banco de dados, os desenvolvedores do Looker podem criar tabelas de agregação menores de dados, agrupados por várias combinações de atributos. As tabelas de agregação atuam como resumos ou tabelas de resumo que o Looker pode usar em consultas sempre que possível, em vez da tabela grande original. Quando implementado de forma estratégica, o reconhecimento agregado pode acelerar a consulta média em ordens de magnitude.
Por exemplo, você pode ter uma tabela de dados de petabyte com uma linha para cada pedido feito no seu site. Com base nesse banco de dados, você pode criar uma tabela de agregação com os totais de vendas diárias. Se o site recebe 1.000 pedidos por dia, a tabela de agregação diária representa cada dia com 999 linhas a menos do que a tabela original. Você pode criar outra tabela de agregação com os totais de vendas mensais, que será ainda mais eficiente. Agora, se um usuário executar uma consulta de vendas diárias ou semanais, o Looker vai usar a tabela de total de vendas diárias. Se um usuário executar uma consulta sobre vendas anuais e você não tiver uma tabela de agregação anual, o Looker vai usar a melhor opção seguinte, que é a tabela de agregação de vendas mensais neste exemplo.
O Looker responde às perguntas dos usuários com as menores tabelas de agregação sempre que possível. Exemplo:
- Para uma consulta sobre o total de vendas mensais, o Looker usa a tabela de agregação com base nas vendas mensais (
sales_monthly_aggregate_table). - Para uma consulta sobre o total de cada venda em um dia, não há uma tabela de agregação com essa granularidade. Por isso, o Looker recebe os resultados da consulta da tabela de banco de dados original (
orders_database). No entanto, se os usuários executarem esse tipo de consulta com frequência, você poderá criar uma tabela de agregação para ela. - Para uma consulta sobre vendas semanais, não há uma tabela de agregação semanal. Por isso, o Looker usa a melhor opção seguinte, que é a tabela de agregação com base nas vendas diárias (
sales_daily_aggregate_table).
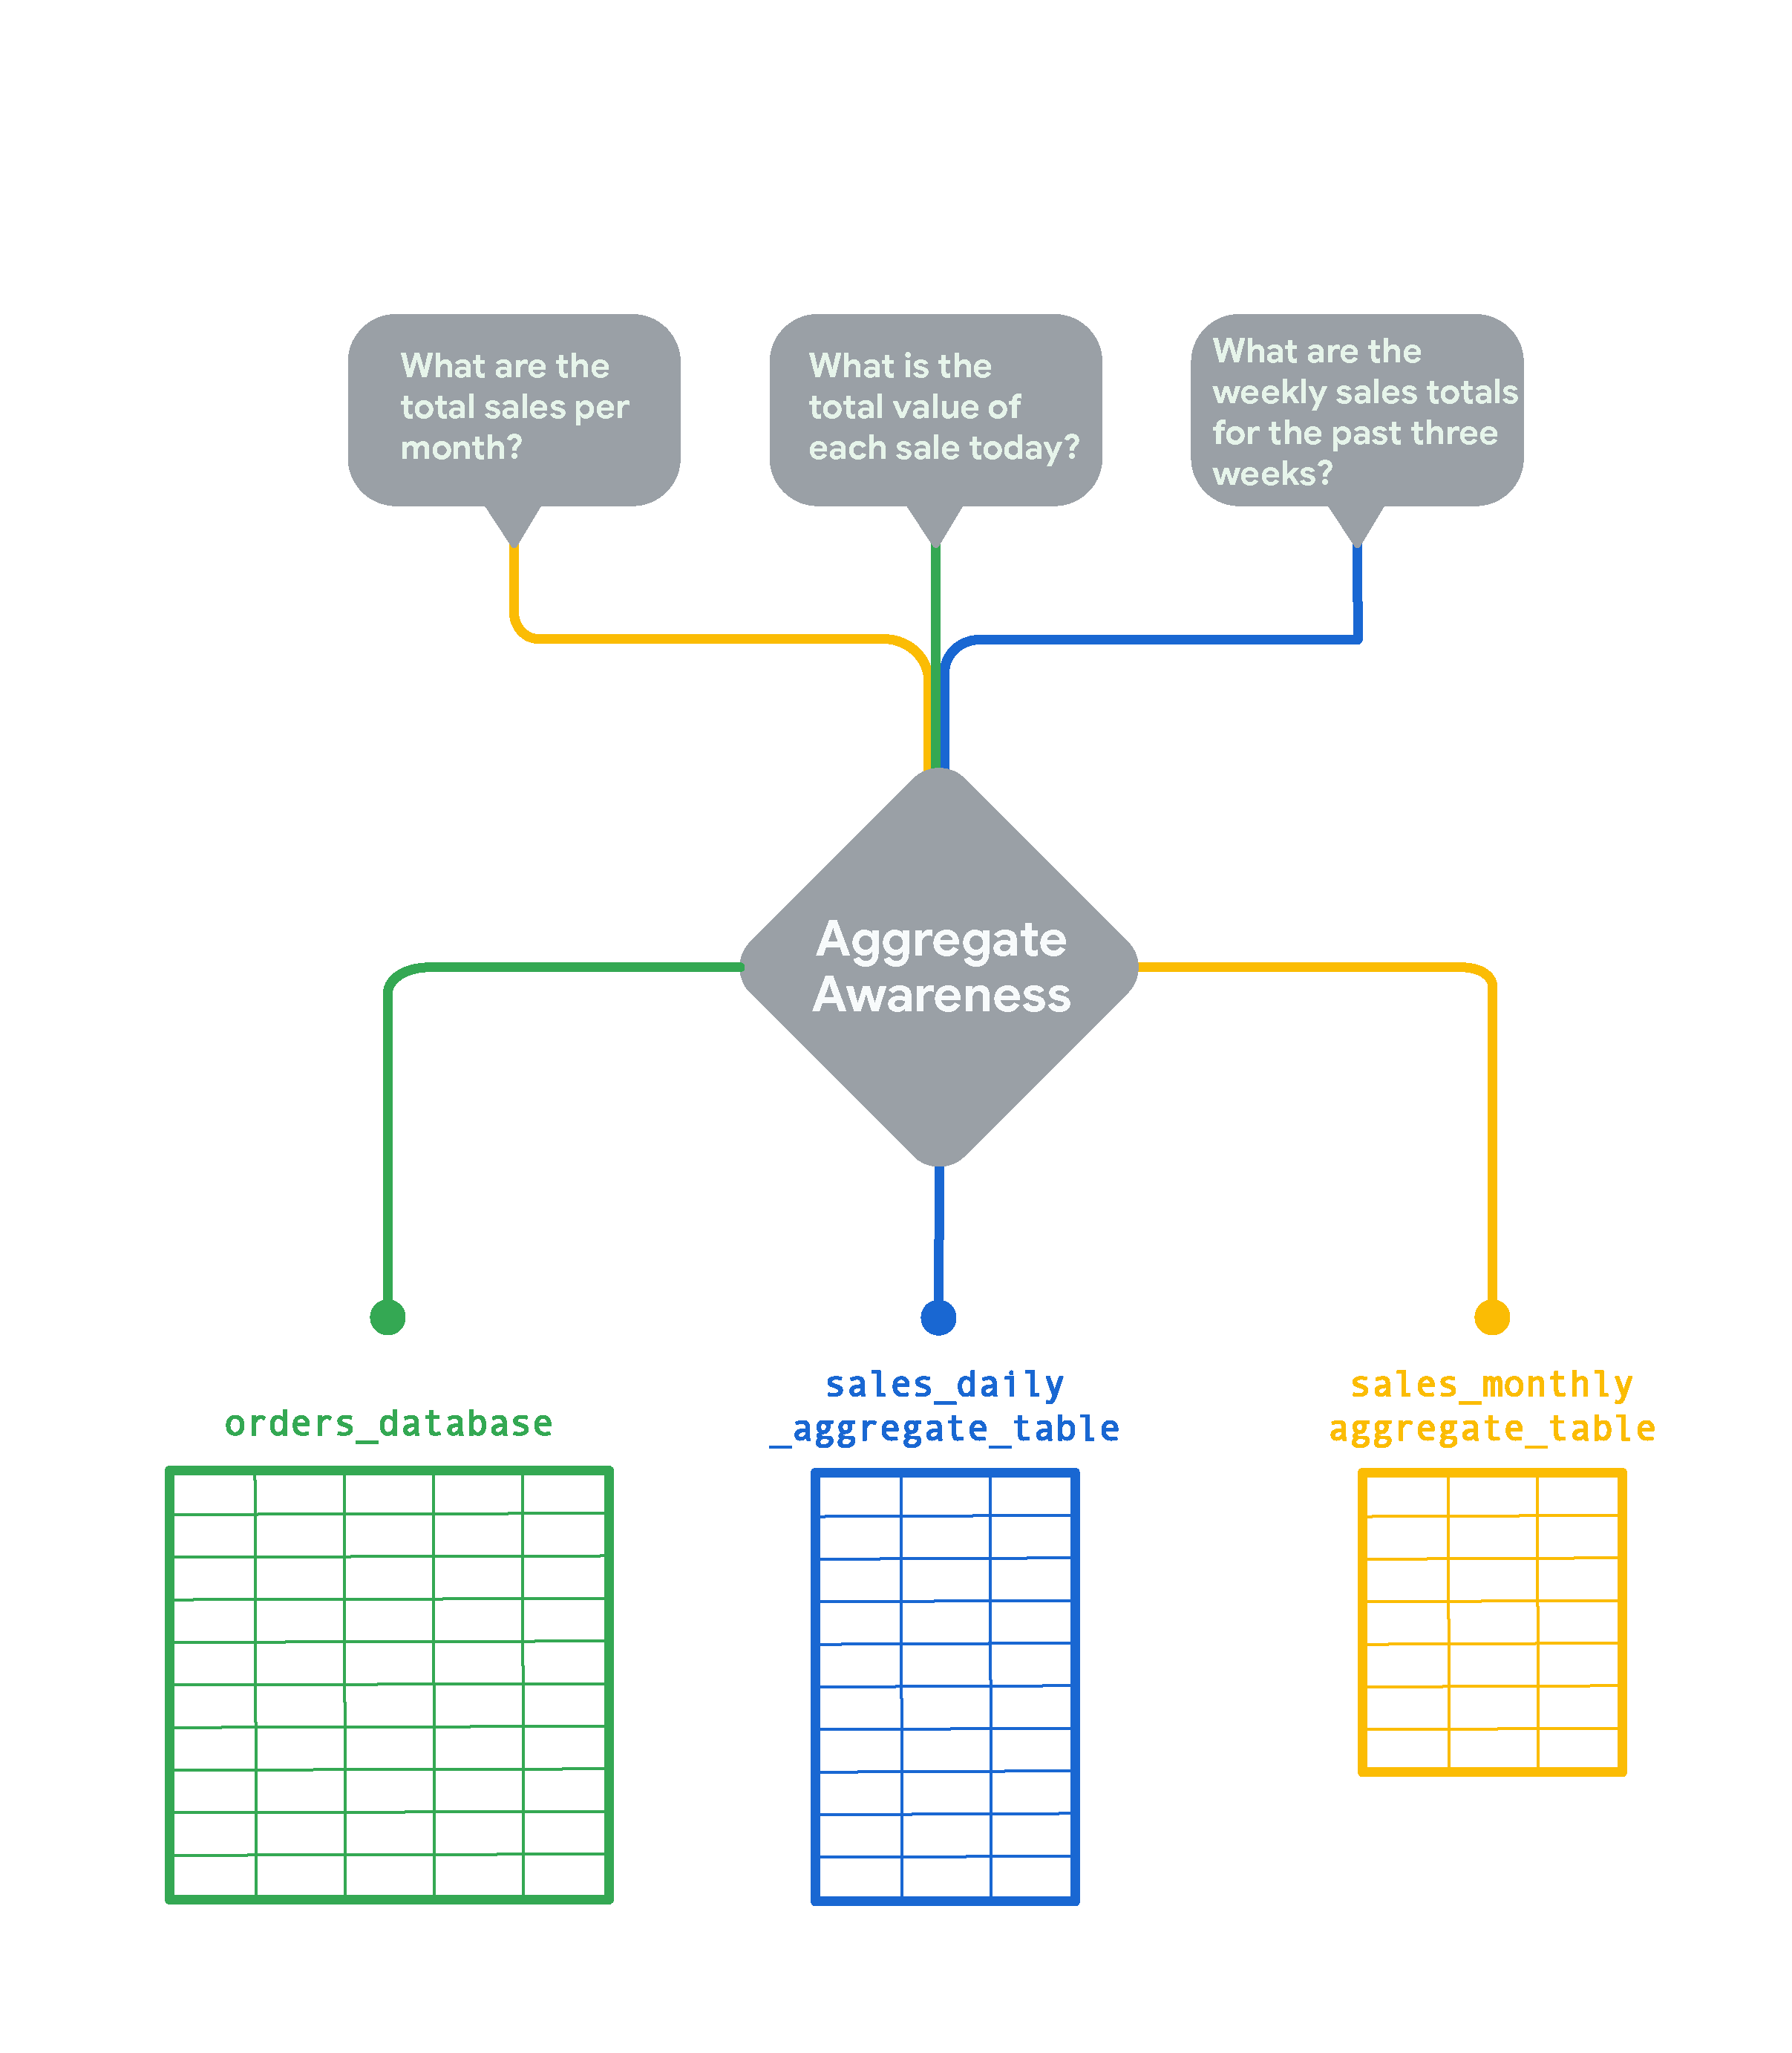
Usando a lógica de reconhecimento agregado, o Looker consulta a menor tabela de agregação possível para responder às perguntas dos usuários. A tabela original seria usada apenas para consultas que exigem uma granularidade mais refinada do que as tabelas de agregação podem fornecer.
As tabelas de agregação não precisam ser mescladas ou adicionadas a uma Análise separada. Em vez disso, o Looker ajusta dinamicamente a cláusula FROM da consulta da Análise para acessar a melhor tabela de agregação para a consulta. Isso significa que as análises detalhadas são mantidas e as análises podem ser consolidadas. Com o reconhecimento de agregação, uma análise detalhada pode usar automaticamente tabelas agregadas, mas ainda analisar dados granulares, se necessário.
Também é possível usar tabelas de agregação para melhorar drasticamente a performance dos painéis, principalmente para blocos que consultam conjuntos de dados enormes. Para mais detalhes, consulte a seção Como receber o LookML da tabela de agregação de um painel na página de documentação do parâmetro aggregate_table.
Como adicionar tabelas de agregação ao seu projeto
Os desenvolvedores do Looker podem criar tabelas agregadas estratégicas que minimizam o número de consultas necessárias nas tabelas grandes de um banco de dados. As tabelas de agregação precisam ser persistidas no banco de dados para que possam ser acessíveis para reconhecimento de agregação. Portanto, as tabelas agregadas são um tipo de tabela derivada persistente (TDP).
Uma tabela de agregação é definida usando o parâmetro aggregate_table em um parâmetro explore no seu projeto do LookML.
Veja um exemplo de explore com uma tabela de agregação no LookML:
explore: orders {
  label: "Sales Totals"
  join: order_items {
    sql_on: ${orders.id} = ${order_items.id} ;;
  }
  aggregate_table: sales_monthly {
    materialization: {
      datagroup_trigger: orders_datagroup
    }
    query: {
      dimensions: [created_month]
      measures: [order_items.total_sales]
    }
  }
  # other explore parameters
}
Para criar uma tabela de agregação, você pode escrever o LookML do zero ou acessar a tabela de agregação do LookML em uma Análise ou em um dashboard. Consulte a página de documentação do parâmetro aggregate_table para saber mais sobre o parâmetro aggregate_table e os subparâmetros dele.
Como projetar tabelas de agregação
Para que uma consulta de Análise use uma tabela de agregação, ela precisa fornecer dados precisos para a consulta. O Looker pode usar uma tabela de agregação para uma consulta de Análise se todas as seguintes condições forem verdadeiras:
- Os campos da consulta da Análise são um subconjunto dos campos da tabela de agregação (consulte a seção Fatores de campo nesta página). Ou, para períodos, os períodos da consulta de Análise podem ser derivados dos períodos na tabela de agregação (consulte a seção Fatores de período nesta página).
- A consulta de Análise contém tipos de métricas compatíveis com o reconhecimento de agregados (consulte a seção Fatores do tipo de métrica nesta página) ou tem uma tabela de agregação que é uma correspondência exata (consulte a seção Como criar tabelas de agregação que correspondem exatamente às consultas de Análise nesta página).
- O fuso horário da consulta da Análise Detalhada corresponde ao usado pela tabela de agregação (consulte a seção Fatores de fuso horário nesta página).
- Os filtros da consulta da Análise fazem referência a campos que estão disponíveis como dimensões na tabela de agregação, ou cada um dos filtros da consulta da Análise corresponde a um filtro na tabela de agregação (consulte a seção Fatores de filtro nesta página).
Uma maneira de garantir que uma tabela de agregação possa fornecer dados precisos para uma consulta de Análise é criar uma tabela de agregação que corresponda exatamente a uma consulta de Análise. Consulte a seção Como criar tabelas de agregação que correspondem exatamente às consultas da Análise detalhada nesta página para mais detalhes.
Fatores de campo
Para ser usada em uma consulta de Análise, uma tabela de agregação precisa ter todas as dimensões e medidas necessárias para essa consulta de Análise, incluindo os campos usados para filtros. Se uma consulta de Análise tiver uma dimensão ou métrica que não está em uma tabela de agregação, o Looker não poderá usar essa tabela e vai usar a tabela base.
Por exemplo, se uma consulta agrupa pelas dimensões A e B, agrega pela métrica C e filtra pela dimensão D, a tabela de agregação precisa ter, no mínimo, A, B e D como dimensões e C como métrica.
A tabela de agregação também pode ter outros campos, mas precisa ter pelo menos os campos de consulta da Análise para ser viável para otimização. A única exceção são as dimensões de período, já que períodos de granularidade mais grosseira podem ser derivados de granularidade mais refinada.
Devido a essas considerações de campo, uma tabela de agregação é específica da Análise em que é definida. Uma tabela de agregação definida em uma Análise não será usada para consultas em outra Análise.
Fatores de período
A lógica de reconhecimento de agregação do Looker pode derivar um período de outro. Uma tabela de agregação pode ser usada para uma consulta, desde que o período dela tenha uma granularidade mais fina (ou igual) à da consulta da Análise. Por exemplo, uma tabela de agregação com base em dados diários pode ser usada para uma consulta de Análise que exige outros períodos, como consultas de dados diários, mensais e anuais, ou até mesmo dados de dia do mês, dia do ano e semana do ano. Mas uma tabela de agregação anual não pode ser usada para uma consulta do recurso Detalhar que exige dados por hora, já que os dados da tabela de agregação não têm granularidade suficiente para a consulta.
O mesmo se aplica a subconjuntos de períodos. Por exemplo, se você tiver uma tabela de agregação filtrada para os últimos três meses e um usuário consultar os dados com um filtro para os últimos dois meses, o Looker poderá usar a tabela de agregação para essa consulta.
Além disso, a mesma lógica se aplica a consultas com filtros de período: uma tabela de agregação pode ser usada para uma consulta com um filtro de período, desde que o período da tabela de agregação tenha uma granularidade mais refinada (ou igual) ao filtro de período usado na consulta da Análise. Por exemplo, uma tabela de agregação com uma dimensão de período diário pode ser usada para uma consulta de Análise que filtra por dia, semana ou mês.
Fatores do tipo de medição
Para que uma consulta de Análise use uma tabela de agregação, as medições na tabela precisam fornecer dados precisos para a consulta.
Por esse motivo, apenas alguns tipos de medições são aceitos, conforme descrito nas seções a seguir:
- Medidas com tipos de medida compatíveis
- Métricas definidas por expressões SQL
- Medidas que não são definidas com
${TABLE} - Medidas que aproximam contagens distintas
Se uma consulta de Análise usar qualquer outro tipo de medida, o Looker vai usar a tabela original, não a tabela de agregação, para retornar os resultados. A única exceção é se a consulta da Análise for uma correspondência exata de uma consulta de tabela de agregação, conforme descrito na seção Como criar tabelas de agregação que correspondem exatamente às consultas da Análise.
Caso contrário, o Looker vai usar a tabela original, não a tabela de agregação, para retornar os resultados.
Medidas com tipos compatíveis
A Agregação de reconhecimento pode ser usada para consultas de Análise que usam medidas com estes tipos:
Para usar uma tabela de agregação em uma consulta de Análise, o Looker precisa ser capaz de operar nas medições da tabela de agregação para fornecer dados precisos na consulta de Análise. Por exemplo, uma métrica com type: sum pode ser usada para reconhecimento de agregação porque é possível somar várias somas: uma tabela de agregação de somas semanais pode ser adicionada para receber uma soma mensal precisa. Da mesma forma, uma medida com type: max pode ser usada porque uma tabela de agregação de máximos diários pode ser usada para encontrar o máximo semanal preciso.
No caso de medições com type: average, o reconhecimento de agregação é compatível porque o Looker usa dados de soma e contagem para derivar com precisão os valores médios das tabelas de agregação.
Métricas definidas com expressões SQL
A percepção de agregação também pode ser usada com medidas definidas com expressões no parâmetro sql. Quando definidos com expressões SQL, os seguintes tipos de medição também são aceitos:
O reconhecimento de agregados é compatível com medidas definidas como combinações de outras medidas, como neste exemplo:
measure: total_revenue_in_dollars {
  type: number
  sql: ${total_revenue_in_dollars} - ${inventory_item.total_cost_in_dollars} ;;
}
O reconhecimento de agregação também é compatível com medidas em que os cálculos são definidos no parâmetro sql, como esta medida:
measure: wholesale_value {
  type: number
    sql: (${order_items.total_sale_price} * 0.60) ;;
}
O reconhecimento de agregação é compatível com medidas em que as operações MIN, MAX e COUNT são definidas no parâmetro sql, como esta medida:
measure: most_recent_order_date {
  type: date
  sql: MAX(${users.created_at_raw})
}
Medidas que se referem a campos do LookML
Quando as expressões sql são usadas em métricas, o reconhecimento de agregados é compatível com os seguintes tipos de referências de campo:
- Referências que usam o formato
${view_name.field_name}, que indica campos em outras visualizações - Referências que usam o formato
${field_name}, que indica campos na mesma visualização
A agregação não é compatível com medidas definidas usando o formato ${TABLE}.column_name, que indica uma coluna em uma tabela. Consulte a página de documentação Como incorporar SQL e fazer referência a objetos do LookML para uma visão geral do uso de referências no LookML.
Por exemplo, uma métrica definida com esse parâmetro sql não seria compatível com uma tabela de agregação, já que usa o formato ${TABLE}.column_name:
measure: wholesale_value {
  type: number
  sql: (${TABLE}.total_sale_price * 0.60) ;;
}
Se você quiser incluir essa medida em uma tabela de agregação, crie uma dimensão definida com o formato ${TABLE}.column_name e, em seguida, crie uma medida que faça referência à dimensão, como esta:
 dimension: total_sale_price {
    sql: (${TABLE}.total_sale_price) ;;
  }

  measure: wholesale_value {
    type: number
    sql: (${total_sale_price} * 0.60) ;;
}
Agora você pode usar a medida wholesale_value na sua tabela de agregação.
Medidas que aproximam contagens distintas
Em geral, as contagens distintas não são compatíveis com o reconhecimento de agregação porque não é possível receber dados precisos se você tentar agregar contagens distintas. Por exemplo, se você estiver contando os usuários distintos em um site, pode haver um usuário que acessou o site duas vezes, com três semanas de intervalo. Se você tentasse aplicar uma tabela de agregação semanal para receber uma contagem mensal de usuários distintos no seu site, esse usuário seria contado duas vezes na consulta mensal de contagem distinta, e os dados estariam incorretos.
Uma solução alternativa é criar uma tabela de agregação que corresponda exatamente a uma consulta de Análise, conforme descrito na seção Como criar tabelas de agregação que correspondem exatamente às consultas de Análise nesta página. Quando a consulta da Análise e a consulta da tabela de agregação são iguais, as medidas de contagem distinta fornecem dados precisos, então podem ser usadas para reconhecimento de agregação.
Outra opção é usar aproximações para contagens distintas. Para dialetos que aceitam esboços do HyperLogLog, o Looker pode usar o algoritmo HyperLogLog para aproximar contagens distintas de tabelas de agregação.
O algoritmo HyperLogLog tem um erro de cerca de 2%. O parâmetro allow_approximate_optimization: yes exige que os desenvolvedores do Looker confirmem que é possível usar dados aproximados para a métrica. Assim, ela pode ser calculada aproximadamente com base em tabelas agregadas.
Consulte a página de documentação do parâmetro allow_approximate_optimization para mais informações e a lista de dialetos que oferecem suporte à contagem de valores distintos usando HyperLogLog.
Fatores de fuso horário
Em muitos casos, os administradores de banco de dados usam o UTC como fuso horário para bancos de dados. No entanto, muitos usuários podem não estar no fuso horário UTC. O Looker tem várias opções para converter fusos horários para que os usuários recebam resultados de consultas no próprio fuso horário:
- Fuso horário da consulta, uma configuração que se aplica a todas as consultas na conexão do banco de dados. Se todos os usuários estiverem no mesmo fuso horário, você poderá definir um único fuso horário de consulta para que todas as consultas sejam convertidas do fuso horário do banco de dados para o fuso horário da consulta.
- Fusos horários específicos do usuário, em que os usuários podem ser atribuídos e selecionar fusos horários individualmente. Nesse caso, as consultas são convertidas do fuso horário do banco de dados para o fuso horário do usuário individual.
Consulte a página de documentação Como usar as configurações de fuso horário para mais informações sobre essas opções.
Esses conceitos são importantes para entender o reconhecimento de agregação porque, para que uma tabela de agregação seja usada em uma consulta com dimensões ou filtros de data, o fuso horário na tabela de agregação precisa corresponder à configuração de fuso horário usada na consulta original.
As tabelas de agregação usam o fuso horário do banco de dados se nenhum valor timezone for especificado. Sua conexão de banco de dados também usará o fuso horário do banco de dados se alguma das seguintes condições for verdadeira:
- Seu banco de dados não é compatível com fusos horários.
- O fuso horário de consulta da conexão do banco de dados está definido como o mesmo fuso horário do banco de dados.
- Sua conexão de banco de dados não tem um fuso horário de consulta especificado nem fusos horários específicos do usuário. Se esse for o caso, a conexão do banco de dados vai usar o fuso horário do banco de dados.
Se alguma dessas condições for verdadeira, você poderá omitir o parâmetro timezone das tabelas agregadas.
Caso contrário, o fuso horário da tabela de agregação deve ser definido para corresponder às possíveis consultas, de modo que a tabela de agregação tenha mais chances de ser usada:
- Se a conexão do banco de dados usar um único fuso horário de consulta, o valor
timezoneda tabela de agregação precisará corresponder ao valor do fuso horário de consulta. - Se a conexão do banco de dados usar fusos horários específicos do usuário, crie tabelas agregadas idênticas, cada uma com um valor
timezonediferente para corresponder aos possíveis fusos horários dos usuários.
Filtrar fatores
Tenha cuidado ao incluir filtros na tabela de agregação. Os filtros em uma tabela de agregação podem restringir os resultados ao ponto em que ela se torna inutilizável. Por exemplo, digamos que você crie uma tabela de agregação para contagens diárias de pedidos, e ela filtre apenas os pedidos de óculos de sol vindos da Austrália. Se um usuário executar uma consulta de Análise para contagens diárias de pedidos de óculos de sol no mundo todo, o Looker não poderá usar a tabela de agregação para essa consulta, já que ela só tem os dados da Austrália. A tabela de agregação filtra os dados de forma muito restrita para ser usada pela consulta da Análise.
Além disso, preste atenção aos filtros que os desenvolvedores do Looker podem ter criado na Análise, como:
access_filters: aplica restrições de dados específicas do usuário.always_filter: exige que os usuários incluam um determinado conjunto de filtros para uma consulta de Análise. Os usuários podem mudar o valor padrão do filtro para a consulta, mas não podem remover o filtro por completo.conditionally_filter: define um conjunto de filtros padrão que os usuários podem substituir se aplicarem pelo menos um filtro de uma segunda lista que também está definida na Análise.
Esses tipos de filtro são baseados em campos específicos. Se a Análise tiver esses filtros, inclua os campos deles no parâmetro dimensions de aggregate_table.
Por exemplo, veja uma Análise com um filtro de acesso baseado no campo orders.region:
explore: orders {
  access_filter: {
    field: orders.region
    user_attribute: region
  }
}
Para criar uma tabela de agregação que seria usada para essa Análise, ela precisa incluir o campo em que o filtro de acesso se baseia. No próximo exemplo, o filtro de acesso é baseado no campo orders.region, e esse mesmo campo é incluído como uma dimensão na tabela de agregação:
explore: orders {
  access_filter: {
    field: orders.region  # <-- orders.region field
    user_attribute: region
  }
  aggregate_table: sales_monthly {
    materialization: {
      datagroup_trigger: orders_datagroup
    }
    query: {
      dimensions: [orders.created_day, orders.region] # <-- orders.region field
      measures: [orders.total_sales]
      timezone: America/Los_Angeles
    }
  }
}
Como a consulta da tabela de agregação inclui a dimensão orders.region, o Looker pode filtrar dinamicamente os dados na tabela de agregação para corresponder ao filtro da consulta da Análise. Portanto, o Looker ainda pode usar a tabela de agregação para as consultas da Análise, mesmo que ela tenha um filtro de acesso.
Isso também se aplica às consultas de Análise que usam uma tabela derivada nativa configurada com bind_filters. O parâmetro bind_filters transmite filtros especificados de uma consulta de Análise para a subconsulta da tabela derivada nativa. No caso do reconhecimento de agregação, se a consulta do Explore exigir uma tabela derivada nativa que use bind_filters, a consulta do Explore só poderá usar uma tabela de agregação se todos os campos usados no parâmetro bind_filters da tabela derivada nativa tiverem exatamente os mesmos valores de filtro na consulta do Explore e na tabela de agregação.
Criar tabelas de agregação que correspondam exatamente às consultas de Análise
Uma maneira de garantir que uma tabela de agregação possa ser usada para uma consulta de Análise é criar uma tabela de agregação que corresponda exatamente à consulta de Análise. Se a consulta da Análise e a tabela de agregação usarem as mesmas métricas, dimensões, filtros, fusos horários e outros parâmetros, os resultados da tabela de agregação serão aplicados à consulta da Análise. Se uma tabela de agregação for uma correspondência exata de uma consulta da Análise, o Looker poderá usar tabelas de agregação que incluam qualquer tipo de métrica.
Você pode criar uma tabela de agregação em uma Análise usando a opção Receber LookML no menu de engrenagem de uma Análise. Também é possível criar correspondências exatas para todos os blocos em um painel usando a opção Get LookML no menu de engrenagem de um painel.
Como determinar qual tabela de agregação é usada para uma consulta
Os usuários com permissões see_sql podem usar os comentários na guia SQL de uma Análise para ver qual tabela de agregação será usada em uma consulta. Os comentários da guia SQL também são mostrados no Modo de Desenvolvimento. Assim, os desenvolvedores podem testar novas tabelas de agregação para ver como o Looker as usa antes de enviar as novas tabelas para produção.
Por exemplo, com base na tabela de agregação mensal de exemplo mostrada anteriormente, você pode acessar a Análise e executar uma consulta para totais de vendas anuais. Em seguida, clique na guia SQL para conferir os detalhes da consulta criada pelo Looker. Se você estiver no Modo de Desenvolvimento, o Looker vai mostrar comentários para indicar a tabela de agregação usada na consulta.
Nos comentários a seguir na guia SQL, podemos ver que o Looker está usando a tabela de agregação sales_monthly para essa consulta, além de informações sobre por que outras tabelas de agregação não foram usadas para a consulta:
-- use existing orders::sales_monthly in sandbox_scratch.LR$LB4151619827209021_orders$sales_monthly
-- Did not use orders::sales_weekly; it does not include the following fields in the query: orders.created_month
-- Did not use orders::sales_daily; orders::sales_monthly was a better fit for optimization.
-- Did not use orders::sales_last_3_days; contained filters not in the query: orders.created_date
Consulte a seção Solução de problemas nesta página para ver possíveis comentários na guia SQL e sugestões de como resolvê-los.
Estimativas de economia de computação para reconhecimento agregado
Se a conexão do banco de dados oferecer suporte a estimativas de custo e se uma tabela de agregação puder ser usada em uma consulta, a janela "Análise" vai mostrar a economia de computação ao usar a tabela de agregação em vez de consultar o banco de dados diretamente. A economia do reconhecimento de agregação é mostrada ao lado do botão Executar em uma Análise antes da execução da consulta.
Antes de executar a consulta, se quiser saber qual tabela de agregação será usada para a consulta, clique na guia SQL, conforme descrito na seção Determinar qual tabela de agregação é usada para uma consulta desta página de documentação.
Depois que a consulta for executada, a janela "Análise" vai mostrar qual tabela de agregação foi usada para responder à consulta ao lado do botão Executar.
A economia agregada de reconhecimento é mostrada para conexões de banco de dados que estão ativadas para estimativas de custo. Consulte a página de documentação Analisar dados no Looker para mais informações.
O Looker une novos dados às suas tabelas de agregação
Para tabelas de agregação com filtros de tempo, o Looker pode unir dados atualizados à sua tabela de agregação. Você pode ter uma tabela de agregação que inclui dados dos últimos três dias, mas que foi criada ontem. A tabela de agregação não teria as informações de hoje, então não seria possível usá-la para uma consulta do recurso Análise sobre as informações diárias mais recentes.
No entanto, o Looker ainda pode usar os dados dessa tabela de agregação para a consulta, porque ele vai executar uma consulta nos dados mais recentes e unir esses resultados aos resultados na tabela de agregação.
O Looker pode unir dados novos com os dados da tabela de agregação nas seguintes circunstâncias:
- A tabela de agregação tem um filtro de tempo.
- A tabela de agregação inclui uma dimensão com base no mesmo campo de tempo do filtro de tempo.
Por exemplo, a tabela de agregação a seguir tem uma dimensão baseada no campo orders.created_date e um filtro de período ("3 days") baseado no mesmo campo:
aggregate_table: sales_last_3_days {
  query:  {
    dimensions: [orders.created_date]
    measures: [order_items.total_sales]
    filters: [orders.created_date: "3 days"]  # <-- time filter
    timezone: America/Los_Angeles
  }
  ...
}
Se essa tabela de agregação foi criada ontem, o Looker vai recuperar os dados mais recentes que ainda não estão incluídos nela e, em seguida, vai unir os resultados novos aos resultados da tabela de agregação. Isso significa que os usuários vão receber os dados mais recentes e, ao mesmo tempo, otimizar a performance usando o reconhecimento agregado.
Se você estiver no Modo de Desenvolvimento, clique na guia SQL de uma Análise para conferir a tabela de agregação usada pelo Looker na consulta e a instrução UNION usada para trazer dados mais recentes que não estavam incluídos na tabela de agregação.
As tabelas de agregação precisam ser persistidas
Para ser acessível ao reconhecimento agregado, a tabela de agregação precisa ser persistida no banco de dados. A estratégia de persistência é especificada no parâmetro materialization da tabela agregada. Como as tabelas agregadas são um tipo de tabela derivada persistente (TDP), elas têm os mesmos requisitos das TDPs. Para mais detalhes, consulte a página de documentação Tabelas derivadas no Looker.
É possível criar PDTs incrementais no seu projeto se o dialeto for compatível com elas. O Looker cria TDPs incrementais anexando dados novos à tabela, em vez de recriá-la por completo. Como as tabelas de agregação são um tipo de TDP, também é possível criar tabelas de agregação incrementais. Consulte a página de documentação sobre TDPs incrementais para mais informações. Consulte a página de documentação do parâmetro increment_key para ver um exemplo de tabela de agregação incremental.
Um usuário com a permissão develop pode substituir as configurações de persistência e recriar todas as tabelas de agregação de uma consulta para receber os dados mais atualizados. Para recriar as tabelas de uma consulta, selecione a opção Recriar tabelas derivadas e executar no menu de engrenagem Abrir ações.
É preciso esperar que a consulta de Análise seja carregada para que essa opção fique disponível.
A opção Recriar tabelas derivadas e executar recria todas as tabelas derivadas que são referenciadas na consulta, bem como todas as tabelas derivadas que dependem das tabelas na consulta. Isso inclui as tabelas de agregação, que são um tipo de tabela derivada persistente.
Para o usuário que inicia a opção Recriar tabelas derivadas e executar, a consulta vai aguardar a recriação das tabelas antes de carregar os resultados. As consultas de outros usuários ainda vão usar as tabelas atuais. Depois que as tabelas persistentes forem recriadas, todos os usuários vão usar as tabelas recriadas.
Consulte a página de documentação Tabelas derivadas no Looker para mais detalhes sobre a opção Recriar tabelas derivadas e executar.
Solução de problemas
Conforme descrito na seção Determinar qual tabela de agregação é usada para uma consulta, se você estiver no Modo de Desenvolvimento, poderá executar consultas na Análise e clicar na guia SQL para ver comentários sobre a tabela de agregação usada na consulta, se houver.
A guia SQL também inclui comentários sobre por que as tabelas de agregação não foram usadas em uma consulta, se for o caso. Para tabelas de agregação que não são usadas, o comentário começa com:
Did not use [explore name]::[aggregate table name];
Por exemplo, confira um comentário sobre por que a tabela de agregação sales_daily definida na Análise order_items não foi usada em uma consulta:
-- Did not use order_items::sales_daily; query contained the following filters
that were neither included as fields nor exactly matched by filters in the aggregate table:
order_items.created_year.
Nesse caso, os filtros na consulta impediram o uso da tabela agregada.
A tabela a seguir mostra outros motivos possíveis para uma tabela de agregação não ser usada, além de etapas que você pode seguir para aumentar a usabilidade dela.
| Motivo para não usar a tabela de agregação | Explicação e possíveis etapas |
|---|---|
| Não há esse campo na Análise. | Há um erro de tipo de validação do LookML. Isso provavelmente ocorre porque a tabela de agregação não foi definida corretamente ou há um erro de digitação no LookML dela. Um provável culpado é um nome de campo incorreto ou algo parecido.Para resolver isso, verifique se as dimensões e as medições na tabela de agregação correspondem aos nomes dos campos na Análise. Consulte a página de documentação do parâmetro aggregate_table para mais informações sobre como definir uma tabela de agregação. |
| A tabela de agregação não inclui os seguintes campos na consulta. | Para ser usada em uma consulta de Análise, uma tabela de agregação precisa ter todas as dimensões e medidas necessárias para essa consulta de Análise, incluindo os campos usados para filtros. Se uma consulta de Análise tiver uma dimensão ou métrica que não está em uma tabela de agregação, o Looker não poderá usar essa tabela e vai usar a tabela base. Consulte a seção Fatores de campo nesta página para mais detalhes. A única exceção são as dimensões de período, já que períodos de granularidade mais ampla podem ser derivados de períodos de granularidade mais refinada. Para resolver isso, verifique se os campos da consulta da Análise estão incluídos na definição da tabela de agregação. |
| A consulta continha os seguintes filtros que não foram incluídos como campos nem correspondiam exatamente aos filtros na tabela de agregação. | Os filtros na consulta da Análise impedem que o Looker use a tabela de agregação. Para resolver isso, faça o seguinte:
|
| A consulta contém as seguintes medições que não podem ser agrupadas. | A consulta contém um ou mais tipos de medição que não são compatíveis com o reconhecimento de agregados, como contagem distinta, mediana ou percentil.Para resolver isso, verifique o tipo de cada métrica na consulta e confira se ele é um dos tipos de métrica aceitos. Além disso, se a Análise tiver mesclagens, verifique se as medições não foram convertidas em medições distintas (conjuntos simétricos) por meio de mesclagens em leque. Consulte a seção Conjuntos simétricos para Análises com junções [de dados] nesta página para uma explicação. |
| Uma tabela de agregação diferente era mais adequada para otimização. | Havia várias tabelas de agregação viáveis para a consulta, e o Looker encontrou uma tabela de agregação mais adequada para usar. Nesse caso, não é preciso fazer nada. |
O Looker não fez nenhum agrupamento (devido a um parâmetro primary_key ou cancel_grouping_fields) e, portanto, a consulta não pode ser resumida. |
A consulta faz referência a uma dimensão que impede que ela tenha uma cláusula GROUP BY. Portanto, o Looker não pode usar nenhuma tabela de agregação para a consulta.
Para resolver isso, verifique se o parâmetro primary_key da visualização e o parâmetro cancel_grouping_fields da análise detalhada estão configurados corretamente. |
| A tabela de agregação continha filtros que não estavam na consulta. | A tabela de agregação tem um filtro que não é de tempo e não está na consulta.Para resolver isso, remova o filtro da tabela de agregação. Consulte a seção Filtrar fatores nesta página para mais detalhes. |
Um campo é definido como somente para filtro na consulta da Análise, mas está listado no parâmetro dimensions da tabela de agregação. |
O parâmetro dimensions da tabela de agregação lista um campo que é definido apenas como um campo filter na consulta da Análise.Para resolver isso, remova o campo da lista dimensions da tabela agregada. Se esse campo for necessário para a tabela de agregação, adicione-o à lista filters na consulta da tabela. |
| O otimizador não consegue determinar por que a tabela de agregação não foi usada. | Este comentário é reservado para casos extremos. Se você encontrar essa mensagem em uma consulta de Análise usada com frequência, crie uma tabela de agregação que corresponda exatamente à consulta. É possível acessar o LookML da tabela de agregação em uma Análise, conforme descrito na página de parâmetros aggregate_table. |
Informações importantes
Conjuntos simétricos para Análises com mesclagens
É importante observar que, em uma Análise que combina várias tabelas de banco de dados, o Looker pode renderizar medições do tipo SUM, COUNT e AVERAGE como SUM DISTINCT, COUNT DISTINCT e AVERAGE DISTINCT, respectivamente. O Looker faz isso para evitar erros de cálculo de fanout. Por exemplo, uma medida count é renderizada como um tipo de medida count_distinct. Isso evita erros de cálculo de divergência para mesclagens e faz parte da funcionalidade de conjuntos simétricos do Looker. Consulte a página de práticas recomendadas sobre conjuntos simétricos para uma explicação desse recurso do Looker.
A funcionalidade de conjuntos simétricos evita erros de cálculo, mas também pode impedir que suas tabelas de agregação sejam usadas em determinados casos. Por isso, é importante entender.
Para os tipos de medição compatíveis com o reconhecimento de agregados, isso se aplica a sum, count e average. O Looker vai renderizar esses tipos de medidas como DISTINCT se:
- A medida é da visualização "um" de uma mesclagem muitos para um ou um para muitos.
- A medição é de uma das visualizações de uma mesclagem muitos para muitos.
Consulte a página de documentação do parâmetro relationship para uma explicação sobre esses tipos de mesclagens.
Se você descobrir que a tabela de agregação não está sendo usada por esse motivo, crie uma tabela de agregação que corresponda exatamente a uma consulta da Análise para usar esses tipos de métricas em uma Análise com junções. Consulte a seção Como criar tabelas de agregação que correspondem exatamente às consultas da Análise detalhada nesta página para mais informações.
Além disso, se você tiver um dialeto SQL que ofereça suporte a esboços HyperLogLog, adicione o parâmetro allow_approximate_optimization: yes à métrica. Quando uma medida de contagem é definida com allow_approximate_optimization: yes, o Looker pode usá-la para reconhecimento agregado, mesmo que ela seja renderizada como uma contagem distinta.
Consulte a página de documentação do parâmetro allow_approximate_optimization para mais detalhes e uma lista de quais dialetos SQL são compatíveis com os esboços do HyperLogLog.
Suporte a dialetos para reconhecimento agregado
A capacidade de usar o reconhecimento de agregação depende do dialeto do banco de dados que sua conexão do Looker está usando. Na versão mais recente do Looker, os seguintes dialetos são compatíveis com o reconhecimento de agregados:
| Dialeto | Compatível? |
|---|---|
| Actian Avalanche | |
| Amazon Athena | |
| Amazon Aurora MySQL | |
| Amazon Redshift | |
| Amazon Redshift 2.1+ | |
| Amazon Redshift Serverless 2.1+ | |
| Apache Druid | |
| Apache Druid 0.13.x - 0.17.x | |
| Apache Druid 0.18+ | |
| Apache Hive 2.3+ | |
| Apache Hive 3.1.2+ | |
| Apache Spark 3+ | |
| ClickHouse | |
| ClickHouse 26+ | |
| Cloudera Impala 3.1+ | |
| Cloudera Impala 3.1+ with Native Driver | |
| Cloudera Impala with Native Driver | |
| DataVirtuality | |
| Databricks | |
| Denodo 7 | |
| Denodo 8 & 9 | |
| Dremio | |
| Dremio 11+ | |
| Dremio 26+ with Arrow Flight SQL | |
| Exasol | |
| Google BigQuery Legacy SQL | |
| Google BigQuery Standard SQL | |
| Google Cloud AlloyDB for PostgreSQL | |
| Google Cloud PostgreSQL | |
| Google Cloud SQL | |
| Google Spanner | |
| Greenplum | |
| HyperSQL | |
| IBM Netezza | |
| MariaDB | |
| Microsoft Azure PostgreSQL | |
| Microsoft Azure SQL Database | |
| Microsoft Azure Synapse Analytics | |
| Microsoft SQL Server 2008+ | |
| Microsoft SQL Server 2012+ | |
| Microsoft SQL Server 2016 | |
| Microsoft SQL Server 2017+ | |
| MongoBI | |
| MongoSQL | |
| MySQL | |
| MySQL 8.0.12+ | |
| Oracle | |
| Oracle ADWC | |
| PostgreSQL 9.5+ | |
| PostgreSQL pre-9.5 | |
| PrestoDB | |
| PrestoSQL | |
| SAP HANA | |
| SAP HANA 2+ | |
| SingleStore | |
| SingleStore 7+ | |
| Snowflake | |
| Teradata | |
| Trino | |
| Vector | |
| Vertica |
Suporte de dialeto para criar tabelas de agregação de forma incremental
Para que o Looker seja compatível com tabelas de agregação incrementais no seu projeto do Looker, o dialeto do banco de dados também precisa ser compatível com elas. A tabela a seguir mostra quais dialetos são compatíveis com a criação incremental de PDTs na versão mais recente do Looker:
| Dialeto | Compatível? |
|---|---|
| Actian Avalanche | |
| Amazon Athena | |
| Amazon Aurora MySQL | |
| Amazon Redshift | |
| Amazon Redshift 2.1+ | |
| Amazon Redshift Serverless 2.1+ | |
| Apache Druid | |
| Apache Druid 0.13.x - 0.17.x | |
| Apache Druid 0.18+ | |
| Apache Hive 2.3+ | |
| Apache Hive 3.1.2+ | |
| Apache Spark 3+ | |
| ClickHouse | |
| ClickHouse 26+ | |
| Cloudera Impala 3.1+ | |
| Cloudera Impala 3.1+ with Native Driver | |
| Cloudera Impala with Native Driver | |
| DataVirtuality | |
| Databricks | |
| Denodo 7 | |
| Denodo 8 & 9 | |
| Dremio | |
| Dremio 11+ | |
| Dremio 26+ with Arrow Flight SQL | |
| Exasol | |
| Google BigQuery Legacy SQL | |
| Google BigQuery Standard SQL | |
| Google Cloud AlloyDB for PostgreSQL | |
| Google Cloud PostgreSQL | |
| Google Cloud SQL | |
| Google Spanner | |
| Greenplum | |
| HyperSQL | |
| IBM Netezza | |
| MariaDB | |
| Microsoft Azure PostgreSQL | |
| Microsoft Azure SQL Database | |
| Microsoft Azure Synapse Analytics | |
| Microsoft SQL Server 2008+ | |
| Microsoft SQL Server 2012+ | |
| Microsoft SQL Server 2016 | |
| Microsoft SQL Server 2017+ | |
| MongoBI | |
| MongoSQL | |
| MySQL | |
| MySQL 8.0.12+ | |
| Oracle | |
| Oracle ADWC | |
| PostgreSQL 9.5+ | |
| PostgreSQL pre-9.5 | |
| PrestoDB | |
| PrestoSQL | |
| SAP HANA | |
| SAP HANA 2+ | |
| SingleStore | |
| SingleStore 7+ | |
| Snowflake | |
| Teradata | |
| Trino | |
| Vector | |
| Vertica |