


סקירה כללית
Looker משתמש בלוגיקה של מודעוּת לצבירה כדי למצוא את הטבלה הקטנה והיעילה ביותר שזמינה במסד הנתונים שלכם להרצת שאילתה, תוך שמירה על הדיוק.
אם יש לכם טבלאות גדולות מאוד במסד הנתונים, מפתחי Looker יכולים ליצור טבלאות מסכמות קטנות יותר של נתונים, שמקובצות לפי שילובים שונים של מאפיינים. הטבלאות המסכמות משמשות כטבלאות סיכום ש-Looker יכול להשתמש בהן לשאילתות כשאפשר, במקום בטבלה המקורית הגדולה. כשמיישמים את התכונה הזו באופן אסטרטגי, היא יכולה להאיץ את השאילתה הממוצעת בסדרי גודל.
לדוגמה, יכול להיות שיש לכם טבלת נתונים בגודל פטה-בייט עם שורה אחת לכל הזמנה שבוצעה באתר שלכם. מתוך מסד הנתונים הזה, אפשר ליצור טבלה מסכמת עם סכומי המכירות היומיים. אם באתר שלכם מתקבלות 1,000 הזמנות מדי יום, הטבלה היומית המצטברת תייצג כל יום עם 999 שורות פחות מהטבלה המקורית. אתם יכולים ליצור טבלת צבירה נוספת עם סכומי מכירות חודשיים שתהיה יעילה עוד יותר. עכשיו, אם משתמש יריץ שאילתה על מכירות יומיות או שבועיות, Looker ישתמש בטבלת סך המכירות היומיות. אם משתמש מריץ שאילתה לגבי מכירות שנתיות ואין לכם טבלת סיכום שנתית, Looker ישתמש בטבלה הכי מתאימה, שהיא במקרה הזה טבלת סיכום של מכירות חודשיות.
Looker עונה על השאלות של המשתמשים באמצעות טבלאות מסכמות קטנות ככל האפשר. לדוגמה:
- בשאילתה לגבי סך המכירות החודשיות, Looker משתמש בטבלת הצבירה שמבוססת על מכירות חודשיות (
sales_monthly_aggregate_table). - בשאילתה לגבי הסכום הכולל של כל מכירה ביום מסוים, אין טבלה נצברת עם רמת הפירוט הזו, ולכן Looker מקבל את תוצאות השאילתה מטבלת מסד הנתונים המקורית (
orders_database). (עם זאת, אם המשתמשים מריצים שאילתה מהסוג הזה לעיתים קרובות, אפשר ליצור בשבילה טבלה נצברת). - בשאילתה על מכירות שבועיות, אין טבלת צבירה שבועית, ולכן Looker משתמש באפשרות הטובה ביותר הבאה, שהיא טבלת הצבירה שמבוססת על מכירות יומיות (
sales_daily_aggregate_table).
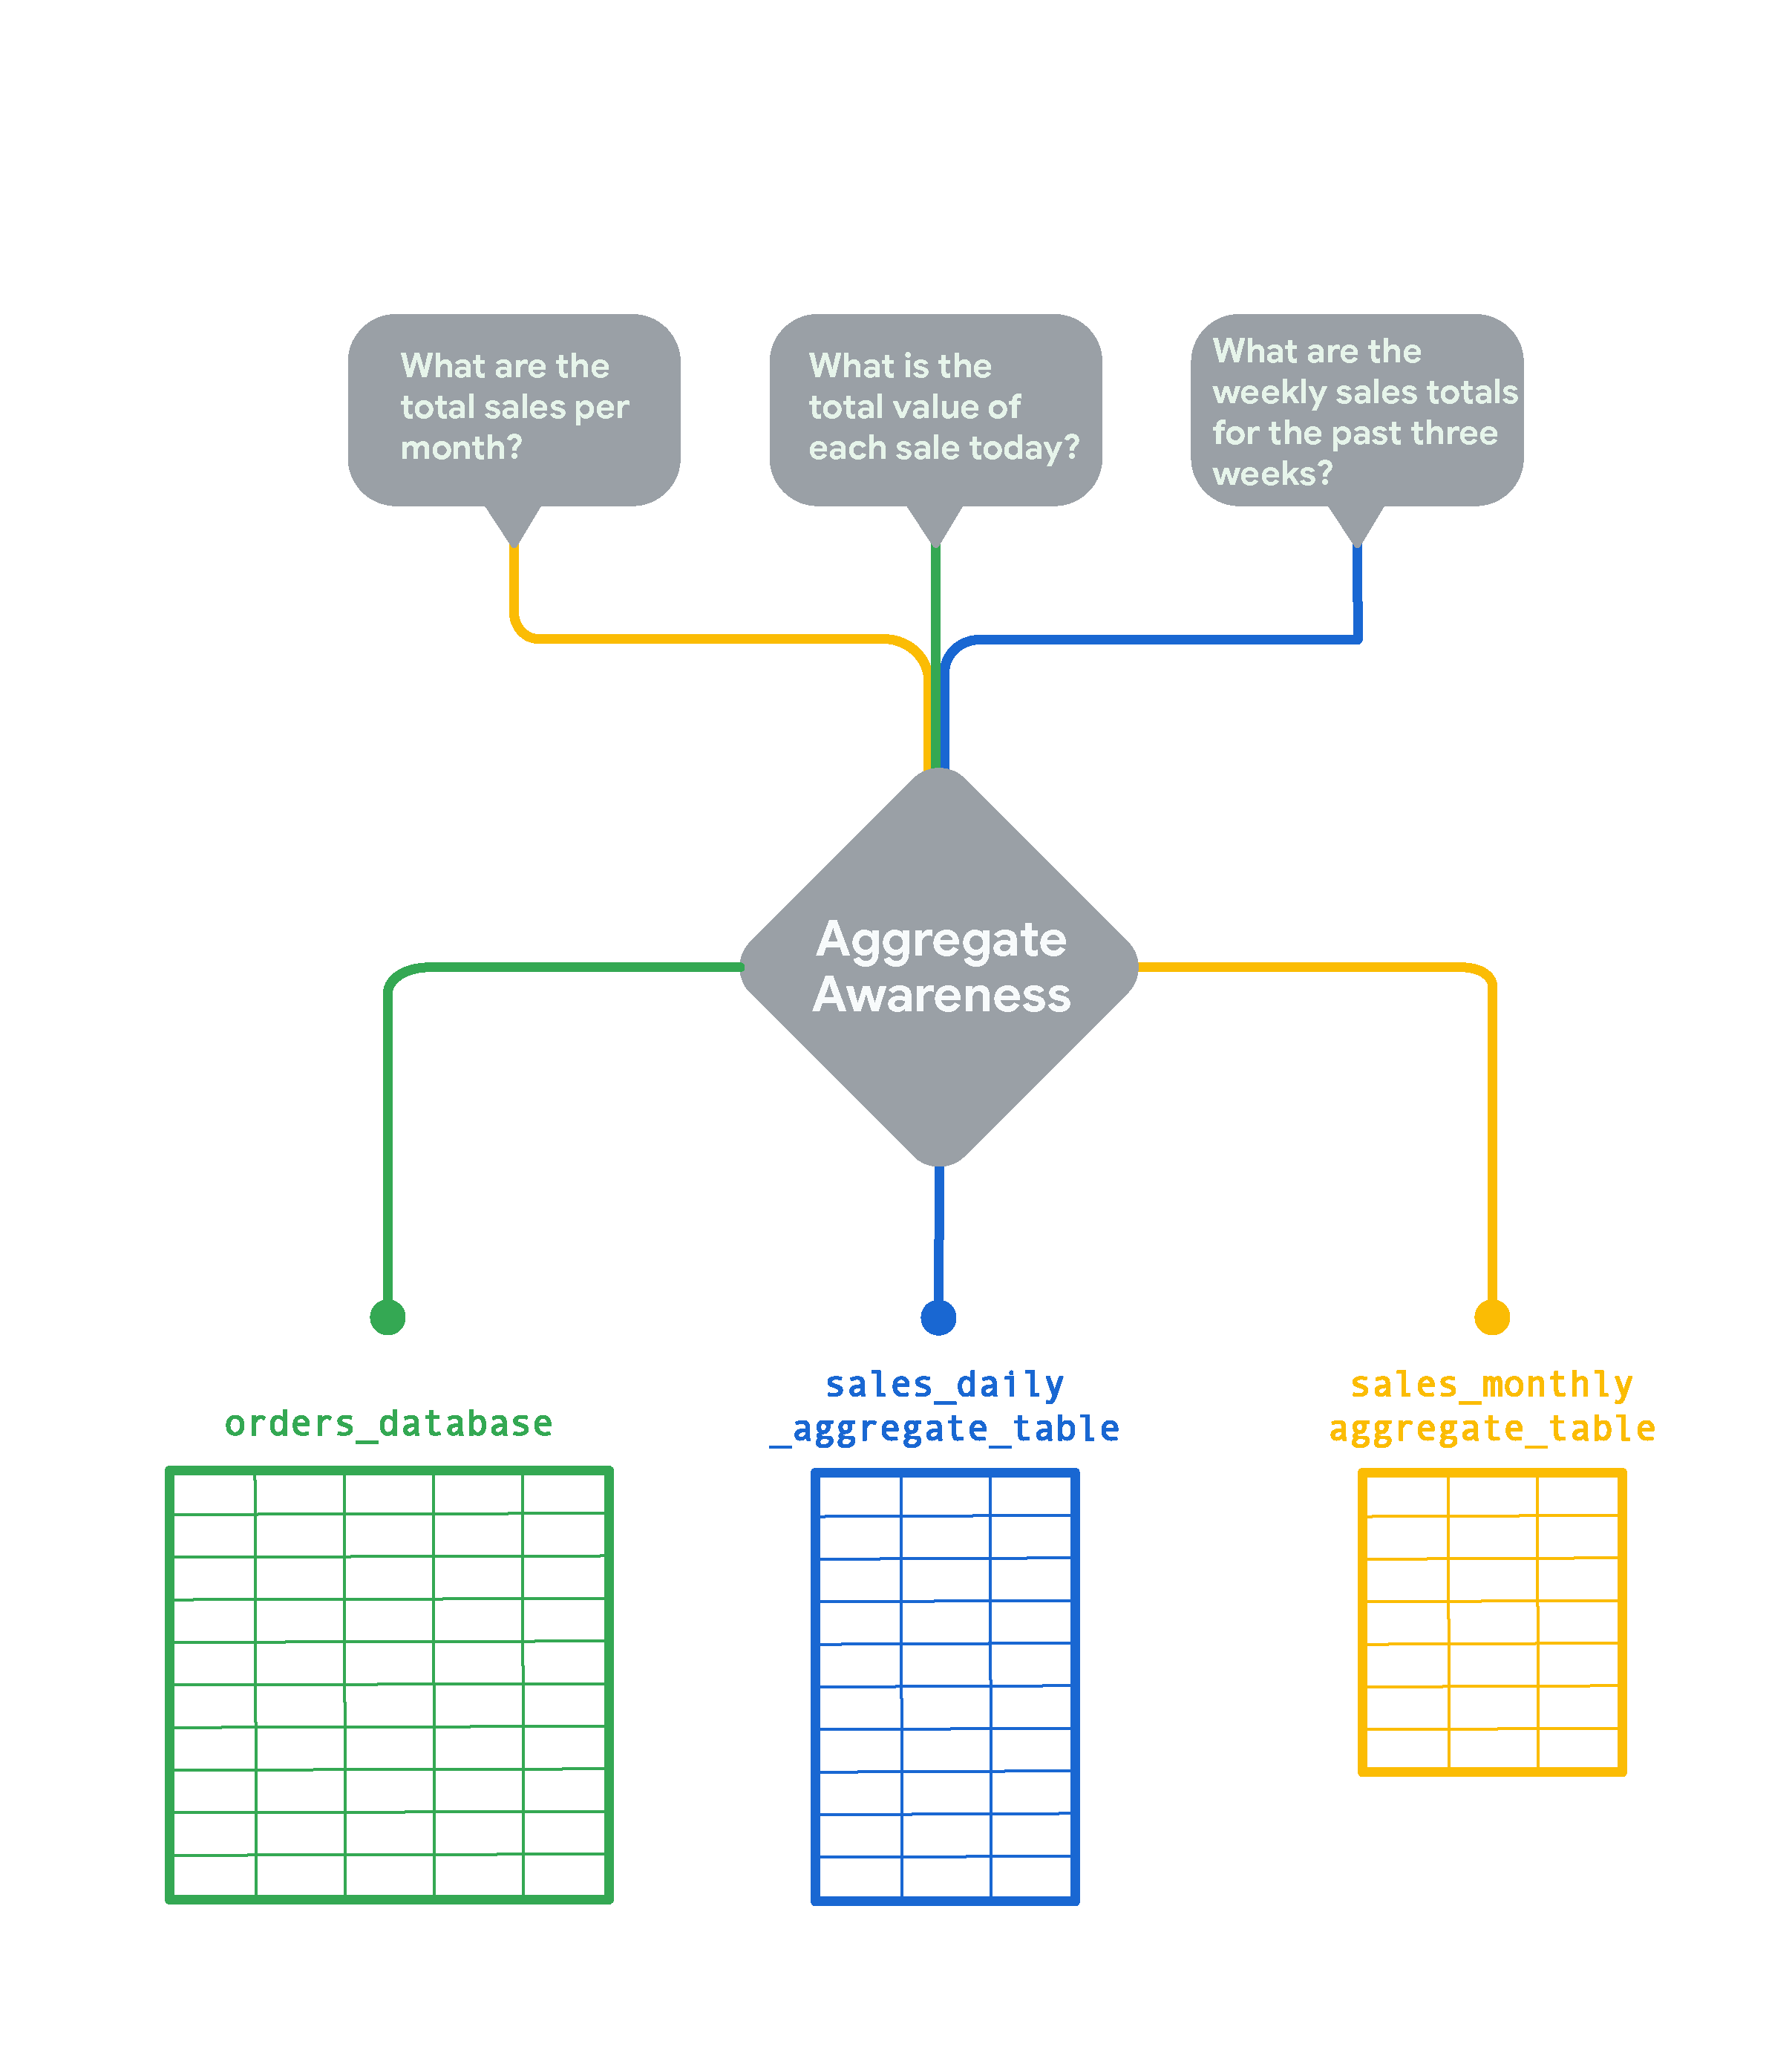
בעזרת לוגיקת המודעות לצבירת נתונים, Looker יבצע שאילתה בטבלה המסכמת הקטנה ביותר האפשרית כדי לענות על השאלות של המשתמשים. הטבלה המקורית תשמש רק לשאילתות שדורשות רמת פירוט גבוהה יותר מזו שהטבלאות המצטברות יכולות לספק.
אין צורך לצרף טבלאות מסכמות או להוסיף אותן ל-Explore נפרד. במקום זאת, Looker משנה באופן דינמי את סעיף ה-FROM של שאילתת ה-Explore כדי לגשת לטבלת הצבירה הכי מתאימה לשאילתה. המשמעות היא שהניתוחים המפורטים שלכם נשמרים ואפשר לאחד את הניתוחים ב-Explore. בעזרת מודעוּת לצבירה, אפשר להשתמש בטבלאות מסכמות באופן אוטומטי ב-Explore אחד, אבל עדיין להתעמק בנתונים מפורטים במקרה הצורך.
אתם יכולים גם להשתמש בטבלאות מסכמות כדי לשפר באופן משמעותי את הביצועים של מרכזי הבקרה, במיוחד במשבצות ששולחות שאילתות לקבוצות נתונים גדולות. פרטים נוספים מופיעים בקטע קבלת טבלת LookML מצטברת מלוח בקרה בדף התיעוד של הפרמטר aggregate_table.
הוספת טבלאות מצטברות לפרויקט
מפתחי Looker יכולים ליצור טבלאות צבירה אסטרטגיות שיצמצמו את מספר השאילתות שנדרשות בטבלאות הגדולות במסד נתונים. צריך לשמור את הטבלאות המצטברות במסד הנתונים כדי שיהיה אפשר לגשת אליהן לצורך צבירת נתונים. לכן, טבלאות מצטברות הן סוג של טבלה נגזרת מתמידה (PDT).
טבלה מסכמת מוגדרת באמצעות הפרמטר aggregate_table מתחת לפרמטר explore בפרויקט של LookML.
דוגמה ל-explore עם טבלה מסכמת ב-LookML:
explore: orders {
  label: "Sales Totals"
  join: order_items {
    sql_on: ${orders.id} = ${order_items.id} ;;
  }
  aggregate_table: sales_monthly {
    materialization: {
      datagroup_trigger: orders_datagroup
    }
    query: {
      dimensions: [created_month]
      measures: [order_items.total_sales]
    }
  }
  # other explore parameters
}
כדי ליצור טבלה מסכמת, אתם יכולים לכתוב את ה-LookML מאפס, או לקבל LookML של טבלה מסכמת מ-Explore או ממרכז בקרה. פרטים ספציפיים על הפרמטר aggregate_table והפרמטרים המשניים שלו זמינים בדף התיעוד של הפרמטר aggregate_table.
עיצוב טבלאות מסכמות
כדי ששאילתת Explore תשתמש בטבלת צבירת נתונים, הטבלה צריכה להיות מסוגלת לספק נתונים מדויקים לשאילתת Explore. Looker יכול להשתמש בטבלה מסכמת לשאילתת Explore אם כל התנאים הבאים מתקיימים:
- השדות של שאילתת Explore הם קבוצת משנה של השדות של טבלה מסכמת (ראו את הקטע גורמי שדות בדף הזה). בנוסף, מסגרות הזמן של השאילתה ב-Explore יכולות להיות נגזרת של מסגרות הזמן בטבלת הצבירה (ראו את הקטע גורמים של מסגרת זמן בדף הזה).
- השאילתה ב-Explore מכילה סוגי מדדים שנתמכים על ידי מודעות מצטברת (ראו את הקטע גורמים של סוגי מדדים בדף הזה), או שלשאילתה ב-Explore יש טבלה מצטברת שהיא התאמה מדויקת (ראו את הקטע יצירת טבלאות מצטברות שתואמות בדיוק לשאילתות ב-Explore בדף הזה).
- אזור הזמן של השאילתה ב-Explore תואם לאזור הזמן שבו משתמשת טבלה מסכמת (ראו את הקטע גורמים שקשורים לאזור הזמן בדף הזה).
- המסננים בשאילתת ה-Explore מתייחסים לשדות שזמינים כמאפיינים בטבלה המסכמת, או שכל אחד מהמסננים בשאילתת ה-Explore תואם למסנן בטבלה המסכמת (ראו את הקטע גורמים שמשפיעים על סינון בדף הזה).
אחת מהדרכים לוודא שטבלה מסכמת יכולה לספק נתונים מדויקים לשאילתה ב-Explore, היא ליצור טבלה מסכמת שתואמת בדיוק לשאילתה ב-Explore. פרטים נוספים זמינים בקטע יצירת טבלאות מסכמות שתואמות בדיוק לשאילתות בכלי הניתוחים בדף הזה.
גורמים בשטח
כדי להשתמש בטבלה מסכמת בשאילתת Explore, הטבלה צריכה לכלול את כל המאפיינים והמדדים שנדרשים לשאילתת ה-Explore, כולל השדות שמשמשים למסננים בשאילתת ה-Explore. אם שאילתת Explore מכילה מאפיין או מדד שלא נמצאים בטבלה מסכמת, Looker לא יכול להשתמש בטבלה המסכמת וישתמש במקום זאת במסד הנתונים הטבלאי.
לדוגמה, אם שאילתה מקבצת לפי המאפיינים א' וב', צוברת לפי המדד ג' ומסננת לפי המאפיין ד', טבלת הצבירה חייבת לכלול לפחות את א', ב' וד' כמאפיינים ואת ג' כמדד.
הטבלה המצטברת יכולה להכיל גם שדות אחרים, אבל היא חייבת להכיל לפחות את שדות השאילתה של Explore כדי שאפשר יהיה לבצע אופטימיזציה. החריג היחיד הוא מאפיינים של מסגרת זמן, כי אפשר להפיק מסגרות זמן עם רמת פירוט נמוכה יותר ממסגרות זמן עם רמת פירוט גבוהה יותר.
בגלל השיקולים האלה לגבי השדות, טבלה מסכמת היא ספציפית ל-Explore שבו היא מוגדרת. טבלה מסכמת שהוגדרה ב-Explore אחד לא תשמש לשאילתות ב-Explore אחר.
גורמים שקשורים למסגרת הזמן
הלוגיקה של Looker לגבי מוּדעוּת מצטברת מאפשרת להסיק מסגרת זמן אחת מתוך מסגרת זמן אחרת. אפשר להשתמש בטבלה מצטברת לשאילתה כל עוד מסגרת הזמן של הטבלה המצטברת היא ברמת פירוט גבוהה יותר (או שווה) מזו של השאילתה בניתוח. לדוגמה, אפשר להשתמש בטבלה מסכמת שמבוססת על נתונים יומיים בשאילתה בכלי הניתוחים שדורשת מסגרות זמן אחרות, כמו שאילתות של נתונים יומיים, חודשיים ושנתיים, או אפילו נתונים של יום בחודש, יום בשנה ושבוע בשנה. אבל אי אפשר להשתמש בטבלה מסכמת שנתית לשאילתת ניתוח שמבקשת נתונים ברזולוציה שעתית, כי הנתונים בטבלה המסכמת לא מספיק מפורטים בשביל שאילתת הניתוח.
אותו עיקרון חל על קבוצות משנה של טווחי תאריכים. לדוגמה, אם יש לכם טבלה מסכמת שמסוננת לפי שלושת החודשים האחרונים, ומשתמש שולח שאילתה על הנתונים עם מסנן לפי החודשיים האחרונים, Looker יוכל להשתמש בטבלה המסכמת בשביל השאילתה הזו.
בנוסף, אותה לוגיקה חלה על שאילתות עם מסנני טווח זמן: אפשר להשתמש בטבלה מסכמת לשאילתה עם מסנן טווח זמן, כל עוד טווח הזמן של הטבלה המסכמת הוא ברמת פירוט גבוהה יותר (או שווה) מזו של מסנן טווח הזמן שבו נעשה שימוש בשאילתת הניתוח. לדוגמה, אפשר להשתמש בטבלה נצברת שיש בה מאפיין של מסגרת זמן יומית בשאילתת Explore שמסננת לפי יום, שבוע או חודש.
גורמים של סוג המדידה
כדי ששאילתת Explore תשתמש בטבלת צבירת נתונים, המדדים בטבלת צבירת הנתונים צריכים להיות מסוגלים לספק נתונים מדויקים לשאילתת Explore.
לכן, רק סוגים מסוימים של מדדים נתמכים, כפי שמתואר בסעיפים הבאים:
- אמצעים עם סוגי אמצעים נתמכים
- מדדים שמוגדרים באמצעות ביטויי SQL
- מידות שלא מוגדרות באמצעות
${TABLE} - מדדים שמספקים קירוב לספירות נפרדות
אם שאילתת Explore משתמשת בסוג אחר של מדד, Looker ישתמש בטבלה המקורית, ולא בטבלת הצבירה, כדי להחזיר תוצאות. החריג היחיד הוא אם השאילתה של Explore היא התאמה מדויקת של שאילתת טבלה מסכמת, כמו שמתואר בקטע יצירת טבלאות מסכמות שתואמות בדיוק לשאילתות של Explore.
אחרת, Looker ישתמש בטבלה המקורית, ולא בטבלה המצטברת, כדי להחזיר תוצאות.
מדדים עם סוגי מדדים נתמכים
אפשר להשתמש במודעות מצטברת בשאילתות של Explore שמשתמשות במדדים עם סוגי המדדים הבאים:
כדי להשתמש בטבלה מסכמת בשאילתת Explore, ל-Looker צריכה להיות אפשרות לפעול על המדדים של הטבלה המסכמת כדי לספק נתונים מדויקים בשאילתת Explore. לדוגמה, אפשר להשתמש במדד עם type: sum למודעות מצטברת כי אפשר לסכם כמה סכומים: אפשר לחבר טבלה מצטברת של סכומים שבועיים כדי לקבל סכום חודשי מדויק. באופן דומה, אפשר להשתמש במדד עם type: max כי אפשר להשתמש בטבלה נצברת של ערכי מקסימום יומיים כדי למצוא את הערך המקסימלי השבועי המדויק.
במקרה של מדדים עם type: average, יש תמיכה במודעות לצבירת נתונים כי Looker משתמש בנתוני סכום וספירה כדי להפיק ערכים ממוצעים מדויקים מטבלאות מסכמות.
מדדים שמוגדרים באמצעות ביטויי SQL
אפשר להשתמש במודעות מצטברת גם עם מדדים שמוגדרים באמצעות ביטויים בפרמטר sql. כשמגדירים אותם באמצעות ביטויי SQL, אפשר להשתמש גם בסוגי המדדים הבאים:
התכונה "מודעות לצבירת נתונים" נתמכת במדדים שמוגדרים כשילובים של מדדים אחרים, כמו בדוגמה הזו:
measure: total_revenue_in_dollars {
  type: number
  sql: ${total_revenue_in_dollars} - ${inventory_item.total_cost_in_dollars} ;;
}
יש גם תמיכה במודעות מצטברת למדדים שבהם החישובים מוגדרים בפרמטר sql, כמו המדד הזה:
measure: wholesale_value {
  type: number
    sql: (${order_items.total_sale_price} * 0.60) ;;
}
בנוסף, יש תמיכה במודעוּת לצבירה במדדים שבהם הפעולות MIN, MAX ו-COUNT מוגדרות בפרמטר sql, כמו במדד הזה:
measure: most_recent_order_date {
  type: date
  sql: MAX(${users.created_at_raw})
}
מדדים שמפנים לשדות LookML
כשמשתמשים בביטויים של sql במדדים, המודעות המצטברת תומכת בסוגים הבאים של הפניות לשדות:
- הפניות בפורמט
${view_name.field_name}, שמציין שדות בתצוגות אחרות - הפניות בפורמט
${field_name}, שמציין שדות באותה תצוגה
אין תמיכה במודעות לצבירה במדדים שמוגדרים באמצעות הפורמט ${TABLE}.column_name, שמציין עמודה בטבלה. (סקירה כללית על שימוש בהפניות ב-LookML מופיעה במאמר שילוב של SQL והפניה לאובייקטים של LookML).
לדוגמה, מדד שמוגדר עם הפרמטר sql הזה לא ייתמך בטבלה מסכמת, כי הוא משתמש בפורמט ${TABLE}.column_name:
measure: wholesale_value {
  type: number
  sql: (${TABLE}.total_sale_price * 0.60) ;;
}
אם רוצים לכלול את המדד הזה בטבלה מסכמת, אפשר ליצור מאפיין שמוגדר בפורמט ${TABLE}.column_name, ואז ליצור מדד שמפנה למאפיין, למשל:
 dimension: total_sale_price {
    sql: (${TABLE}.total_sale_price) ;;
  }

  measure: wholesale_value {
    type: number
    sql: (${total_sale_price} * 0.60) ;;
}
עכשיו אפשר להשתמש במדד wholesale_value בטבלה המסכמת.
מדדים שנותנים קירוב לספירות נפרדות
באופן כללי, ספירות נפרדות לא נתמכות במודעות לצבירת נתונים, כי אי אפשר לקבל נתונים מדויקים אם מנסים לצבור ספירות נפרדות. לדוגמה, אם אתם סופרים את המשתמשים הייחודיים באתר, יכול להיות שמשתמש מסוים הגיע לאתר פעמיים, בהפרש של שלושה שבועות. אם ניסיתם להחיל טבלה מסכמת שבועית כדי לקבל ספירה חודשית של משתמשים ייחודיים באתר שלכם, המשתמש הזה ייספר פעמיים בשאילתת הספירה החודשית של משתמשים ייחודיים, והנתונים יהיו שגויים.
אפשר לעקוף את הבעיה הזו על ידי יצירת טבלת צבירה שתואמת בדיוק לשאילתת Explore, כפי שמתואר בקטע יצירת טבלאות צבירה שתואמות בדיוק לשאילתות Explore בדף הזה. כשהשאילתה של הכלי "ניתוחים" והשאילתה של הטבלה המסכמת זהות, מדדי הספירה הייחודית מספקים נתונים מדויקים, ולכן אפשר להשתמש בהם כדי להבין את הנתונים המצטברים.
אפשרות נוספת היא להשתמש בקירובים לספירות נפרדות. בניבים שתומכים בשרטוטי HyperLogLog, Looker יכול להשתמש באלגוריתם HyperLogLog כדי להעריך ספירות נפרדות לטבלאות נתונים נצברים.
לאלגוריתם HyperLogLog יש שגיאה של כ-2%. הפרמטר allow_approximate_optimization: yes דורש ממפתחי Looker לאשר שזה בסדר להשתמש בנתונים משוערים למדד, כדי שניתן יהיה לחשב את המדד באופן משוער מטבלאות מסכמות.
מידע נוסף ורשימת הניבים שתומכים בספירת ערכים ייחודיים באמצעות HyperLogLog זמינים בדף התיעוד של הפרמטר allow_approximate_optimization.
גורמים שקשורים לאזור הזמן
במקרים רבים, מנהלי מסדי נתונים משתמשים ב-UTC כאזור הזמן של מסדי הנתונים. עם זאת, יכול להיות שהרבה משתמשים לא נמצאים באזור הזמן UTC. ל-Looker יש כמה אפשרויות להמרת אזורי זמן, כדי שהמשתמשים יקבלו תוצאות של שאילתות באזור הזמן שלהם:
- אזור הזמן של השאילתות, הגדרה שחלה על כל השאילתות בחיבור למסד הנתונים. אם כל המשתמשים נמצאים באותו אזור זמן, אפשר להגדיר אזור זמן אחד לשאילתות, כך שכל השאילתות יומרו מאזור הזמן של מסד הנתונים לאזור הזמן של השאילתות.
- אזורי זמן ספציפיים למשתמש, שבהם אפשר להקצות למשתמשים אזורי זמן באופן נפרד, והם יכולים לבחור אותם בעצמם. במקרה כזה, השאילתות מומרות מאזור הזמן של מסד הנתונים לאזור הזמן של המשתמש הספציפי.
מידע נוסף על האפשרויות האלה זמין בדף התיעוד שימוש בהגדרות אזור הזמן.
המושגים האלה חשובים להבנת המודעות המצטברת, כי כדי להשתמש בטבלה מצטברת לשאילתה עם מימדי תאריך או מסנני תאריך, אזור הזמן בטבלה המצטברת צריך להיות זהה להגדרת אזור הזמן שבה נעשה שימוש בשאילתה המקורית.
אם לא מציינים ערך של timezone, טבלאות מצטברות משתמשות באזור הזמן של מסד הנתונים. חיבור מסד הנתונים ישתמש גם באזור הזמן של מסד הנתונים אם מתקיים אחד מהתנאים הבאים:
- מסד הנתונים שלכם לא תומך באזורי זמן.
- אזור הזמן של השאילתות בחיבור של מסד הנתונים מוגדר לאותו אזור זמן כמו אזור הזמן של מסד הנתונים.
- בחיבור למסד הנתונים לא צוין אזור זמן לשאילתה ולא צוינו אזורי זמן ספציפיים למשתמש. במקרה כזה, חיבור מסד הנתונים ישתמש באזור הזמן של מסד הנתונים.
אם אחד מהתנאים האלה מתקיים, אתם יכולים להשמיט את הפרמטר timezone מהטבלאות המסכמות.
אחרת, צריך להגדיר את אזור הזמן של הטבלה המסכמת כך שיתאים לשאילתות אפשריות, כדי שהטבלה המסכמת תשמש יותר:
- אם החיבור למסד הנתונים משתמש באזור זמן אחד של השאילתות, צריך להתאים את הערך של
timezoneבטבלה המסכמת לערך של אזור הזמן של השאילתות. - אם החיבור למסד הנתונים משתמש באזורי זמן ספציפיים למשתמש, צריך ליצור טבלאות מסכמות זהות, שלכל אחת מהן ערך
timezoneשונה שמתאים לאזורי הזמן האפשריים של המשתמשים.
סינון גורמים
חשוב להיזהר כשכוללים מסננים בטבלה המסכמת. מסננים בטבלה מסכמת יכולים לצמצם את התוצאות עד כדי כך שהטבלה המסכמת לא תהיה שמישה. לדוגמה, נניח שאתם יוצרים טבלה מסכמת של ספירת הזמנות יומית, ובטבלה המסכמת מוגדרים מסננים רק להזמנות של משקפי שמש שמגיעות מאוסטרליה. אם משתמש מריץ שאילתת Explore כדי לקבל את מספר ההזמנות היומי של משקפי שמש ברחבי העולם, Looker לא יכול להשתמש בטבלה המסכמת בשביל שאילתת ה-Explore הזו, כי בטבלה המסכמת יש רק את הנתונים של אוסטרליה. הטבלה הנצברת מסננת את הנתונים בצורה מצומצמת מדי, ולכן אי אפשר להשתמש בה בשאילתה של הכלי לניתוח נתונים.
בנוסף, חשוב לשים לב למסננים שמפתחי Looker הוסיפו ל-Explore, למשל:
-
access_filters: חלות הגבלות על נתונים ספציפיים למשתמש. -
always_filter: דורשים מהמשתמשים לכלול קבוצה מסוימת של מסננים בשאילתת Explore. המשתמשים יכולים לשנות את ערך ברירת המחדל של המסנן בשאילתה, אבל הם לא יכולים להסיר את המסנן לגמרי. -
conditionally_filter: מגדיר קבוצה של מסנני ברירת מחדל שהמשתמשים יכולים לבטל אם הם מפעילים לפחות מסנן אחד מרשימה שנייה שמוגדרת גם היא בכלי הניתוח.
סוגי המסננים האלה מבוססים על שדות ספציפיים. אם ב-Explore יש את המסננים האלה, צריך לכלול את השדות שלהם בפרמטר dimensions של aggregate_table.
לדוגמה, הנה ניתוח עם מסנן גישה שמבוסס על השדה orders.region:
explore: orders {
  access_filter: {
    field: orders.region
    user_attribute: region
  }
}
כדי ליצור טבלה מסכמת שתשמש לניתוח הזה, הטבלה המסכמת חייבת לכלול את השדה שעליו מבוסס מסנן הגישה. בדוגמה הבאה, מסנן הגישה מבוסס על השדה orders.region, והשדה הזה נכלל כמאפיין בטבלת הצבירה:
explore: orders {
  access_filter: {
    field: orders.region  # <-- orders.region field
    user_attribute: region
  }
  aggregate_table: sales_monthly {
    materialization: {
      datagroup_trigger: orders_datagroup
    }
    query: {
      dimensions: [orders.created_day, orders.region] # <-- orders.region field
      measures: [orders.total_sales]
      timezone: America/Los_Angeles
    }
  }
}
מכיוון שהשאילתה של הטבלה המסכמת כוללת את המאפיין orders.region, Looker יכול לסנן באופן דינמי את הנתונים בטבלה המסכמת כך שיתאימו למסנן מהשאילתה של Explore. לכן, Looker עדיין יכול להשתמש בטבלה מסכמת לשאילתות של ה-Explore, גם אם ל-Explore יש מסנן גישה.
זה חל גם על שאילתות Explore שמשתמשות בטבלה נגזרת מבוססת LookML שמוגדרת עם bind_filters. הפרמטר bind_filters מעביר מסננים שצוינו משאילתת Explore אל שאילתת המשנה של טבלה נגזרת מבוססת LookML (NDT). במקרה של מודעות מצטברת, אם השאילתה של Explore דורשת טבלה נגזרת מבוססת LookML שמשתמשת ב-bind_filters, השאילתה של Explore יכולה להשתמש בטבלה מצטברת רק אם לכל השדות שנעשה בהם שימוש בפרמטר bind_filters של הטבלה הנגזרת מבוססת LookML יש בדיוק את אותם ערכי סינון בשאילתה של Explore כמו בטבלה המצטברת.
יצירת טבלאות מצטברות שתואמות בדיוק לשאילתות בכלי הניתוחים
אחת מהדרכים לוודא שאפשר להשתמש בטבלה מסכמת בשאילתת Explore היא ליצור טבלה מסכמת שתואמת בדיוק לשאילתת Explore. אם בשאילתת ה-Explore ובטבלה המסכמת נעשה שימוש באותם מדדים, מאפיינים, מסננים, אזורי זמן ופרמטרים אחרים, אז בהגדרה, התוצאות של הטבלה המסכמת יחולו על שאילתת ה-Explore. אם טבלה מסכמת היא התאמה מדויקת של שאילתת Explore, Looker יכול להשתמש בטבלאות מסכמות שכוללות כל סוג של מדד.
אפשר ליצור טבלת צבירה מניתוח באמצעות האפשרות Get LookML בתפריט ההגדרות של ניתוח. אתם יכולים גם ליצור התאמות מדויקות לכל המשבצות בלוח הבקרה באמצעות האפשרות Get LookML מתפריט גלגל השיניים של לוח הבקרה.
איך לקבוע באיזו טבלה מסכמת להשתמש בשאילתה
משתמשים עם הרשאות see_sql יכולים להשתמש בתגובות בכרטיסייה SQL של Explore כדי לראות באיזו טבלה מסכמת תתבצע שאילתה. ההערות בכרטיסייה SQL מוצגות גם במצב פיתוח, כך שמפתחים יכולים לבדוק טבלאות צבירה חדשות כדי לראות איך Looker משתמש בהן לפני שמעבירים טבלאות חדשות לייצור.
לדוגמה, על סמך הטבלה המצטברת החודשית לדוגמה שמוצגת למעלה, אתם יכולים לעבור אל Explore ולהריץ שאילתה על סך המכירות השנתיות. אחר כך אפשר ללחוץ על הכרטיסייה SQL כדי לראות את פרטי השאילתה שנוצרה ב-Looker. אם אתם במצב פיתוח, Looker מציג הערות שמציינות את הטבלה המסכמת שבה הוא השתמש בשאילתה.
מההערות הבאות בכרטיסייה SQL אפשר לראות ש-Looker משתמש בטבלה מסכמת sales_monthly בשאילתה הזו, ומידע על הסיבות לכך שטבלאות מסכמות אחרות לא שימשו בשאילתה:
-- use existing orders::sales_monthly in sandbox_scratch.LR$LB4151619827209021_orders$sales_monthly
-- Did not use orders::sales_weekly; it does not include the following fields in the query: orders.created_month
-- Did not use orders::sales_daily; orders::sales_monthly was a better fit for optimization.
-- Did not use orders::sales_last_3_days; contained filters not in the query: orders.created_date
בקטע פתרון בעיות שבדף הזה מפורטות הערות אפשריות שמופיעות בכרטיסייה SQL והצעות לפתרון הבעיות.
אומדני חיסכון בחישובים למודעות מצטברת
אם חיבור מסד הנתונים תומך באומדני עלויות ואפשר להשתמש בטבלה מסכמת בשאילתה, בחלון 'ניתוח' יוצגו החיסכון בעלויות החישוב כתוצאה משימוש בטבלה המסכמת במקום בשליחת שאילתה ישירה במסד הנתונים. החיסכון המצטבר במודעות מוצג לצד הלחצן Run בכלי Explore לפני הרצת השאילתה.
לפני שמריצים את השאילתה, אם רוצים לראות באיזו טבלה מסכמת ייעשה שימוש בשאילתה, אפשר ללחוץ על הכרטיסייה SQL, כפי שמתואר בקטע קביעה באיזו טבלה מסכמת ייעשה שימוש בשאילתה בדף התיעוד הזה.
אחרי שהשאילתה תרוץ, בחלון Explore תוצג הטבלה המסכמת ששימשה כדי לענות על השאילתה, ליד הלחצן Run.
החיסכון המצטבר מוצג לחיבורים למסדי נתונים שמופעלות בהם הערכות עלות. מידע נוסף זמין בדף התיעוד בחינת נתונים ב-Looker .
Looker מאחד נתונים חדשים עם טבלאות מסכמות
בטבלאות מסכמות עם מסנני זמן, Looker יכול לאחד נתונים חדשים לתוך הטבלה המסכמת. יכול להיות שיש לכם טבלה מסכמת שכוללת נתונים משלושת הימים האחרונים, אבל הטבלה הזו נוצרה אתמול. בטבלה המצטברת לא יופיע המידע של היום, ולכן לא כדאי להשתמש בה כדי להריץ שאילתת ניתוח על המידע היומי העדכני ביותר.
עם זאת, Looker עדיין יכול להשתמש בנתונים שבטבלה המסכמת הזו בשאילתה, כי Looker יריץ שאילתה על הנתונים העדכניים ביותר, ואז יאחד את התוצאות האלה עם התוצאות בטבלה המסכמת.
Looker יכול לאחד נתונים חדשים עם הנתונים בטבלת הצבירה שלכם, בתנאים הבאים:
- בטבלה המצטברת יש מסנן זמן.
- טבלת הצבירה כוללת מאפיין שמבוסס על אותו שדה זמן כמו מסנן הזמן.
לדוגמה, בטבלה מסכמת הבאה יש מאפיין שמבוסס על השדה orders.created_date, ומסנן זמן ("3 days") שמבוסס על אותו שדה:
aggregate_table: sales_last_3_days {
  query:  {
    dimensions: [orders.created_date]
    measures: [order_items.total_sales]
    filters: [orders.created_date: "3 days"]  # <-- time filter
    timezone: America/Los_Angeles
  }
  ...
}
אם הטבלה המצטברת הזו נוצרה אתמול, Looker יאחזר את הנתונים העדכניים ביותר שעדיין לא נכללים בטבלה המצטברת, ואז יאחד את התוצאות העדכניות עם התוצאות מהטבלה המצטברת. זה אומר שהמשתמשים יקבלו את הנתונים העדכניים ביותר, תוך אופטימיזציה של הביצועים באמצעות מודעות מצטברת.
אם אתם במצב פיתוח, אתם יכולים ללחוץ על הכרטיסייה SQL בדוח Explore כדי לראות את הטבלה המסכמת ש-Looker השתמש בה בשאילתה, ואת ההצהרה UNION ש-Looker השתמש בה כדי להוסיף נתונים חדשים שלא נכללו בטבלה המסכמת.
צריך לשמר את הטבלאות המסכמות
כדי שהטבלה המצטברת תהיה נגישה לצורך מודעות מצטברת, היא צריכה להיות קבועה במסד הנתונים. אסטרטגיית השמירה מצוינת בפרמטר materialization של הטבלה המסכמת. טבלאות מסכמות הן סוג של טבלה נגזרת מתמידה (PDT), ולכן יש להן את אותן דרישות כמו ל-PDT. פרטים נוספים זמינים בדף התיעוד טבלאות נגזרות ב-Looker.
אתם יכולים ליצור טבלאות PDT מצטברות בפרויקט אם הניב תומך בהן. Looker יוצר טבלאות PDT מצטברות על ידי הוספת נתונים חדשים לטבלה, במקום לבנות מחדש את הטבלה כולה. מכיוון שטבלאות צבירה הן בעצמן סוג של PDT, אפשר ליצור גם טבלאות צבירה מצטברות. מידע נוסף על טבלאות PDT מצטברות זמין בדף התיעוד טבלאות PDT מצטברות. דוגמה לטבלת צבירה מצטברת מופיעה בדף התיעוד של הפרמטר increment_key.
משתמש עם הרשאת develop יכול לבטל את הגדרות השמירה ולבנות מחדש את כל טבלאות הצבירה של שאילתה כדי לקבל את הנתונים העדכניים ביותר. כדי לבנות מחדש את הטבלאות הנגזרות של שאילתה, בוחרים באפשרות Rebuild Derived Tables & Run בתפריט גלגל השיניים Explore actions.
צריך להמתין עד שהשאילתה ב'ניתוח נתונים' תיטען כדי שהאפשרות הזו תהיה זמינה.
האפשרות Rebuild Derived Tables & Run בונה מחדש את כל הטבלאות הנגזרות שיש אליהן הפניה בשאילתה, וגם את כל הטבלאות הנגזרות שהטבלאות בשאילתה תלויות בהן. זה כולל טבלאות מסכמות, שהן בעצמן סוג של טבלה נגזרת מתמידה.
אם המשתמש יבחר באפשרות Rebuild Derived Tables & Run (בנייה מחדש של טבלאות נגזרות והרצה), השאילתה תמתין עד שהטבלאות ייבנו מחדש לפני שהתוצאות ייטענו. שאילתות של משתמשים אחרים עדיין ישתמשו בטבלאות הקיימות. אחרי שהטבלאות לשימוש חוזר נוצרות מחדש, כל המשתמשים ישתמשו בטבלאות שנוצרו מחדש.
פרטים נוספים על האפשרות Rebuild Derived Tables & Run זמינים בדף התיעוד Derived tables in Looker.
פתרון בעיות
כפי שמתואר בקטע איך קובעים איזו טבלת צבירה משמשת לשאילתה, אם אתם נמצאים במצב פיתוח, אתם יכולים להריץ שאילתות ב'ניתוח נתונים' וללחוץ על הכרטיסייה SQL כדי לראות הערות לגבי טבלת הצבירה שמשמשת לשאילתה, אם יש כאלה.
בכרטיסייה SQL יש גם הערות שמסבירות למה לא נעשה שימוש בטבלאות מסכמות בשאילתה, אם זה המצב. אם הטבלאות המצטברות לא בשימוש, התגובה תתחיל במילים:
Did not use [explore name]::[aggregate table name];
לדוגמה, הנה הערה שמסבירה למה לא נעשה שימוש בשאילתה בטבלת הצבירה sales_daily שהוגדרה בניתוח הנתונים order_items:
-- Did not use order_items::sales_daily; query contained the following filters
that were neither included as fields nor exactly matched by filters in the aggregate table:
order_items.created_year.
במקרה הזה, המסננים בשאילתה מנעו את השימוש בטבלה מסכמת.
בטבלה הבאה מפורטות סיבות אפשריות נוספות לכך שלא ניתן להשתמש בטבלה מסכמת, וגם פעולות שאפשר לבצע כדי להגביר את השימושיות של הטבלה המסכמת.
| הסיבה לכך שהטבלה המסכמת לא בשימוש | הסבר ושלבים אפשריים |
|---|---|
| אין שדה כזה ב-Explore. | יש שגיאה מסוג אימות LookML. סביר להניח שהסיבה לכך היא שטבלת הצבירה לא הוגדרה כראוי, או שהייתה שגיאת הקלדה ב-LookML של טבלת הצבירה. הסיבה הסבירה לכך היא שם שדה שגוי או משהו דומה.כדי לפתור את הבעיה, מוודאים שהמאפיינים והמדדים בטבלה המסכמת זהים לשמות השדות ב-Explore. בדף התיעוד של הפרמטר aggregate_table מוסבר איך להגדיר טבלה מסכמת. |
| הטבלה המצטברת לא כוללת את השדות הבאים בשאילתה. | כדי להשתמש בטבלה מסכמת בשאילתת Explore, היא צריכה לכלול את כל המאפיינים והמדדים שנדרשים לשאילתת Explore, כולל השדות שמשמשים למסננים בשאילתת Explore. אם שאילתת Explore מכילה מאפיין או מדד שלא נמצאים בטבלה מסכמת, Looker לא יכול להשתמש בטבלה המסכמת וישתמש במקום זאת במסד הנתונים הטבלאי. פרטים נוספים זמינים בקטע גורמים בשטח בדף הזה. החריג היחיד הוא מאפייני תקופת זמן, כי אפשר לגזור תקופות זמן עם רמת פירוט גסה יותר מתקופות זמן עם רמת פירוט מדויקת יותר. כדי לפתור את הבעיה, צריך לוודא שהשדות של שאילתת ה-Explore נכללים בהגדרה של טבלה מסכמת. |
| השאילתה הכילה את המסננים הבאים שלא נכללו כשדות ולא תאמו בדיוק למסננים בטבלה המסכמת. | המסננים בשאילתה של Explore מונעים מ-Looker להשתמש בטבלה מסכמת. כדי לפתור את הבעיה, אפשר לבצע אחת מהפעולות הבאות:
|
| השאילתה מכילה את המדדים הבאים שלא ניתן לצמצם. | השאילתה מכילה סוג אחד או יותר של מדדים שלא נתמכים בחישובים מצטברים, כמו ספירה של ערכים ייחודיים, ערך חציוני או אחוזון.כדי לפתור את הבעיה, בודקים את הסוג של כל מדד בשאילתה ומוודאים שהוא אחד מסוגי המדדים הנתמכים. בנוסף, אם ב-Explore יש צירופים, צריך לוודא שהמדדים לא מומרים למדדים נפרדים (צבירה סימטרית) באמצעות צירופים מורחבים. הסבר מופיע בקטע מצטברים סימטריים ב-Explores עם הצטרפויות בדף הזה. |
| טבלה מסכמת אחרת התאימה יותר לאופטימיזציה. | היו כמה טבלאות צבירה מתאימות לשאילתה, ו-Looker מצא טבלת צבירה אופטימלית יותר לשימוש. במקרה כזה לא צריך לעשות כלום. |
Looker לא ביצע שום קיבוץ (בגלל פרמטר primary_key או cancel_grouping_fields), ולכן אי אפשר לצמצם את השאילתה. |
השאילתה מפנה למאפיין שמונע ממנה לכלול פסוקית GROUP BY, ולכן Looker לא יכול להשתמש בטבלה מסכמת כלשהי בשאילתה.
כדי לפתור את הבעיה, מוודאים שהפרמטר primary_key של התצוגה והפרמטר cancel_grouping_fields של הכלי'ניתוח נתונים' מוגדרים בצורה נכונה. |
| הטבלה המסכמת הכילה מסננים שלא היו בשאילתה. | בטבלה מסכמת יש מסנן שאינו מסנן זמן, שלא מופיע בשאילתה.כדי לפתור את הבעיה, אפשר להסיר את המסנן מהטבלה המסכמת. פרטים נוספים זמינים בקטע גורמי סינון בדף הזה. |
שדה מוגדר כשדה סינון בלבד בשאילתת הניתוח, אבל הוא מופיע בפרמטר dimensions של הטבלה המסכמת. |
הפרמטר dimensions בטבלת הצבירה מציג שדה שמוגדר רק כשדה filter בשאילתת הניתוח.כדי לפתור את הבעיה, צריך להסיר את השדה מהרשימה dimensions של הטבלה המסכמת. אם השדה הזה נדרש לטבלה המסכמת, צריך להוסיף אותו לרשימה filters בשאילתה של הטבלה המסכמת. |
| כלי האופטימיזציה לא יכול לקבוע למה לא נעשה שימוש בטבלה מסכמת. | ההערה הזו שמורה למקרי קצה. אם ההודעה הזו מופיעה בשאילתת Explore שמשתמשים בה לעיתים קרובות, אתם יכולים ליצור טבלה מסכמת שתואמת בדיוק לשאילתת Explore. אפשר לקבל LookML של טבלה מצטברת מניתוח, כמו שמתואר בדף הפרמטר aggregate_table. |
מה כדאי לקחת בחשבון?
צבירה סימטרית ל-Explores עם שאילתות איחוד (join)
חשוב לציין שב-Explore שמצרף כמה טבלאות של מסדי נתונים, Looker יכול להציג מדדים מסוג SUM, COUNT ו-AVERAGE בתור SUM DISTINCT, COUNT DISTINCT ו-AVERAGE DISTINCT, בהתאמה. Looker עושה את זה כדי למנוע חישובים שגויים של fanout. לדוגמה, מדד count מוצג כסוג מדד count_distinct. כך אפשר להימנע מחישובים שגויים של fanout בשאילתות איחוד (join), וזה חלק מהפונקציונליות של צבירה סימטרית ב-Looker. מידע נוסף על התכונה הזו של Looker זמין בדף שיטות מומלצות בנושא צבירות סימטריות.
הפונקציונליות של צבירה סימטרית מונעת חישובים שגויים, אבל היא גם יכולה למנוע את השימוש בטבלאות הצבירה במקרים מסוימים, ולכן חשוב להבין אותה.
לגבי סוגי המדדים שנתמכים על ידי המדד המצטבר של מוּדעוּת, זה רלוונטי ל-sum, ל-count ול-average. Looker יעבד את סוגי המדדים האלה כ-DISTINCT אם:
- המדד הוא מהתצוגה "אחד" של צירוף רבים לאחד או אחד לרבים.
- המדד מגיע מאיחוד רבים לרבים.
הסבר על סוגי הצירופים האלה מופיע בדף התיעוד של הפרמטר relationship.
אם אתם מגלים שהטבלה המצטברת לא נמצאת בשימוש בגלל הסיבה הזו, אתם יכולים ליצור טבלה מצטברת שתתאים בדיוק לשאילתת ניתוח כדי להשתמש בסוגי המדדים האלה בניתוח עם הצטרפות. למידע נוסף, עיינו בקטע יצירת טבלאות צבירה שתואמות בדיוק לשאילתות של Explore בדף הזה.
בנוסף, אם יש לכם ניב SQL שתומך בסקיצות של HyperLogLog, אתם יכולים להוסיף את הפרמטר allow_approximate_optimization: yes למדד. כשמדד ספירה מוגדר עם allow_approximate_optimization: yes, Looker יכול להשתמש במדד למודעות מצטברת, גם אם הוא מוצג כספירה נפרדת.
פרטים נוספים ורשימה של דיאלקטים של SQL שתומכים בסקיצות של HyperLogLog זמינים בדף התיעוד של הפרמטר allow_approximate_optimization.
תמיכה בניבים למודעות לצבירה
היכולת להשתמש ב-Aggregate Awareness תלויה בדיאלקט של מסד הנתונים שבו נעשה שימוש בחיבור Looker. בגרסה האחרונה של Looker, הניבים הבאים תומכים במודעות לצבירת נתונים:
| ניב | יש תמיכה? |
|---|---|
| Actian Avalanche | |
| Amazon Athena | |
| Amazon Aurora MySQL | |
| Amazon Redshift | |
| Amazon Redshift 2.1+ | |
| Amazon Redshift Serverless 2.1+ | |
| Apache Druid | |
| Apache Druid 0.13.x - 0.17.x | |
| Apache Druid 0.18+ | |
| Apache Hive 2.3+ | |
| Apache Hive 3.1.2+ | |
| Apache Spark 3+ | |
| ClickHouse | |
| ClickHouse 26+ | |
| Cloudera Impala 3.1+ | |
| Cloudera Impala 3.1+ with Native Driver | |
| Cloudera Impala with Native Driver | |
| DataVirtuality | |
| Databricks | |
| Denodo 7 | |
| Denodo 8 & 9 | |
| Dremio | |
| Dremio 11+ | |
| Dremio 26+ with Arrow Flight SQL | |
| Exasol | |
| Google BigQuery Legacy SQL | |
| Google BigQuery Standard SQL | |
| Google Cloud AlloyDB for PostgreSQL | |
| Google Cloud PostgreSQL | |
| Google Cloud SQL | |
| Google Spanner | |
| Greenplum | |
| HyperSQL | |
| IBM Netezza | |
| MariaDB | |
| Microsoft Azure PostgreSQL | |
| Microsoft Azure SQL Database | |
| Microsoft Azure Synapse Analytics | |
| Microsoft SQL Server 2008+ | |
| Microsoft SQL Server 2012+ | |
| Microsoft SQL Server 2016 | |
| Microsoft SQL Server 2017+ | |
| MongoBI | |
| MongoSQL | |
| MySQL | |
| MySQL 8.0.12+ | |
| Oracle | |
| Oracle ADWC | |
| PostgreSQL 9.5+ | |
| PostgreSQL pre-9.5 | |
| PrestoDB | |
| PrestoSQL | |
| SAP HANA | |
| SAP HANA 2+ | |
| SingleStore | |
| SingleStore 7+ | |
| Snowflake | |
| Teradata | |
| Trino | |
| Vector | |
| Vertica |
תמיכה בדיאלקט ליצירה מצטברת של טבלאות צבירה
כדי ש-Looker תתמוך בטבלאות צבירה מצטברות בפרויקט Looker, גם הניב של מסד הנתונים צריך לתמוך בהן. בטבלה הבאה מוצג אילו ניבים תומכים בבנייה מצטברת של טבלאות PDT בגרסה האחרונה של Looker:
| ניב | נתמך? |
|---|---|
| Actian Avalanche | |
| Amazon Athena | |
| Amazon Aurora MySQL | |
| Amazon Redshift | |
| Amazon Redshift 2.1+ | |
| Amazon Redshift Serverless 2.1+ | |
| Apache Druid | |
| Apache Druid 0.13.x - 0.17.x | |
| Apache Druid 0.18+ | |
| Apache Hive 2.3+ | |
| Apache Hive 3.1.2+ | |
| Apache Spark 3+ | |
| ClickHouse | |
| ClickHouse 26+ | |
| Cloudera Impala 3.1+ | |
| Cloudera Impala 3.1+ with Native Driver | |
| Cloudera Impala with Native Driver | |
| DataVirtuality | |
| Databricks | |
| Denodo 7 | |
| Denodo 8 & 9 | |
| Dremio | |
| Dremio 11+ | |
| Dremio 26+ with Arrow Flight SQL | |
| Exasol | |
| Google BigQuery Legacy SQL | |
| Google BigQuery Standard SQL | |
| Google Cloud AlloyDB for PostgreSQL | |
| Google Cloud PostgreSQL | |
| Google Cloud SQL | |
| Google Spanner | |
| Greenplum | |
| HyperSQL | |
| IBM Netezza | |
| MariaDB | |
| Microsoft Azure PostgreSQL | |
| Microsoft Azure SQL Database | |
| Microsoft Azure Synapse Analytics | |
| Microsoft SQL Server 2008+ | |
| Microsoft SQL Server 2012+ | |
| Microsoft SQL Server 2016 | |
| Microsoft SQL Server 2017+ | |
| MongoBI | |
| MongoSQL | |
| MySQL | |
| MySQL 8.0.12+ | |
| Oracle | |
| Oracle ADWC | |
| PostgreSQL 9.5+ | |
| PostgreSQL pre-9.5 | |
| PrestoDB | |
| PrestoSQL | |
| SAP HANA | |
| SAP HANA 2+ | |
| SingleStore | |
| SingleStore 7+ | |
| Snowflake | |
| Teradata | |
| Trino | |
| Vector | |
| Vertica |