


Auf dieser Seite wird beschrieben, wie Sie eine hochverfügbare Bereitstellung in mehreren Regionen mit regionalen externen Application Load Balancern konfigurieren. Um Hochverfügbarkeit zu erreichen, stellen Sie mehrere einzelne regionale externe Application Load Balancer in Regionen bereit, die den Traffic Ihrer Anwendung am besten unterstützen. Dies funktioniert, da regionale externe Application Load Balancer in verschiedenen Regionen nicht nur voneinander isoliert sind, sondern auch von jeder globalen externen Application Load Balancer- oder klassischen Application Load Balancer-Infrastruktur, die in der gleichen Region läuft.
Strategien für Hochverfügbarkeit
Sie können die regionsübergreifende Resilienz für regionale externe Application Load Balancer mit einer der folgenden Strategien implementieren:
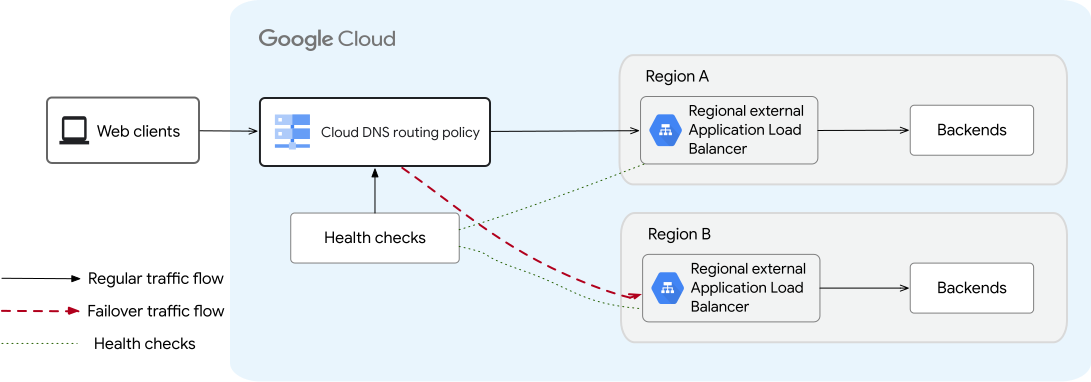
Aktiv-Passiv (Regionen-Failover): Stellen Sie einen primären regionalen externen Application Load Balancer in Ihrer primären Region und einen oder mehrere regionale externe Application Load Balancer in sekundären Regionen bereit. Im stabilen Zustand leitet Cloud DNS den gesamten Traffic an den primären Load-Balancer weiter. Wenn die Systemdiagnosen des primären Load Balancers fehlschlagen, verwendet Cloud DNS eine Failover-Routingrichtlinie, um Traffic an die regionalen Ersatz-Load Balancer weiterzuleiten.
Hier sehen Sie ein Beispiel für eine Aktiv/Passiv-Einrichtung mit zwei regionalen externen Application Load Balancern in zwei verschiedenen Regionen.
Aktiv/Aktiv (Proximity-Routing): Stellen Sie mehrere regionale externe Application Load Balancer in verschiedenen Regionen bereit, die gleichzeitig Traffic verarbeiten. Verwenden Sie eine Cloud DNS-Standortbestimmung-Routingrichtlinie, um Clients an die nächstgelegene fehlerfreie Region weiterzuleiten. Wenn ein Load Balancer in einer Region ausfällt, leitet Cloud DNS den Traffic automatisch von der fehlerhaften Region zu fehlerfreien Load Balancern in anderen Regionen weiter.
Hier sehen Sie ein Beispiel für eine Aktiv/Aktiv-Konfiguration mit zwei regionalen externen Application Load Balancern in zwei verschiedenen Regionen.
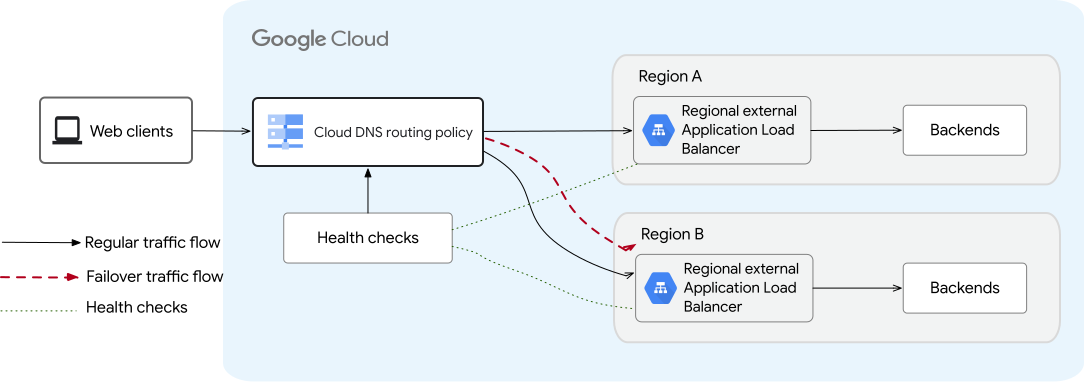
Hochverfügbarkeit mit zwei regionalen externen Application Load Balancern (zum Vergrößern klicken).
In den folgenden Abschnitten wird beschrieben, wie Systemdiagnosen und Traffic-Steuerung in einem typischen Workflow regionsübergreifend funktionieren:
Systemdiagnosen zum Erkennen regionaler Fehler verwenden
Google Cloud verwendet Systemdiagnosen, um zu ermitteln, ob Ihre regionalen Load Balancer fehlerfrei arbeiten. Sie konfigurieren diese Systemdiagnosen so, dass Prüfungen aus drei Quellregionen gesendet werden. Diese drei Quellregionen müssen repräsentativ für die Regionen sein, aus denen Ihre Clients auf die Load Balancer zugreifen. Wenn Sie beispielsweise einen regionalen externen Application Load Balancer haben, bei dem der Großteil Ihres Client-Traffics aus Nordamerika und Europa stammt, können Sie Prüfungen aus zwei oder mehr Regionen in Nordamerika und Prüfungen aus zwei oder mehr Regionen in Europa verwenden.
Zusätzliche Hinweise:
- Beim Erstellen der Systemdiagnose müssen Sie genau drei Quellregionen angeben. Nur bei globalen Systemdiagnosen können Quellregionen angegeben werden.
- HTTP-, HTTPS- und TCP-Systemdiagnosen werden unterstützt.
- Die Systemdiagnoseprüfungen stammen von einem Point of Presence (PoP) im Internet unweit der konfigurierten Google Cloud-Quellregion.
Traffic basierend auf Routingrichtlinien weiterleiten
- Aktiv-passiv: Cloud DNS verwendet eine Failover-Routingrichtlinie, um im stabilen Zustand 100% des Client-Traffics an den primären regionalen Load Balancer weiterzuleiten. Wenn die Systemdiagnosen des primären regionalen Load Balancers fehlschlagen, leitet Cloud DNS den Traffic an die regionalen Ersatz-Load Balancer weiter.
- Aktiv/Aktiv: Cloud DNS verwendet eine Routingrichtlinie zur Standortbestimmung, um Traffic an die Load Balancer weiterzuleiten. Wenn alle Load Balancer fehlerfrei sind, leitet Cloud DNS den Traffic an den Load Balancer weiter, der dem Client geografisch am nächsten ist. Wenn ein Load Balancer in einer Region Systemdiagnosen nicht mehr besteht, wird der Traffic automatisch zu verfügbaren fehlerfreien Load Balancern in anderen Regionen weitergeleitet.
Failback zum primären Load-Balancer
Failbacks erfolgen automatisch, sobald die Systemdiagnosen wieder bestanden werden. Der Traffic wird ohne Ausfallzeit wiederhergestellt, da die Load-Balancer Traffic verarbeiten.
Multiregionales Load-Balancing konfigurieren
So konfigurieren Sie eine multiregionale Bereitstellung, die eine hohe Verfügbarkeit ermöglicht:
- Regionale externe Application Load Balancer erstellen in den Regionen, die den Traffic für Ihre Anwendung am besten unterstützen. Jeder dieser Load-Balancer muss dieselben Konfigurationen für Traffic-Management und Sicherheit haben.
- Systemdiagnosen erstellen, um die IP-Adressen der Weiterleitungsregeln Ihrer regionalen Load Balancer zu überwachen.
- Konfigurieren Sie Ihre DNS-Routingrichtlinie in Cloud DNS:
- Bei Aktiv/Passiv-Bereitstellungen müssen Sie eine Failover-Routingrichtlinie erstellen.
- Für Aktiv-Aktiv-Bereitstellungen erstellen Sie eine Geolocation-Routingrichtlinie.
Load Balancer in mehreren Regionen erstellen
Beachten Sie beim Konfigurieren der zusätzlichen redundanten Load-Balancer Folgendes:
Konfigurieren Sie alle regionalen externen Application Load Balancer mit ähnlichen Funktionen, damit der Traffic unabhängig davon, welcher Load Balancer die Anfrage verarbeitet, einheitlich verarbeitet wird. Achten Sie beispielsweise darauf, dass Sie für alle regionalen externen Application Load Balancer denselben Typ von SSL-Zertifikat, dieselben regionalen Sicherheitsrichtlinien von Cloud Armor und dieselben Routing-Einstellungen für URL-Zuordnungen verwenden.
Wir empfehlen, ein Automatisierungsframework wie Terraform zu verwenden, um die Konsistenz der Load-Balancer-Konfigurationen in den verschiedenen regionalen Bereitstellungen zu erreichen und aufrechtzuerhalten.
Wir empfehlen, regionale externe Application Load Balancer in allen Regionen einzurichten, die sich am besten für den Traffic Ihrer Anwendung eignen.
Regionale externe Application Load Balancer unterstützen sowohl die Premium- als auch die Standard-Netzwerkdienststufen. Wir empfehlen, die regionalen externen Application Load Balancer in der Premium-Stufe einzurichten, um eine geringe Latenz zu gewährleisten.
Informationen zum Konfigurieren eines regionalen externen Application Load Balancers finden Sie unter Regionalen externen Application Load Balancer mit VM-Instanzgruppen-Backends einrichten.
Systemdiagnose erstellen
Erstellen Sie eine globale Systemdiagnose, um die externe IP-Adresse der Weiterleitungsregel jedes regionalen Load Balancers zu überwachen:
gcloud compute health-checks create http HEALTH_CHECK_NAME \
    --global \
    --source-regions=SOURCE_REGION_1,SOURCE_REGION_2,SOURCE_REGION_3 \
    --use-serving-port \
    --check-interval=HEALTH_CHECK_INTERVAL \
    --healthy-threshold=HEALTHY_THRESHOLD \
    --unhealthy-threshold=UNHEALTHY_THRESHOLD \
    --request-path=REQUEST_PATH
Ersetzen Sie Folgendes:
HEALTH_CHECK_NAME: der Name der SystemdiagnoseSOURCE_REGION_1,SOURCE_REGION_2undSOURCE_REGION_3: die drei Google Cloud-Regionen, aus denen Systemdiagnose-Probes gesendet werden. Sie müssen genau drei Quellregionen angeben.HEALTH_CHECK_INTERVAL: Die Zeit in Sekunden vom Start einer Prüfung, die von einem Prober aus erfolgt ist, bis zum Start der nächsten Prüfung, die vom selben Prober aus erfolgt ist. Der unterstützte Mindestwert beträgt 30 Sekunden. Empfohlene Werte finden Sie unter Best Practices.HEALTHY_THRESHOLDundUNHEALTHY_THRESHOLDgeben die Anzahl der sequenziellen Testdurchläufe an, die bestanden werden oder fehlschlagen müssen, damit der Load Balancer als fehlerfrei oder fehlerhaft eingestuft wird. Wenn einer der Parameter nicht angegeben ist,verwendet Google Cloud den Standardschwellenwert 2.REQUEST_PATH: Der URL-Pfad, an denGoogle Cloud Prüfanfragen für die Systemdiagnose sendet. Wenn keine Angabe gemacht wird, sendet Google Cloud Prüfungsanfragen an den Stammpfad/. Wenn die zu prüfenden Endpunkte privat sind, was für IP-Adressen externer Weiterleitungsregeln nicht typisch ist, können Sie diesen Pfad auf/afhealthzfestlegen.
Regionales Aktiv/Passiv-Failover konfigurieren
Erstellen Sie in Cloud DNS ein Recordset und wenden Sie eine FAILOVER-Routingrichtlinie an, um Steady-State-Traffic an den primären regionalen Load Balancer zu senden und bei einem Ausfall ein Failover zum sekundären regionalen Load Balancer durchzuführen:
gcloud dns record-sets create DNS_RECORD_SET_NAME \
    --ttl=TIME_TO_LIVE \
    --type=RECORD_TYPE \
    --zone="MANAGED_ZONE_NAME" \
    --routing-policy-type=FAILOVER \
    --routing-policy-primary-data=PRIMARY_REGIONAL_FORWARDING_RULE \
    --routing-policy-backup-data_type=GEO \
    --routing-policy-backup-data="BACKUP_REGION_1=BACKUP_LOAD_BALANCER_1_IP[;BACKUP_REGION_2=BACKUP_LOAD_BALANCER_2_IP]" \
    --health-check=HEALTH_CHECK_NAME \
    --backup-data-trickle-ratio=BACKUP_DATA_TRICKLE_RATIO
Ersetzen Sie Folgendes:
DNS_RECORD_SET_NAMEist der DNS- oder Domainname des hinzuzufügenden Datensatzes, z. B.test.example.com.TIME_TO_LIVE: die TTL in Sekunden für den Datensatz. Empfohlene Werte finden Sie unter Best Practices.RECORD_TYPEist der Datensatztyp, z. B.A.MANAGED_ZONE_NAME: Der Name Ihrer verwalteten Cloud DNS-Zone, z. B.my-zone-namePRIMARY_REGIONAL_FORWARDING_RULEist der Name der Weiterleitungsregel des primären regionalen externen Application Load Balancers.BACKUP_REGION_1undBACKUP_REGION_2: die Regionen, in denen die regionalen externen Ersatz-Application Load Balancer bereitgestellt sindBACKUP_LOAD_BALANCER_1_IPundBACKUP_LOAD_BALANCER_2_IP: die externen IP-Adressen der Weiterleitungsregel der regionalen externen Backup-Application Load BalancerHEALTH_CHECK_NAME: der Name der SystemdiagnoseBACKUP_DATA_TRICKLE_RATIO: Der Anteil des Traffics (zwischen 0 und 1, z. B.0.1), der im Steady State an den regionalen Ersatz-Load Balancer gesendet wird, um sicherzustellen, dass der Ersatz-Load Balancer bereit ist. Der Standardwert ist 0.
Aktiv/Aktiv-Regionenrouting konfigurieren
Erstellen Sie in Cloud DNS einen Datensatz und wenden Sie eine Routingrichtlinie für die Standortbestimmung an, um Traffic gleichzeitig über fehlerfreie regionale Load Balancer weiterzuleiten:
gcloud dns record-sets create DNS_RECORD_SET_NAME \
    --ttl=TIME_TO_LIVE \
    --type=RECORD_TYPE \
    --zone="MANAGED_ZONE_NAME" \
    --routing-policy-type="GEO" \
    --routing-policy-data="FORWARDING_RULE_NAME_A@REGION_A;FORWARDING_RULE_NAME_B@REGION_B[,;FORWARDING_RULE_NAME_C@REGION_C]" \
    --health-check=HEALTH_CHECK_NAME
Ersetzen Sie Folgendes:
DNS_RECORD_SET_NAMEist der DNS- oder Domainname des hinzuzufügenden Datensatzes, z. B.test.example.com.TIME_TO_LIVE: die Gültigkeitsdauer (TTL) des Datensatzes in Sekunden. Empfohlene Werte finden Sie unter Best Practices.RECORD_TYPEist der Datensatztyp, z. B.A.MANAGED_ZONE_NAMEist der Name der verwalteten Zone, deren Datensätze Sie verwalten möchten, z. B.my-zone-name.FORWARDING_RULE_NAME_A,FORWARDING_RULE_NAME_BundFORWARDING_RULE_NAME_C: die Namen der Weiterleitungsregeln für die Load Balancer in den einzelnen RegionenREGION_A,REGION_BundREGION_C: die Regionen, in denen die einzelnen Load Balancer bereitgestellt werdenHEALTH_CHECK_NAME: der Name der Systemdiagnose
Best Practices
Hier sind einige Best Practices, die Sie beim Konfigurieren von Cloud DNS-Einträgen und ‑Systemdiagnosen beachten sollten:
Ausfalldauer berechnen: Die Zeit, die der Traffic benötigt, um von fehlerhaften zu fehlerfreien Load Balancern umgeleitet zu werden (d. h. die Dauer der Ausfallzeit) hängt vom DNS-TTL-Wert, dem Intervall für die Systemdiagnose und dem Fehlerschwellenwert der Systemdiagnose ab:
Duration of outage = DNS TTL + Health Check Interval * Unhealthy ThresholdWir empfehlen, die DNS-TTL auf 30 bis 60 Sekunden festzulegen. Höhere TTLs führen zu längeren Ausfallzeiten, da Clients im Internet weiterhin auf die fehlerhaften Load Balancer zugreifen, auch nachdem das DNS ein Failover zu anderen Regionen durchgeführt hat.
Schwellenwerte für Systemdiagnosen konfigurieren: Konfigurieren Sie die Parameter für die Schwellenwerte „Fehlerfrei“ und „Fehlerhaft“, um unnötige Failovers und abrupte Weiterleitungen von Traffic zu vermeiden, die durch vorübergehende Fehler verursacht werden. Höhere Schwellenwerte erhöhen die Zeit, die für die Umleitung des Traffics zu Load-Balancern in anderen Regionen benötigt wird.
Trickle-Traffic für die Aktiv/Passiv-Validierung verwenden: Konfigurieren Sie in Aktiv/Passiv-Einrichtungen das Flag
--backup-data-trickle-ratioso, dass während des Steady State kontinuierlich ein kleiner Prozentsatz des Traffics (z. B.0.1) an den regionalen Backup-Load-Balancer gesendet wird. So wird überprüft, ob die Sicherungsinfrastruktur aktiv ist und Traffic während eines Failover-Ereignisses verarbeiten kann.