


Um sich vor Infrastrukturausfällen oder Konfigurationsfehlern zu schützen, können Sie Failover-Strategien für globale externe Application Load Balancer entwickeln. Bei diesen Strategien werden regionale externe Application Load Balancer verwendet und der Traffic wird von einem globalen externen Application Load Balancer an diese weitergeleitet, um die Hochverfügbarkeit bei globalen Infrastrukturausfällen oder Konfigurationsfehlern aufrechtzuerhalten.
In einer Failover-Architektur stellen Sie einen primären Load-Balancer und einen oder mehrere Ersatz-Load-Balancer bereit:
- Der primäre Load Balancer ist der globale externe Application Load Balancer, der den Clienttraffic im Normalbetrieb verarbeitet.
- Der Ersatz-Load-Balancer ist ein regionaler externer Application Load Balancer, der Traffic empfängt, wenn der primäre Load Balancer Systemdiagnosen nicht besteht.
Failover und Failback sind automatische Prozesse für das Weiterleiten von Traffic:
- Ein Failover tritt auf, wenn Cloud DNS einen Ausfall erkennt und den Traffic vom primären Load Balancer an die Ersatz-Load Balancer weiterleitet.
- Ein Failback erfolgt, wenn Cloud DNS dieses Routing umkehrt und Traffic nach bestandenen Systemdiagnosen an den primären Load Balancer weiterleitet.
In diesem Dokument wird der Failover von einem globalen externen Application Load Balancer zu regionalen Backup-Load Balancern beschrieben. Wenn Sie Failover zwischen regionalen externen Application Load Balancern in verschiedenen Regionen konfigurieren möchten, lesen Sie den Abschnitt Hochverfügbarkeit für regionale externe Application Load Balancer.
Gründe für die Verwendung regionaler Load Balancer für das Failover
Regionale externe Application Load Balancer sind als Failover-Load-Balancer für globale externe Application Load Balancer ideal, da sie folgende Eigenschaften haben:
- Regionale externe Application Load Balancer sind in einzelnenGoogle Cloud -Regionen abgeschlossen und auch von allen globalen externen Application Load Balancer-Infrastrukturen isoliert, die in derselben Region ausgeführt werden.
- Regionale externe Application Load Balancer und globale externe Application Load Balancer basieren beide auf Envoy-Proxys und verarbeiten Traffic auf ähnliche Weise.
Wenn Sie ein Global-auf-Regional-Failover für globale externe Application Load Balancer implementieren möchten, erstellen Sie zwei oder mehr regionale externe Application Load Balancer in den Regionen, in die der Traffic beim Failover geleitet werden soll.
Failover-Strategien
Sie können Failover für globale externe Application Load Balancer mit den folgenden Strategien implementieren:
- Aktiv/Passiv (globales zu regionales Failover): Sie stellen einen oder mehrere regionale externe Application Load Balancer nur zu Sicherungszwecken bereit. Im stabilen Zustand wird Cloud DNS in die IP-Adresse des globalen externen Application Load Balancers aufgelöst. Wenn der globale Load Balancer ausfällt, leitet Cloud DNS den Traffic an die regionalen Backup-Load Balancer weiter. Bei dieser Konfiguration wird eine Failover-Routingrichtlinie von Cloud DNS verwendet.
- Aktiv/aktiv (global-zu-regional-Umgehung): Ein globaler externer Application Load Balancer fungiert als Edge-Frontend, das Cloud CDN-Funktionen wie Edge-Caching bietet und Anfragen an regionale externe Application Load Balancer weiterleitet. Dazu werden Internet-NEGs (Network Endpoint Groups) mit vollständig qualifizierten Domainnamen (Fully Qualified Domain Names, FQDNs) verwendet. Im stabilen Zustand fließt der Traffic sequenziell durch beide Load-Balancing-Ebenen. Dies kann mit einer Cloud DNS-Routingrichtlinie zur Standortbestimmung konfiguriert werden. Wenn der globale Load Balancer einen Ausfall hat, umgehen DNS-Routingrichtlinien die globale Ebene und leiten den Client-Traffic direkt an die regionalen Load Balancer weiter.
Wenn Ihre Architektur nicht auf kapazitätsbewusstem globalen Backend-Load-Balancing basiert, sollten Sie die Active-Active-Strategie bevorzugen. Wenn Ihre Anwendung jedoch explizit ein globales Backend-Load-Balancing erfordert, um Traffic basierend auf der Backend-Kapazität über Regionen hinweg zu verteilen und zu übertragen, implementieren Sie die Aktiv-Passiv-Strategie.
Vergleich von Failover-Strategien
In der folgenden Tabelle werden die Aktiv/Passiv- und Aktiv/Aktiv-Failover-Strategien verglichen:
| Strategieattribut | Aktiv/Passiv | Aktiv/Aktiv |
|---|---|---|
| Stationärer Verkehrsfluss | Client → Globaler externer Application Load Balancer → Backend | Client → Globaler externer Application Load Balancer → Regionaler externer Application Load Balancer → Backend |
| Traffic-Flow im Fehlerstatus | Client → Regionaler externer Application Load Balancer → Backend. Der Dienst ist weiterhin verfügbar, es kann jedoch aufgrund des Verlusts der Edge-Leistungsvorteile zu einer höheren Latenz kommen. |
Client → Regionaler externer Application Load Balancer → Backend (Umgehung des globalen externen Application Load Balancers). Der Dienst ist weiterhin verfügbar, es kann jedoch aufgrund des Verlusts der Edge-Leistungsvorteile zu einer höheren Latenz kommen. |
| Konfigurationsverwaltung | Erfordert die Synchronisierung unabhängiger Konfigurationen für globale und regionale Load-Balancer. | Die globale Ebene erfordert nur eine minimale Konfiguration, da sich die meiste Anwendungslogik auf regionalen Load Balancern befindet. Sie müssen jedoch Edge-Sicherheitsrichtlinien (Cloud Armor) und die Konfiguration für die Verbindungsbeendigung (TLS-Zertifikate) auf beiden Ebenen duplizieren. |
| Zuverlässigkeitsprüfung | Der regionale externe Application Load Balancer ist im stabilen Zustand im Leerlauf. Regelmäßige Tests oder DNS-Trickle-Traffic werden empfohlen. | Der Steady-State-Traffic testet den regionalen externen Application Load Balancer kontinuierlich. Es wird empfohlen, den regionalen Load Balancer regelmäßig zu testen oder ihm direkt wenig Traffic zuzuweisen. |
| Sicherheit bei der schrittweisen Bereitstellung | Konfigurationsänderungen für globale externe Application Load Balancer werden global angewendet. Änderungen am regionalen externen Application Load Balancer sind isoliert, aber der Steady-State-Traffic testet sie nicht. | Sie können Änderungen am regionalen externen Application Load Balancer schrittweise vornehmen, Region für Region. Wenn eine Region ausfällt, leitet die globale Ebene den Traffic automatisch an fehlerfreie Regionen weiter. |
| Globales Backend-Load-Balancing | Unterstützt Der globale externe Application Load Balancer kann Traffic basierend auf der Kapazität auf Backends in verschiedenen Regionen verteilen. |
Begrenzt Der globale externe Application Load Balancer leitet den Traffic an den nächstgelegenen regionalen externen Application Load Balancer weiter. Der regionale Load-Balancer gleicht den Traffic nur lokal aus und leitet ihn nicht regionsübergreifend basierend auf der Backend-Kapazität weiter. |
| Kosten und Abrechnung | Gebühren für die Datenverarbeitung fallen für eine einzelne Load-Balancing-Ebene an. Im stabilen Zustand fallen Kosten für den globalen externen Application Load Balancer an. Gebühren für den regionalen externen Application Load Balancer fallen nur bei Tests oder Failover-Ereignissen an. | Für beide Load-Balancing-Ebenen fallen gleichzeitig Gebühren für die Datenverarbeitung an, da der Traffic im Steady State sowohl durch die globale als auch durch die regionale Ebene fließt. |
| Empfohlener Anwendungsfall | Arbeitslasten, die ein erweitertes globales Backend-Load-Balancing und ein kapazitätsbasiertes Traffic-Spilling über Regionen hinweg erfordern. | Arbeitslasten, die auf regionaler Isolation basieren und die globale Ebene für Edge-Leistung und Caching nutzen. |
Aktiv/Passiv-Strategie
Bei einer Aktiv/Passiv-Konfiguration stellen Sie unabhängige regionale externe Application Load Balancer in einer oder mehreren Regionen neben Ihrem primären globalen externen Application Load Balancer oder klassischen Application Load Balancer bereit.
So funktioniert das Aktiv/Passiv-Failover
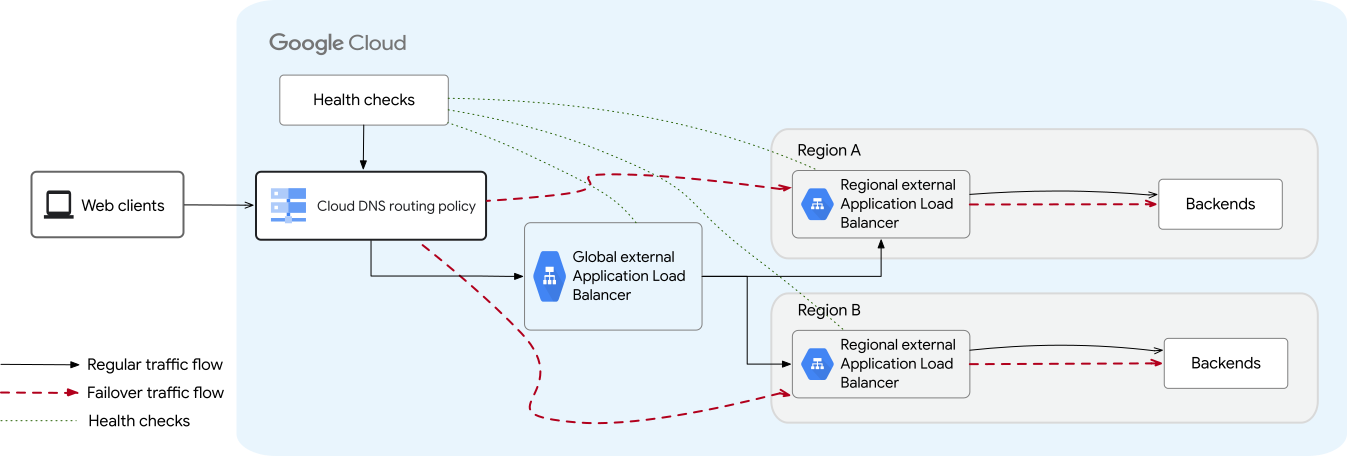
Die folgende Einrichtung zeigt den Failover von einem globalen externen Application Load Balancer zu zwei regionalen externen Application Load Balancern, die sich in je einer in den beiden Regionen befindet, in denen der globale Load Balancer Backends bereitgestellt hat.

Das Aktiv/Passiv-Failover folgt diesem Workflow:
- Steady State: Cloud DNS leitet den gesamten Client-Traffic an den globalen externen Application Load Balancer weiter.
- Fehlererkennung: Google Cloud Verwendet Systemdiagnosen, die mit drei Quellregionen konfiguriert sind, um zu erkennen, ob der primäre Load Balancer fehlerfrei arbeitet. Wenn Systemdiagnosen aus zwei oder mehr Quellregionen fehlschlagen, löst Cloud DNS ein Failover aus.
- Failover: Cloud DNS-Failover-Routingrichtlinien leiten Clienttraffic direkt an die regionalen externen Ersatz-Application Load Balancer weiter. Auswirkungen auf die Latenz während des Failovers:Da regionale externe Application Load Balancer Verbindungen in einer bestimmten Google Cloud Region beenden, kann es bei Clients, die sich weit entfernt von der Zielregion befinden, während des Failovers zu einer erhöhten Latenz und Round-Trip-Zeit (RTT) kommen.
- Failback: Nachdem die Systemdiagnosen wieder erfolgreich sind, leitet Cloud DNS den Traffic automatisch wieder an den primären Load Balancer weiter. Da beide Load Balancer Traffic bereitstellen, kommt es zu keinen Ausfallzeiten.
Aktiv/Aktiv-Strategie (globale zu regionale Umgehung)
Bei einer Active-Active-Strategie verwendet der globale externe Application Load Balancer ein Internet-FQDN-NEG (INTERNET_FQDN_PORT), um Traffic an regionale externe Application Load Balancer in zwei oder mehr Regionen zu senden.
So funktioniert der Aktiv/Aktiv-Bypass
Die folgende Einrichtung zeigt den Failover von einem globalen externen Application Load Balancer zu zwei regionalen externen Application Load Balancern, die sich in je einer in den beiden Regionen befindet, in denen der globale Load Balancer Backends bereitgestellt hat.
Der Active-Active-Failover folgt diesem Workflow:
- Stabiler Zustand: Der Traffic fließt vom Client zum globalen externen Application Load Balancer.
Der globale Load Balancer verwendet eine Internet-NEG (Netzwerk-Endpunktgruppe) vom Typ
INTERNET_FQDN_PORTmit FQDN, um Traffic an die nächstgelegenen regionalen externen Application Load Balancer weiterzuleiten. Die regionalen Load Balancer leiten den Traffic dann an lokale Back-Ends weiter. - Fehlererkennung: Wenn im stabilen Zustand ein einzelner regionaler externer Application Load Balancer oder seine Region ausfällt, erkennt der globale externe Application Load Balancer den Fehler mithilfe der Cloud DNS-Systemdiagnoserichtlinie für das Internet-NEG. Der globale Load-Balancer leitet den Traffic automatisch von der fehlerhaften Region zu fehlerfreien regionalen Load-Balancern um.
- Umgehen: Wenn der globale externe Application Load Balancer einen Ausfall hat, erkennen Cloud DNS-Failover-Richtlinien den Fehler und leiten den Traffic direkt an die regionalen externen Application Load Balancer weiter. Die globale Ebene wird dabei vollständig umgangen. Auswirkungen auf die Latenz bei Umgehung: Der globale externe Application Load Balancer bietet Edge-Leistungsvorteile wie das Beenden von Verbindungen näher an den Nutzern und Edge-Caching. Wenn der Traffic den globalen Load Balancer umgeht, werden Clientverbindungen direkt mit den regionalen VIPs hergestellt. Dies kann die Verbindungs- und RTT-Latenz für geografisch entfernte Clients erhöhen.
- Failback: Wenn der globale Load Balancer aufeinanderfolgende Systemdiagnosen besteht, gibt Cloud DNS automatisch wieder die globale Anycast-VIP in DNS-Antworten zurück und stellt so die globale Edge-Routing-Ebene wieder her.
Konfiguration des primären Load Balancers prüfen
Bevor Sie das Failover konfigurieren, prüfen Sie, ob der regionale externe Ersatz-Application Load Balancer die vom primären Load Balancer verwendeten Funktionen unterstützt.
- Im Aktiv/Passiv-Modus muss der regionale Ersatz-Load Balancer ähnliche Funktionen unterstützen, um den Traffic bei einem Ausfall nahtlos zu übernehmen.
- Im Aktiv-Aktiv-Modus müssen die wichtigsten Routing- und Sicherheitsregeln direkt auf der regionalen Ebene konfiguriert werden. Globale Edge-Funktionen wie Cloud CDN werden bei einem globalen Ausfall umgangen.
| Funktion | Anforderungen an kompatible Geräte |
|---|---|
| Google Kubernetes Engine-Bereitstellungen | Verwenden Sie GKE Gateway, um sowohl den primären als auch den Ersatz-Load-Balancer bereitzustellen. Das liegt daran, dass mit GKE Gateway bereitgestellte Load-Balancer mit diesem Failover-Mechanismus besser kompatibel sind als Load-Balancer, die mit dem GKE-Ingress-Controller bereitgestellt werden. Der GKE-Ingress-Controller unterstützt nur den klassischen Application Load Balancer. |
| Cloud CDN | Regionale externe Application Load Balancer unterstützen Cloud CDN nicht. Bei einem Failover sind Vorgänge betroffen, die auf Cloud CDN angewiesen sind. |
| Cloud Armor | Wenn Sie Cloud Armor für den primären Load Balancer verwenden, konfigurieren Sie entsprechende regionale Cloud Armor-Sicherheitsrichtlinien für die Ersatz-Load Balancer. Cloud Armor bietet unterschiedliche Funktionen im regionalen und globalen Bereich. Weitere Informationen finden Sie unter Regionale Cloud Armor-Sicherheitsrichtlinien und Globale Cloud Armor-Sicherheitsrichtlinien. |
| SSL-Zertifikate | Prüfen Sie, ob der vom primären Load-Balancer verwendete SSL-Zertifikatstyp mit dem regionalen externen Ersatz-Application Load Balancer kompatibel ist. Sehen Sie sich die Unterschiede zwischen den SSL-Zertifikaten an, die für globale, regionale und klassische Load Balancer verfügbar sind. Weitere Informationen finden Sie unter Compute Engine-SSL-Zertifikate und Zertifikatmanager-SSL-Zertifikate. |
Überlegungen zu regionalen Load-Balancern
Konfigurieren und stellen Sie regionale externe Application Load Balancer in der Region bereit, in die der Traffic bei einem Fehler weitergeleitet werden soll.
Beachten Sie beim Konfigurieren Ihres regionalen Load Balancers die folgenden Überlegungen zu Failover- oder Bypass-Architekturen:
Sie müssen die Features des regionalen externen Ersatz-Application Load Balancers so konfigurieren, dass sie dem primären Load Balancer so ähnlich wie möglich sind, damit der Traffic in beiden Bereitstellungen ähnlich verarbeitet wird.
Globale externe Application Load Balancer. Die regionalen externen Application Load Balancer unterstützen die meisten Funktionen der globalen externen Application Load Balancer, mit einigen Ausnahmen. Regionale Load Balancer unterstützen außerdem dieselben erweiterten Funktionen zur Trafficverwaltung wie globale Load Balancer. So lässt sich die Gleichwertigkeit zwischen dem primären und dem Ersatz-Load Balancer leichter erreichen.
Klassische Application Load Balancer. Bei klassischen Application Load Balancern ist es schwieriger, die Funktionsparität zwischen dem primären und dem Ersatz-Load Balancer zu erreichen, da regionale externe Application Load Balancer Envoy-basierte Load Balancer sind, die Traffic anders verarbeitet. Testen Sie Failover und Failback gründlich, bevor Sie diese in der Produktion nutzen.
Die spezifischen Funktionen der regionalen, globalen und klassischen Application Load Balancer finden Sie auf der Seite Load-Balancer-Features im Vergleich.
Wir empfehlen die Verwendung eines Automatisierungsframeworks wie Terraform, um die Konsistenz der Load-Balancer-Konfigurationen sowohl in primären als auch in Backup-Bereitstellungen zu erreichen und aufrechtzuerhalten.
Regionale externe Application Load Balancer unterstützen sowohl die Premium- als auch die Standard-Netzwerkdienststufen. Wenn die Latenz während des Failovers nicht Ihr Hauptanliegen ist, empfehlen wir, die regionalen externen Ersatz-Application Load Balancer in der Standardstufe einzurichten. Die Verwendung der Standardstufe bietet zusätzliche Isolation von der Premium-Stufe, die von globalen externen Application Load Balancern verwendet wird.
Achten Sie darauf, dass das Nur-Proxy-Subnetz groß genug ist, um den erhöhten Traffic bei einem Failover aufzunehmen, ohne andere regionale Load Balancer in derselben Region und demselben Netzwerk zu beeinträchtigen. Weitere Informationen finden Sie unter Zusätzliche Nur-Proxy-Subnetzkapazität reservieren.
Informationen zum Konfigurieren eines regionalen externen Application Load Balancers finden Sie unter Regionalen externen Application Load Balancer mit VM-Instanzgruppen-Back-Ends einrichten.
Zusätzliche Kapazität für Nur-Proxy-Subnetze reservieren
Alle regionalen Envoy-basierten Load Balancer in einer Region und einem VPC-Netzwerk verwenden denselben Pool an Envoy-Proxys. Bei einem Failover steigt die Proxy-Nutzung der regionalen externen Ersatz-Application Load Balancer, um den Failover-Traffic des primären Load Balancers zu verarbeiten. Durch das Reservieren von ausreichend Proxy-Kapazität wird sichergestellt, dass Failover keine anderen regionalen Envoy-basierten Load Balancer in derselben Region und demselben Netzwerk beeinträchtigen.
Damit für die Ersatz-Load Balancer immer genügend Kapazität verfügbar ist, sollten Sie die Größe Ihres Nur-Proxy-Subnetzes prüfen. Wir empfehlen, die geschätzte Anzahl der Proxys zu berechnen, die zum Verarbeiten von Traffic in einer bestimmten Region erforderlich sind, und die Kapazität bei Bedarf zu erhöhen. Weitere Informationen zu den Kapazitätslimits für Proxys und zu Größenberechnungen finden Sie im Abschnitt Proxy instance charge (Gebühr für Proxyinstanzen) unter „Cloud Load Balancing pricing“ (Cloud Load Balancing – Preise).
Wenn Sie mithilfe von DNS-Richtlinien den Traffic auf mehrere Ersatz-Load Balancer in verschiedenen Regionen aufteilen, müssen Sie dies bei der Schätzung der Proxyanforderungen pro Region und Netzwerk berücksichtigen. Ein größeres Nur-Proxy-Subnetz ermöglicht esGoogle Cloud , Ihrem Load Balancer bei Bedarf eine größere Anzahl von Envoy-Proxys zuzuweisen.
Sie können ein Nur-Proxy-Subnetz nicht auf dieselbe Weise erweitern wie bei einem primären Adressbereich (mit dem expand-ip-range-Befehl). Stattdessen müssen Sie ein Nur-Proxy-Subnetz als Sicherung erstellen, das Ihren Anforderungen entspricht, und es dann zur aktiven Rolle hochstufen.
Informationen zum Ändern der Größe Ihres Nur-Proxy-Subnetzes finden Sie unter Größe oder Adressbereich eines Nur-Proxy-Subnetzes ändern.
Backends zwischen primären und Ersatz-Load-Balancern freigeben
Um eine vollständige infrastrukturelle Redundanz zu erreichen, müssen Sie sowohl auf Load Balancer- als auch auf Backend-Ebene für Redundanz sorgen. Das bedeutet, dass Sie Ihre regionalen externen Ersatz-Application Load Balancer mit Backends (Instanzgruppen oder Netzwerk-Endpunktgruppen) konfigurieren müssen, die sich nicht mit den primären Load-Balancern überschneiden.
Wenn Sie stattdessen dieselben Backends sowohl für den primären als auch für den Ersatz-Load Balancer verwenden möchten, müssen Sie jeden regionalen externen Ersatz-Application Load Balancer in der Region erstellen, in der sich die Backends befinden. Wenn die automatische Skalierung für die Instanzgruppen aktiviert ist, müssen die folgenden Anforderungen erfüllt werden, damit ein ordnungsgemäßer Failover erfolgt:
- Konfigurieren Sie den Autoscaler nur mit CPU-basiertem Autoscaling. Autoscaling auf Basis der Load-Balancer-Auslastung wird nicht unterstützt.
- Sowohl die globalen als auch die regionalen Backend-Dienste dürfen nur den Balancing-Modus
UTILIZATIONverwenden. Verwenden Sie nicht den Balancing-ModusRATE, da Ihre Instanzen während des Failover-Prozesses die doppelte Menge an Traffic von globalen und regionalen Load Balancern erhalten können. - Konfigurieren Sie die Steuerelemente für die Herunterskalierung, um zu verhindern, dass der Autoscaler die Gruppe während der Ausfallzeit vorzeitig herunterskaliert, wenn der Traffic vom globalen Load Balancer zum regionalen Load Balancer umgeleitet wird. Diese Ausfallzeit kann so lang wie die Summe aus DNS-TTL (Time to Live) und dem konfigurierten Intervall für den Health-Check sein.
Wenn das Autoscaling nicht korrekt eingerichtet wird, kann das während des Failovers einen sekundären Ausfall bedingen, da der Traffic-Verlust vom globalen Load-Balancer dazu führt, dass die Instanzgruppe schnell verkleinert wird, bevor der regionale Load-Balancer die Steuerung übernimmt.
Aktiv/Passiv-Failover konfigurieren
So konfigurieren Sie das Aktiv/Passiv-Failover:
- Architekturüberlegungen: Bevor Sie Ressourcen erstellen, sollten Sie die Überlegungen zu regionalen Load Balancern lesen, um die Funktionskompatibilität, die Proxykapazität und die Anforderungen an das Autoscaling für freigegebene Backends zu prüfen.
- Primären Load Balancer konfigurieren: Richten Sie Ihren globalen externen Application Load Balancer mit Backend-Diensten ein, die auf eine oder mehrere Regionen verteilt sind. Weitere Informationen zum Konfigurieren eines globalen externen Application Load Balancers finden Sie unter Globalen externen Application Load Balancer einrichten.
- Konfiguration des primären Load Balancers prüfen: Prüfen Sie, ob die vom primären Load Balancer verwendeten Funktionen (z. B. Sicherheitsfunktionen, Funktionen zur Traffic-Verwaltung und Routingfunktionen sowie Cloud CDN) auch für den regionalen externen Ersatz-Application Load Balancer verfügbar sind. Sind keine ähnlichen Features verfügbar, ist dieser Load-Balancer möglicherweise kein guter Kandidat für ein Failover.
- Regionale externe Application Load Balancer zur Sicherung konfigurieren: Richten Sie unabhängige regionale externe Application Load Balancer in den Regionen ein, in denen der Traffic beim Failover geleitet werden soll. Informationen zum Konfigurieren eines regionalen externen Application Load Balancers finden Sie unter Regionalen externen Application Load Balancer mit VM-Instanzgruppen-Back-Ends einrichten.
- DNS-Routing und Systemdiagnosen konfigurieren: Erstellen Sie eine Systemdiagnose für den primären Load Balancer und konfigurieren Sie eine Cloud DNS-Failover-Routingrichtlinie, um Ausfälle zu erkennen und Clienttraffic an regionale Ersatz-Load Balancer weiterzuleiten.
Aktiv/Aktiv-Bypass konfigurieren
So konfigurieren Sie die Active-Active-Architektur:
Architekturaspekte prüfen: Bevor Sie Ressourcen erstellen, sollten Sie die Aspekte für regionale Load Balancer prüfen, um die Funktionskompatibilität zu ermitteln und sicherzustellen, dass die Kapazität Ihres Nur-Proxy-Subnetzes den Steady-State- und Failover-Traffic bewältigen kann.
Regionale externe Application Load Balancer konfigurieren: Bevor Sie regionale Load Balancer konfigurieren, lesen Sie die Funktionskompatibilität und ‑beschränkungen. Stellen Sie regionale externe Application Load Balancer in zwei oder mehr Regionen mit Ihren Backend-Diensten, externen IP-Adressen, SSL-Zertifikaten und regionalen Cloud Armor-Sicherheitsrichtlinien bereit. Eine Einrichtungsanleitung finden Sie unter Regionalen externen Application Load Balancer mit VM-Instanzgruppen-Back-Ends einrichten.
DNS für regionale Load-Balancer konfigurieren: Erstellen Sie einen DNS-Eintrag (z. B.
regional-api.example.com), der mithilfe einer Routingrichtlinie für Standortbestimmung oder Latenz auf die externen IP-Adressen Ihrer regionalen externen Application Load Balancer verweist. Aktivieren Sie die DNS-Systemdiagnose für diesen Datensatz, um einen Fehler in einer bestimmten Region zu erkennen und den Traffic automatisch von dieser Region zu anderen fehlerfreien Regionen weiterzuleiten.Globalen externen Application Load Balancer konfigurieren: Reservieren Sie eine globale externe IP-Adresse und erstellen Sie eine globale Internet-Netzwerk-Endpunktgruppe (NEG) vom Typ
INTERNET_FQDN_PORT. Fügen Sie der Internet-NEG einen Endpunkt hinzu, der auf den FQDN des regionalen DNS-Eintrags verweist, z. B.regional-api.example.com. Konfigurieren Sie einen Backend-Dienst für den globalen externen Application Load Balancer, hängen Sie die Internet-NEG an und aktivieren Sie bei Bedarf Cloud CDN oder Cloud Armor. Konfigurieren Sie die URL-Zuordnung, den HTTP(S)-Zielproxy und die globale Weiterleitungsregel.DNS für Failover und Systemdiagnosen konfigurieren: Erstellen Sie den DNS-Eintrag für den Hauptdienst (z. B.
api.example.com) mit einerFAILOVER-Routingrichtlinie. Prüfen Sie, ob der Datensatz einen primären Endpunkt hat, der auf die IP-Adresse des globalen externen Application Load Balancers verweist, und Backup-Endpunkte, die auf die IP-Adressen der externen IP-Adressen der regionalen externen Application Load Balancer verweisen. Konfigurieren Sie einen DNS-Health-Check, um den globalen externen Application Load Balancer zu überwachen.
Best Practices
Beachten Sie beim Konfigurieren des Cloud DNS-Eintrags und der Systemdiagnosen die folgenden Best Practices:
Ausfalldauer berechnen: Die Zeit, die für das Failover des Traffics vom primären zum Ersatz-Load Balancer benötigt wird, hängt vom DNS-TTL-Wert, dem Intervall der Systemdiagnose und dem Parameter Fehlerschwellenwert der Systemdiagnose ab:
Mit Cloud DNS von Google kann die Obergrenze für diesen Zeitraum mit der folgenden Formel berechnet werden:
Duration of outage = DNS TTL + Health Check Interval * Unhealthy ThresholdLegen Sie die DNS-TTL auf 30–60 Sekunden fest. Höhere TTL-Werte führen zu längeren Failover-Zeiten, da Clients im Internet weiterhin auf die primären externen Application Load Balancer zugreifen, auch nachdem das DNS ein Failover zum regionalen externen Ersatz-Application Load Balancer durchgeführt hat.
Schwellenwerte für die Systemdiagnose konfigurieren: Legen Sie die Parameter Schwellenwert für fehlerfrei und fehlerhaft fest, um Failovers zu vermeiden, die durch vorübergehende Netzwerkfehler verursacht werden. Höhere Schwellenwerte erhöhen die Zeit, die für das Failover des Traffics zu Ersatz-Load-Balancern benötigt wird.
Trickle-Traffic zur Validierung verwenden: Konfigurieren Sie das Flag
--backup-data-trickle-ratioso, dass kontinuierlich ein kleiner Prozentsatz des Traffics an die Ersatz-Load Balancer gesendet wird, auch wenn die primären Load Balancer fehlerfrei sind. So wird sichergestellt, dass die Backup-Infrastruktur aktiv und bereit ist, Traffic zu verarbeiten. Sie können den Prozentsatz des Traffics, der an die Backup-Load-Balancer gesendet wird, als Bruch zwischen 0 und 1 konfigurieren. Der typische Wert ist 0, 1.Mit Cloud DNS können Sie jedoch 100 % des Traffics an die VIP-Ersatzadressen senden, um einen Failover manuell auszulösen.Failover und Failback regelmäßig testen: Nehmen Sie Failover-Tests in Ihren Notfallwiederherstellungsplan auf. Prüfen Sie sowohl allmähliche als auch plötzliche Traffic-Verschiebungen vom primären zum Ersatz-Load Balancer und ob der Traffic nach dem Failback reibungslos zum primären Load Balancer zurückkehrt.