


La distribution d'identifiants pour le catalogue d'environnements d'exécution Lakehouse vous permet de déléguer l'accès Cloud Storage aux moteurs de requête et d'appliquer des stratégies IAM (Identity and Access Management) précises au niveau du catalogue, de l'espace de noms et de la table à l'aide de la console Google Cloud ou de la Google Cloud CLI. La distribution d'identifiants est également requise pour activer la gestion automatique des tables pour les tâches de maintenance en arrière-plan telles que le compactage, l'expiration des instantanés et la récupération de mémoire.
Fonctionnement de la distribution d'identifiants
Lorsque vous utilisez la distribution d'identifiants, la séquence d'opérations change légèrement pour appliquer les règles avant l'accès au stockage. Le schéma suivant illustre la manière dont les moteurs de requête obtiennent des jetons de stockage à champ d'application réduit à partir du catalogue pour lire et écrire des données de manière sécurisée directement dans Cloud Storage :
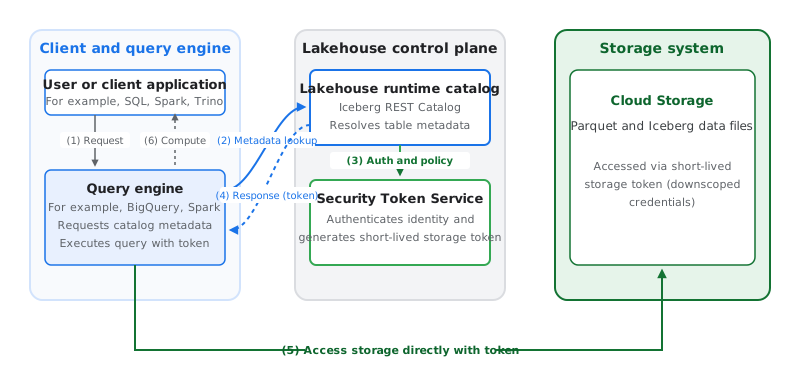
La séquence d'opérations illustrée dans le schéma précédent est la suivante :
- Requête : un utilisateur envoie une instruction SQL, telle qu'une requête, une opération LMD ou une opération LDD, à un moteur compatible tel qu'Apache Spark ou BigQuery.
- Recherche de métadonnées : le moteur envoie une requête au catalogue d'exécution Lakehouse pour résoudre la table.
- Authentification et stratégie : le catalogue authentifie l'utilisateur et vérifie ses autorisations IAM sur les ressources Lakehouse.
- Réponse : Comme la distribution d'identifiants est activée, le catalogue renvoie les métadonnées et un jeton de stockage de courte durée (identifiants de stockage à champ d'application réduit) au moteur. Le jeton est limité aux chemins d'accès associés à la table et aux autorisations minimales requises (par exemple, l'accès en lecture seule pour les requêtes qui n'ont pas besoin d'écrire des fichiers).
- Accès : le moteur utilise ce jeton pour lire ou écrire les fichiers autorisés spécifiques directement depuis Cloud Storage.
- Calcul : le moteur traite les données ou exécute l'opération, puis renvoie les résultats.
Lorsque la gestion automatique des tables (gcp.biglake.table-management.enabled) est activée, les tâches de maintenance en arrière-plan telles que la compaction, l'expiration des instantanés et la récupération de mémoire utilisent le compte de service provisionné automatiquement du catalogue pour s'authentifier directement auprès de Cloud Storage et mettre à jour les fichiers de données sous-jacents.
Moteurs compatibles
Pour utiliser la distribution d'identifiants avec des moteurs de requête, vous devez configurer le point de terminaison du catalogue REST Apache Iceberg dans votre catalogue d'environnements d'exécution Lakehouse afin qu'il accepte la distribution d'identifiants. La distribution d'identifiants n'est pas compatible avec les points de terminaison de catalogue Apache Hive.
- Moteurs Open Source : les moteurs compatibles tels que Spark et Trino utilisent des jetons de stockage de courte durée fournis par le catalogue. Votre application cliente doit spécifier la compatibilité avec la distribution d'identifiants dans l'en-tête
X-Iceberg-Access-Delegation. - BigQuery : BigQuery utilise des identifiants vendus pour l'accès à Cloud Storage au lieu des identifiants de l'utilisateur final.
Autorisations de compte de service requises
Lorsque la distribution d'identifiants est activée, assurez-vous que les comptes de service suivants disposent des rôles nécessaires :
- Compte de service du catalogue d'environnements d'exécution Lakehouse provisionné automatiquement : vous devez attribuer le rôle Utilisateur d'objets Storage (
roles/storage.objectUser) à ce compte sur tous les buckets Cloud Storage associés. Sans cet accès, les identifiants vendus ne peuvent pas lire ni écrire dans l'espace de stockage. Si vous utilisez la console Google Cloud , cliquez sur Définir les autorisations du bucket pour vérifier ce rôle. Pour gcloud CLI, Terraform ou l'API, vous devez attribuer ce rôle manuellement. - Comptes de service du moteur de requête : les comptes de service exécutant des jobs de moteur de requête (tels que Managed Service pour Apache Spark, Managed Service pour Apache Spark ou Dataflow) nécessitent le rôle Éditeur BigLake (
roles/biglake.editor) pour obtenir des identifiants vendus avec un champ d'application en écriture.
Étapes suivantes
- Découvrez comment créer un catalogue en mode de distribution d'identifiants.
- Découvrez comment activer la distribution d'identifiants pour un catalogue existant à l'aide de la consoleGoogle Cloud .
- Découvrez comment configurer votre application cliente pour la distribution d'identifiants.