


En esta página, se explica cómo migrar la configuración de GKE Inference Gateway de la
API de v1alpha2 en versión preliminar a la API de v1 con disponibilidad general.
Este documento está dirigido a los administradores de plataformas y especialistas en redes que usan la versión v1alpha2 de GKE Inference Gateway y desean actualizar a la versión v1 para usar las funciones más recientes.
Antes de comenzar la migración, asegúrate de conocer los conceptos y la implementación de GKE Inference Gateway. Te recomendamos que revises Implementa GKE Inference Gateway.
Antes de comenzar
Antes de comenzar la migración, determina si necesitas seguir esta guía.
Verifica si existen APIs de v1alpha2
Para verificar si usas la API de v1alpha2 GKE Inference Gateway, ejecuta los siguientes comandos:
kubectl get inferencepools.inference.networking.x-k8s.io --all-namespaces
kubectl get inferencemodels.inference.networking.x-k8s.io --all-namespaces
El resultado de estos comandos determina si necesitas migrar:
- Si alguno de los comandos devuelve uno o más recursos
InferencePooloInferenceModel, significa que estás usando la API dev1alpha2y debes seguir esta guía. - Si ambos comandos devuelven
No resources found, no estás usando la API dev1alpha2. Puedes continuar con una instalación nueva de lav1GKE Inference Gateway.
Rutas de migración
Existen dos rutas para migrar de v1alpha2 a v1:
- Migración simple (con tiempo de inactividad): Esta ruta es más rápida y sencilla, pero genera un breve período de inactividad. Es la ruta recomendada si no necesitas una migración sin tiempo de inactividad.
- Migración sin tiempo de inactividad: Esta ruta es para los usuarios que no pueden permitirse ninguna interrupción del servicio. Implica ejecutar las pilas de
v1alpha2yv1en paralelo y cambiar el tráfico de forma gradual.
Migración simple (con tiempo de inactividad)
En esta sección, se describe cómo realizar una migración simple con tiempo de inactividad.
Borra los recursos de
v1alpha2existentes: Para borrar los recursos dev1alpha2, elige una de las siguientes opciones:Opción 1: Desinstala con Helm
helm uninstall HELM_PREVIEW_INFERENCEPOOL_NAMEOpción 2: Borra los recursos de forma manual
Si no usas Helm, borra de forma manual todos los recursos asociados con tu implementación de
v1alpha2:- Actualiza o borra el
HTTPRoutepara quitar elbackendRefque apunta alv1alpha2InferencePool. - Borra el
v1alpha2InferencePool, todos los recursosInferenceModelque lo señalen y la Deployment y el servicio correspondientes del Selector de extremos (EPP).
Después de borrar todos los recursos personalizados de
v1alpha2, quita las definiciones de recursos personalizados (CRD) de tu clúster:kubectl delete -f https://github.com/kubernetes-sigs/gateway-api-inference-extension/releases/download/v0.3.0/manifests.yaml- Actualiza o borra el
Instala recursos de la versión 1: Después de limpiar los recursos anteriores, instala la
v1GKE Inference Gateway. Este proceso implica lo siguiente:- Instala las nuevas
v1definiciones de recursos personalizados (CRD). - Crea un
v1InferencePoolnuevo y los recursosInferenceObjectivecorrespondientes. El recursoInferenceObjectiveaún se define en la API dev1alpha2. - Crea un
HTTPRoutenuevo que dirija el tráfico a tuv1InferencePoolnuevo.
- Instala las nuevas
Verifica la implementación: Después de unos minutos, verifica que tu nueva pila de
v1esté entregando tráfico de forma correcta.Confirma que el estado de la puerta de enlace sea
PROGRAMMED:kubectl get gateway -o wideEl resultado debe ser similar a este:
NAME                CLASS                            ADDRESS        PROGRAMMED   AGE
inference-gateway   gke-l7-regional-external-managed   <IP_ADDRESS>   True         10m
Verifica el extremo enviando una solicitud:
IP=$(kubectl get gateway/inference-gateway -o jsonpath='{.status.addresses[0].value}')
PORT=80
curl -i ${IP}:${PORT}/v1/completions -H 'Content-Type: application/json' -d '{"model": "<var>YOUR_MODEL</var>","prompt": "<var>YOUR_PROMPT</var>","max_tokens": 100,"temperature": 0}'
Asegúrate de recibir una respuesta correcta con un código de respuesta
200.
Migración sin tiempo de inactividad
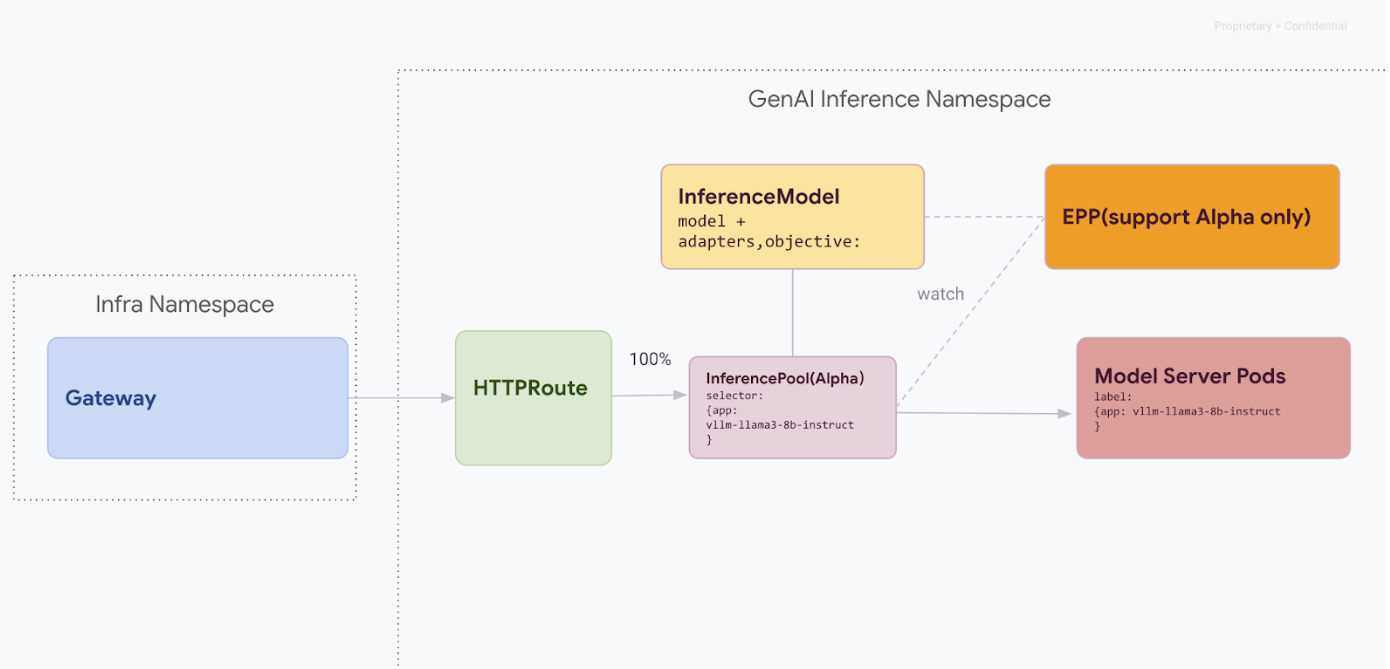
Esta ruta de migración está diseñada para los usuarios que no pueden permitirse ninguna interrupción del servicio. En el siguiente diagrama, se ilustra cómo GKE Inference Gateway facilita la entrega de varios modelos de IA generativa, un aspecto clave de una estrategia de migración sin tiempo de inactividad.
Cómo distinguir las versiones de la API con kubectl
Durante la migración sin tiempo de inactividad, se instalan los CRD v1alpha2 y v1
en tu clúster. Esto puede crear ambigüedad cuando se usa kubectl para consultar recursos de InferencePool. Para asegurarte de interactuar con la versión correcta, debes usar el nombre completo del recurso:
Para
v1alpha2:kubectl get inferencepools.inference.networking.x-k8s.ioPara
v1:kubectl get inferencepools.inference.networking.k8s.io
La API de v1 también proporciona un nombre corto conveniente, infpool, que puedes usar
para consultar recursos de v1 específicamente:
kubectl get infpool
Etapa 1: Implementación de la versión 1 en paralelo
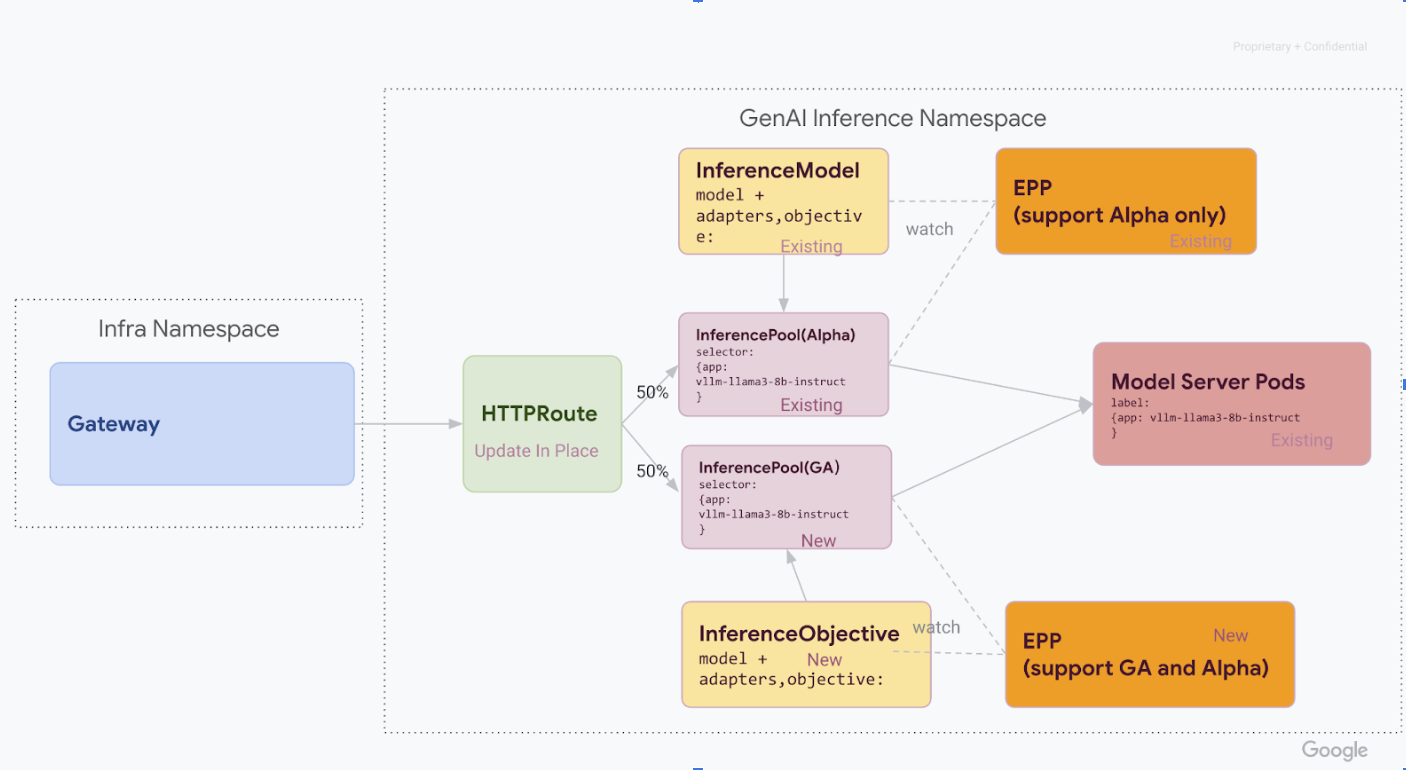
En esta etapa, implementarás la nueva pila de InferencePool v1 junto con la pila existente de v1alpha2, lo que permitirá una migración segura y gradual.
Después de completar todos los pasos de esta etapa, tendrás la siguiente infraestructura en el siguiente diagrama:
Instala la definición de recursos personalizados (CRD) necesaria en tu clúster de GKE:
- En el caso de las versiones de GKE anteriores a la
1.34.0-gke.1626000, ejecuta el siguiente comando para instalar las CRD v1InferencePooly alfaInferenceObjective:
kubectl apply -f https://github.com/kubernetes-sigs/gateway-api-inference-extension/releases/download/v1.0.0/manifests.yaml- Para las versiones de GKE
1.34.0-gke.1626000o posteriores, instala solo la CRDInferenceObjectivealfa ejecutando el siguiente comando:
kubectl apply -f https://github.com/kubernetes-sigs/gateway-api-inference-extension/raw/v1.0.0/config/crd/bases/inference.networking.x-k8s.io_inferenceobjectives.yaml- En el caso de las versiones de GKE anteriores a la
Para instalar el
v1 InferencePool, ingresa este comando:Usa Helm para instalar un nuevo
v1 InferencePoolcon un nombre de versión distinto, comovllm-llama3-8b-instruct-ga. ElInferencePooldebe segmentarse para los mismos Pods de servidor de modelos que elInferencePoolalfa coninferencePool.modelServers.matchLabels.app.Para instalar
InferencePool, usa el siguiente comando:helm install vllm-llama3-8b-instruct-ga \ --set inferencePool.modelServers.matchLabels.app=MODEL_SERVER_DEPLOYMENT_LABEL \ --set provider.name=gke \ --version RELEASE \ oci://registry.k8s.io/gateway-api-inference-extension/charts/inferencepoolReemplaza lo siguiente:
MODEL_SERVER_DEPLOYMENT_LABEL: Es la etiqueta que usan tus Pods de servidor de modelos existentes (por ejemplo,vllm-llama3-8b-instruct-preview).RELEASE: Es la versión del gráfico de Helm de la extensión de inferencia de la API de Gateway v1 que deseas instalar.
Crea recursos
v1alpha2 InferenceObjective.Como parte de la migración a la versión 1.0 de la extensión de inferencia de la API de Gateway, también debemos migrar de la API de
InferenceModelalfa a la nueva API deInferenceObjective.Aplica el siguiente YAML para crear los recursos
InferenceObjective:kubectl apply -f - <<EOF --- apiVersion: inference.networking.x-k8s.io/v1alpha2 kind: InferenceObjective metadata: name: food-review spec: priority: 2 poolRef: group: inference.networking.k8s.io name: vllm-llama3-8b-instruct-ga --- apiVersion: inference.networking.x-k8s.io/v1alpha2 kind: InferenceObjective metadata: name: base-model spec: priority: 2 poolRef: group: inference.networking.k8s.io name: vllm-llama3-8b-instruct-ga --- EOF
Etapa 2: Transferencia de tráfico
Con ambas pilas en ejecución, puedes comenzar a transferir tráfico de v1alpha2 a v1 actualizando HTTPRoute para dividir el tráfico. En este ejemplo, se muestra una división de 50-50.
Actualiza HTTPRoute para la división del tráfico.
Para actualizar el
HTTPRoutepara la división del tráfico, ejecuta el siguiente comando:kubectl apply -f - <<EOF --- apiVersion: gateway.networking.k8s.io/v1 kind: HTTPRoute metadata: name: llm-route spec: parentRefs: - group: gateway.networking.k8s.io kind: Gateway name: inference-gateway rules: - backendRefs: - group: inference.networking.x-k8s.io kind: InferencePool name: vllm-llama3-8b-instruct-preview weight: 50 - group: inference.networking.k8s.io kind: InferencePool name: vllm-llama3-8b-instruct-ga weight: 50 --- EOFVerifica y supervisa.
Después de aplicar los cambios, supervisa el rendimiento y la estabilidad de la nueva pila de
v1. Verifica que la puerta de enlaceinference-gatewaytenga el estadoPROGRAMMEDdeTRUE.
Etapa 3: Finalización y limpieza
Una vez que hayas verificado que el v1 InferencePool es estable, puedes dirigir todo
el tráfico hacia él y retirar los recursos antiguos de v1alpha2.
Transfiere el 100% del tráfico a
v1 InferencePool.Para cambiar el 100% del tráfico a
v1 InferencePool, ejecuta el siguiente comando:kubectl apply -f - <<EOF --- apiVersion: gateway.networking.k8s.io/v1 kind: HTTPRoute metadata: name: llm-route spec: parentRefs: - group: gateway.networking.k8s.io kind: Gateway name: inference-gateway rules: - backendRefs: - group: inference.networking.k8s.io kind: InferencePool name: vllm-llama3-8b-instruct-ga weight: 100 --- EOFRealiza la verificación final.
Después de dirigir todo el tráfico a la pila
v1, verifica que esté controlando todo el tráfico según lo esperado.Confirma que el estado de la puerta de enlace sea
PROGRAMMED:kubectl get gateway -o wideEl resultado debe ser similar a este:
NAME                CLASS                              ADDRESS           PROGRAMMED   AGE
inference-gateway   gke-l7-regional-external-managed   <IP_ADDRESS>   True                     10m
Verifica el extremo enviando una solicitud:
IP=$(kubectl get gateway/inference-gateway -o jsonpath='{.status.addresses[0].value}')
PORT=80
curl -i ${IP}:${PORT}/v1/completions -H 'Content-Type: application/json' -d '{
"model": "YOUR_MODEL",
"prompt": "YOUR_PROMPT",
"max_tokens": 100,
"temperature": 0
}'
Asegúrate de recibir una respuesta correcta con un código de respuesta
200.
Limpia los recursos de v1alpha2.
Después de confirmar que la pila de
v1funciona correctamente, quita de forma segura los recursos dev1alpha2antiguos.Comprueba si quedan recursos de
v1alpha2.Ahora que migraste a la API de
v1InferencePool, puedes borrar los CRD antiguos de forma segura. Verifica si existen APIs v1alpha2 para asegurarte de que ya no uses ningún recursov1alpha2. Si aún te quedan algunos, puedes continuar el proceso de migración para esos.Borra los CRD de
v1alpha2.Después de borrar todos los recursos personalizados de
v1alpha2, quita las definiciones de recursos personalizados (CRD) de tu clúster:kubectl delete -f https://github.com/kubernetes-sigs/gateway-api-inference-extension/releases/download/v0.3.0/manifests.yamlDespués de completar todos los pasos, tu infraestructura debería parecerse al siguiente diagrama:
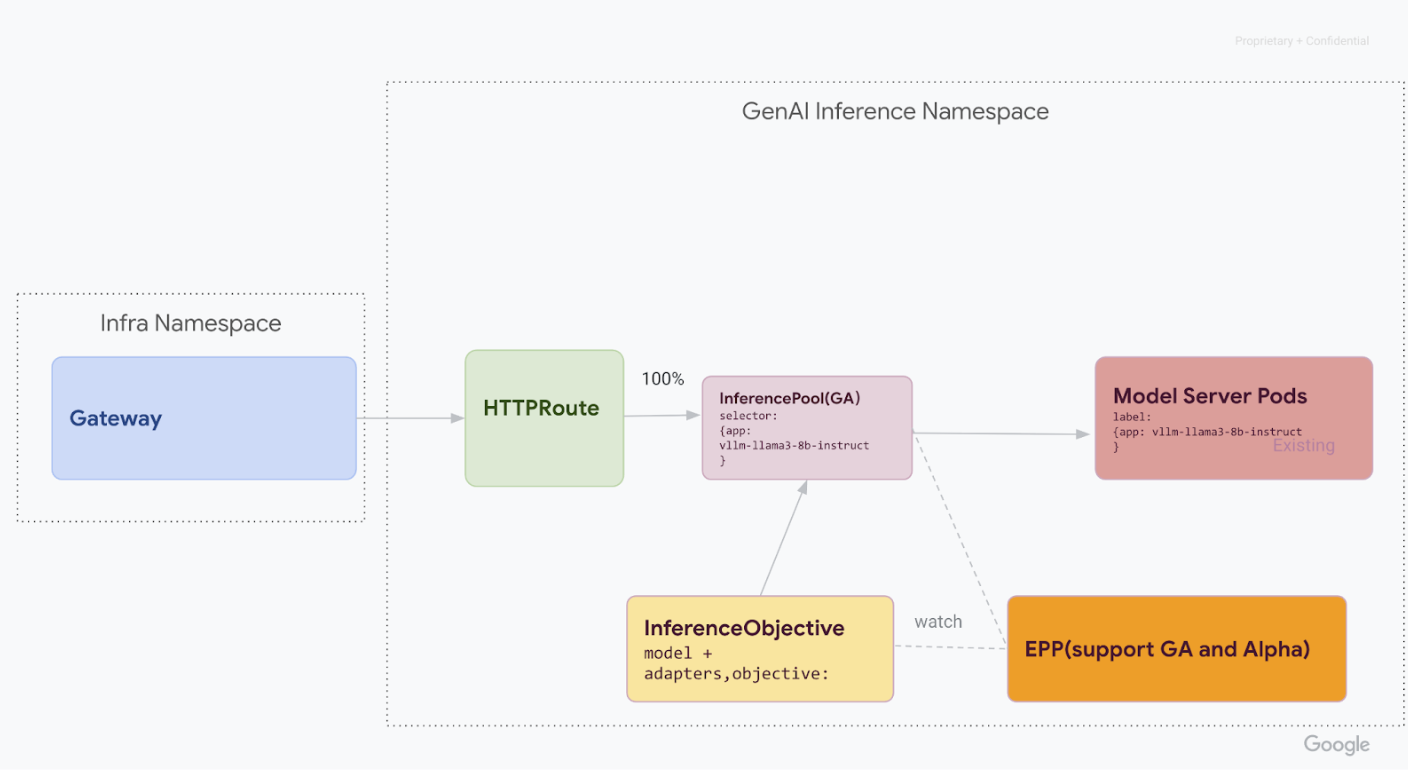
Figura: GKE Inference Gateway enruta las solicitudes a diferentes modelos de IA generativa según el nombre y la prioridad del modelo
¿Qué sigue?
- Obtén más información para implementar la puerta de enlace de GKE Inference.
- Explora otras funciones de redes de GKE.