

概览
此解决方案参考架构 (SRA) 定义了在 Distributed Cloud 纯软件独立集群上托管、部署和验证开放权重的大语言模型 (LLM) 的概念设计、组件拓扑和技术边界。
企业边缘环境通常需要低延迟推理和严格的数据主权。此解决方案参考架构提供了一个标准化、安全且可观测的服务堆栈,用于在配备客户自购 NVIDIA RTX PRO 6000 GPU (96GB VRAM) 的单节点 Distributed Cloud 纯软件集群上部署 Gemma 4 31B 模型。
特性和功能
- 本地模型服务:在 Distributed Cloud 软件专用集群边界内本地公开行业标准、与 OpenAI 兼容的 API。
- 支持大型边缘模型:经过优化,可以以原生精度 (BF16) 或量化格式运行 Gemma 4 31B,充分利用 96GB VRAM 容量。
- 可观测性:仅与 Distributed Cloud 软件的监控基础架构 (Google Cloud Managed Service for Prometheus) 集成,使用原生
PodMonitoring资源导出 GPU 遥测数据和 vLLM 性能指标,避免了对独立本地 Prometheus 服务器的需求。 - 交互式验证:部署基于 Gradio 的网页界面,以便立即直观地验证模型响应能力。
架构原则
- 简单性和可移植性:标准化为 Kubernetes 原生结构(部署、服务),而不是复杂的服务运算符,确保在单节点设置中轻松部署和维护。
- 数据主权:所有推理流量以及提示和回答数据都严格保留在本地集群边界内。
- 资源隔离:将物理 GPU 加速器专用于单个模型部署实例,以防止资源争用并保证可预测的延迟。
建筑和设计
组件
解决方案组件包括:
- 客户命名空间(仅限 Distributed Cloud 软件集群):
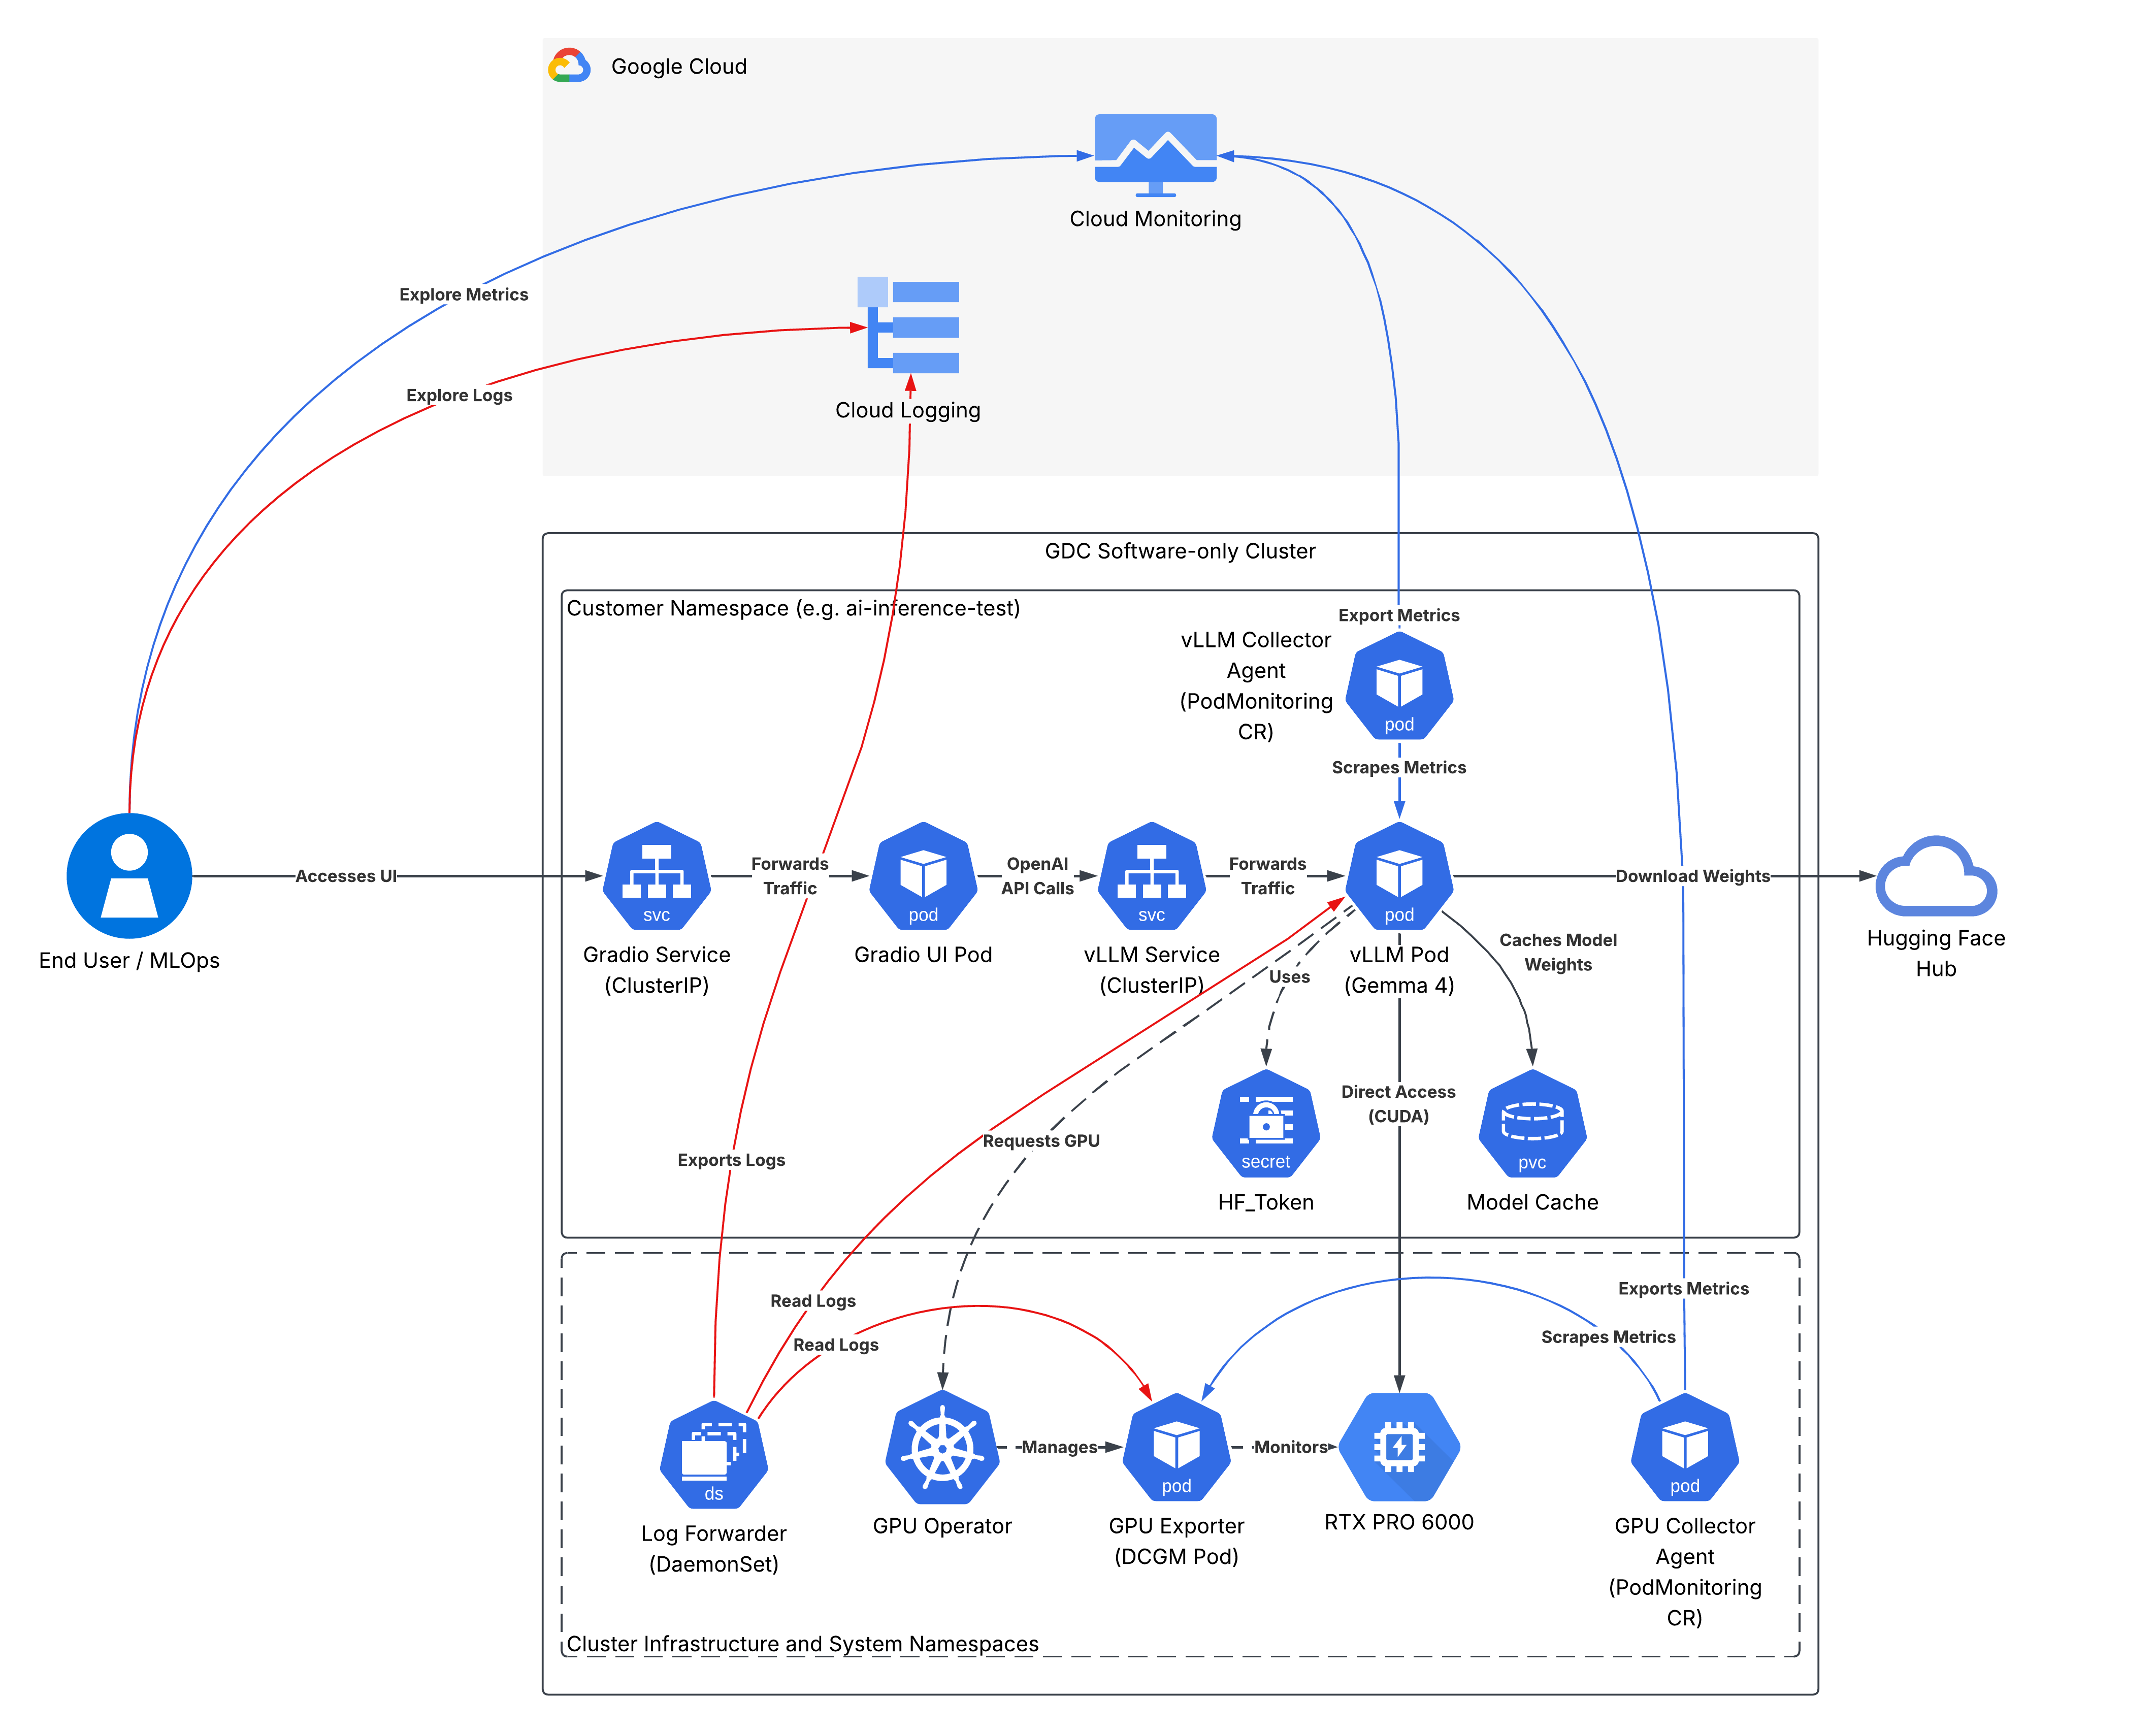
- vLLM 服务引擎:部署为运行 vLLM 容器的 Kubernetes Deployment。配置为从永久性存储加载 Gemma 权重并公开兼容 OpenAI 的 API。
- Gradio Web 界面:部署为 Kubernetes Deployment,提供用于验证的聊天界面(可选:也可以在连接到集群 vLLM 服务的开发者工作站或测试运行时上外部运行)。
- 永久性卷声明 (PVC):仅由 Distributed Cloud 软件本地共享存储空间(使用
local-sharedStorageClass)提供支持,用于托管模型权重。 - Kubernetes 服务:用于 vLLM API 端点的 ClusterIP 服务;用于将 Gradio 界面公开给客户网络的 NodePort 或 LoadBalancer 服务。
- 基础设施(客户管理):
- NVIDIA GPU Operator:编排物理 GPU 资源并将其仅公开给 Distributed Cloud 软件 Kubernetes 工作器节点。
- NVIDIA RTX PRO 6000 GPU:底层物理加速器(96 GB GDDR7 内存架构)。
- Google Cloud 集成:
- Google Cloud Monitoring 和 Logging:默认的 Distributed Cloud 纯软件代理,用于收集系统日志、容器日志和基本指标,并将其转发到Google Cloud。
高级架构概览
下图展示了仅包含 Distributed Cloud 软件的集群中的请求流和组件交互:
硬件限制
该解决方案专为配备 NVIDIA RTX PRO 6000 Blackwell GPU 的客户自备硬件而设计。
- GPU 规格:NVIDIA RTX PRO 6000(Blackwell 服务器版或工作站版)。
- 内存架构:96 GB GDDR7 VRAM(含 ECC)
- 模型选择的影响:
- 96 GB 的 VRAM 可让目标 Gemma 4 31B 模型以原生 BF16 精度运行(占用约 62 GB 的权重,为键值对 [KV] 缓存留下约 34 GB 的 VRAM 裕度)。
- 当启用 Blackwell 硬件加速的 FP8 量化 (
--quantization=fp8)(如参考实现中所配置)时,模型权重内存会减半至约 31 GB,从而将可用的 KV 缓存扩展到 ~56.5 GiB(61,728个令牌),同时在--gpu-memory-utilization=0.95时启用大上下文窗口或高并发批次大小,而不会遇到内存不足 (OOM) 错误。
可支持性矩阵(责任)
| 组件 | 管理者 | 备注 |
|---|---|---|
| 实体硬件和操作系统 | 客户 | 客户自备的硬件(具体而言,是搭载 NVIDIA RTX PRO 6000 Blackwell GPU 的服务器或工作站)。 |
| Distributed Cloud 纯软件集群安装 | 客户 | 必须遵循标准 Distributed Cloud(纯软件)安装文档。 |
| GPU 驱动程序和运算符 | 客户 | 安装 NVIDIA GPU Operator 和 Helm 图表。Google 不支持 NVIDIA 运算符部署。 |
| vLLM 服务清单 | Google(解决方案) | 作为本解决方案指南的一部分提供。 |
| 模型制品 | 客户 | 下载并托管 Gemma 模型权重。 |
| Gradio 界面和应用代码 | 客户 | 客户自有应用层,用于验证和使用。 |
| Cloud Logging 和 Cloud Monitoring | Joint | Google 提供默认集成;客户进行配置。 |
概念和技术
本部分详细介绍了功能组件、它们的职责以及它们在系统内的通信方式。它确定了支持目标使用情形所需的核心服务、数据存储单元和网络接口。
基础架构和平台
- NVIDIA RTX PRO 6000 GPU:提供 96GB GDDR7 VRAM。物理 GPU 完全专用于模型部署实例。未启用 GPU 分区 (MIG),以确保模型对完整的 VRAM 和内存带宽具有独占访问权限,从而防止资源争用。
- NVIDIA GPU Operator:由客户管理的 Operator,用于编排物理 GPU 资源并将其公开给 Distributed Cloud(纯软件)Kubernetes 工作器节点。
- 节点本地存储空间(永久性卷声明):仅由 Distributed Cloud 软件支持的节点本地存储空间,用于在节点上托管和持久保存模型权重。这样可确保模型权重下载后,会持久保存在本地。后续的 pod 重启或更新会从此本地缓存加载权重,从而缩短启动时间并防范 WAN 中断。
- 共享内存段 (
/dev/shm):将具有medium: Memory的emptyDir卷装载到/dev/shm,并分配 16GiB 的内存,以防止在 vLLM 中进行高并发张量运算期间出现分段错误。
服务和逻辑
- vLLM 服务引擎:部署为运行 Vertex AI 合格 vLLM 容器的 Kubernetes Deployment,通过
ClusterIP服务(端口 8000)公开。关键配置参数包括:--model:Gemma 模型的路径或 ID(例如google/gemma-4-31B-it)。--tensor-parallel-size:设置为1(单个 GPU 限制)。--dtype:设置为bfloat16可针对非量化层和激活利用硬件原生精度。--quantization:在参考实现中设置为fp8,以利用 Blackwell FP8 权重量化(约 31 GB 权重,约 56.5 GiB KV 缓存),如果首选未量化的 BF16(约 62 GB 权重,约 34 GB KV 缓存),则省略。
- Gradio Web 界面:部署为 Kubernetes Deployment,提供用于验证的聊天界面,通过
ClusterIP服务(端口 8080)公开。它会连接到 vLLM 服务,以进行提示和响应互动。
可观测性和 Google Cloud 集成
- Cloud Logging:使用默认的 Distributed Cloud 纯软件 Logging 代理自动捕获容器日志(vLLM 应用日志和 GPU 诊断信息)并将其转发到 Cloud Logging。
- Cloud Monitoring (PodMonitoring):Google Cloud Managed Service for Prometheus (GMP) 资源同时以 vLLM pod(用于提供令牌吞吐量和 KV 缓存使用情况等服务遥测数据)和 GPU 指标导出器 pod(用于提供 GPU 遥测数据)为目标,并将指标导出到 Cloud Monitoring。
注意事项
可扩展性与性能
- GPU 专用:NVIDIA RTX PRO 6000 GPU 完全专用于 vLLM 容器。在此架构中,未通过 MIG 或时间切片实现 GPU 共享,以确保可预测的推理延迟时间并防止出现 OOM。Gemma 4 31B 模型还需要大部分 VRAM 容量来存储模型权重(约 62 GB),这使得其他模型无法同时运行。
- 部署策略:强制执行为
Recreate。由于我们只有一个 GPU,因此在更新期间无法同时运行两个 vLLM pod 实例。必须先终止旧 pod 以释放 GPU 锁定,然后新 pod 才能启动。
资源管理
- VRAM 预留空间:虽然 96 GB NVIDIA RTX PRO 6000 在未量化的 BF16 精度下可容纳 Gemma 4 31B 模型(权重约 62 GB,为 KV 缓存留下约 34 GB),但参考部署支持 Blackwell FP8 量化 (
--quantization=fp8),以将权重内存减少到约 31 GB,并将可用的 KV 缓存扩展到 ~56.5 GiB(61,728并发令牌)。 - KV 缓存大小调整:SRA 假设采用默认 vLLM 分配 (
--gpu-memory-utilization=0.95),这可最大限度地提高引擎的 VRAM 使用率。
可用性和可靠性
- 缓存热度:使用节点本地 PV 至关重要。如果节点重启,则会重复使用主机目录中的缓存权重。
- 映像缓存:由于 vLLM 容器映像较大(超过 10 GB),建议设置
imagePullPolicy: IfNotPresent,以避免在 pod 重启时出现注册表拉取延迟。
运维复杂性
- 控制台可见性:与 GKE 不同,Distributed Cloud 纯软件不支持基于控制台的“AI/ML 模型”视图。所有验证和监控都必须通过
kubectlCLI、端口转发和直接 Cloud Monitoring 信息中心来执行。
设计决策
推理引擎:vLLM 与 Triton 与 Ollama
- 所选选项: vLLM
- 理由:vLLM 通过 PagedAttention 为 LLM 提供出色的开箱即用性能,支持 OpenAI API 对等性,并具有来自 Vertex AI 的预先经过资格认证的容器映像。
- 替代方案被拒:
- Triton:对于单模型边缘部署,配置和编译过于复杂。
- Ollama:缺少生产监控所需的高级遥测端点和精细的并发调优。
遥测路径:原生 GMP 与本地 Prometheus
所选选项: 原生 GMP (PodMonitoring)
- 理由:Distributed Cloud 纯软件仅支持与 Cloud Monitoring 进行原生集成。我们可以使用 Managed Prometheus 将指标直接路由到Google Cloud ,从而减少集群内的运营开销。
- 替代方案遭拒:
- 本地 Prometheus 和 Grafana 堆栈:被拒绝,以最大限度减少单节点集群上的控制平面资源使用量。
假设和限制
前提
- GPU Operator 可用性:假设客户已成功安装 NVIDIA GPU Operator,并在部署此解决方案之前配置了
nvidiaRuntimeClass。 - Hugging Face 访问权限:部署需要有效的 Hugging Face 令牌,该令牌具有对受限的 Gemma 4 代码库的访问权限,并以 Kubernetes Secret 的形式存储。
- 网络路径:集群必须具有互联网访问权限(或内部代理),才能在初始设置期间下载容器映像和模型权重。
限制
- 单 GPU 边界:第 1 阶段的架构受单个 NVIDIA RTX PRO 6000 GPU 的物理容量限制。第 1 阶段不支持大于约 310 亿参数的模型(或需要多 GPU 张量并行的高并发工作负载)。
- 无滚动更新:
Recreate策略意味着在模型更新或配置更改期间,服务会暂时停机,因为 GPU 无法在旧 pod 和新 pod 之间共享。 - 排除性能调优:与项目范围一致,此架构中排除了节点级优化(CPU 固定、巨页、
PerformanceTuningProfile)。