

개요
이 솔루션 참조 아키텍처 (SRA)는 Distributed Cloud 소프트웨어 전용 독립형 클러스터에서 공개 가중치 대규모 언어 모델 (LLM)을 호스팅, 서빙, 검증하기 위한 개념적 설계, 구성요소 토폴로지, 기술적 경계를 정의합니다.
엔터프라이즈 에지 환경에는 지연 시간이 짧은 추론과 엄격한 데이터 주권이 필요한 경우가 많습니다. 이 솔루션 참조 아키텍처는 고객이 제공한 NVIDIA RTX PRO 6000 GPU (96GB VRAM)가 장착된 단일 노드 Distributed Cloud 소프트웨어 전용 클러스터에 Gemma 4 31B 모델을 배포하기 위한 표준화되고 안전하며 관찰 가능한 제공 스택을 제공합니다.
특징 및 기능
- 로컬 모델 서빙: Distributed Cloud 소프트웨어 전용 클러스터 경계 내에서 로컬로 업계 표준의 OpenAI 호환 API를 노출합니다.
- 대형 에지 모델 지원: Gemma 4 31B를 네이티브 정밀도 (BF16) 또는 양자화된 형식으로 실행하도록 최적화되어 96GB VRAM 용량을 최대한 활용합니다.
- 관측 가능성: 기본
PodMonitoring리소스를 사용하여 Distributed Cloud 소프트웨어의 모니터링 인프라(Google Cloud Managed Service for Prometheus)와 통합하여 GPU 원격 분석 및 vLLM 성능 측정항목을 내보내므로 독립형 로컬 Prometheus 서버가 필요하지 않습니다. - 대화형 검증: 모델 응답성을 즉시 시각적으로 검증하기 위해 Gradio 기반 웹 인터페이스를 배포합니다.
아키텍처 원칙
- 간단성 및 이식성: 복잡한 서비스 운영자가 아닌 Kubernetes 네이티브 구조 (배포, 서비스)를 표준화하여 단일 노드 설정에서 배포 및 유지관리의 용이성을 보장합니다.
- 데이터 주권: 모든 추론 트래픽과 프롬프트 및 응답 데이터는 로컬 클러스터 경계 내에만 유지됩니다.
- 리소스 격리: 리소스 경합을 방지하고 예측 가능한 지연 시간을 보장하기 위해 물리적 GPU 가속기를 단일 모델 서빙 인스턴스에 전용으로 할당합니다.
건축 및 디자인
구성요소
솔루션 구성요소는 다음과 같습니다.
- 고객 네임스페이스 (Distributed Cloud 소프트웨어 전용 클러스터):
- vLLM 서빙 엔진: vLLM 컨테이너를 실행하는 Kubernetes 배포로 배포됩니다. 영구 스토리지에서 Gemma 가중치를 로드하고 OpenAI 호환 API를 노출하도록 구성됩니다.
- Gradio 웹 UI: 검증을 위한 채팅 인터페이스를 제공하는 Kubernetes 배포로 배포됩니다 (선택사항: 클러스터의 vLLM 서비스에 연결된 개발자 워크스테이션 또는 테스트 런타임에서 외부적으로 실행할 수도 있음).
- 영구 볼륨 클레임 (PVC): 모델 가중치를 호스팅하기 위해 Distributed Cloud 소프트웨어의 로컬 공유 스토리지(
local-sharedStorageClass 사용)만 지원됩니다. - Kubernetes 서비스: vLLM API 엔드포인트용 ClusterIP 서비스, 고객 네트워크에 노출하기 위한 Gradio UI용 NodePort 또는 LoadBalancer 서비스
- 인프라 (고객 관리):
- NVIDIA GPU Operator: 실제 GPU 리소스를 Distributed Cloud 소프트웨어 전용 Kubernetes 작업자 노드에 오케스트레이션하고 노출합니다.
- NVIDIA RTX PRO 6000 GPU: 기본 물리적 가속기 (96GB GDDR7 메모리 아키텍처)입니다.
- Google Cloud 통합:
- Google Cloud Monitoring 및 Logging: 시스템 로그, 컨테이너 로그, 기본 측정항목을Google Cloud에 수집하고 전달하는 기본 Distributed Cloud 소프트웨어 전용 에이전트입니다.
상위 수준 아키텍처 개요
다음 다이어그램은 Distributed Cloud 소프트웨어 전용 클러스터 내의 요청 흐름과 구성요소 상호작용을 보여줍니다.
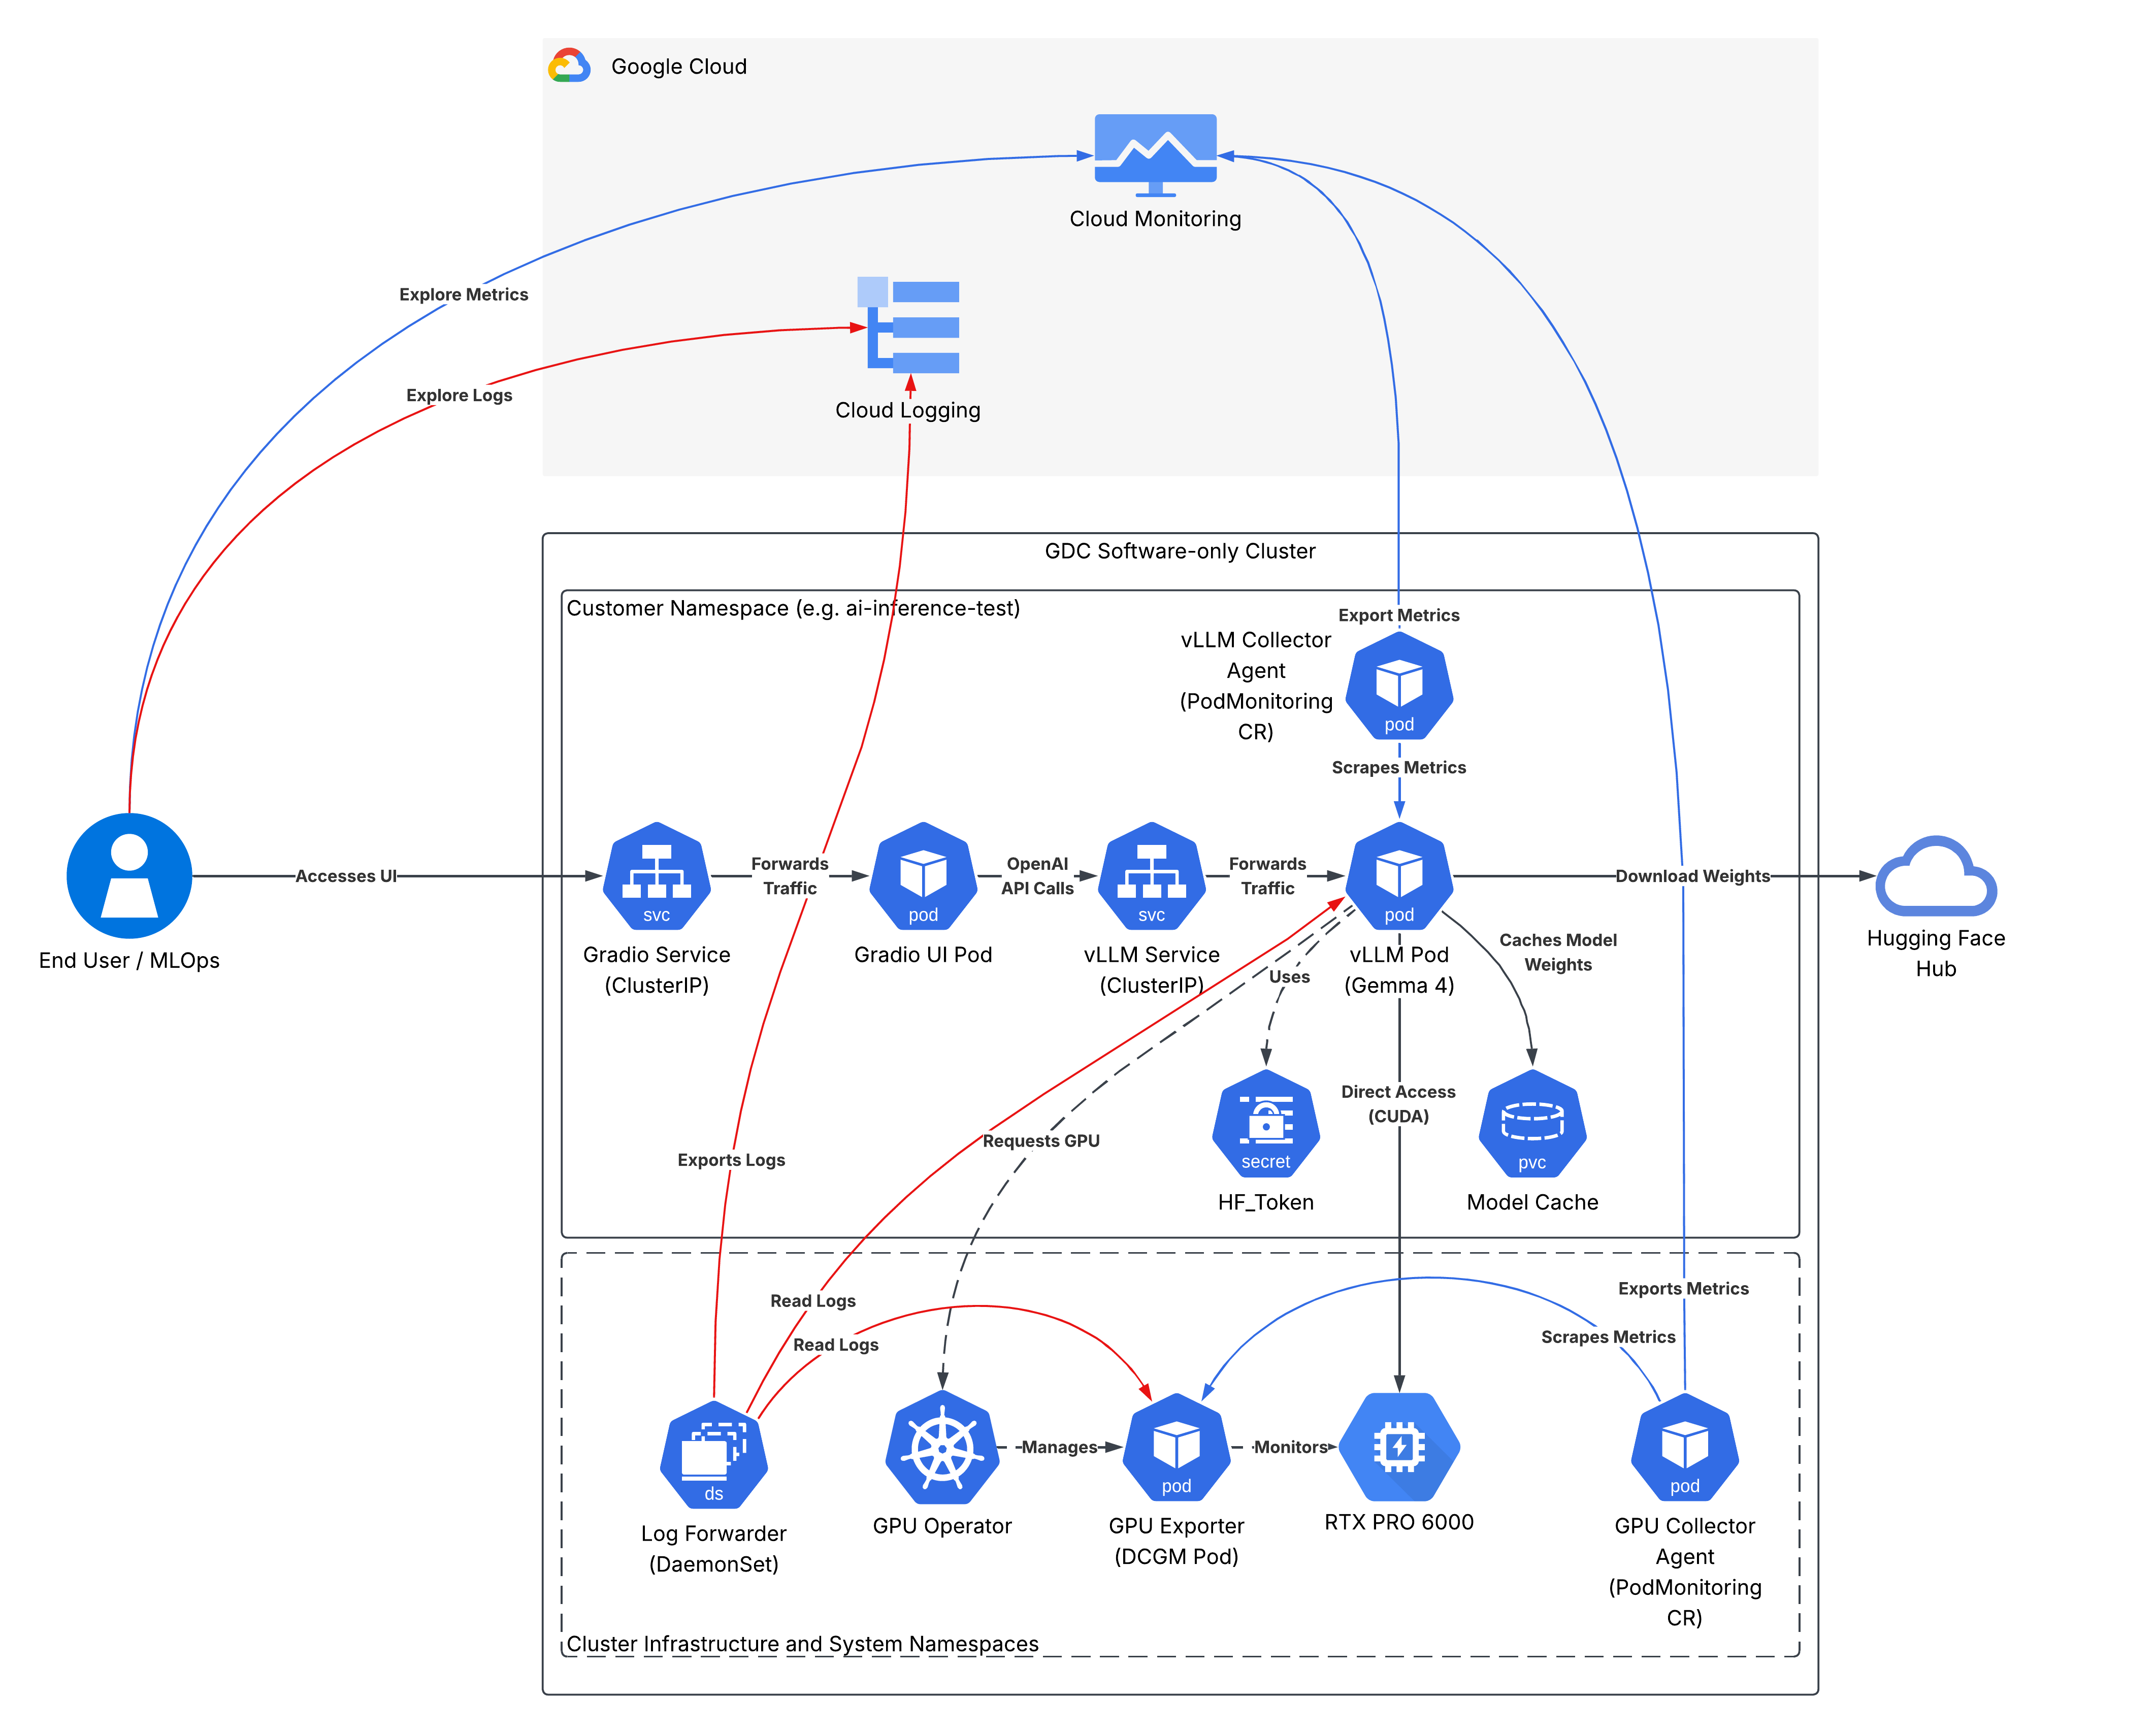
하드웨어 제약 조건
이 솔루션은 NVIDIA RTX PRO 6000 Blackwell GPU가 탑재된 고객 제공 하드웨어를 위해 설계되었습니다.
- GPU 사양: NVIDIA RTX PRO 6000 (Blackwell 서버 또는 워크스테이션 버전)
- 메모리 아키텍처: 96GB GDDR7 VRAM (ECC 포함)
- 모델 선택의 영향:
- 96GB의 VRAM을 사용하면 네이티브 BF16 정밀도로 타겟 Gemma 4 31B 모델을 실행할 수 있습니다 (가중치 약 62GB 차지, 키-값 (KV) 캐시용 VRAM 헤드룸 약 34GB 남음).
- 참조 구현에 구성된 대로 Blackwell 하드웨어 가속 FP8 양자화(
--quantization=fp8)가 사용 설정되면 모델 가중치 메모리가 ~31GB로 절반으로 줄어들어--gpu-memory-utilization=0.95에서 사용 가능한 KV 캐시가 ~56.5GiB (61,728토큰)로 확장되고 메모리 부족 (OOM) 오류가 발생하지 않고도 큰 컨텍스트 창이나 높은 동시 배치 크기를 사용할 수 있습니다.
지원 가능성 매트릭스 (책임)
| 구성요소 | 관리 리소스: | 참고 |
|---|---|---|
| 실제 하드웨어 및 OS | 고객 | 고객이 제공한 하드웨어 (특히 NVIDIA RTX PRO 6000 Blackwell GPU가 장착된 서버 또는 워크스테이션) |
| Distributed Cloud 소프트웨어 전용 클러스터 설치 | 고객 | 표준 Distributed Cloud 소프트웨어 전용 설치 문서를 따라야 합니다. |
| GPU 드라이버 및 연산자 | 고객 | NVIDIA GPU Operator 및 Helm 차트 설치 Google은 NVIDIA 운영자 배포를 지원하지 않습니다. |
| vLLM 서빙 매니페스트 | Google (솔루션) | 이 솔루션 가이드의 일부로 제공됩니다. |
| 모델 아티팩트 | 고객 | Gemma 모델 가중치를 다운로드하고 호스팅합니다. |
| Gradio UI 및 앱 코드 | 고객 | 유효성 검사 및 사용을 위한 고객 소유 애플리케이션 계층입니다. |
| Cloud Logging 및 Cloud Monitoring | 조인트 | Google에서 기본 통합을 제공하고 고객이 구성합니다. |
개념 및 기술
이 섹션에서는 기능 구성요소, 책임, 시스템 내에서 통신하는 방법을 자세히 설명합니다. 타겟 사용 사례를 지원하는 데 필요한 핵심 서비스, 데이터 스토리지 단위, 네트워킹 인터페이스를 식별합니다.
인프라 및 플랫폼
- NVIDIA RTX PRO 6000 GPU: 96GB GDDR7 VRAM을 제공합니다. 물리적 GPU는 모델 서빙 인스턴스에 전적으로 전용됩니다. 모델이 전체 VRAM 및 메모리 대역폭에 독점적으로 액세스하여 리소스 경합을 방지할 수 있도록 GPU 파티셔닝 (MIG)이 사용 설정되어 있지 않습니다.
- NVIDIA GPU Operator: 물리적 GPU 리소스를 Distributed Cloud 소프트웨어 전용 Kubernetes 워커 노드에 오케스트레이션하고 노출하는 고객 관리형 연산자입니다.
- 노드 로컬 스토리지 (영구 볼륨 요청): 노드에서 모델 가중치를 호스팅하고 유지하기 위해 Distributed Cloud 소프트웨어 전용 노드 로컬 스토리지를 지원합니다. 이렇게 하면 모델 가중치가 다운로드된 후 로컬에 유지됩니다. 후속 포드 다시 시작 또는 업데이트는 이 로컬 캐시에서 가중치를 로드하여 시작 시간을 줄이고 WAN 중단으로부터 보호합니다.
- 공유 메모리 세그먼트 (
/dev/shm):medium: Memory이 있는emptyDir볼륨이/dev/shm에 마운트되고 vLLM의 동시성 높은 텐서 작업 중에 세그먼트 오류를 방지하기 위해 16GiB가 할당됩니다.
서비스 및 로직
- vLLM 서빙 엔진: Vertex AI 인증 vLLM 컨테이너를 실행하는 Kubernetes 배포로 배포되고
ClusterIP서비스 (포트 8000)를 통해 노출됩니다. 주요 구성 파라미터는 다음과 같습니다.--model: Gemma 모델의 경로 또는 ID입니다 (예:google/gemma-4-31B-it).--tensor-parallel-size:1(단일 GPU 제약 조건)으로 설정됩니다.--dtype: 양자화되지 않은 레이어와 활성화에 하드웨어 네이티브 정밀도를 활용하려면bfloat16로 설정합니다.--quantization: Blackwell FP8 가중치 양자화 (~31GB 가중치, ~56.5GiB KV 캐시)를 활용하기 위해 참조 구현에서fp8로 설정하거나 양자화되지 않은 BF16 (~62GB 가중치, ~34GB KV 캐시)이 선호되는 경우 생략됩니다.
- Gradio 웹 UI: 검증을 위한 채팅 인터페이스를 제공하는 Kubernetes 배포로 배포되며
ClusterIP서비스 (포트 8080)를 통해 노출됩니다. 프롬프트 및 응답 상호작용을 위해 vLLM 서비스에 연결됩니다.
모니터링 가능성 및 Google Cloud 통합
- Cloud Logging: 기본 Distributed Cloud 소프트웨어 전용 로깅 에이전트를 사용하여 컨테이너 로그 (vLLM 애플리케이션 로그 및 GPU 진단)를 자동으로 캡처하고 Cloud Logging으로 전달합니다.
- Cloud Monitoring (PodMonitoring): Google Cloud Managed Service for Prometheus(GMP) 리소스는 vLLM 포드 (토큰 처리량 및 KV 캐시 사용량과 같은 원격 분석 제공)와 GPU 내보내기 프로그램 포드 (GPU 원격 분석용)를 모두 타겟팅하여 측정항목을 Cloud Monitoring으로 내보냅니다.
고려사항
확장성 및 성능
- GPU 전용: NVIDIA RTX PRO 6000 GPU는 vLLM 컨테이너에 완전히 전용됩니다. 예측 가능한 추론 지연 시간을 보장하고 OOM을 방지하기 위해 이 아키텍처에서는 MIG 또는 시간 슬라이싱을 통한 GPU 공유가 구현되지 않습니다. Gemma 4 31B 모델은 모델 가중치 (~62GB)에 대부분의 VRAM 용량이 필요하므로 다른 모델이 동시에 실행될 메모리가 많이 남지 않습니다.
- 배포 전략:
Recreate로 적용됩니다. GPU가 하나만 있으므로 업데이트 중에 vLLM 포드의 인스턴스를 두 개 동시에 실행할 수 없습니다. 새 포드가 시작되기 전에 GPU 잠금을 해제하려면 이전 포드를 종료해야 합니다.
리소스 관리
- VRAM 여유 공간: 96GB NVIDIA RTX PRO 6000은 양자화되지 않은 BF16 정밀도에서 Gemma 4 31B 모델에 적합하지만 (가중치에 ~62GB, KV 캐시에 ~34GB 남음) 참조 배포에서는 Blackwell FP8 양자화 (
--quantization=fp8)를 사용하여 가중치 메모리를 ~31GB로 줄이고 사용 가능한 KV 캐시를 ~56.5GiB (61,728동시 토큰)로 확장합니다. - KV 캐시 크기 조정: SRA는 엔진의 VRAM 사용량을 최대화하는 기본 vLLM 할당(
--gpu-memory-utilization=0.95)을 가정합니다.
가용성 및 안정성
- 캐시 워밍: 노드 로컬 PV를 사용하는 것이 중요합니다. 노드가 다시 시작되면 호스트 디렉터리의 캐시된 가중치가 재사용됩니다.
- 이미지 캐싱: vLLM 컨테이너 이미지가 크기 (>10GB) 때문에 포드 다시 시작 시 레지스트리 풀 지연을 방지하려면
imagePullPolicy: IfNotPresent를 설정하는 것이 좋습니다.
운영 복잡성
- 콘솔 가시성: GKE와 달리 Distributed Cloud 소프트웨어 전용은 콘솔 기반 'AI/ML 모델' 보기를 지원하지 않습니다. 모든 검증과 모니터링은
kubectlCLI, 포트 전달, 직접 Cloud Monitoring 대시보드를 통해 실행해야 합니다.
설계 결정
추론 엔진: vLLM과 Triton, Ollama 비교
- 선택한 옵션: vLLM
- 이유: vLLM은 PagedAttention을 통해 LLM에 즉시 사용할 수 있는 최고의 성능을 제공하고, OpenAI API 패리티를 지원하며, Vertex AI의 사전 검증된 컨테이너 이미지가 있습니다.
- 대안 거부:
- Triton: 단일 모델 에지 배포를 위해 구성하고 컴파일하기에는 너무 복잡합니다.
- Ollama: 프로덕션 모니터링에 필요한 고급 원격 분석 엔드포인트와 세부적인 동시성 조정이 부족합니다.
원격 분석 경로: 네이티브 GMP 대 로컬 Prometheus
선택한 옵션: 네이티브 GMP (PodMonitoring)
- 이유: Distributed Cloud 소프트웨어는 Cloud Monitoring과의 기본 통합만 지원합니다. 관리형 Prometheus를 사용하여 측정항목을Google Cloud 로 직접 라우팅하여 클러스터 내 운영 오버헤드를 줄일 수 있습니다.
- 대안 거부:
- 로컬 Prometheus 및 Grafana 스택: 단일 노드 클러스터에서 컨트롤 플레인 리소스 사용량을 최소화하기 위해 거부되었습니다.
가정 및 제한사항
가정
- GPU Operator 가용성: 고객이 이 솔루션을 배포하기 전에 NVIDIA GPU Operator를 성공적으로 설치하고
nvidiaRuntimeClass를 구성했다고 가정합니다. - Hugging Face 액세스: 배포에는 제한된 Gemma 4 저장소에 액세스할 수 있는 유효한 Hugging Face 토큰이 필요하며, 이는 Kubernetes 보안 비밀로 저장됩니다.
- 네트워크 경로: 초기 설정 중에 컨테이너 이미지와 모델 가중치를 다운로드하려면 클러스터가 인터넷에 액세스할 수 있어야 합니다 (또는 내부 프록시 사용).
제한사항
- 단일 GPU 경계: 1단계 아키텍처는 단일 NVIDIA RTX PRO 6000 GPU의 물리적 용량에 의해 제한됩니다. ~31B보다 큰 모델 (또는 다중 GPU 텐서 병렬 처리가 필요한 높은 동시성 워크로드)은 1단계에서 지원되지 않습니다.
- 순차적 업데이트 없음:
Recreate전략은 모델 업데이트 또는 구성 변경 중에 일시적인 서비스 다운타임을 의미합니다. GPU를 이전 포드와 새 포드 간에 공유할 수 없기 때문입니다. - 성능 조정 제외: 프로젝트 범위와 일관되게 노드 수준 최적화 (CPU 고정, 대용량 페이지,
PerformanceTuningProfile)는 이 아키텍처에서 제외됩니다.