

概要
このソリューション リファレンス アーキテクチャ(SRA)は、Distributed Cloud ソフトウェアのみのスタンドアロン クラスタでオープンウェイトの大規模言語モデル(LLM)をホスト、サービング、検証するためのコンセプト設計、コンポーネント トポロジ、技術的な境界を定義します。
エンタープライズ エッジ環境では、低レイテンシの推論と厳格なデータ主権が必要になることがよくあります。このソリューション リファレンス アーキテクチャは、標準化された安全でオブザーバブルなサービング スタックを提供し、お客様が提供する NVIDIA RTX PRO 6000 GPU(96 GB VRAM)を備えた単一ノードの Distributed Cloud ソフトウェア専用クラスタに Gemma 4 31B モデルをデプロイします。
特長と機能
- ローカル モデル サービング: 業界標準の OpenAI 互換 API を Distributed Cloud ソフトウェアのみのクラスタ境界内でローカルに公開します。
- 大規模エッジモデルのサポート: Gemma 4 31B をネイティブ精度(BF16)または量子化形式で実行するように最適化され、96 GB の VRAM 容量を最大限に活用します。
- オブザーバビリティ: ネイティブの
PodMonitoringリソースを使用して、Distributed Cloud ソフトウェアのモニタリング インフラストラクチャ(Google Cloud Managed Service for Prometheus)と統合し、GPU テレメトリーと vLLM パフォーマンス指標をエクスポートします。これにより、スタンドアロンのローカル Prometheus サーバーが不要になります。 - インタラクティブ検証: モデルの応答性をすぐに視覚的に検証するための Gradio ベースのウェブ インターフェースをデプロイします。
アーキテクチャの原則
- シンプルさと移植性: 複雑なサービング オペレータではなく、Kubernetes ネイティブ コンストラクト(Deployment、Service)を標準化し、単一ノード設定でのデプロイとメンテナンスを容易にします。
- データ主権: すべての推論トラフィックとプロンプトとレスポンスのデータは、ローカル クラスタの境界内に厳密に保持されます。
- リソースの分離: 物理 GPU アクセラレータを単一のモデル サービング インスタンス専用にして、リソースの競合を防ぎ、予測可能なレイテンシを保証します。
アーキテクチャと設計
コンポーネント
ソリューションのコンポーネントは次のとおりです。
- 顧客 Namespace(Distributed Cloud ソフトウェアのみのクラスタ):
- vLLM サービング エンジン: vLLM コンテナを実行する Kubernetes Deployment としてデプロイされます。永続ストレージから Gemma の重みを読み込み、OpenAI 互換 API を公開するように構成されています。
- Gradio Web UI: 検証用のチャット インターフェースを提供する Kubernetes Deployment としてデプロイされます(省略可: クラスタの vLLM サービスに接続されたデベロッパー ワークステーションまたはテスト ランタイムで外部実行することもできます)。
- Persistent Volume Claim(PVC): モデルの重みをホストするために、Distributed Cloud ソフトウェアのローカル共有ストレージ(
local-sharedStorageClass を使用)のみによって支えられます。 - Kubernetes サービス: vLLM API エンドポイント用の ClusterIP サービス。Gradio UI を顧客ネットワークに公開するための NodePort サービスまたは LoadBalancer サービス。
- インフラストラクチャ(お客様管理):
- NVIDIA GPU Operator: 物理 GPU リソースをオーケストレートし、Distributed Cloud(ソフトウェアのみ)の Kubernetes ワーカーノードに公開します。
- NVIDIA RTX PRO 6000 GPU: 基盤となる物理アクセラレータ(96 GB GDDR7 メモリ アーキテクチャ)。
- Google Cloud との統合:
- Google Cloud Monitoring と Logging: デフォルトの Distributed Cloud ソフトウェアのみのエージェントが、システムログ、コンテナログ、基本指標を収集してGoogle Cloudに転送します。
アーキテクチャの概要
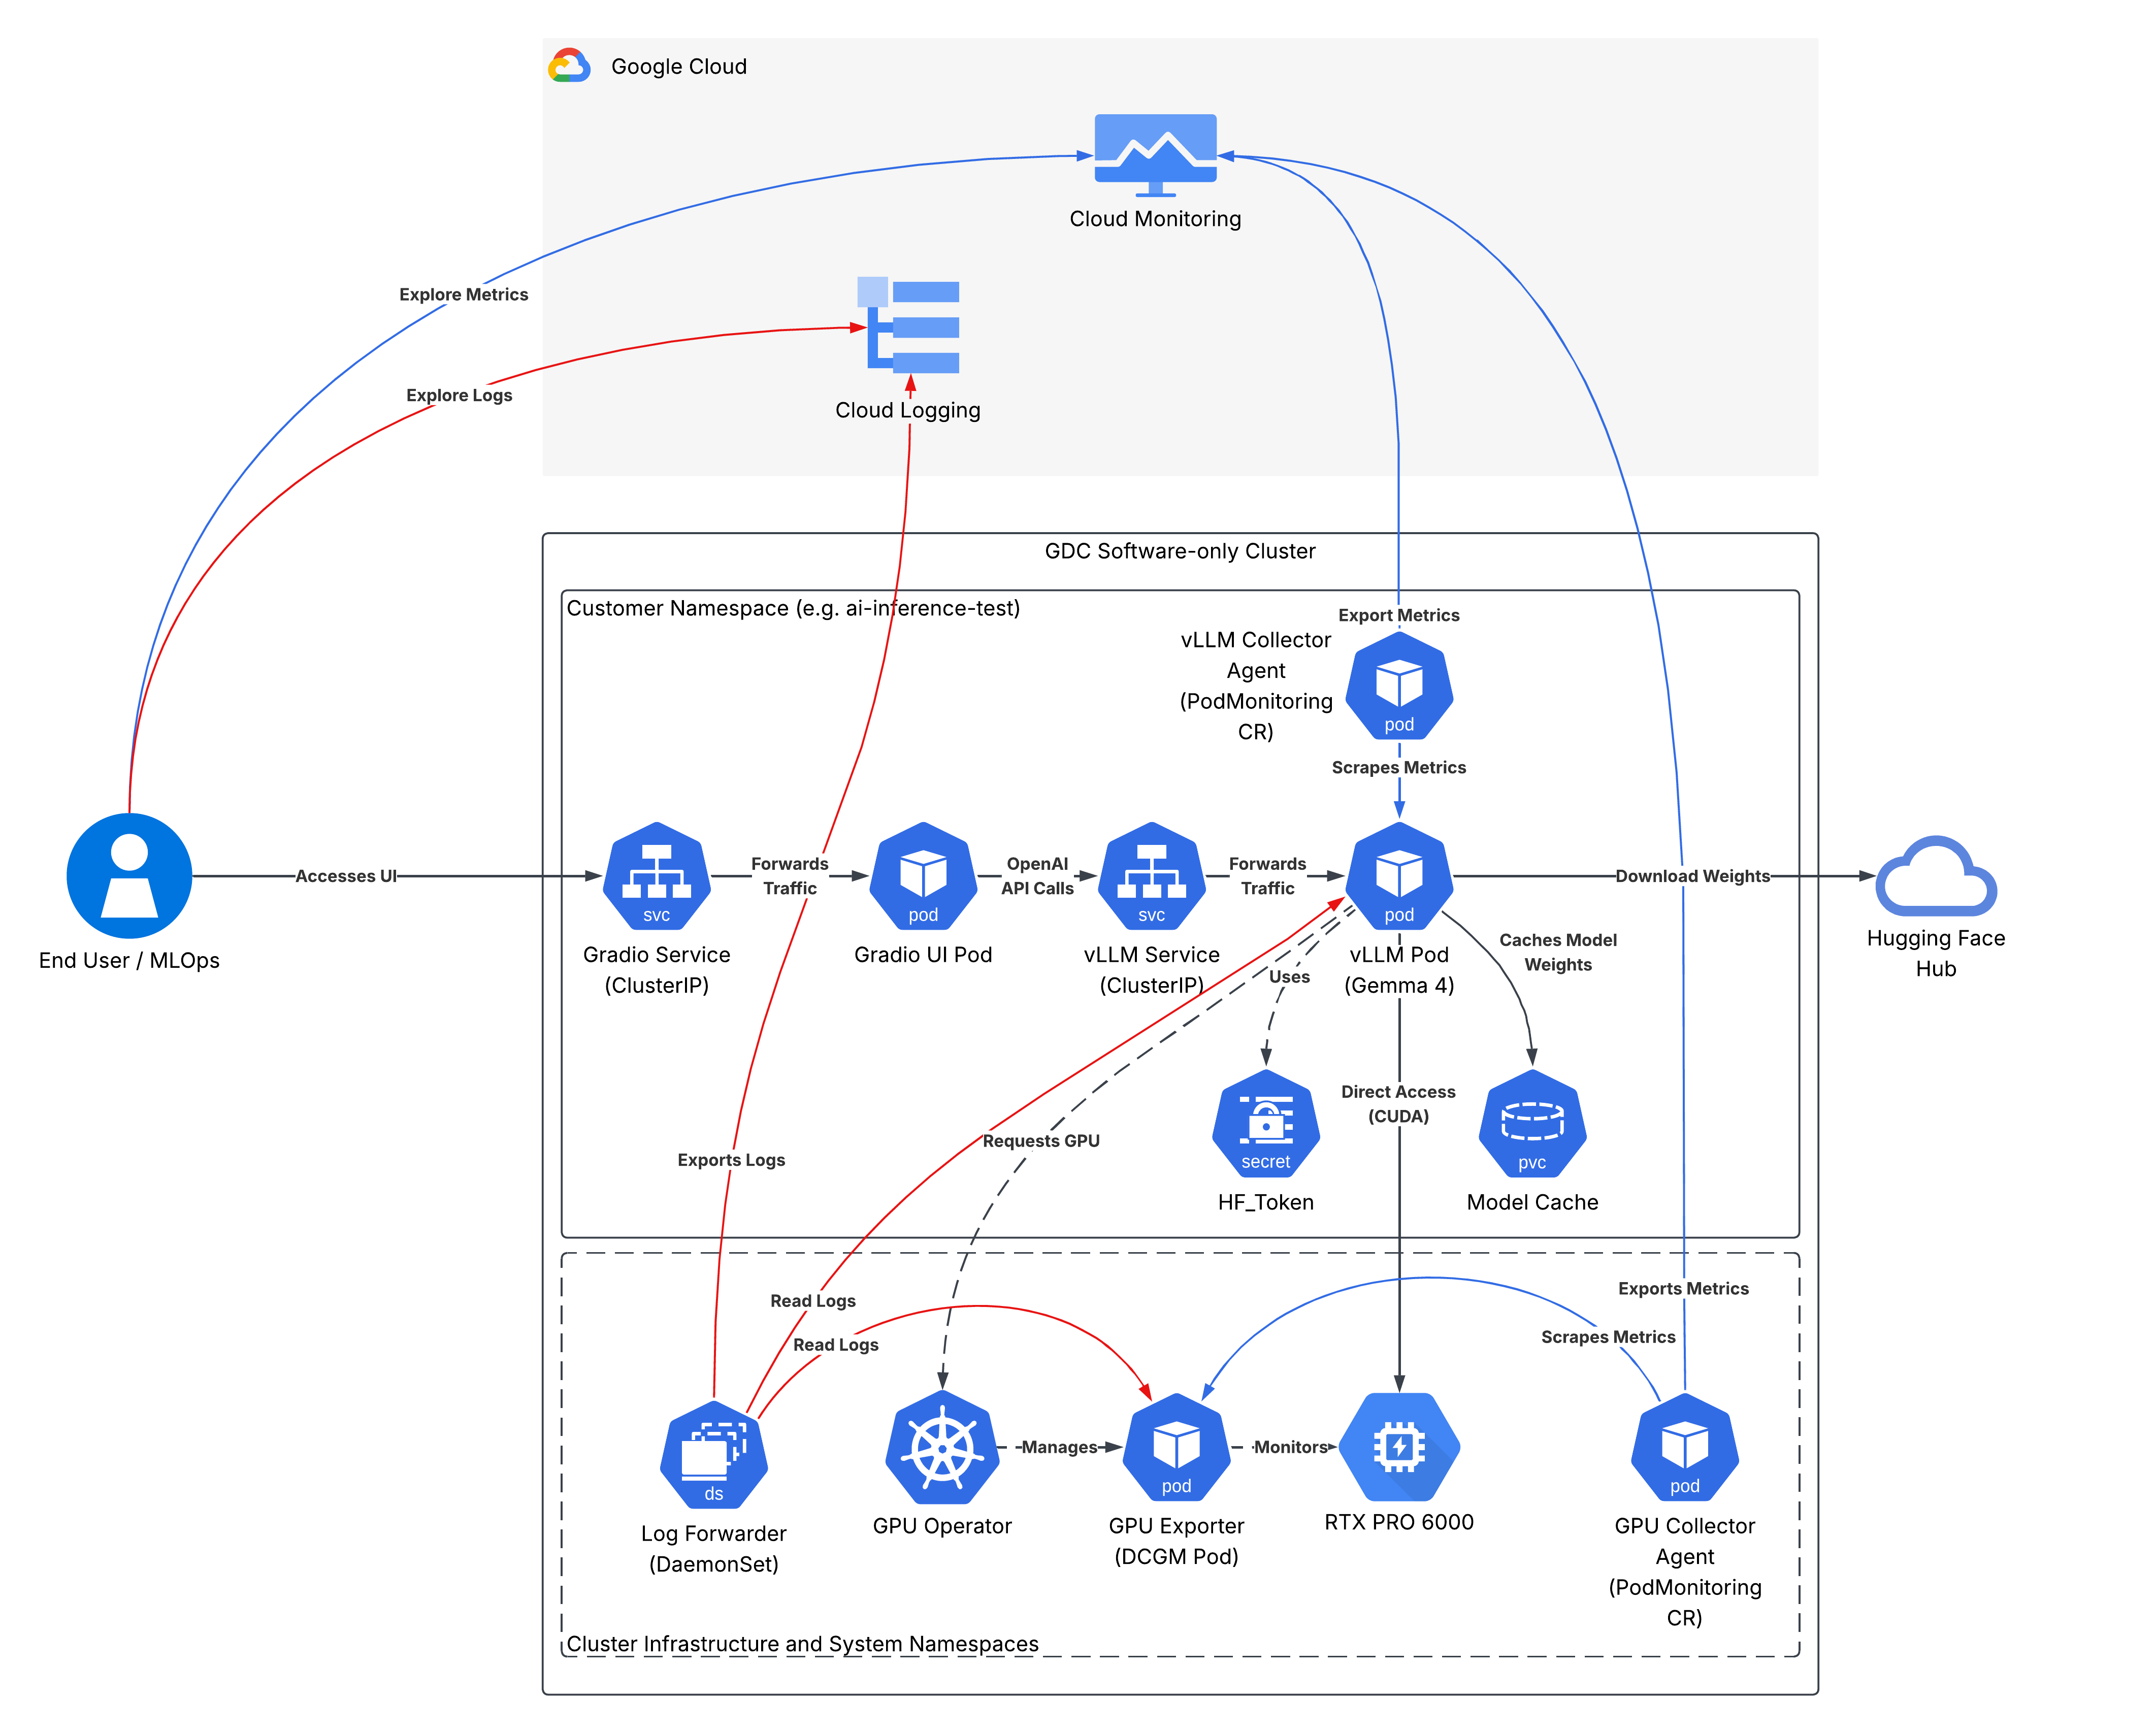
次の図は、Distributed Cloud ソフトウェア専用クラスタ内のリクエスト フローとコンポーネントのインタラクションを示しています。
ハードウェアの制約
このソリューションは、NVIDIA RTX PRO 6000 Blackwell GPU を搭載したお客様提供のハードウェア向けに設計されています。
- GPU 仕様: NVIDIA RTX PRO 6000(Blackwell Server または Workstation エディション)。
- メモリ アーキテクチャ: 96 GB GDDR7 VRAM(ECC 付き)
- モデル選択の影響:
- 96 GB の VRAM により、ターゲットの Gemma 4 31B モデルをネイティブ BF16 精度で実行できます(重み付けに約 62 GB を使用し、キー値(KV)キャッシュ用に約 34 GB の VRAM ヘッドルームを残します)。
- リファレンス実装で構成されているように、Blackwell ハードウェア アクセラレーション FP8 量子化(
--quantization=fp8)が有効になっている場合、モデルの重みメモリは半分になり、約 31 GB になります。これにより、--gpu-memory-utilization=0.95で使用可能な KV キャッシュが 約 56.5 GiB(61,728トークン)に拡張され、メモリ不足(OOM)エラーが発生することなく、大きなコンテキスト ウィンドウや高い同時バッチサイズが可能になります。
サポート内容のマトリクス(責任)
| コンポーネント | 管理者 | メモ |
|---|---|---|
| 物理ハードウェアと OS | 顧客 | お客様が調達したハードウェア(特に NVIDIA RTX PRO 6000 Blackwell GPU を搭載したサーバーまたはワークステーション)。 |
| Distributed Cloud ソフトウェアのみのクラスタのインストール | 顧客 | 標準の Distributed Cloud ソフトウェアのみのインストール ドキュメントに沿って操作する必要があります。 |
| GPU ドライバとオペレータ | 顧客 | NVIDIA GPU Operator と Helm チャートのインストール。Google は NVIDIA オペレーターのデプロイをサポートしていません。 |
| vLLM サービング マニフェスト | Google(ソリューション) | このソリューション ガイドの一部として提供されます。 |
| モデルのアーティファクト | 顧客 | Gemma モデルの重みをダウンロードしてホストする。 |
| Gradio UI とアプリコード | 顧客 | 検証と使用のための顧客所有のアプリケーション レイヤ。 |
| Cloud Logging と Cloud Monitoring | 共同 | Google がデフォルトの統合を提供します。お客様が構成します。 |
コンセプトとテクノロジー
このセクションでは、機能コンポーネント、その役割、システム内での通信方法について詳しく説明します。ターゲット ユースケースをサポートするために必要なコアサービス、データ ストレージ ユニット、ネットワーキング インターフェースを特定します。
インフラストラクチャとプラットフォーム
- NVIDIA RTX PRO 6000 GPU: 96 GB の GDDR7 VRAM を提供します。物理 GPU は、モデル提供インスタンス専用になります。モデルが VRAM とメモリ帯域幅全体に排他的にアクセスできるように、GPU パーティショニング(MIG)は有効になっていません。これにより、リソースの競合を防ぐことができます。
- NVIDIA GPU Operator: 物理 GPU リソースをオーケストレートし、Distributed Cloud(ソフトウェアのみ)の Kubernetes ワーカーノードに公開する、顧客管理の Operator。
- ノードローカル ストレージ(永続ボリューム クレーム): Distributed Cloud ソフトウェアのみでサポートされるノードローカル ストレージ。ノードでモデルの重みをホストして永続化します。これにより、モデルの重みがダウンロードされると、ローカルに保持されます。以降の Pod の再起動または更新では、このローカル キャッシュから重みが読み込まれるため、起動時間が短縮され、WAN の停止から保護されます。
- 共有メモリ セグメント(
/dev/shm):medium: Memoryを含むemptyDirボリュームが/dev/shmにマウントされ、vLLM での高並行テンソル オペレーション中のセグメンテーション違反を防ぐために 16 GiB が割り当てられます。
サービスとロジック
- vLLM サービング エンジン: Vertex AI 認定の vLLM コンテナを実行する Kubernetes Deployment としてデプロイされ、
ClusterIPサービス(ポート 8000)を介して公開されます。主な構成パラメータは次のとおりです。--model: Gemma モデルのパスまたは ID(google/gemma-4-31B-itなど)。--tensor-parallel-size:1(単一 GPU 制約)に設定します。--dtype: 量子化されていないレイヤとアクティベーションでハードウェア ネイティブの精度を活用するには、bfloat16に設定します。--quantization: 参照実装ではfp8に設定して、Blackwell FP8 重み量子化(重み約 31 GB、KV キャッシュ約 56.5 GiB)を活用します。量子化されていない BF16(重み約 62 GB、KV キャッシュ約 34 GB)が優先される場合は省略します。
- Gradio ウェブ UI: 検証用のチャット インターフェースを提供する Kubernetes Deployment としてデプロイされ、
ClusterIPサービス(ポート 8080)経由で公開されます。プロンプトとレスポンスのやり取りのために vLLM サービスに接続します。
オブザーバビリティと Google Cloud 統合
- Cloud Logging: デフォルトの Distributed Cloud ソフトウェアのみのロギング エージェントを使用して、コンテナログ(vLLM アプリケーション ログと GPU 診断)を自動的にキャプチャして Cloud Logging に転送します。
- Cloud Monitoring(PodMonitoring): Google Cloud Managed Service for Prometheus(GMP)リソースは、vLLM Pod(トークン スループットや KV キャッシュ使用率などのテレメトリー用)と GPU エクスポーター Pod(GPU テレメトリー用)の両方をターゲットとし、指標を Cloud Monitoring にエクスポートします。
考慮事項
スケーラビリティとパフォーマンス
- GPU の専用割り当て: NVIDIA RTX PRO 6000 GPU は vLLM コンテナ専用です。このアーキテクチャでは、予測可能な推論レイテンシを確保し、OOM を防ぐために、MIG またはタイム スライスによる GPU の共有は実装されていません。Gemma 4 31B モデルも、モデルの重み(約 62 GB)に VRAM 容量のほとんどを必要とするため、他のモデルを同時に実行するためのメモリがほとんど残りません。
- デプロイ戦略:
Recreateとして適用されます。GPU が 1 つしかないため、更新中に vLLM Pod の 2 つのインスタンスを同時に実行することはできません。新しい Pod を起動する前に、古い Pod を終了して GPU ロックを解除する必要があります。
リソース管理
- VRAM ヘッドルーム: 96 GB の NVIDIA RTX PRO 6000 は、非量子化 BF16 精度で Gemma 4 31B モデルに適合しますが(重み付けに約 62 GB、KV キャッシュに約 34 GB)、リファレンス デプロイでは Blackwell FP8 量子化(
--quantization=fp8)により、重み付けメモリが約 31 GB に削減され、使用可能な KV キャッシュが ~56.5 GiB(61,728同時トークン)に拡張されます。 - KV キャッシュのサイズ設定: SRA は、デフォルトの vLLM 割り当て(
--gpu-memory-utilization=0.95)を前提としています。これにより、エンジンの VRAM 使用率が最大化されます。
可用性と信頼性
- キャッシュのウォームアップ: ノードローカル PV の使用が重要です。ノードが再起動すると、ホスト ディレクトリのキャッシュに保存された重みが再利用されます。
- イメージ キャッシュ: vLLM コンテナ イメージは大きいため(10 GB 超)、Pod の再起動時にレジストリの pull が遅延しないように
imagePullPolicy: IfNotPresentを設定することをおすすめします。
運用の複雑さ
- コンソールの可視性: GKE とは異なり、Distributed Cloud ソフトウェアのみではコンソールベースの [AI/ML モデル] ビューはサポートされていません。検証とモニタリングはすべて、
kubectlCLI、ポート転送、直接 Cloud Monitoring ダッシュボードを使用して行う必要があります。
設計上の意思決定
推論エンジン: vLLM、Triton、Ollama
- 選択したオプション: vLLM
- 理由: vLLM は、PagedAttention を介して LLM に最適なパフォーマンスをすぐに提供し、OpenAI API のパリティをサポートし、Vertex AI から事前認定されたコンテナ イメージを備えています。
- Alternatives Rejected:(代替案が拒否されました)
- Triton: 単一モデルのエッジ デプロイ用に構成してコンパイルするには、複雑すぎます。
- Ollama: 本番環境のモニタリングに必要な高度なテレメトリー エンドポイントと詳細な同時実行チューニングがありません。
テレメトリー パス: ネイティブ GMP とローカル Prometheus
選択したオプション: ネイティブ GMP(PodMonitoring)
- 理由: Distributed Cloud ソフトウェアは、Cloud Monitoring とのネイティブ統合のみをサポートしています。Managed Prometheus を使用して指標をGoogle Cloud に直接転送できるため、クラスタ内の運用オーバーヘッドを削減できます。
- Alternatives Rejected:(代替案が拒否されました)
- ローカルの Prometheus と Grafana スタック: 単一ノード クラスタでのコントロール プレーン リソースの使用量を最小限に抑えるため、拒否されました。
前提条件と制限事項
前提条件
- GPU Operator の可用性: このソリューションをデプロイする前に、NVIDIA GPU Operator が正常にインストールされ、
nvidiaRuntimeClass が構成されていることを前提としています。 - Hugging Face アクセス: デプロイには、制限付きの Gemma 4 リポジトリへのアクセス権を持つ有効な Hugging Face トークンが必要です。このトークンは Kubernetes Secret として保存されます。
- ネットワーク パス: クラスタは、初期設定時にコンテナ イメージとモデルの重みをダウンロードするために、インターネット アクセス(または内部プロキシ)が必要です。
制限事項
- 単一 GPU の境界: フェーズ 1 のアーキテクチャは、単一の NVIDIA RTX PRO 6000 GPU の物理容量によって制限されます。フェーズ 1 では、約 31B を超えるモデル(またはマルチ GPU テンソル並列処理を必要とする高同時実行ワークロード)はサポートされていません。
- ローリング アップデートなし:
Recreate戦略では、モデルの更新または構成の変更中にサービスが一時的に停止します。これは、GPU を古い Pod と新しい Pod で共有できないためです。 - パフォーマンス チューニングは除外: プロジェクトの範囲に沿って、ノードレベルの最適化(CPU ピニング、hugepages、
PerformanceTuningProfile)はこのアーキテクチャから除外されます。