


Knowledge Catalog הוא שכבת הקשר שמבוססת על Gemini. הוא מספק הקשר עסקי אוניברסלי ויכולות פעילות של עיגון בנתונים בכל מאגר הנתונים שלכם. הוא עוזר לצוותי נתונים ולמפתחים לגלות נכסים, לאמת את איכות הנתונים ולהקטין את הסיכוי להזיות על ידי יצירת גרף הקשר דינמי מנתונים מובנים ולא מובנים.
בסרטון הבא יש הדרכה מפורטת על Knowledge Catalog:
קהל ותנאים מוקדמים
הסקירה הכללית הזו מיועדת למהנדסי נתונים והקשר, למדעני נתונים, למנהלי נתונים ולמפתחי AI. לפני שמשתמשים ב-Knowledge Catalog, צריך:
היכרות עם מערכות אחסון ומסדי נתונים, כמו BigQuery או Cloud Storage.
הבנה בסיסית של מושגים ב-AI גנרטיבי, כמו יצירה עם שליפה משופרת (RAG) או Model Context Protocol (MCP).
פתרון בעיות של מורכבות נתונים ספציפית לתעשייה
בארגונים מודרניים, הנתונים מורכבים, מפוזרים מאוד וקיימים בפורמטים מובנים ולא מובנים. בדרך כלל, בקשות עסקיות לא ממופות לסכימת מסד נתונים יחידה או למאגר מסמכים. התאמה מאובטחת בין מאגרי המידע האלה, תוך מתן תשובות מיידיות ומהימנות לשאלות שקשורות לתחומים שונים, היא אתגר תפעולי משמעותי.
Knowledge Catalog משמש כבסיס סמנטי שמגשר על הפער הזה, ומאפשר לסוכני AI ולכלי ניתוח נתונים לאחזר הקשר מעוגן בנתונים ורלוונטי.
תפקידי משתמשים מרכזיים
מהנדסי הקשר (מהנדסי נתונים). אוטומציה של צבירת מטא-נתונים במסדי נתונים וב-Cloud Storage, מעקב אחר טרנספורמציות באמצעות שושלת נתונים ויצירת תהליכי עבודה להעשרה ולהערכה.
נאמני מידע (צוותי משילות). פיקוח על איכות המטא-נתונים באמצעות ביקורות אנושיות על תיאורים שנוצרו על ידי AI, סטנדרטיזציה של אוצר מילים עסקי באמצעות מילונים והגדרת היבטים מותאמים אישית לצירוף הקשר ספציפי לתחום לרשומות בקטלוג.
מפתחי AI. הקרקוע של מודלים גדולים של שפה (LLM) ושל אפליקציות AI עם סכימות נתונים ארגוניות מהימנות באמצעות שרתי MCP או ממשקי API לאחזור הקשר.
תרחישי שימוש בתחומים שונים
בטבלה הבאה מפורטות שאלות מורכבות שעולות בפועל, איך הן חוצות גבולות טכניים ואיך Knowledge Catalog עוזר לארגונים להתמודד איתן:
| ענף | אתגרים שקשורים לנתונים ולתפעול | בעיה עסקית שצריך לפתור | איך Knowledge Catalog פותר את הבעיה |
|---|---|---|---|
| מסחר אלקטרוני |
|
"תמצא מוצרי אלקטרוניקה עם שיעורי החזרה גבוהים ותמונות של לקוחות שמראות סימני נזק כשהמוצר מגיע". | התאמה סמנטית בין פורמטים שונים של נתונים: המערכת מגלה באופן אוטומטי מטא-נתונים ממסדי נתונים טרנזקציוניים ומקשרת אותם לתמונות לא מובְנות בקטגוריות אחסון ב-Cloud Storage, וכך מאפשרת לכלי AI לפתור את השאילתה במערכות אחסון שונות. |
| ייצור |
|
"תצור סיכומים לכל דוחות הבדיקה שקשורים למכונות באזור המערבי שנכשלו בבדיקות הבטיחות ברבעון האחרון". | סריקה אזורית ולא מובנית: סריקה וקטלוג של דוחות בדיקה לא מובְנים בפורמט PDF לצד מטא-נתונים של נכסים, שמאפשרים לסוכני AI גנרטיבי לאתר, לקמפל ולסכם דוחות לפי אזור. |
| שירותי בריאות |
|
"אילו מטופלים נמצאים בסיכון הגבוה ביותר לאשפוז חוזר תוך 30 יום, בהתבסס על נתונים חיוניים מהמעבדה ותדירות הפגישות שלהם?" | איכות הנתונים ושושלת הנתונים: חישוב פרופיל איכות הנתונים ברמת השורה ומיפוי שושלת הנתונים שלהם בכל פיד של סיכום מצב בריאותי אלקטרוני, כדי לוודא שמודלים קליניים לחיזוי מסתמכים רק על סימנים חיוניים מאומתים ובאיכות גבוהה של המטופלים. |
| שירותים פיננסיים |
|
"אילו מתוך 10 הלקוחות המובילים שמניבים הכי הרבה הכנסות התלוננו על 'בעיות בביצועים', ואיך זה משפיע על התחזיות לרבעון השלישי?" | גרף הקשר המאוחד: מאחד רשומות של לקוחות, משוב על תמיכה וטבלאות פיננסיות, ומאפשר לשאילתות בשפה טבעית לצרף נתונים סטטיסטיים על הכנסות של לקוחות לקובצי משוב לא מובנים כדי לחזות את ההשפעה הפיננסית. |
כדי להתמודד עם האתגרים התפעוליים האלה, Knowledge Catalog מספק יכולות מרכזיות שעוזרות למהנדסי נתונים, למדעני נתונים ולמפתחי AI לבנות מערכות נתונים מבוקרות:
הארקה של סוכני AI באמצעות Model Context Protocol (MCP). אפשר לחשוף מטא-נתונים, סכימות, שושלת וכללים עסקיים ישירות לסוכני AI באמצעות שרתי MCP מקומיים או מרוחקים. השרתים האלה מאפשרים למודלים לאמת ציפיות תפעוליות לפני שהם מציעים פעולות.
מגלים מהר יותר את היתרונות של AI וניתוח נתונים. חיפוש נכסי נתונים רלוונטיים באמצעות חיפוש סמנטי בשפה טבעית. סיכומים והמלצות גנרטיביים עוזרים למשתמשים לאתר נתונים בלי לחכות לבדיקות ידניות של מסמכים.
חילוץ הקשר מנתונים לא מובְנים. ניתוח אוטומטי של קבצים לא מובנים, כמו קובצי PDF ב-Cloud Storage, כדי לחלץ ישויות וקשרים, ולהמיר אותם לנכסים שאפשר להריץ עליהם שאילתות ב-BigQuery, כדי לתמוך בסוכנים שיכולים לנהל שיחה.
שליטה במוצרי נתונים בקנה מידה נרחב. אפשר לארוז אוספים של נכסים עם הסכמי רמת שירות (SLA), חוזים, פרטי בעלות והערות שימוש ליחידות מנוהלות יחידות לחיפוש ולמינוי.
איך Knowledge Catalog עובד
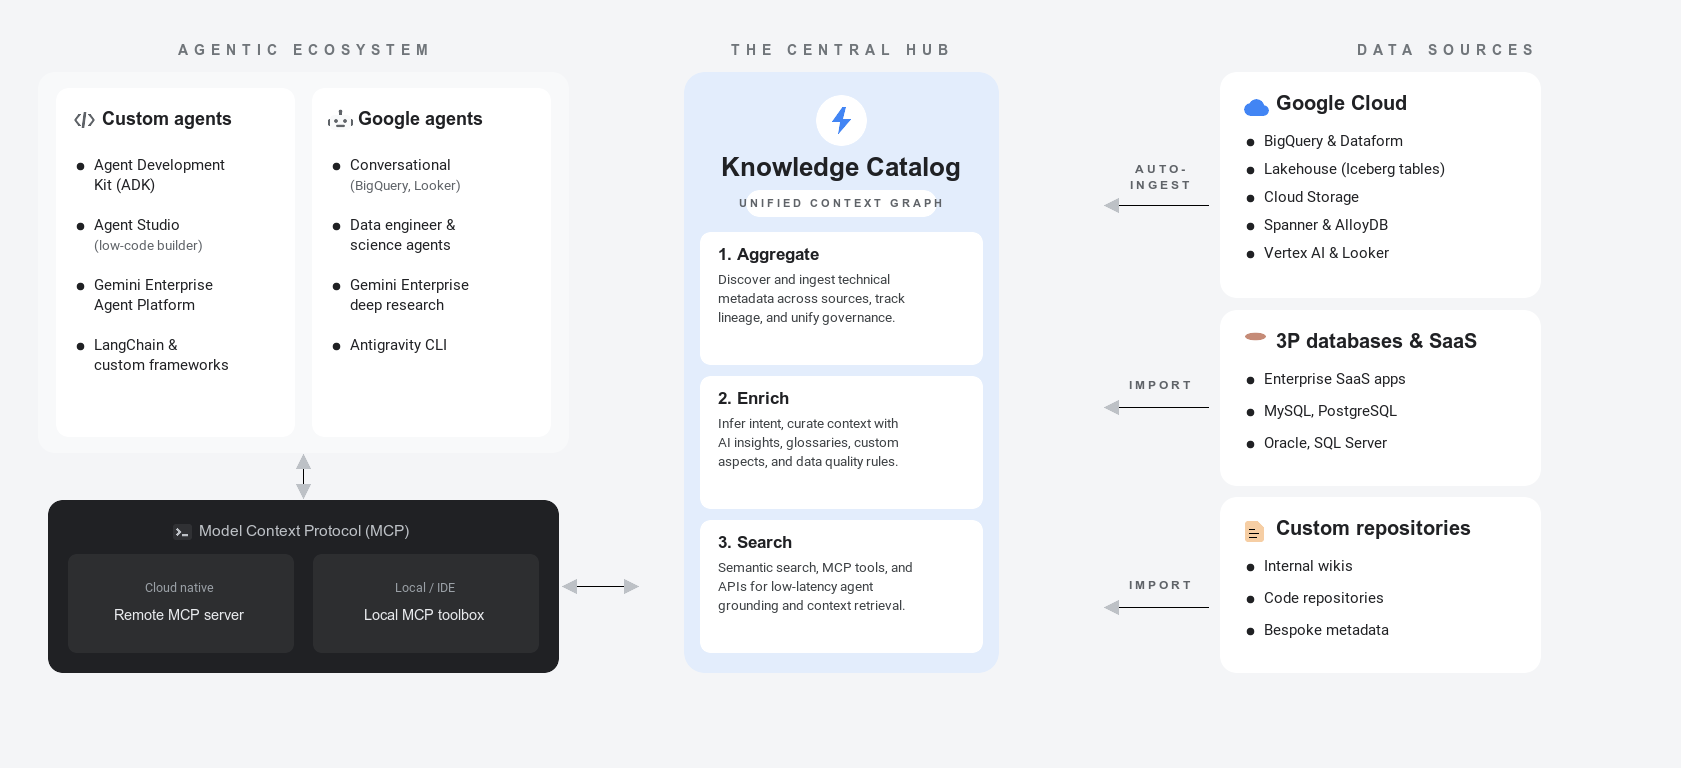
Knowledge Catalog מאחד את ניהול הנתונים וההקשר באמצעות מחזור חיים שמבוסס על שלושה עקרונות. הדיאגרמה הבאה ממחישה איך השירות ממפה נכסי נתונים פיזיים לסמנטיקה עסקית לצורך עיגון של סוכני AI:
למידע נוסף על מושגי המטא-נתונים האלה, אפשר לעיין במאמר מידע על מטא-נתונים.
בקטעים הבאים מתוארים שלושת העקרונות של מחזור החיים של המטא-נתונים, ומוסבר איך חברה קמעונאית מיישמת אותם על טבלאות מסד נתונים, קבצים ורשומות קטלוג חיצוניות:
צבירה (ב-Discover ובכלי להעלאת נתונים). Knowledge Catalog סורק ומבצע אינדוקס אוטומטי של מטא-נתונים טכניים בכל נכסי הנתונים שלכם בלי להעביר את הנתונים הבסיסיים:
- מסדי נתונים מובנים. תהליך קטלוג אוטומטי מתעד סכימות ומאפיינים בפלטפורמות כמו BigQuery, AlloyDB ל-PostgreSQL ו-Spanner.
- קישוריות מנוהלת. הגדרות של נתונים ממערכות חיצוניות, כמו Oracle או PostgreSQL, או ממאגרי מידע של שותפים, כמו Collibra, בלי לכתוב צינורות נתונים בהתאמה אישית.
- שושלת נתונים. אפשר לעקוב אחרי שינויים ברמת העמודה בכל צינורות הנתונים כדי לדעת מאיפה הנתונים מגיעים ואיך הם השתנו.
- דוגמה: חברה קמעונאית מבצעת באופן אוטומטי הטמעה של מטא נתונים של מסד נתונים טרנזקציוני, כמו טבלאות
ordersו-order_items, ומבצעת אינדוקס של קובצי מוצרים לא מובְנים שמאוחסנים בקטגוריות של Cloud Storage. הם מקשרים בין מסדי נתונים חיצוניים כדי ליצור אינדקס מאוחד של מטא-נתונים בספרייה שאפשר לגלות.
מידע נוסף על צבירת מטא-נתונים והטמעת נתונים (אפשר ללחוץ כדי להרחיב)
- מקורות נתונים נתמכים: רשימה של כל המקורות הנתמכים Google Cloud והחיצוניים להעברה אוטומטית.
- סקירה כללית על קישוריות מנוהלת: הסבר על הטמעה של סכימות טכניות ממערכות חיצוניות.
- מעקב אחרי מקורות הנתונים: הסבר על האופן שבו אפשר להציג חזותית את השינויים בצינורות הנתונים ברמת העמודה ואת זרימת הנתונים.
העשרה (יצירת הקשר ואימות האמינות). Knowledge Catalog מוסיף משמעות עסקית למבנים טכניים ויוצר אותות אמון:
- תובנות שנוצרו על ידי AI. Gemini מנתח יומני שאילתות כדי ליצור תיאורי עמודות, סיכומי טבלאות והמלצות לצירופים.
- הוספה לאינדקס של נתונים לא מובנים. סריקת ספריות של קבצים כדי לחלץ ישויות וקשרים מנכסים לא מובנים כמו קובצי PDF או תמונות.
- מילוני מונחים והיבטים. מיפוי של שמות מדדים פנימיים לאוצר מילים משותף באמצעות מונחים עסקיים ותבניות לוגיות.
- איכות הנתונים וזיהוי אנומליות. אכיפת הנחיות לניקוי נתונים והרצת סריקות של למידת מכונה כדי לזהות חריגות סטטיסטיות או בעיות ברעננות הנתונים, וכך ליצור אותות מהימנות מרכזיים.
- ביקורות בנושא ניהול. כדי לנהל את הסיכון, כדאי להשתמש בתהליכי בדיקה של תהליכי עבודה כדי לאמת עדכונים של מטא-נתונים לפני הפרסום.
- דוגמה: צוות הקמעונאות מעשיר נכסים על ידי הפעלת תובנות לגבי נתונים כדי להמליץ על תיאורי עמודות, והפעלת כללים של איכות נתונים. הם ממפים הגדרות עסקיות להזמנות פעילות על ידי יצירת מילוני מונחים והיבטים.
מידע נוסף על העשרת מטא-נתונים ואימות מהימנות (לחצו להרחבה)
- הגדרת תובנות לגבי נתונים: הסבר על יצירה אוטומטית של תיאורים וסיכומים של מערכי נתונים.
- ניהול מילוני מונחים עסקיים: במאמר הזה מוסבר איך להתאים אישית מונחים סטנדרטיים ולקסיקונים עסקיים.
- העשרת מטא-נתונים באמצעות היבטים: במאמר הזה מוסבר איך לצרף מאפיינים של מטא-נתונים מובְנים לנכסים לוגיים.
- שימוש חוזר בכללים לאיכות הנתונים: במאמר הזה מוסבר איך ליצור כללי אימות למסד נתונים ולעשות בהם שימוש חוזר.
- סקירה כללית של פרופיל נתונים: הסבר על הגדרת סריקות לאיתור חריגות בסכימה וסחיפה סטטיסטית.
חיפוש ואחזור (גישה וקרקוע). אפליקציות AI ומשתמשים עסקיים שולחים שאילתות לגרף ההקשר המאוחד כדי לגשת לנתונים בצורה בטוחה:
- הסוכנים פועלים לפי נתונים. לקשר את האפליקציות והסוכנים שמבוססים על LLM לקטלוג.
- Context API. ביצוע בקשות מטען ייעודי (payload) להארקה עם השהיה נמוכה.
- חיפוש סמנטי. מציאת הנכסים המתאימים באמצעות שאילתות בשפה טבעית.
- חבילת נתונים. חבילות של אוספי טבלאות, פרטי רישוי והסכמי SLA בחבילות נתונים מאובטחות בשירות עצמי.
- דוגמה: אנליסטים מבצעים חיפושים סמנטיים בשפה טבעית כדי לאתר נכסים. אפליקציות מבוססות-AI צורכות את האינדקס הזה בצורה מאובטחת באמצעות שרתי MCP או Context Retrieval API, ונכסים באיכות גבוהה נארזים בתצוגה מאובטחת.
מידע נוסף על אחזור הקשר ועל ביסוס הסוכן (לחיצה להרחבה)
- סקירה כללית על Model Context Protocol (MCP): הסבר על הדרך לגשר בין סוכני AI גנרטיביים ושכבות אפליקציה לבין הקשר של Knowledge Catalog.
- שליפת הקשר באמצעות LookupContext: במאמר הזה מוסבר איך לחלץ נתוני הפעלה חשובים להנחיית הסוכן.
- חיפוש נכסים: תיאור של יכולות חיפוש נכסים באמצעות תחביר של שאילתות סמנטיות בשפה טבעית.
Knowledge Catalog ב- Google Cloud ובסביבה העסקית של AI
כדי לבנות בסיס נתונים, חשוב להבין איך Knowledge Catalog משתלב עם שירותים קשורים.
Google Cloud מסדי נתונים ומודלים
- BigQuery. Knowledge Catalog סורק ומאנדקס באופן אוטומטי מערכי נתונים, טבלאות ותצוגות של BigQuery. הוא מפעיל תובנות מבוססות-נתונים מ-Gemini כדי לנתח את היסטוריית השאילתות, לפרסם תיאורים ולהציע דוגמאות מאומתות לשאילתות.
- Looker (Google Cloud core). ב-Knowledge Catalog אפשר להטמיע לוחות בקרה, תצוגות ומבנים של LookML, כמו תצוגות, ניתוחים, מאפיינים ומדדים. ההטמעה הזו יוצרת מיפויים של שושלת כדי לעקוב אחרי האופן שבו ערכים תפעוליים ממופים לסמנטיקה עסקית.
- קטלוג של Lighthouse בזמן ריצה. Knowledge Catalog משתלב עם Lighthouse, מאגר המטא-נתונים בזמן הריצה של עומסי עבודה של Iceberg בקוד פתוח. הוא מבצע אינדוקס אוטומטי של מטא-נתונים טכניים בנוסף לעומסי העבודה של Lighthouse, כדי לספק הקשר פעיל מאוחד.
פלטפורמות סוכני AI ועוזרים
- ניתוח נתוני שיחות. ממשקי הניתוח משתמשים במונחים מהקטלוג ובכלי חיפוש כדי לאפשר למשתמשים לשאול שאלות על מדדים עסקיים בשפה טבעית עם ביסוס מאומת.
- Gemini לסוכני AI. סוכני AI עם דיוק גבוה משתמשים במטא-נתונים של הקטלוג כדי להריץ חיפושים במסד הנתונים, וכך להפחית הזיות.
- Gemini Enterprise Agent Platform. Knowledge Catalog משמש כסטנדרט מרכזי לניהול נתונים בסביבות של פלטפורמות יעד. הוא מקושר לפלטפורמת הסוכנים של Gemini Enterprise כדי לספק כלים והקשר ל-Agent Registry של הפלטפורמה.
שילוב של מסד נתונים ושירות AIGoogle Cloud
Knowledge Catalog פועל לצד מוצרים אחרים של Google Cloud Google כדי ליצור את בסיס הנתונים שלכם. בטבלה הבאה מודגמת האינטגרציה של Knowledge Catalog עם שירותים קשורים והאופן שבו הוא משלים אותם:
| שירות | תפקיד ראשי | איך הוא משתלב עם Knowledge Catalog |
|---|---|---|
| Knowledge Catalog | פיקוח והקשר של סוכנים | הוא משמש כתרשים מאוחד של הקשר הסמנטי, מבצע סריקות של בדיקות איכות הנתונים וחושף סכימות מבוססות למודלים וליישומים של AI. |
| BigQuery | מחסן נתונים ארגוני | מאחסן, שולח שאילתות ומעבד מערכי נתונים; סורק, מאנדקס ומעשיר את הטבלאות האלה באופן אוטומטי בהיבטים של סיווג עסקי. |
| Vertex AI | פיתוח מודלים של AI | בנייה, פריסה ואירוח של מודלים בסיסיים. סוכנים מותאמים אישית מאחזרים הקשר של מטא-נתונים כדי לבסס את ההיגיון שלהם. |
| Cloud Storage | אחסון קבצים לא מובנה | אחסון של קבצים גולמיים לא מובְנים; הפעלת סריקות לא מובְנות של גילוי באופן אוטומטי כדי לנתח קובצי PDF ותמונות ולבנות מפות קשרים. |
סמנטיקה ופורמטים של נתונים
כדי לתת הנחיות למערכות מבוססות-סוכנים ולהנחות אותן בצורה יעילה, צריך להבחין בין מבנה נתונים פיזי לבין משמעות סמנטית:
- סמנטיקה. המשמעות העסקית, הכוונות והקשרים שמשויכים לנתונים. סכימות טכניות מגדירות מפרטים של אחסון מבני, כמו סוג מסד נתונים, אורך תווים או אילוץ של מספר שלם, אבל סמנטיקה מתארת את מה שמערך הנתונים מייצג בפועל. לדוגמה, אפשר למפות עמודה בשם
txn_qtyלהגדרה העסקית של 'כמות שנרכשה'. - נתונים מובְנים. מידע שמאוחסן בסכימות מוגדרות ובפורמטים יחסיים. לדוגמה, טבלאות BigQuery, מסדי נתונים של Spanner וטבלאות תפעוליות של Postgres. Knowledge Catalog סורק אוטומטית את המטא-נתונים האלה ומתעד עמודות ואילוצים.
- נתונים לא מובְנים. מידע לא מפורמט שמכיל טקסט גולמי או קובצי מדיה ללא סכימה מבנית. דוגמאות: גיליונות נתונים בפורמט PDF, אימיילים של תמיכת לקוחות ותמונות שמאוחסנות ב-Cloud Storage. ב-Knowledge Catalog מריצים סריקות לגילוי נתונים באמצעות תובנות מנתונים לא מובְנים, כדי לחלץ את היחסים בין ישויות בסיסיות ולתעד אותם בפרופיל גרף. זהו היבט מיוחד שמכיל צמתים וקשתות של יחסי ישויות שחולצו על ידי AI.
תזמור הקשר ב-Agentic Data Cloud
במסגרת Agentic Data Cloud של Google, Knowledge Catalog משמש כמישור תזמור סמנטי. במקום לדרוש מהמפתחים להקשיח ידנית סכימות של מסדי נתונים וכללים בהנחיות, מנוע ההקשר מספק באופן דינמי את ההקשר הסמנטי המדויק שסוכן צריך כדי לקבל החלטות חכמות.
באיור הבא מוצג איך Knowledge Catalog מתזמן ומספק הקשר לנתונים:
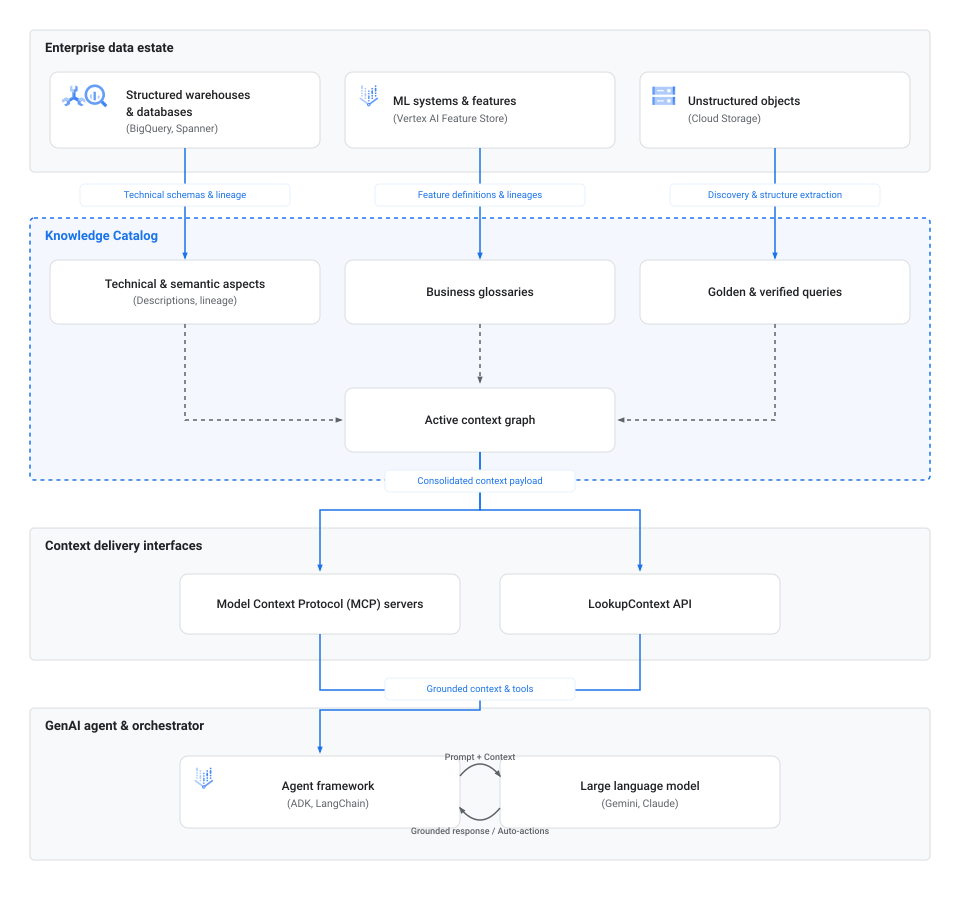
תהליך העבודה של תזמור ההקשר מורכב מהשלבים הבאים:
- הטמעה וגילוי. מסדי נתונים תפעוליים, מחסני נתונים כמו Spanner ו-BigQuery, מאגרי אובייקטים לא מובנים כמו Cloud Storage ומאגרי מטא-נתונים בזמן ריצה כמו Lighthouse מעבירים סכימות טכניות, מפות שושלת והגדרות מטא-נתונים ישירות אל Knowledge Catalog.
- מיפוי הקשר. ב-Knowledge Catalog, מאפייני המטא-נתונים האלה מקושרים לרכיבים סמנטיים, כולל היבטים טכניים, מילוני מונחים עסקיים ושאילתות מאומתות, כדי ליצור את גרף ההקשר הפעיל.
- ממשקי מסירה. אפליקציות מבוססות-AI וכלים לניהול תהליכים מאחזרים את גרף ההקשר המאוחד הזה באופן פרוגרמטי באמצעות מחברים סטנדרטיים, כמו MCP או נקודות קצה (endpoints) ישירות של
LookupContextAPI. - הארקה של סוכן. פלטפורמות תזמור, כמו Agent Development Kit (ADK) או LangChain, מזריקות את הקשר של המטא-נתונים הזה ישירות להנחיות של מודלים גדולים של שפה (LLM). ההחדרה הזו מעגנת את החשיבה הרציונלית של הסוכן בכללים ארגוניים מאומתים, וכך הוא יכול לשלוח שאילתות למסדי נתונים או לבצע פעולות אוטומטיות בלי הזיות.
פרופילים של סוכני AI
בהתאם לתהליכי העבודה שרוצים להפוך לאוטומטיים, אפשר ליצור סוגים שונים של סוכנים שמבוססים על Knowledge Catalog:
- סוכני גילוי נתונים. העוזרים האלה עוזרים למשתמשים לחפש בנכסי הנתונים ולנווט בהם. במקום להשתמש בהתאמה למילות מפתח, הם מנתחים כוונות ומגבלות בשפה טבעית כדי לאחזר את הנכסים הפיזיים הרלוונטיים ביותר.
- סוכני העשרה של מטא-נתונים. סוכני הרקע האלה מעבדים טקסט לא מובנה מתוך ויקי, קובצי README או יומני צ'אט, מנתחים את הטקסט למטא-נתונים רשמיים וכותבים את המטא-נתונים כ-aspects ב-Knowledge Catalog כדי לשמור על עדכניות המטא-נתונים.
- איכות הנתונים וסוכני צינורות העיבוד. הסוכנים האוטונומיים האלה מעריכים כללי איכות, מזהים סחיפה של סכימות ויוצרים או מתקנים צינורות להמרת נתונים על ידי שליחת שאילתות לגבי שושלת הנתונים וסטטיסטיקות הפרופיל.
כלי תזמור
כדי ליצור את הסוכנים האלה ולשלב אותם, אפשר להשתמש בכלים הבאים:
- Model Context Protocol (MCP). פרוטוקול פתוח וסטנדרטי לקישור סוכנים למקורות חיצוניים. אתם יכולים להגדיר סוכנים להתחבר לקטלוג באמצעות שרת MCP מרוחק או ארגז כלים מקומי של MCP. מידע נוסף זמין במאמר מידע על Model Context Protocol (MCP) ב-Knowledge Catalog.
- הערכה לפיתוח סוכנים (ADK). מסגרת מבית Google שמפשטת את התהליך של בנייה, הפעלה ובדיקה של סוכני AI גנרטיביים, ומציעה קשירות מובנות ל-Catalog Service API. מידע נוסף זמין ב דף הבית של ADK.
- LookupContext API. נקודת קצה של REST ו-gRPC API שמחלצת מטען ייעודי (payload) מאוחד של הקשר בפורמט YAML או JSON עבור נכסי נתונים, שמוכן להחדרה ישירה להנחיות של LLM. מידע נוסף מופיע במאמר אחזור הקשר באמצעות LookupContext API.
הקשר הגישה עם MCP
Model Context Protocol (MCP) הוא גשר סטנדרטי שמאפשר לסוכני AI ולכלים להתחבר בצורה חלקה למקורות נתונים כמו Knowledge Catalog. היעזרו בטבלת ההשוואה הבאה כדי לבחור את האפשרות הכי מתאימה לשילוב:
| הטמעה | מתאים במיוחד בשביל | הפרטים העיקריים | נקודת קצה או הגדרה |
|---|---|---|---|
| שרת MCP מרוחק | פריסות בענן, סביבות ללא שרת (serverless) כמו Cloud Run ושירותים חיצוניים מנוהלים. | נקודת קצה (endpoint) שמתארחת ב-Google ולא דורשת ניהול של שרת מקומי. | נקודת קצה: https://dataplex.googleapis.com/mcpהוראות להגדרה מופיעות במאמר שימוש בשרת MCP מרוחק. |
| ארגז כלים מקומי של MCP | פיתוח סוכנים מקומי, יצירת אב טיפוס מהיר ושילוב עם סביבות פיתוח משולבות (IDE) למחשב כמו VS Code או Cursor. | כלי שורת פקודה שפועל כפרוקסי מקומי בין סביבת Workspace לבין Knowledge Catalog. | נדרשת התקנה בינארית והגדרות של .mcp.json.הוראות להגדרה מופיעות במאמר שימוש בשרת MCP מקומי. |
שיטות מומלצות להקשר נתונים מבוסס-סוכן
כדי ליצור חוויות אג'נטיות מהימנות, חשוב לפעול לפי השיטות המומלצות הבאות כשמארגנים ומבצעים שאילתות של מטא-נתונים ב-Knowledge Catalog:
- הוספת היבטים סוכני AI לא יכולים להבחין בין טבלאות רשמיות של נתוני ייצור לבין טבלאות ארגז חול זמניות רק לפי השם. הגדירו והפעילו היבט מותאם אישית של אותות מהימנות כדי לאשר מוצרי נתונים סמכותיים, וכך לוודא שהסוכנים נותנים עדיפות לשאילתות למשאבים האלה או מגבילים אותן.
- אופטימיזציה של חיפושים באמצעות תקציבים לפי הקשר. כשקוראים ל-API
LookupContext, מציינים את הפרמטרcontext_budget. ה-API מבצע אופטימיזציה ומתאים קודם את המטא-נתונים הכי חשובים, כמו שושלת ותיאורים ראשוניים, בהתאם למגבלות האסימונים שצוינו. - ספק משאבים קשורים כדי לחשוף נתיבי הצטרפות. בשאילתות שכוללות הקשר, אפשר לציין עד 10 טבלאות או נכסים קשורים. כשמספקים קבוצה של נכסים, מנוע ההקשר מאכלס אוטומטית את נתיבי הצירוף ואת הקשרים, וכך הסוכן מבין איך הטבלאות מתקשרות.
- מבנה מילוני מונחים סמנטיים. להגדיר מונחים וקיצורים במילוני מונחים עסקיים. התקנון הזה עוזר לכלים לניהול שיחות לפתור בעיות שקשורות למילים נרדפות ולמדדים ספציפיים לעסק בצורה מדויקת.
- פרסום שאילתות לדוגמה. מצרפים שאילתות מאומתות בשפה טבעית ואת שאילתות ה-SQL המקבילות להן ישירות לרשומות ב-Knowledge Catalog. ההנמקה מבוססת על התבניות המאומתות האלה, וכך נמנעות שגיאות בהמרת SQL בסוכני text-to-SQL.
מעבר מ-Dataplex Universal Catalog ל-Knowledge Catalog
Dataplex Universal Catalog התפתח ל-Knowledge Catalog. מידע נוסף על המעבר הזה זמין במאמר מעבר מ-Dataplex Universal Catalog ל-Knowledge Catalog.
מגבלות
כשמתכננים את הפריסה, חשוב לקחת בחשבון את המגבלות הבאות:
שילובים נתמכים. אמנם Knowledge Catalog תומך במערכות עיקריות של צד שלישי, אבל יכול להיות שחלק מהחילוצים הסמנטיים האוטומטיים יוגבלו לשירותים מובנים Google Cloud .
מגבלות מכסה. מכסות ה-API Google Cloud הרגילות חלות על פעולות של אחזור הקשר וחילוץ מטא-נתונים.
המאמרים הבאים
מידע על הקשר של הנתונים
הסבר על האופן שבו הקשר פעיל הופך מטא-נתונים פסיביים לנתונים שמאפשרים לסוכני AI להישאר מבוססים על עובדות ולמנוע הזיות.
יצירת הקשר בסיסי לנתונים
ליצור מילון המונחים הארגוני, להגדיר סוגים מותאמים אישית של היבטים ולהעשיר נכסים ב-BigQuery.
סוכנים שפועלים על בסיס נתונים עם MCP
חיבור סוכני AI וכלים למפתחים אל Knowledge Catalog באמצעות Model Context Protocol.
חיפוש מקורות מידע
חיפוש ועיון במשאבים בקטלוג ב-Google Cloud ובמערכות של צד שלישי באמצעות שפה טבעית.
אוטומציה של סריקות לאיכות הנתונים
הגדרת כללי אימות ומעקב אחרי ניקיון הנתונים בטבלאות באמצעות סריקות איכות אוטומטיות.
תרחישי שימוש אינטראקטיביים
הסבר על פתרונות בעולם האמיתי להעשרת הקשר, לתיעוד מקורות הנתונים ולתהליכי עבודה מבוססי-סוכן.