


Knowledge Studio (Pratinjau) mengubah metadata menjadi mesin konteks aktif yang membantu Anda meningkatkan keandalan aplikasi AI generatif. Anda dapat menggunakan Knowledge Studio untuk mencegah halusinasi pada agen AI, seperti analisis percakapan di BigQuery dan Gemini, dengan mendasarkannya pada konteks bisnis Anda.
Knowledge Studio mengotomatiskan seleksi metadata dengan menyatukan pengetahuan yang terfragmentasi dari skema, wiki, dan kueri SQL sebelumnya. Anda dapat menjelajahi data menggunakan bahasa alami, menavigasi grafik konteks visual yang menghubungkan aset data ke semantik bisnis, dan menjalankan alur kerja otomatis yang menyusun draf pembaruan katalog untuk ditinjau oleh manusia. Kemudian, Anda dapat menyajikan blok konteks yang diseleksi ini secara dinamis kepada agen menggunakan Model Context Protocol (MCP) atau Knowledge Catalog API.
Dokumen ini ditujukan untuk arsitek data, pimpinan tata kelola, dan engineer AI yang ingin memahami cara kerja Knowledge Studio.
Dari katalog pasif menjadi mesin konteks aktif
Katalog metadata standar menyimpan skema, deskripsi, dan kamus data statis. Meskipun cukup bagi analis data manusia yang menelusuri tabel, metadata statis tidak cukup untuk agen AI generatif yang memerlukan hal berikut:
Hubungan semantik yang mendalam: Memahami cara tabel bergabung di seluruh skema, kolom mana yang mewakili metrik bisnis utama, dan cara glosarium bisnis dipetakan ke penyimpanan yang mendasarinya.
Grounding operasional: Memasukkan pola penggunaan SQL di dunia nyata, frekuensi kueri, serta perintah dan respons agen yang sebenarnya ke dalam konteks.
Pembelajaran mandiri berkelanjutan: Otomatis menyempurnakan deskripsi tabel, aspek, dan definisi kolom berdasarkan masukan pengguna dan rasio keberhasilan eksekusi agen.
Knowledge Studio menghadirkan kemampuan ini melalui mesin konteks yang selalu aktif yang terus-menerus menambang sinyal operasional, menghasilkan proposal metadata berakurasi tinggi, dan menyajikan blok konteks yang telah diformat sebelumnya kepada agen melalui Model Context Protocol (MCP) atau Knowledge Catalog Catalog API.
Antarmuka Knowledge Studio
Knowledge Studio mengatur alur kerja Anda ke dalam tiga area utama:
Chat baru: Antarmuka chat percakapan dan grafik konteks interaktif untuk penemuan data, investigasi, dan validasi kueri semantik menggunakan bahasa alami. Untuk mengetahui informasi selengkapnya, lihat Mempelajari aset data.
Set konteks: Antarmuka untuk membuat dan mengelola container logis (grup entri) yang mengemas metadata yang diperkaya untuk melakukan grounding agen AI downstream dengan aman. Untuk mengetahui informasi selengkapnya, lihat Mengelola set konteks.
Pengayaan: Pusat kontrol untuk mengotomatiskan pembuatan metadata, mengonfigurasi tolok ukur evaluasi, dan meninjau pembaruan katalog yang diusulkan AI (permintaan perubahan) dengan alur kerja seleksi yang memerlukan interaksi manusia. Untuk mengetahui informasi selengkapnya, lihat Tentang tugas pengayaan.
Skenario multiproduk di dunia nyata
Knowledge Studio menghubungkan data warehouse, repositori pengetahuan perusahaan, dan aplikasi AI generatif Anda. Skenario berikut menggambarkan cara Knowledge Studio beroperasi di beberapa produk dalam arsitektur perusahaan.
Melakukan grounding kueri bahasa alami di BigQuery
Tantangan: Analis bisnis menggunakan bahasa alami dalam analisis percakapan untuk mengajukan pertanyaan seperti "Berapa rasio retensi bersih kita menurut wilayah pada kuartal terakhir?" Tanpa semantik bisnis yang diseleksi, model mungkin akan berhalusinasi tentang kunci gabungan atau salah mengira pemesanan kotor sebagai pendapatan bersih.
Solusi Knowledge Studio: Analis menggunakan antarmuka New chat untuk memverifikasi hubungan antara tabel staging penjualan dan
SZBank Business Glossaryyang tersertifikasi. Knowledge Studio mendasarkan analisis percakapan menggunakan grafik konteks aktif, sehingga memastikan SQL yang dihasilkan menyertakan kondisi gabungan yang diverifikasi dan formula KPI standar.
Memperkaya metadata dari SOP perusahaan
Tantangan: Tim data engineering mengelola puluhan set data di BigQuery, sementara aturan bisnis penting dan silsilah pipeline berada di wiki Confluence eksternal atau tiket Jira. Seiring berkembangnya skema, dokumentasi katalog menjadi usang.
Solusi Knowledge Studio: Pemimpin tata kelola mengonfigurasi Tugas pengayaan berulang yang menargetkan set data analisis. Knowledge Studio menyerap SOP tidak terstruktur dari Confluence dan log kueri historis dari Cloud Logging, yang otomatis mengusulkan definisi kolom dan hubungan tabel yang diperbarui. Pengelola memeriksa perbedaan yang diusulkan di halaman Run Details dan menyetujui update yang diverifikasi ke katalog.
Memberikan konteks yang diseleksi kepada agen
- Tantangan: Developer AI yang membangun agen dukungan atau penasihat yang berinteraksi dengan pelanggan menggunakan LangChain atau ADK memerlukan semantik skema baru tanpa melakukan hardcoding kredensial database atau memasukkan definisi tabel besar ke dalam prompt.
- Solusi Knowledge Studio: Knowledge Studio menangkap metadata yang diseleksi dan grafik gabungan yang divalidasi ke dalam set konteks (seperti
entryGroups/customer-360). Untuk mengakses konteks, agen dapat terhubung ke Knowledge Studio melalui Model Context Protocol (MCP) atau menggunakan API Katalog Knowledge Catalog. Pada waktu inferensi, agen akan mengkueri endpoint MCP atau Catalog API untuk mengambil konteks bisnis bersertifikasi dan contoh kueri yang relevan dengan niat pengguna secara dinamis.
Ringkasan arsitektur
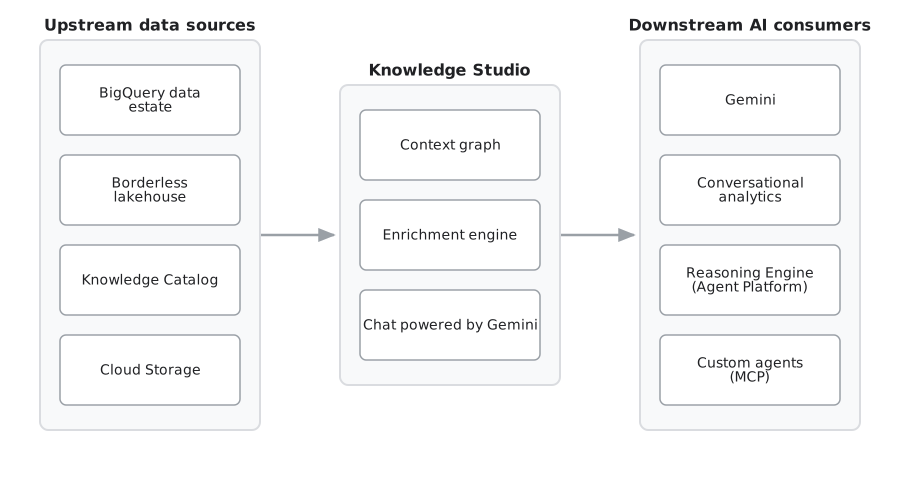
Diagram berikut mengilustrasikan cara komponen Knowledge Studio berinteraksi dengan estate data, model dasar, dan aplikasi AI yang menggunakan:
Konsep inti
Agar dapat bekerja secara efektif dengan Knowledge Studio, pahami cara metadata perusahaan dimodelkan, dipaketkan, dan diseleksi.
Grafik konteks
Grafik konteks adalah topologi visual interaktif pusat di Knowledge Studio. Dataplex menyatukan aset data Anda (seperti tabel, tampilan, dan lakehouse BigQuery) dengan semantik bisnis (seperti istilah glosarium bisnis, formula metrik, dan produk data). Dalam katalog biasa, tabel data dan definisi glosarium bisnis terkaitnya berada dalam silo terpisah. Dalam grafik konteks, keduanya ada sebagai node di
kanvas yang sama. Analis dan engineer data dapat melihat hubungan antara data mereka secara visual, baik melalui penggunaan yang disimpulkan, kondisi penggabungan pada tabel, dan lainnya, sementara Gemini menggunakan grafik untuk mendasari eksplorasi bahasa alami. Untuk mengetahui informasi selengkapnya, lihat Menjelajahi aset data di Knowledge Studio.
Jenis resource dan koneksi yang didukung untuk grafik konteks
Grafik konteks mendukung rendering resource Knowledge Catalog berikut sebagai node atau container:
- Tabel dan tampilan: Tabel, tampilan, set data, dan katalog BigQuery dan Lakehouse teknis.
- Database dan penyimpanan: Database operasional (seperti Spanner dan AlloyDB) serta resource Cloud Storage.
- Analisis dan pemodelan: Project Looker serta model, pengujian, dan eksposur dbt.
- Istilah glosarium: Definisi bisnis individual dari glosarium bisnis.
- Produk data: Paket aset data yang diseleksi untuk digunakan lintas tim.
- Konteks: Kumpulan konteks kustom dan dokumentasi yang dilampirkan.
- Aset kustom: Grup entri kustom dan jenis entri yang tidak didukung.
Grafik ini menentukan cara resource ini terhubung dengan memvisualisasikan edge hubungan semantik berikut:
Gabungan skema: Hubungan gabungan struktural dan operasional antar-tabel. Sistem akan otomatis memindai tugas BigQuery untuk mencari kueri yang menunjukkan bahwa kolom di berbagai tabel memiliki arti yang sama dan dapat digabungkan.
Definisi: Link yang memetakan aset atau kolom data teknis ke definisi glosarium bisnis yang sesuai.
Konteks: Menautkan set konteks khusus atau dokumentasi domain kustom ke aset data target.
Paket: Link agregasi yang menunjukkan aset data mana yang dipaketkan ke dalam produk data tertentu.
Link entri
Link entri mewakili edge semantik terarah atau tidak terarah dalam grafik konteks. Link ini secara visual menggabungkan aset data Anda dan resource terpadu lainnya di kanvas. Anda dapat memfilter link ini secara selektif untuk mengisolasi hubungan tertentu di seluruh aset data Anda.
Link entri menghubungkan entitas yang berbeda di seluruh perusahaan Anda:
Link definisi: Menghubungkan kolom tabel pokok secara langsung ke istilah glosarium bisnis dan formula KPI yang tersertifikasi.
Link hubungan: Memetakan kunci utama, kunci asing, dan jalur gabungan multi-tabel yang diverifikasi.
Link pelacakan agen: Mengaitkan perintah pengguna AI di dunia nyata dengan tabel tertentu yang digunakan untuk menjawabnya.
Link paket: Menggabungkan set aset data ke produk data yang diseleksi.
Link entri berfungsi sebagai koneksi individual yang dilalui untuk menyusun set konteks. Selama proses pengayaan otomatis, agen akan mengusulkan link entri baru untuk persetujuan kurator setiap kali mengidentifikasi kandidat gabungan atau istilah yang tidak ditautkan.
Set data konteks
Set konteks adalah penampung terbatas yang berisi informasi semantik dan referensi aset data. Setiap set konteks diimplementasikan sebagai Grup Entri khusus (type="context-set").
Set konteks menetapkan batas eksekusi hermetis yang mencegah agen melakukan penelusuran terbuka di seluruh katalog perusahaan. Metode ini mengurangi halusinasi dan konsumsi token.
Untuk memahami perbedaan set konteks dari konstruksi terkait, seperti produk data dan grafik konteks semantik, atau untuk mengetahui kemampuan arsitektur, kategori, namespace, dan pola konsultasi agen yang mendetail, lihat Ringkasan set konteks.
Tugas dan operasi pengayaan
Peningkatan metadata otomatis di Knowledge Studio diatur ke dalam tugas pengayaan, tugas pengayaan, dan eksekusi pengayaan.
Tugas pengayaan: Konfigurasi tahan lama yang menentukan cara agen pengayaan menganalisis kumpulan aset data yang ditargetkan. Tugas pengayaan menentukan set konteks target, sumber input kontekstual, dan tolok ukur evaluasi.
Tugas pengayaan: Proses orkestrasi backend dalam Knowledge Studio yang menjalankan tugas pengayaan.
Enrichment run: Satu instance eksekusi tugas pada waktu tertentu. Setiap operasi akan memeriksa aset target, mengekstrak sinyal semantik, dan menghasilkan permintaan perubahan (proposal) yang dapat ditinjau oleh data steward.
Untuk mengetahui informasi selengkapnya tentang alur kerja pengayaan, lihat Tentang tugas pengayaan.
Perbandingan grafik konteks dengan silsilah data
Memahami perbedaan antara grafik konteks Knowledge Studio dan silsilah data Knowledge Catalog sangat penting untuk memilih alat yang tepat.
Silsilah data melacak pergerakan operasional dan transformasi data yang mendasarinya dari waktu ke waktu. Silsilah menjawab pertanyaan seperti: Dari mana data ini berasal? Pipeline ETL apa yang mengisi tabel ini? Jika skema upstream ini berubah, dasbor downstream mana yang akan rusak? Node mewakili aset dan tugas transformasi yang mendasarinya (seperti pipeline Dataflow atau tugas BigQuery), dan edge terarah mewakili aliran data yang mendasarinya.
Grafik konteks memodelkan semantik, hubungan, dan pengetahuan domain bisnis. Grafik konteks menjawab pertanyaan seperti: Apa arti kolom ini dalam istilah bisnis? Bagaimana hubungan kedua tabel ini secara konseptual? Bagaimana seharusnya agen AI menggabungkan aset ini untuk menjawab pertanyaan? Node merepresentasikan aset pokok bersama dengan entity konseptual (seperti istilah glosarium, formula KPI, dan produk data), dan edge merepresentasikan koneksi semantik (seperti link definisi kolom ke glosarium dan kondisi gabungan yang diverifikasi).
Untuk mengetahui informasi selengkapnya tentang keterlacakan pipeline, lihat Silsilah data Knowledge Catalog.
Keamanan dan tata kelola perusahaan
Knowledge Studio dibangun di atas arsitektur keamanan tingkat perusahaan yang dirancang untuk lingkungan yang diatur secara ketat.
Identitas eksekusi yang dikelola pengguna: Tugas pengayaan dijalankan menggunakan akun layanan yang dikelola pengguna, yang merupakan identitas yang Anda buat dan kelola dalam project Anda untuk memungkinkan layanan bertindak atas nama Anda. Agen Layanan Dataplex (P4SA) meniru akun layanan ini menggunakan peran Service Account Token Creator (
roles/iam.serviceAccountTokenCreator) untuk membuat kredensial OAuth 2.0 yang berumur singkat. Membuat kredensial berumur singkat ini membatasi masa aktif token akses, sehingga meminimalkan risiko eksposur kredensial dibandingkan dengan menggunakan kunci akun layanan berumur panjang.Autentikasi pihak ketiga: Menghubungkan sumber pengetahuan SaaS jarak jauh (seperti Microsoft SharePoint, Atlassian Confluence, Jira, dan GitHub) menggunakan Pengelola Autentikasi Agent IdentityGoogle Cloud, sehingga memastikan operator manusia tidak pernah menangani rahasia klien mentah.
Untuk mengetahui informasi tentang cara mengonfigurasi fitur keamanan ini, lihat Mengonfigurasi prasyarat pengayaan.
Batasan
Sistem kepatuhan Assured Workloads (termasuk FedRAMP, CJIS, IL4/IL5, dan HIPAA).
Komitmen Residensi Data (DRZ). Data yang diproses oleh fitur ini mungkin disimpan atau diproses di luar batas geografis yang dikonfigurasi secara ketat.
Kunci enkripsi yang dikelola pelanggan (CMEK). Data yang disimpan atau diproses oleh fitur ini dienkripsi menggunakan Google-owned and Google-managed encryption keysmilik Google, bukan Cloud Key Management Service atau kunci Cloud EKM Anda.
Kontrol Layanan VPC. Kontrol Layanan VPC tidak didukung.
Notifikasi Transparansi Akses (AXT) dan kontrol Persetujuan Akses. Tindakan yang dilakukan oleh personel Google untuk mendukung atau mengelola pratinjau ini tidak akan dicatat dalam Cloud Access Ledger (CAL) Transparansi Akses Anda.
Selama Pratinjau, Knowledge Studio beroperasi dalam batasan tambahan berikut:
Cakupan regional set konteks: Set konteks global yang ditautkan ke aset data regional tidak didukung. Set konteks harus selaras dengan batas regional aset yang dipaketkan.
Pengelolaan yang mengutamakan konsol: Tugas pengayaan dan sesi eksplorasi dikelola melalui konsol Google Cloud . REST API langsung dan perintah CLI
gclouduntuk pengelolaan tugas tidak tersedia di Pratinjau. Namun, agen downstream dapat menemukan dan mengkueri set konteks yang diseleksi secara terprogram menggunakan Catalog API Knowledge Catalog (ListEntries,LookupEntry) dan Model Context Protocol (MCP).Pengelolaan terpusat: Semua peninjauan dan persetujuan metadata dilakukan dalam halaman Detail operasi pengayaan.
Tidak ada SKU penagihan mandiri: Knowledge Studio tidak memperkenalkan SKU produk terpisah. Biaya penggunaan mencerminkan konsumsi standar resource yang mendasarinya ( Gemini Reasoning Engine, BigQuery, dan Cloud Storage).
Langkah berikutnya
Menjelajahi aset data dan grafik konteks
Gunakan kanvas visual di Knowledge Studio untuk melakukan chat dengan data Anda dan melacak hubungan semantik.
Tentang konteks data
Pahami cara konteks aktif mengubah metadata pasif untuk membumikan agen AI dan mencegah halusinasi.
Ringkasan set konteks
Pelajari container konteks paket Knowledge Studio yang digunakan untuk melakukan grounding agen AI downstream Anda dengan aman.
Tentang tugas pengayaan
Pelajari cara mengonfigurasi alur kerja ekstraksi metadata berbasis AI untuk membangun konteks data secara otomatis.
Menetapkan konteks data dasar
Membangun glosarium bisnis, menentukan jenis aspek kustom, dan memperkaya aset di BigQuery.
Meng-grounding agen dengan MCP
Hubungkan agen AI dan alat developer ke Knowledge Catalog menggunakan Model Context Protocol.