


Tugas pengayaan adalah agen otonom di Knowledge Catalog yang membantu data steward dan engineer platform menskalakan operasi metadata mereka. Tugas pengayaan terus menganalisis skema set data Anda, membaca dokumentasi perusahaan Anda, dan membuat deskripsi yang diusulkan untuk aset data Anda. Untuk mendapatkan hasil maksimal dari tugas pengayaan, Anda harus memahami konsep inti Knowledge Catalog dan arsitektur data organisasi Anda.
Dengan mengotomatiskan pembuatan metadata, tugas pengayaan mengurangi beban seleksi manual sekaligus memastikan katalog Anda mencerminkan konteks yang akurat dan spesifik untuk bisnis.
Alasan menggunakan tugas pengayaan
Tugas pengayaan mengatasi tantangan dalam menjaga katalog data berskala besar tetap akurat dan terbaru.
| Aspek | Pendekatan konvensional | Pendekatan Knowledge Studio |
|---|---|---|
| Proses | Deskripsi yang ditulis tangan. Pengelola meninjau ribuan tabel secara manual dan mewawancarai pakar domain. | Berbasis agen. Agen otonom menganalisis data dan membaca prosedur operasi standar. |
| Kecepatan dan skala | Lambat dan sulit dikelola seiring perubahan skema dari waktu ke waktu. | Sangat skalabel. Proposal metadata berkualitas tinggi dibuat secara terus-menerus. |
| Upaya manusia | Tinggi. Entri data manual yang ekstensif dan pemeliharaan berkelanjutan. | Rendah. Petugas data hanya perlu meninjau dan menyetujui saran yang dihasilkan. |
Kasus penggunaan tugas pengayaan
Tugas pengayaan membantu organisasi menyelesaikan tantangan metadata umum berikut:
Integrasi akuisisi: Sebuah perusahaan mengakuisisi unit bisnis baru dengan ribuan aset data yang tidak terdokumentasi. Data engineer mengarahkan tugas pengayaan ke set data baru, menggunakan kamus data perusahaan yang diakuisisi sebagai sinyal pengetahuan. Agen mengusulkan deskripsi yang selaras dengan bisnis untuk seluruh set data dalam hitungan jam, bukan bulan.
Dokumentasi berkelanjutan: Tim platform engineering membangun lakehouse dinamis dengan skema yang berubah setiap hari. Mereka mengonfigurasi tugas pengayaan untuk dijalankan sesuai jadwal harian dengan publikasi otomatis diaktifkan, sehingga memastikan bahwa katalog selalu mencerminkan perubahan skema terbaru.
Tata kelola semantik: Kantor data pusat ingin menstandarkan terminologi di semua departemen. Mereka men-deploy tugas pengayaan yang merujuk ke glosarium Knowledge Catalog yang diseleksi. Agen secara otomatis menandai dan mengusulkan penggantian untuk deskripsi tabel yang melanggar istilah glosarium perusahaan yang disetujui.
Konsep inti
Saat mengonfigurasi tugas pengayaan, Anda menentukan komponen inti berikut:
- Tugas pengayaan
-
Konfigurasi yang menentukan tindakan yang harus dilakukan agen. Tugas berisi set konteks, resource target, jadwal, dan sinyal pengetahuan yang Anda berikan.
Misalnya, tugas yang dikonfigurasi untuk menginstruksikan agen agar membaca repositori GitHub Anda dan memperkaya set data
financeAnda setiap hari Minggu tengah malam. - Tugas pengayaan
- Proses orkestrasi backend dalam Knowledge Studio yang menjalankan tugas pengayaan.
- Enrichment run
-
Satu instance eksekusi tugas pada waktu tertentu. Konsol Knowledge Studio menyertakan tab Jobs yang mencantumkan operasi historis untuk tugas, dan Anda dapat membuka operasi tertentu untuk meninjau proposal metadata yang dihasilkannya.
Misalnya, instance eksekusi tertentu yang terjadi pada 24 Oktober dan menghasilkan 15 usulan perubahan kolom.
- Set data konteks
-
Penampung terbatas untuk aset dan metadata data target. Setiap tugas pengayaan harus dikonfigurasi untuk menargetkan tepat satu set konteks. Set konteks dapat berisi resource target, seperti set data BigQuery atau Lakehouse, tetapi Anda juga dapat membuat set konteks kosong jika belum ada.
Misalnya, set konteks pemasaran yang secara logis mengikat tabel kampanye, metrik ROAS, dan glosarium terminologi Anda ke dalam satu batas konteks AI.
- Sinyal pengetahuan
- Materi eksternal yang mendasari agen dalam realitas perusahaan Anda. Dengan menyediakan bucket Cloud Storage yang berisi kamus data, glosarium Knowledge Catalog, atau URL dokumentasi internal, Anda memastikan agen menggunakan logika bisnis spesifik Anda, bukan membuat tebakan umum.
- Set evaluasi
-
Pertanyaan pengujian dan SQL yang sesuai (disediakan dalam format
.jsonl) yang digunakan untuk menilai akurasi agen. Saat mengusulkan metadata baru, agen akan menjalankan pertanyaan pengujian ini terhadap proposal untuk memastikan akurasi tidak menurun sebelum dipublikasikan.Misalnya, memberikan pertanyaan pengujian seperti "Berapa MRR kita?" yang dipasangkan dengan kueri SQL yang tepat yang diperlukan untuk menghitung Pendapatan Berulang Bulanan. Jika agen mengusulkan metadata yang membingungkan yang menyebabkan kueri pengujian ini gagal, usulan tersebut akan ditandai.
- Sumber pembelajaran mandiri
-
Log percakapan langsung dari aplikasi Gemini Enterprise atau analisis agen BigQuery Anda. Agen membaca log chat ini untuk mengidentifikasi pertanyaan pengguna, menemukan kesenjangan pengetahuan yang hilang, dan otomatis mengusulkan metadata baru untuk mengisi kesenjangan tersebut.
Misalnya, jika log chat menunjukkan bahwa pengguna sering bertanya "Apa arti kode status 42?" dan agen gagal menjawab, pembelajaran mandiri akan memicu proposal metadata untuk mendokumentasikan kode status yang tidak ada tersebut.
Sumber data dan integrasi yang didukung untuk tugas pengayaan
Tugas pengayaan terintegrasi dengan sistem Google Cloud dan sistem pihak ketiga.
Aset data target
Agen pengayaan dapat langsung memperkaya dan menambahkan aset data targetGoogle Cloud berikut ke set konteks Anda:
Set data, tabel, dan tampilan BigQuery
Data lake, zona, dan aset Lakehouse
Melalui integrasi Lakehouse, Knowledge Studio secara tidak langsung mendukung pengayaan metadata dari sumber pihak ketiga yang dilampirkan melalui integrasi Iceberg REST Catalog (seperti Databricks Unity, Snowflake Horizon, AWS Glue Data Catalog, dan SAP Business Data Cloud).
Sinyal pengetahuan
Selama proses pengayaan, agen mengekstrak aturan semantik, konteks bisnis, dan pengetahuan domain dari sumber hanya baca berikut:
Google Cloud:
- Bucket Cloud Storage yang berisi format file yang didukung (seperti PDF, CSV, Markdown, konfigurasi, set data, dan file teks tidak terstruktur)
- Glosarium bisnis Knowledge Catalog yang berada dalam cakupan regional yang sama
- Aplikasi Google Workspace, termasuk file Google Drive (seperti Dokumen, Spreadsheet, Slide, PDF, file, dan dokumen teks umum)
Sistem pihak ketiga (Non-Google Cloud):
- File Microsoft SharePoint berukuran kurang dari 5 MB (seperti PDF, file Office, dan dokumen teks umum, tidak termasuk format lama atau gambar)
- Repositori GitHub (file apa pun yang berisi teks yang dapat dibaca)
- Isi halaman Atlassian Confluence
Sumber pembelajaran mandiri
Untuk mengidentifikasi kesenjangan pengetahuan dari log interaksi nyata, agen pengayaan menambang lintasan dari hal berikut:
- Aplikasi Gemini Enterprise
- Tabel BigQuery Agent Analytics
- Cloud Logging menggunakan tampilan log tercakup
Cara kerja agen pengayaan
Saat Anda memicu tugas pengayaan—baik on-demand maupun sesuai jadwal berulang—proses pengayaan akan dimulai. Agen pengayaan dijalankan secara asinkron di latar belakang, menganalisis aset data, trace kueri, dan dokumentasi Anda untuk menghasilkan proposal metadata yang diverifikasi.
Diagram berikut mengilustrasikan arsitektur alur kerja tingkat tinggi dari agen pengayaan:
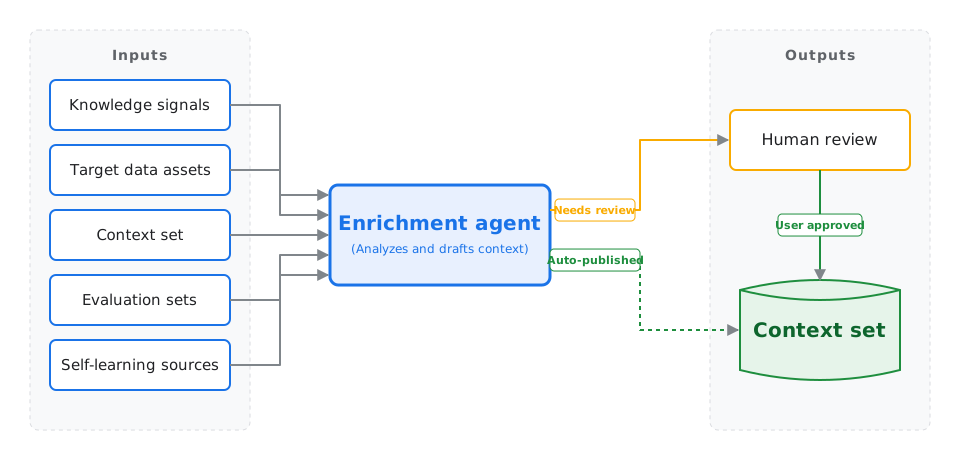
Agen akan mengumpulkan set konteks Anda melalui empat fase utama:
- Menganalisis sinyal dan dokumentasi: Agen menambang log interaksi untuk menemukan bagian yang menyulitkan agen AI downstream atau memerlukan disambiguasi. Alat ini memindai dokumen perusahaan di Cloud Storage atau aplikasi pihak ketiga yang ditautkan, dan memeriksa histori kueri untuk menemukan penggabungan tabel frekuensi tinggi dan dependensi upstream.
- Menyusun draf proposal konteks: Dipandu oleh sasaran seleksi Anda, agen menyusun draf konteks terstruktur untuk aset target Anda. Hal ini mencakup ringkasan tabel yang berorientasi bisnis, formula metrik formal, kondisi gabungan yang diverifikasi, dan template kueri SQL berbasis parameter emas.
- Tolok ukur dan pengoptimalan: Dengan menggunakan pertanyaan pengujian dari set evaluasi Anda, agen akan menguji metadata drafnya sendiri secara berulang, sehingga menyempurnakan deskripsi hingga akurasi kueri downstream dimaksimalkan. Kemudian, model ini menjalankan kueri pengujian yang ditahan untuk menghitung tingkat error regresi. Setiap aturan deskripsi atau metrik yang diusulkan diberi skor keyakinan.
- Menerapkan kebijakan peninjauan: Proposal yang memenuhi nilai minimum keyakinan akan memicu aturan kebijakan Anda. Jika Anda mengaktifkan publikasi otomatis dan tingkat error regresi berada dalam batas yang diizinkan, perubahan akan digabungkan secara otomatis. Jika error regresi melebihi batas yang diizinkan, publikasi otomatis akan segera dihentikan, dan semua proposal akan dikemas ke dalam satu permintaan perubahan untuk ditinjau secara manual.
Keamanan data dan tata kelola
Karena tugas pengayaan Knowledge Studio menggunakan kecerdasan buatan untuk menganalisis skema data dan dokumentasi internal Anda, platform ini menerapkan batasan yang ketat untuk melindungi informasi eksklusif Anda.
Pelatihan model dasar: Data Anda tetap menjadi milik Anda. Trace eksekusi, skema database, dan sinyal pengetahuan yang diberikan pelanggan (seperti dokumen atau glosarium internal) tidak pernah digunakan untuk melatih model dasar Google.
Sanitasi data: Sebelum metadata yang diusulkan ditulis ke dalam set konteks, agen akan otomatis menyamarkan informasi identitas pribadi (PII) dari log sistem dan pelacakan pembuatan.
Batas eksekusi: Agen pengayaan beroperasi dalam tenant yang aman dan dikelola Google. Gemini Code Assist menjangkau sumber data pribadi Anda dengan aman menggunakan antarmuka Private Service Connect dan proxy egress yang dikontrol pelanggan.
Status kepatuhan: Selama fase Pratinjau saat ini, tugas pengayaan tidak mendukung Kontrol Layanan VPC (VPC-SC), Kunci Enkripsi yang Dikelola Pelanggan (CMEK), atau Assured Workloads.
Konfigurasi yang direkomendasikan
Knowledge Catalog menyediakan beberapa setelan opsional untuk tugas pengayaan. Sebaiknya mulai dengan konfigurasi dasar dan aktifkan fitur lanjutan secara progresif seiring Anda menskalakan operasi metadata.
| Konfigurasi | Komponen yang disertakan | Publikasikan otomatis | Direkomendasikan untuk |
|---|---|---|---|
| Basic | Set data konteks | Nonaktif | Menguji alat. Memungkinkan Anda melihat cara agen menyimpulkan metadata secara ketat dari skema set data Anda. Anda harus meninjau semua proposal secara manual. |
| Grounded |
|
Nonaktif | Lingkungan produksi. Mendasarkan agen pada logika bisnis spesifik Anda, menggunakan prosedur operasi standar dan glosarium Anda untuk meningkatkan akurasi. |
| Otomatis |
|
Aktif | Menskalakan operasi metadata. Set Evaluasi berfungsi sebagai batasan keamanan. Jika proposal yang dibuat otomatis menyebabkan regresi dalam akurasi downstream, publikasi akan dihentikan untuk peninjauan manual. |
| Pembelajaran mandiri |
|
Aktif | Katalog lanjutan dan otonom. Agen terus beradaptasi dengan menganalisis interaksi pengguna langsung dan log chat agen untuk mengidentifikasi dan menambal kesenjangan pengetahuan. |
Batasan dan batas pratinjau
Selama Pratinjau, tugas pengayaan beroperasi dalam batasan berikut:
Pengelolaan yang mengutamakan konsol: Anda mengonfigurasi dan mengelola tugas secara eksklusif melalui konsol Google Cloud . REST API publik langsung dan perintah CLI
gcloudtidak tersedia di Pratinjau.Kuota dan batas: Tugas pengayaan dan eksekusi tugas tunduk pada kuota resource regional dan kuota kapasitas per project. Untuk mengetahui informasi selengkapnya, lihat bagian tugas pengayaan Knowledge Studio di Kuota dan batas.
Siklus proses deployment
Proses membangun dan men-deploy tugas pengayaan mengikuti siklus proses linear:
- Konfigurasi prasyarat: Berikan peran yang diperlukan, konfigurasi akun layanan, serta aktifkan pembuatan profil data dan insight data AI pada tabel yang sering digunakan. Untuk mengetahui informasi selengkapnya, lihat Mengonfigurasi prasyarat untuk tugas pengayaan.
- Menautkan pengetahuan eksternal: Izinkan tugas untuk membaca file dari Google Drive atau repositori Git eksternal Anda untuk grounding.
- Membuat tugas: Tentukan set data konteks, resource target, sinyal pengetahuan, dan strategi evaluasi.
- Tinjau proposal AI: Periksa diagnostik operasi, tinjau deskripsi yang diusulkan, dan setujui perubahan metadata.
Langkah berikutnya
Ringkasan set konteks
Pelajari cara metadata yang dihasilkan oleh tugas pengayaan disimpan dalam set konteks untuk membumikan agen AI.
Mengonfigurasi prasyarat pengayaan
Pelajari cara mengonfigurasi peran dan akun layanan untuk menjalankan tugas pengayaan.
Membuat tugas pengayaan
Pelajari cara membuat metadata dengan menjalankan tugas pengayaan otomatis.
Mengelola pengayaan yang berjalan
Pelajari cara memantau tugas dan meninjau atau menyetujui proposal metadata secara manual.
Mengelola tugas pengayaan
Pelajari cara mengedit, menjeda, dan menghapus tugas pengayaan terjadwal.