


קבוצות ההקשר של Knowledge Catalog מאפשרות לארוז סכימות נתונים, הגדרות סמנטיות ומבני שאילתות מאומתים במאגרי ידע מוגבלים וספציפיים לדומיין. הידע הממוקד הזה בתחום מסוים מאפשר לאפליקציות AI אוטונומיות, כמו Gemini Enterprise וסוכנים בהתאמה אישית, לפעול בצורה מדויקת ואמינה.
המסמך הזה מיועד לאדריכלי נתונים, למובילי משילות ולמהנדסי AI שרוצים להבין איך קבוצות הקשרים מארגנות את הידע בתחום בשביל סוכני AI.
מהי קבוצת הקשר?
קבוצת הקשר היא קבוצת רשומות (מאגר לוגי של רשומות מטא-נתונים) ייעודית ב-Knowledge Catalog, שמכילה אוסף עצמאי של מידע סמנטי והפניות לנכסי נתונים לתחומים אנליטיים ספציפיים ולסוכני AI.
בתוך המאגר הזה, הידע מאורגן ברשומות שמייצגות מושגים עסקיים, מסמכים או נכסי נתונים נפרדים. הרשומות האלה מועשרות בהיבטים, שהם מאפייני מטא-נתונים מודולריים שבהם מאוחסנים פרטים ספציפיים כמו מונחים עסקיים, תבניות SQL ותיעוד ב-Markdown.
במקום לאלץ את הנציגים לחפש בקטלוג של כל הארגון, מה שגורם לעיכובים, מבזבז טוקנים של הנחיות ומגביר את הסיכון לתשובות עם הזיות, קבוצות ההקשר יוצרות מאגרי ידע הרמטיים ברמת הדומיין שהנציגים יכולים להתייעץ איתם ברמת דיוק גבוהה.
מכיוון שקבוצות הקשר פועלות כמכלים אדמיניסטרטיביים, אתם יכולים לארגן מטא-נתונים לפי בעלות על פרויקט ולהחיל מדיניות בקרת גישה של ניהול זהויות והרשאות גישה (IAM) על כל הרשומות המקובצות בבת אחת, בלי להגדיר הרשאות בנפרד. למידע נוסף על קבוצות של רשומות, רשומות והיבטים, קראו את המאמר מידע על ניהול מטא-נתונים.
דרישות בנוגע לעיגון של סוכני AI
כשארגונים פורסים סוכני AI אוטונומיים (כמו Gemini Enterprise, Antigravity וסוכנים בהתאמה אישית של ערכה לפיתוח סוכנים (ADK)) כדי לתזמר תהליכי עבודה של נתונים וליצור ניתוח נתונים, הסוכנים צריכים עיגון אמין:
- הגדרות סמנטיות: מה המשמעות של עמודה או מדד ספציפיים במונחים עסקיים?
- תבניות שאילתות מאומתות: איך מומחים בתחום שאלו ואיחדו את הטבלאות האלה?
- כללים תפעוליים: אילו מדיניות עסקית, קריטריונים חריגים ונוהלי הפעלה סטנדרטיים (SOP) חלים על הנתונים האלה?
תבניות מומלצות למתן שמות לקבוצות של הקשרים
בתרשים הארכיטקטורה הבא מוצג איך ארבעת המוסכמות הלוגיות העיקריות למתן שמות פועלות יחד בתוך הגבול של קבוצת הרשומות, כדי לבסס את אפליקציות ה-AI במורד הזרם:
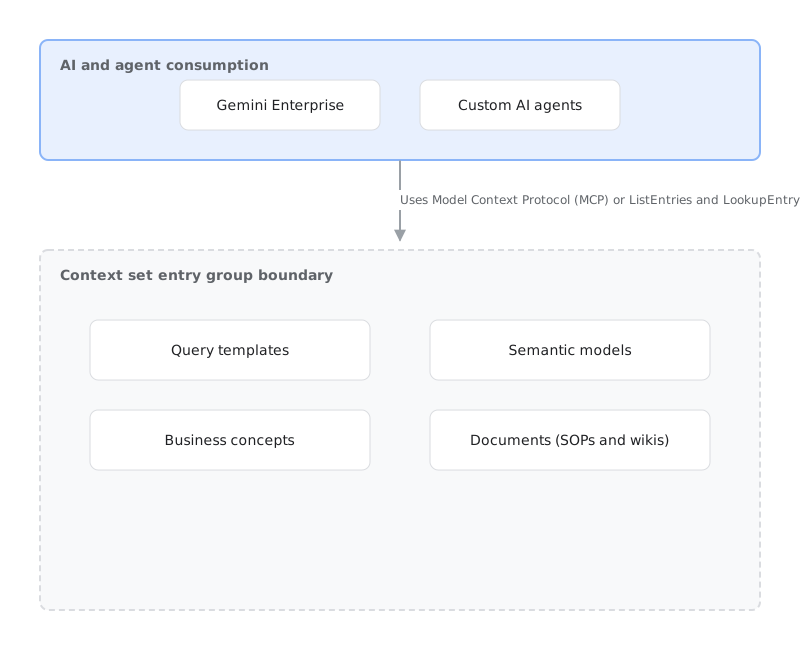
אמנם לא חובה להשתמש בכל סוגי הרשומות כדי שקבוצת ההקשר תפעל, אבל מומלץ לארגן את הרשומות לפי המוסכמות הלוגיות הבאות למתן שמות. שימוש במוסכמות למתן שמות עוזר להבטיח שאנשים וסוכנים אוטונומיים יוכלו לגלות ולפרש מידע באופן עקבי:
| תבנית למתן שמות | סוג הרשומה | תיאור ומטרה | היבטים מצורפים |
|---|---|---|---|
מושגים עסקיים concepts_<id> |
generic |
מונחים ממילון המונחים הארגוני, הגדרות של מדדים, ראשי תיבות ונוסחאות חישוב. | glossary-term-aspect, contacts. |
מסמכים documents_<path> |
document |
הקשר נרטיבי, נהלי עבודה סטנדרטיים (SOP), אתרי ויקי להכשרת עובדים חדשים והפניות למסמכים חיצוניים. | Document, overview (קישורים ו-Markdown של טקסט עשיר). |
תבניות של שאילתות query-templates_<path> |
query-template |
תבניות של שאילתות SQL עם פרמטרים שעברו אימות מראש, לוגיקה של שאילתות איחוד (join) בתדירות גבוהה ודפוסי הפעלה. | query-template (כולל שדות כמו מקורות, כוונה, nlQuery, פרמטרים ושאילתה). |
מודלים סמנטיים semantic-models_<id> |
semantic-model, semantic-entity, semantic-metric |
מודלים יחסיים רשמיים, הגדרות של ישויות, היררכיות של מאפיינים ומדדים. | semantic-model, semantic-entity, semantic-metric. |
מושגים עסקיים
רשומה של קונספט עסקי (רשומה מסוג גנרי שמשתמשת במוסכמות למתן שמות concepts_*) מגדירה טרמינולוגיה עסקית סטנדרטית, מדדי דומיין, ראשי תיבות ונוסחאות חישוב (glossary-term-aspect).
היכולות העיקריות:
- התאמת המינוחים: מונעת חוסר בהירות במינוחים בין היחידות העסקיות לצוותי הניתוח.
- נוסחאות של מדדי KPI: נוסחאות מתמטיות ולוגיקה למדדי ביצועים מרכזיים (KPI) ספציפיים לתחום.
- בעלות ארגונית: הגדרת בעלות ארגונית ברורה באמצעות היבטי פיקוח מצורפים (
contacts).
לדוגמה, בקבוצת הקשר של מסחר אלקטרוני, רשומה ב-concepts_net_items_sold מציינת את החישוב המדויק של נטו יחידות שנמכרו. כשהנציג מקבל הנחיה שבה הוא מתבקש להציג את "מספר הפריטים שנמכרו", הוא בודק את הרשומה של המושג כדי להחיל את החישוב המאומת במקום להמציא לוגיקת SQL.
ייצוג משאב לדוגמה:
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/concepts_net_items_sold
entryType: generic
aspects:
  dataplex-types.global.glossary-term-aspect:
    definition: "Calculates the absolute number of items sold minus customer returns in a given time period."
מסמכים
רשומת מסמך (רשומה מסוג מסמך שמשתמשת במוסכמת מתן השמות documents_*) מאחסנת הקשר נרטיבי ופרוצדורלי ב-Markdown מובנה (Document, overview).
היכולות העיקריות:
- נהלי הפעלה רגילים (SOP): תיעוד של נהלי הפעלה רגילים, רשימות משימות של מדריכי הפעלה ומדריכים להכשרת עובדים חדשים ישירות בקטלוג.
- מדיניות תאימות: מסמכים שקשורים למדיניות תאימות, אילוצים רגולטוריים (כמו כללי טיפול ב-GDPR או ב-HIPAA) וקריטריונים חריגים.
- אתרי ויקי חיצוניים לעיון: הפניה לאתרי ויקי חיצוניים פעילים (כמו Google Docs, Atlassian Confluence, Notion או GitHub) באמצעות מצביעי URI של מקור (קישורי
overview).
לדוגמה, קבוצת הקשר של הלבשה כוללת את documents_return_policy_rules כדי להנחות את הנציגים איך להחריג מכירות סופיות ופריטים שניזוקו במהלך המשלוח כשמחשבים את שיעורי ההחזרות הרגילים.
ייצוג משאב לדוגמה:
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/documents_return_policy_rules
entryType: document
aspects:
  dataplex-types.global.overview:
    content: "## Return Policy Rules\nItems marked FINAL_SALE or DAMAGED_IN_TRANSIT are excluded from return rates..."
תבניות של שאילתות
רשומה של תבנית שאילתה (רשומה מסוג query-template שמשתמשת במוסכמה למתן שמות query-templates_*) מכילה שאילתות SQL עם פרמטרים שאומתו על ידי בני אדם, שממופות לכוונות ניתוח נפוצות בשפה טבעית (באמצעות ההיבט query-template).
היכולות העיקריות:
- שאילתות שעברו אימות מראש: מאחסן נתיבי איחוד, תנאי סינון ודפוסי צבירה שעברו אימות מראש, כדי לענות על שאלות עסקיות נפוצות.
- הגדרת פרמטרים בזמן ריצה: תמיכה בהחלפת פרמטרים בזמן ריצה (כמו
@start_date,@regionו-@limit) להפעלה דינמית של הנציג. - מניעת שגיאות: מניעת הזיות של איחודי טבלאות ושגיאות תחביר בדיאלקט של SQL.
לדוגמה, כשהסוכן צריך לענות על שאלה לגבי החשבונות עם הביצועים הכי טובים, הוא מתאים את query-templates_sales_top_accounts_by_arr ומחליף את טווח התאריכים המבוקש בתבנית ה-SQL המאומתת.
ייצוג משאב לדוגמה:
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/query-templates_top_categories_by_season
entryType: query-template
aspects:
  dataplex-types.global.query-template:
    intent: "Which e-commerce product categories performed best this season?"
    query: "SELECT category, SUM(revenue) FROM sales WHERE season = @season GROUP BY category ORDER BY 2 DESC LIMIT @limit"
    parameters:
      -   name: "season"
        type: "STRING"
      -   name: "limit"
        type: "INTEGER"
מודלים סמנטיים
רשומות של מודלים סמנטיים (באמצעות סוגי הרשומות semantic-model, semantic-entity ו-semantic-metric, לפי מוסכמת מתן השמות semantic-models_*) מגדירות מבנים יחסיים, היררכיות של מאפיינים ומדדי צבירה בטבלאות מנורמלות.
היכולות העיקריות:
הגדרה יחסית: מגדירה מפתחות ראשיים, מפתחות זרים וקרדינליות של צירופים (כמו קשרים של אחד לרבים או רבים לרבים).
מיפוי מאפיינים עסקיים: מיפוי עמודות בסיסיות גולמיות למאפיינים עסקיים, לפרקי זמן ולמדדים שניתן לעשות בהם שימוש חוזר.
הנחיות לסוכנים: הנחיות לסוכנים אוטונומיים כשהם יוצרים שאילתות ניתוח מורכבות עם כמה טבלאות, כשאין תבנית שאילתה מדויקת.
הפשטה של המורכבות הבסיסית: בניגוד לקישורים גולמיים של רשומות מסוג schema-join שמתעדים רק חיבורים מכניים של טבלאות בקבוצת הנתונים של המקור, מודלים סמנטיים פועלים בשכבה העסקית הלוגית כדי למנוע מצב שבו סוכן ה-AI יפיק הזיות של מעברים שגויים בתרשים ER.
לדוגמה, קבוצת הקשר של ביגוד משתמשת ב-semantic-models_apparel_sales_model כדי להגדיר איך warehouses, shipments ו-line_items מצטרפים לטבלאות של עובדות ומאפיינים בסכימת כוכב.
ייצוג משאב לדוגמה:
name: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store/entries/semantic-models_apparel_sales_model
entryType: semantic-model
aspects:
  dataplex-types.global.semantic-model:
    entities:
      -   name: "products"
      -   name: "orders"
    relationships:
      -   sourceEntity: "orders"
        foreignKey: "product_id"
        targetEntity: "products"
        primaryKey: "id"
        type: "MANY_TO_ONE"
דוגמה: הגדרת הקשר של חנות בגדים אונליין
כדי להראות איך ארבע המוסכמות למתן שמות פועלות יחד, נתייחס לחנות בגדים אונליין שפורסת עוזר אישי מבוסס-AI למשווקים בחנות. בלי הקשר מוגדר, יכול להיות שהנציג ישלח שאילתות לטבלאות זמניות גולמיות או יספור באופן שגוי פריטים פופולריים כי הוא לא יחסיר את ההחזרות של הלקוחות.
כדי לבסס את הסוכן, מנהל הנתונים יוצר קבוצת הקשר בשם online-apparel-store:
EntryGroup: projects/cymbal-style/locations/us-central1/entryGroups/online-apparel-store
(EntryGroup.type = "context-set")
│
├── concepts_* (Business concepts)
│   ├── concepts_net_items_sold
│   │     Formula: SUM(orders.quantity) - SUM(returns.quantity)
│   └── concepts_bestseller
│         Definition: Any clothing item with >= 500 net units sold within a 30-day window
│
├── documents_* (Documents and SOPs)
│   ├── documents_return_policy_rules
│   │     Markdown SOP: Exclude items marked 'FINAL_SALE' or 'DAMAGED_IN_TRANSIT' from standard return rates
│   └── documents_size_chart_guide
│         Markdown guide: Sizing conversions across US, UK, and EU clothing labels
│
├── query-templates_* (Golden SQL queries)
│   └── query-templates_top_categories_by_season
│         Verified SQL template with parameters: @season, @limit
│
└── semantic-models_* (Semantic models)
    └── semantic-models_apparel_sales_model
          Join keys: orders.product_id = products.product_id (many-to-one)
                     orders.order_id = returns.order_id (one-to-many)
איך הסוכן פותר הנחיה
כשמוכר שואל את הסוכן, "מהם 5 סגנונות המעילים לחורף שנמכרו הכי הרבה, לא כולל החזרות של פריטים פגומים?", הסוכן פותר את ההנחיה באמצעות ההקשר שהוגדר:
חיפוש תבנית שאילתה: הנציג בודק את
query-templates_*ומתאים אתquery-templates_top_categories_by_season, ומחליף את@season = 'Winter'ו-@limit = 5.אימות קונספט: הנציג בודק את
concepts_net_items_soldואתconcepts_bestsellerכדי לוודא שצריך להחסיר את הפריטים שהוחזרו מכמות ההזמנות הכוללת.אכיפת כללי SOP: הנציג קורא את
documents_return_policy_rulesומוסיף את תנאי הסינוןWHERE return_reason != 'DAMAGED_IN_TRANSIT'.אימות סכימה ואיחוד (join): באמצעות
semantic-models_apparel_sales_modelוהטבלאות המקושרות של@bigquery, הנציג מאחד אתstore.orders,store.productsו-store.returnsבאמצעות מפתחות זרים מאומתים ומריץ את שאילתת ה-SQL.
יכולות ארכיטקטוניות
קבוצות הקשר מספקות כמה יכולות עיקריות לסביבות נתונים ארגוניות:
גבולות הרצה הרמטיים: על ידי הגבלת ההקשר לקבוצה מוגדרת של נכסים ורשומות סמנטיות, הנציגים פועלים בתוך ארגז חול הרמטי. כך אפשר להסיר רעשים מיותרים מהקטלוג, להבטיח הערכות דטרמיניסטיות ולצמצם את השימוש בטוקנים.
העלאה מהירה והוספה לאינדקס בכמות גדולה: הצוותים יכולים להעלות ולהוסיף לאינדקס קבוצות של מושגים, שאילתות ומסמכים כפעולה אטומית אחת, וכך לשלב אותם עם צינורות עיבוד נתונים של אינטגרציה רציפה (CI) ופריסה רציפה (CD).
אריזה ללא העתקה: Context מגדיר את המטא-נתונים והקשרים של החבילה בלי להעתיק או להעביר את מאגר הנתונים הבסיסי, וכך נמנעות עלויות אחסון מיותרות ועיכובים בסנכרון הנתונים.
דפוסי התייעצות עם סוכנים
סוכנים במורד הזרם צורכים קבוצות הקשר דרך Model Context Protocol (MCP) או ממשקי API ישירים של Knowledge Catalog. מידע נוסף זמין במאמר אחזור הקשר של נתונים באמצעות Catalog APIs. כדי לשפר את זמן האחזור של התשובות ולהשתמש בכמה שפחות טוקנים, הסוכנים פועלים לפי היררכיית התייעצות בת שלוש רמות:
התאמה לתבנית של שאילתה: הסוכן מחפש ב-
query-templates_*. אם יש תבנית מאומתת שתואמת לכוונת המשתמש, הנציג ממיר את השאילתה לפרמטרים ומריץ אותה ישירות. כך מקבלים את התשובה הכי מהר, וכמעט שאין סיכון לשגיאה בשאילתה.הרכבת מודל סמנטי: אם אין תבנית שאילתה מתאימה, הנציג מעריך את
semantic-models_*כדי להבין את הקשרים בין הישויות וליצור הצהרת SQL עם כמה טבלאות.התייעצות לגבי מסמכים ומושגים: במקרים לא ברורים (כמו מועדי סיום של שנה פיסקלית או החרגות של מחלוקות), הנציג קורא את
concepts_*ואתdocuments_*כדי להחיל כללים עסקיים.
צריכת הקשר באפליקציות של AI גנרטיבי
אפליקציות של AI גנרטיבי משתמשות בקבוצות הקשרים שנבחרו בקפידה כדי להבין את הסמנטיקה של הדומיין הארגוני, לנווט בסכימות מורכבות וליצור SQL אמין בלי הזיות. בדרך כלל, אפליקציות צורכות את קבוצות ההקשרים האלה בשני דפוסים עיקריים:
גילוי הקשר דינמי: בסביבות של ניתוח נתונים בשיחה או בשירות עצמי, המשתמשים שואלים שאלות אד-הוק בשפה טבעית. האפליקציה מעריכה באופן דינמי את כוונת המשתמש כדי לזהות ולאחזר את קבוצת ההקשרים הכי רלוונטית מ-Knowledge Catalog, ומזריקה את הידע שנשלף מהדומיין להנחיה הפעילה.
קבוצות הקשרים שהוגדרו מראש: באפליקציות של נציגים ייעודיים, אפשר להגדיר מראש את הנציג עם הפניה מפורשת לקבוצת הקשרים על ידי ציון ה-URI של המשאב. קישור של קבוצת הקשרים ייעודית מספק ביסוס דטרמיניסטי, ומבטיח שכל האינטראקציות משתמשות בהגדרות עסקיות מאושרות בלי תקורה של חיפוש בזמן ריצה. הנציג מקבל באופן אוטומטי שיפורים באיכות, כי תהליכי עבודה חוזרים של העשרה משפרים את קבוצת ההקשרים לאורך זמן.
כדי לשפר את יכולות ההעשרה והלמידה העצמית, מומלץ לציין מודל Gemini 3.8 Flash או גרסה מתקדמת יותר באפליקציית Gemini Enterprise. למידע נוסף על השלבים לבחירת מודל, קראו את הקטע "יצירת נציג באמצעות הכלי ליצירת תהליכים" במאמר עיצוב נציגים ב-Agent Studio.
השוואה בין קבוצות הקשרים לבין מבנים קשורים
כדי לבחור את מבנה המטא-נתונים שמתאים לארכיטקטורה שלכם, קראו את ההשוואה בין קבוצות ההקשרים של Knowledge Catalog לבין יכולות קשורות של הפלטפורמה.
השוואה בין קבוצות הקשרים לתרשימי הקשרים
תרשים ההקשר וקבוצות ההקשר הם שני מבנים נפרדים עם תפקידים שונים בארכיטקטורה של Knowledge Studio:
תרשים הקשר: הטופולוגיה הסמנטית המקיפה והפעילה בארגון. הוא מקשר בין נכסי הנתונים הבסיסיים, המונחים במילון המונחים הארגוני ועקבות האינטראקציה. אתם יכולים לחקור את הגרף הפתוח הזה ולעבור בו באופן אינטראקטיבי בממשק Explore.
קבוצת הקשר: יחידת אריזה מוגבלת, אזורית ואוצרת. הוא מחלץ קבוצת משנה ספציפית של ידע בתחום ואורז אותה באופן הרמטי בקבוצת רשומות (
type="context-set"), כדי שסוכני AI במורד הזרם יוכלו לשלוח אליה שאילתות באמצעות Model Context Protocol (MCP). קבוצת הקשרים פועלת כמו תת-תרשים מלוכד וצפוף בתוך תרשים ההקשרים הרחב יותר.
השוואה בין קבוצות הקשר של Knowledge Catalog לבין קבוצות הקשר של מסד נתונים
גם ב-Knowledge Catalog וגם במסדי נתונים תפעוליים של Google Cloudמשתמשים במונח קבוצת הקשר כדי להתייחס למידע שנאסף ומבסס מודלים של AI גנרטיבי.
לשתי הגרסאות יש את אותה ארכיטקטורה בסיסית – הן מאוחסנות באופן מקורי כקבוצות הקשר של Knowledge Catalog (קבוצות של רשומות שניתנות להרחבה באמצעות type="context-set") ומשתמשות בממשקי API סטנדרטיים של Knowledge Catalog. עם זאת, הן מטרגטות שכבות שונות של מקבץ הנתונים הארגוני:
- Database context sets (QueryData): מיועדים למסדי נתונים תפעוליים ולמסדי נתונים של טרנזקציות (כמו AlloyDB ל-PostgreSQL, Cloud SQL ו-Spanner). קבוצות ההקשר האלה מותאמות במיוחד להגדרות SQL. הם כוללים תבניות של שאילתות לדוגמה, מטא-נתונים של סכימות והיבטים של סינון, שסוכן ייעודי להנדסת הקשר מעריך כדי לשפר את התרגום משפה טבעית ל-SQL (NL2SQL) בסביבות זמן ריצה תפעוליות.
- קבוצות הקשר של Knowledge Catalog (Knowledge Studio): נועדו לשרת נכסי נתונים אנליטיים (כמו BigQuery, מאגרי נתונים ומוצרי נתונים של Knowledge Catalog). קבוצות ההקשר האלה כוללות ידע רחב יותר, מולטי-מודאלי, על פני כמה מוסכמות למתן שמות, כולל מושגים עסקיים, אתרי ויקי של מסמכי תיעוד ב-Markdown ומודלים סמנטיים. הם נאספים באמצעות תהליכי עבודה להעשרה של Knowledge Studio ומוצגים לסוכני ניתוח נתונים במורד הזרם באמצעות Model Context Protocol (MCP).
השוואה בין קבוצות הקשר לבין מוצרי נתונים
כדי להגדיר גבולות ברורים לניהול נתונים ו-AI, חשוב להבין איך קבוצות ההקשרים פועלות עם מוצרי הנתונים ב-Knowledge Catalog:
מוצרי נתונים מנהלים את המשאבים הבסיסיים: מוצרי נתונים מאגדים באופן מאובטח משאבים קונקרטיים כמו טבלאות ב-BigQuery, קטגוריות וסטרימינג, ויוצרים יחידה ראשית לשיתוף נתונים, חוזי נתונים ובקרת גישה למישור הנתונים.
קבוצות הקשרים מאגדות סמנטיקה של שיחות: קבוצות הקשרים לא מעניקות גישה לנתונים, אלא מאגדות ידע בתחום, כמו מושגים, תבניות של שאילתות ומסמכים שנדרשים לסוכני AI ולבני אדם כדי להבין את הנתונים. מנהלי נתונים יכולים לקשר קבוצת הקשר למוצר נתונים על ידי הצהרה עליה בהפניות
additional_contextשל המוצר.
אבטחה ומשילות ברמה שמתאימה לארגונים
קבוצות ההקשר משתלבות עם Google Cloud אמצעי בקרה לאבטחה ולפיקוח כדי להגן על מטא-נתונים רגישים של הארגון:
תפקידי IAM בקבוצות הקשר: בגלל שקבוצות הקשר מכילות לעיתים קרובות מידע סמנטי רגיש, הגישה מנוהלת על ידי תפקידי IAM שמוחלים ישירות על קבוצת הרשומות של
context-set. כך אתם יכולים לארגן את הידע שנאסף לפי אזור גיאוגרפי ובעלות על הדומיין, לתת הרשאות שינוי למנהלי הדומיין והרשאות קריאה לסוכני ה-AI שמשתמשים בו. כדי ליצור קבוצת הקשר, צריכה להיות לכם הרשאת ה-IAMdataplex.entryGroups.setIamPolicy. ההרשאה הזו נדרשת כדי להעניק לכם באופן אוטומטי הרשאות בעלים במהלך יצירת קבוצת ההקשר. אפשר לקבל את ההרשאה הזו באמצעות תפקידים מוגדרים מראש, כמו אדמין של Dataplex Catalog (roles/dataplex.catalogAdmin) או בעלים של קבוצת רשומות ב-Dataplex (roles/dataplex.entryGroupOwner).אבטחת נתונים בסיסיים ללא העתקה: כשנותנים לסוכן גישה לקבוצת הקשר, הוא יכול לקרוא מטא-נתונים סמנטיים ותבניות של שאילתות, אבל הוא לא יכול לעקוף את אמצעי בקרת הגישה בטבלאות הבסיסיות. כדי להריץ שאילתת SQL ב-BigQuery או לקרוא קבצים ב-Cloud Storage, הזהות שמריצה את השאילתה צריכה לכלול את הרשאות ה-IAM הנדרשות במישור הנתונים במשאבים הבסיסיים האלה.
ניהול עם האדם שבתהליך: כשמשימות העשרה אוטונומיות של Knowledge Studio מחלצות מושגים חדשים, נהלי עבודה תקינים או תבניות של שאילתות מיומני תפעול, ההצעות מוצגות כבקשות לשינוי שניתן לבדוק. מנהלי הנתונים בודקים את ההשוואות בין ההבדלים ואת ציוני ההערכה לפני שהם מאשרים שינויים בקבוצת הקשרים בסביבת הייצור. מידע נוסף על בדיקת הצעות זמין במאמר ניהול בקשות.
זהות הרצה בניהול המשתמש: משימות העשרה אוטומטיות שמאכלסות קבוצות הקשר פועלות בחשבון שירות בניהול המשתמש, שסוכן השירות של Dataplex מתחזה אליו באמצעות התפקיד יצירת אסימונים בחשבון שירות (
roles/iam.serviceAccountTokenCreator).
היקף וגבולות של גרסת טרום-השקה (Preview)
בגרסת טרום-השקה (Preview), קבוצות ההקשר פועלות במסגרת המגבלות הבאות:
היקף אזורי: אין תמיכה בקבוצות של הקשרים גלובליים שמקושרות לנכסי נתונים אזוריים. קבוצת ההקשר חייבת להתאים לגבולות האזוריים של הנכסים שהיא כוללת.
ממשקי יצירה וצריכה: אתם יכולים ליצור קבוצות הקשרים באמצעות מאגר Knowledge Studio במסוף Google Cloud , ולהפריד אותן באופן לוגי מקבוצות רשומות ניהוליות רגילות של Knowledge Catalog. אתם יכולים לאכלס קבוצות הקשר באופן אוטומטי באמצעות תהליכי עבודה להעשרה ב-Knowledge Studio. סוכני AI במורד הזרם יכולים לגלות קבוצות הקשר ולשלוח אליהן שאילתות באופן פרוגרמטי באמצעות ממשקי ה-API של Knowledge Catalog (
ListEntriesו-LookupEntry) ו-Model Context Protocol (MCP). מידע נוסף זמין במאמר מידע על שרתי MCP.חיוב: ב-Knowledge Catalog אין חיוב נפרד על מק"ט עצמאי ליצירת קבוצות של רשומות בקבוצות הקשר.
מכסות משותפות: קבוצות הקשר הן בעצם קבוצות של רשומות (
type="context-set") עם מאפיינים מיוחדים, ולכן הן צורכות ומשתפות את אותן מכסות משאבים כמו קבוצות רגילות של רשומות ב-Knowledge Catalog.
המאמרים הבאים
סקירה כללית על Knowledge Studio
איך לתזמר הקשר של נתונים מגוונים, ליצור קבוצות של הקשרים ולבסס סוכני AI באמצעות הממשקים של Knowledge Studio.
עיון בנכסי הנתונים ובתרשים ההקשר
אתם יכולים להשתמש בלוח הציור החזותי ב-Knowledge Studio כדי לשוחח בצ'אט עם הנתונים שלכם ולעקוב אחרי קשרים סמנטיים.
מידע על ניהול מטא-נתונים
להבין איך רשומות, קבוצות של רשומות והיבטים יוצרים את הבסיס המבני של קבוצות הקשרים.
מידע על שרתי MCP
חשיפת קבוצות של הקשרים ומטא-נתונים עשירים לסוכני AI גנרטיבי במורד הזרם באמצעות MCP.
אחזור הקשר של נתונים באמצעות Catalog API
אתם יכולים לגלות ולאחזר באופן פרוגרמטי קבוצות הקשר להסקת מסקנות באמצעות AI גנרטיבי, בעזרת ממשקי ה-API `ListEntries` ו-`LookupEntry`.
ניהול קבוצות של הקשרים
כדי לארגן את הידע בתחום, אתם יכולים ליצור, להציג, לערוך ולמחוק קבוצות הקשר ב- .