


ב-Knowledge Catalog (לשעבר Dataplex Universal Catalog) אתם יכולים להגדיר ולמדוד את איכות הנתונים בטבלאות של BigQuery ושל Iceberg REST Catalog. אתם יכולים להגדיר סריקה אוטומטית של הנתונים, לאמת את הנתונים לפי כללים מוגדרים ולתעד התראות אם הנתונים לא עומדים בדרישות האיכות. התכונה "איכות נתונים אוטומטית" מאפשרת לנהל את הכללים והפריסות של איכות הנתונים כקוד, וכך לשפר את התקינות של צינורות עיבוד הנתונים.
כדי לסרוק נתונים ולחפש חריגות, קראו את המאמר סריקת פרופיל נתונים של Knowledge Catalog. הסריקה יכולה ליצור כללים לאיכות הנתונים. אפשר גם להשתמש בכללי איכות מובנים או ליצור כללים בהתאמה אישית.
ב-Knowledge Catalog יש מעקב, פתרון בעיות והתראות של Cloud Logging שמשולבים עם איכות נתונים אוטומטית.
מודל קונספטואלי
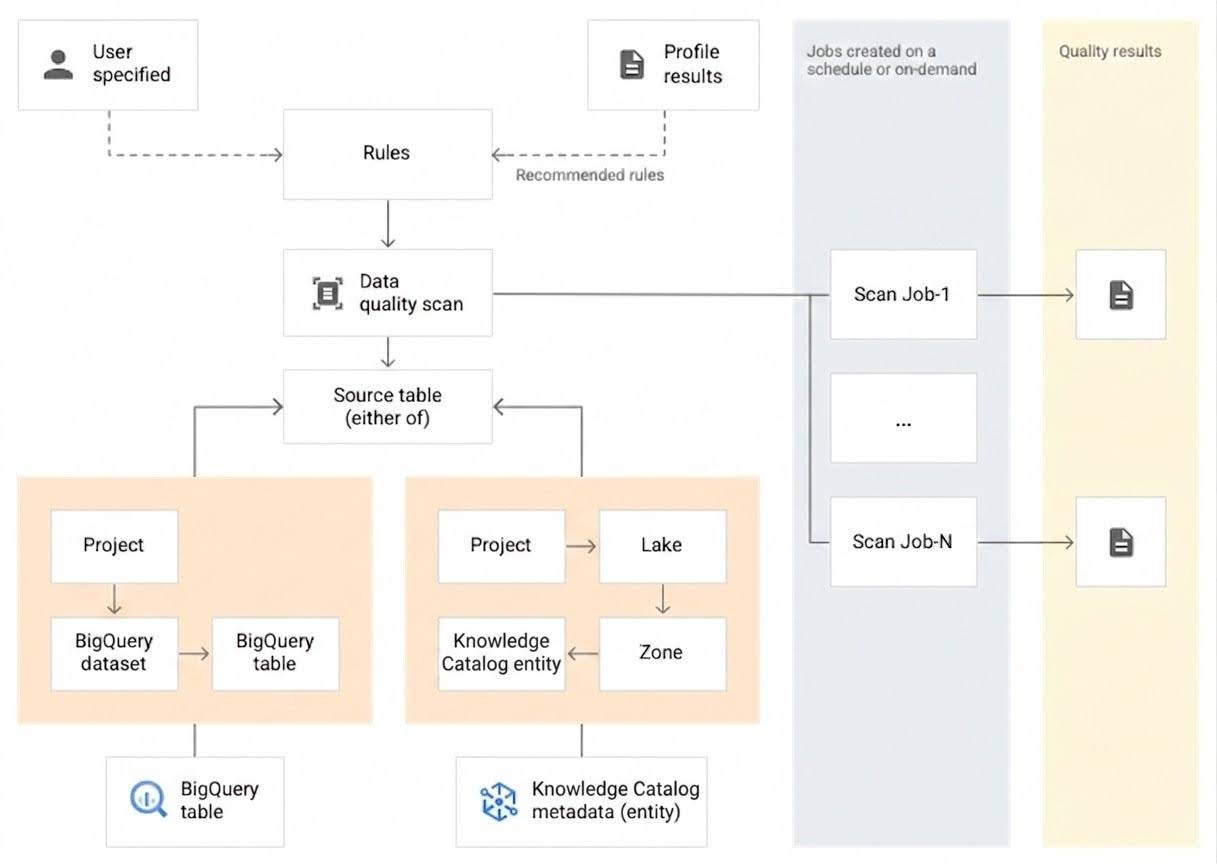
סריקה של איכות הנתונים היא סוג של סריקת נתונים ב-Knowledge Catalog, שמאמתת את הנתונים לפי קבוצה של כללים מובְנים. סריקת נתונים היא משימה של Knowledge Catalog שדוגמת נתונים מ-BigQuery ומ-Cloud Storage (דרך טבלאות חיצוניות של BigQuery) ומסיקה סוגים שונים של מטא-נתונים. כדי למדוד את איכות הטבלה באמצעות איכות נתונים אוטומטית, יוצרים אובייקט DataScan מסוג data quality. הסריקה פועלת רק על טבלה אחת ב-BigQuery.
הסריקה משתמשת במשאבים בפרויקט דייר (tenant) של Google, כך שאין צורך להגדיר תשתית משלכם.
כדי ליצור סריקה של איכות הנתונים ולהשתמש בה, צריך לבצע את השלבים הבאים:
- הגדרת כללים לאיכות הנתונים
- הגדרת הפעלת הכללים
- ניתוח תוצאות הסריקה של איכות הנתונים
- הגדרת מעקב והתראות
- פתרון בעיות שקשורות לכשלים באיכות הנתונים
הגדרת הכלל
כללי איכות הנתונים שמשויכים לסריקת איכות הנתונים מגדירים את הציפיות מהנתונים. אפשר ליצור כללים לאיכות הנתונים בדרכים הבאות:
- להשתמש בהמלצות מפרופיל הנתונים של Knowledge Catalog
- להשתמש בכללים המובנים או בתבניות של כללי מערכת
- יצירת כללי SQL בהתאמה אישית
- שימוש חוזר בכללים של איכות הנתונים
כללים מובְנים
ב-Knowledge Catalog יש תמיכה בקטגוריות הבאות של כללים מובְנים:
- ברמת השורה
בכללי קטגוריה ברמת השורה, הציפייה חלה על כל שורת נתונים. כל שורה עומדת בתנאי או לא עומדת בו באופן עצמאי. לדוגמה,
column_A_value < 1.בבדיקות ברמת השורה צריך לציין סף מעבר. כשאחוז השורות שעומדות בכלל נמוך מערך הסף, הכלל נכשל.
- צבירה
בכללים מצטברים, הציפייה חלה על ערך יחיד שנצבר בכל הנתונים. לדוגמה,
Avg(someCol) >= 10. כדי לעבור את הבדיקה, הערך הבוליאני של הבדיקה צריך להיותtrue. כללים מצטברים לא מספקים ספירה עצמאית של מעבר או כישלון לכל שורה.
בשתי הקטגוריות של הכללים, אפשר להגדיר את הפרמטרים הבאים:
- העמודה שהכלל חל עליה
- מאפיין
בטבלה הבאה מפורטים סוגי הכללים הנתמכים ברמת השורה וברמת הצבירה:
| סוג הכלל (השם במסוף Google Cloud ) |
כלל ברמת השורה או כלל צבירה | תיאור | סוגי עמודות נתמכים | פרמטרים ספציפיים לכלל |
|---|---|---|---|---|
RangeExpectation(בדיקת טווח) |
ברמת השורה | בודקים אם הערך נמצא בין המינימום למקסימום. | כל העמודות מסוג מספר, תאריך וחותמת זמן. | חובה:
|
NonNullExpectation(בדיקת ערך Null) |
ברמת השורה | מוודאים שהערכים בעמודה הם לא NULL. | כל סוגי העמודות הנתמכים. | חובה:
|
SetExpectation(הגדרת בדיקה) |
ברמת השורה | בודקים אם הערכים בעמודה הם אחד מהערכים שצוינו בקבוצה. | כל סוגי העמודות הנתמכים, חוץ מ-Record ו-Struct. |
חובה:
|
RegexExpectation(בדיקת ביטויים רגולריים) |
ברמת השורה | בודקים את הערכים מול ביטוי רגולרי מסוים. | String | חובה:
|
Uniqueness(בדיקת ייחודיות) |
צבירה | בודקים אם כל הערכים בעמודה הם ייחודיים. | כל סוגי העמודות הנתמכים, חוץ מ-Record ו-Struct. |
חובה:
|
StatisticRangeExpectation(בדיקת נתונים סטטיסטיים) |
צבירה | בודקים אם המדד הסטטיסטי הנתון תואם לטווח הצפוי. | כל סוגי העמודות המספריות הנתמכים. | חובה:
|
סוגי כללי SQL בהתאמה אישית שנתמכים
כללי SQL מאפשרים להרחיב את האימות באמצעות לוגיקה מותאמת אישית. אלה סוגי הכללים:
| סוג הכלל | כלל ברמת השורה או כלל צבירה | תיאור | סוגי עמודות נתמכים | פרמטרים ספציפיים לכלל | דוגמה |
|---|---|---|---|---|---|
| תנאי השורה | ברמת השורה | מציינים ציפייה לכל שורה על ידי הגדרת ביטוי SQL בסעיף WHERE. הביטוי ב-SQL צריך להחזיר את הערך true (עבר) או false (נכשל) לכל שורה.ב-Knowledge Catalog מחושב אחוז השורות שעומדות בציפייה הזו, והערך הזה מושווה לאחוז הסף למעבר כדי לקבוע אם הכלל הצליח או נכשל. הביטוי יכול לכלול הפניה לטבלה אחרת, למשל כדי ליצור בדיקות של שלמות ההפניות. |
כל העמודות | חובה:
|
grossWeight <= netWeight |
| תנאי טבלה (ביטוי SQL מצטבר) |
צבירה | הכללים האלה מופעלים פעם אחת לכל טבלה. צריך לספק ביטוי SQL שמחזיר ערך בוליאני של true (עבר) או false (נכשל).ביטוי ה-SQL יכול לכלול הפניה לטבלה אחרת באמצעות שאילתות משנה של ביטויים. |
כל העמודות | חובה:
|
דוגמה פשוטה לצבירה:avg(price) > 100שימוש בשאילתת משנה של ביטוי כדי להשוות בין ערכים בטבלה אחרת: (SELECT COUNT(*) FROM `example_project.example_dataset.different-table`) < COUNT(*) |
| טענת נכוֹנוּת (assertion) ב-SQL | צבירה | כלל טענה נכונה (assertion) משתמש בשאילתה של איכות נתונים כדי למצוא שורות שלא עומדות בתנאי אחד או יותר שצוינו בשאילתה. מזינים הצהרת SQL שמוערכת כדי להחזיר שורות שתואמות למצב הלא תקין. אם השאילתה מחזירה שורות, הכלל נכשל. השמיטו את הנקודה-פסיק בסוף הצהרת ה-SQL. הצהרת ה-SQL יכולה לכלול הפניה לטבלה אחרת באמצעות שאילתות משנה של ביטויים. |
כל העמודות | חובה:
|
דוגמה פשוטה לצבירה כדי לוודא שהערך של discount_pct לא גדול מ-100:SELECT * FROM example_project.example_dataset.table WHERE discount_pct > 100שימוש בשאילתת משנה של ביטוי כדי להשוות בין ערכים בטבלה אחרת: SELECT * FROM `example_project.example_dataset.different-table` WHERE gross_weight > (SELECT avg(gross_weight) FROM `example_project.example_dataset.different-table`)
|
במאמר כללים לדוגמה לאיכות נתונים אוטומטית אפשר למצוא דוגמאות לכללים.
בחומר העזר בנושא GoogleSQL מפורטות פונקציות ה-SQL הנתמכות.
שימוש חוזר בכללים לאיכות הנתונים
אתם יכולים להשתמש שוב בכללי איכות הנתונים של Knowledge Catalog כדי לשתף הגדרות מורכבות או סטנדרטיות של כללים עסקיים בין כמה כללי איכות נתונים, באמצעות תבניות של כללים. לדוגמה, אתם יכולים ליצור תבנית כלל לאימות כתובת אימייל או לאימות מפתח זר בין שתי טבלאות, ואז להשתמש בתבניות האלה שוב בסריקות הנתונים.
התכונות העיקריות של שימוש חוזר בכללים:
- תבניות של כללים לאיכות הנתונים: אתם יכולים ליצור תבניות של כללים בהתאמה אישית כדי לאחסן הגדרות מורכבות או סטנדרטיות של כללים עסקיים, שאפשר לשתף בין כמה כללים לאיכות הנתונים. יוצרים רשומה מסוג
data-quality-rule-templateומוסיפים לה מאפיין מסוגdata-quality-rule-templateכדי להגדיר את הלוגיקה של התבנית. - כללי נתונים כמטא-נתונים: מגדירים כללים לאיכות הנתונים כהיבטים ב-Knowledge Catalog ברשומות כמו טבלאות ב-BigQuery או מונחים במילון המונחים הארגוני. כדי לצרף את הכללים האלה לרשומות, משתמשים בסוג ההיבט
data-rules. - תבניות של כללי מערכת: אפשר להשתמש בתבניות של כללי מערכת לכללים נפוצים.
מידע נוסף זמין במאמר שימוש חוזר בכללים לאיכות הנתונים.
מידות
מאפיינים מאפשרים לכם לצבור את התוצאות של כמה כללים לאיכות נתונים לצורך מעקב והתראות. צריך לשייך כל כלל איכות נתונים למאפיין. ב-Knowledge Catalog יש את המאפיינים הבאים:
- עדכניות
- עדכניות הנתונים מציינת מתי הנתונים עודכנו לאחרונה. המידע הזה יכול לעזור לכם להחליט אם הנתונים עדכניים מספיק כדי שיהיו שימושיים.
- עוצמת הקול
- נפח הנתונים: האם כל הנתונים הצפויים קיימים.
- שלמות הנתונים
- שלמות: האם הנתונים מכילים את כל המידע שנדרש למטרה שלשמה הם נאספו.
- תוקף
- תקינות: בודקים אם הנתונים עומדים בסטנדרטים מובְנים של פורמט, טווחים קבילים או קריטריונים אחרים. לדוגמה, אם תאריך תקין צריך להיות בפורמט
YYYY/mm/dd, אז 08-12-2019 הוא נתון לא תקין. דוגמה נוספת: אם מחיר המבצע התקין של פריט הוא בין 40 ש"ח ל-80 ש"ח, מחיר מבצע של 400 ש"ח הוא נתון לא תקין. - עקביות
- עקביות מתייחסת לערכים זהים של נתונים במופעים שונים, כמו טבלאות ועמודות. חוסר עקביות בנתונים נוצר, למשל, כשההכנסה ממוצר שונה כשקוראים אותה ממסד נתונים של מכירות או ממסד נתונים של שימוש.
- דיוק
- הדיוק משקף את נכונות הנתונים. חשוב לזכור שנתונים תקינים הם לא בהכרח מדויקים. לדוגמה, צבע שיער חוקי יכול להיות חום, אבל אם לאדם אין שיער חום, הנתונים לא מדויקים.
- ייחודיות
- ייחודיות: מדד שבודק אם הנתונים נפרדים ואין כפילויות.
קלט שהוזן ידנית בכללים
כל הפרמטרים של הערכים מועברים ל-API כערכי מחרוזת. הקלט של Knowledge Catalog צריך להיות בפורמט שצוין ב-BigQuery.
אפשר להעביר פרמטרים מסוג בינארי כמחרוזת בקידוד Base64.
| סוג | פורמטים נתמכים | דוגמאות |
|---|---|---|
| בינארי | ערך בקידוד Base64 | YXBwbGU= |
| חותמת הזמן | YYYY-[M]M-[D]D[( |T)[H]H:[M]M:[S]S[.F]] [time_zone] או YYYY-[M]M-[D]D[( |T)[H]H:[M]M:[S]S[.F]][time_zone_offset] |
2014-09-27 12:30:00.45-08 |
| תאריך | YYYY-M[M]-D[D] | 2014-09-27 |
| שעה | [H]H:[M]M:[S]S[.DDDDDD] | 12:30:00.45 |
| DateTime | YYYY-[M]M-[D]D [[H]H:[M]M:[S]S[.DDDDDD]] | 2014-09-27 12:30:00.45 |
פרמטר של הפניה לנתונים
כשיוצרים כלל SQL בהתאמה אישית, אפשר להפנות לטבלה של מקור נתונים ולכל מסנני התנאים המוקדמים שלה באמצעות פרמטר ההפניה לנתונים ${data()} בכלל, במקום לציין במפורש את טבלת המקור ואת המסננים שלה.
Knowledge Catalog מפרש את הפרמטר כהפניה לטבלת המקור ולמסננים שלה. דוגמאות למסננים של תנאים מוקדמים כוללות מסנני שורות, אחוזי דגימה ומסננים מצטברים.
לדוגמה, נניח שיש לכם טבלה של מקור נתונים בשם my_project_id.dim_dataset.dim_currency. אתם רוצים להריץ סריקה מצטברת של איכות הנתונים, שסורקת רק נתונים יומיים חדשים. מסנן שורות שמסנן את הרשומות של היום, transaction_timestamp >= current_date(), מופעל על הטבלה.
כלל SQL בהתאמה אישית לאיתור שורות עם discount_pct להיום נראה כך:
discount_pct IN (SELECT discount_pct FROM my_project_id.dim_dataset.dim_currency WHERE transaction_timestamp >= current_date())
אם משתמשים בפרמטר של הפניה לנתונים, אפשר לפשט את הכלל. מחליפים את האזכור של הטבלה והמסננים של התנאים המוקדמים שלה בפרמטר ${data()}:
discount_pct IN (SELECT discount_pct FROM ${data()})
Knowledge Catalog מפרש את הפרמטר ${data()} כהפניה לטבלה של מקור הנתונים עם הרשומות של היום, my_project_id.dim_dataset.dim_currency WHERE transaction_timestamp >= current_date().
בדוגמה הזו, הפרמטר של הפניה לנתונים מתייחס רק לנתונים המצטברים.
הפרמטר ${data()} תלוי אותיות רישיות.
כשמשתמשים בכינוי בתוך שאילתת משנה כדי להפנות לעמודות בטבלת המקור, צריך להשתמש בפרמטר של הפניה לנתונים כדי להפנות לטבלת המקור, או להשמיט את ההפניה לטבלה. אל תפנו לעמודות בטבלת המקור באמצעות הפניה ישירה לטבלה בסעיף WHERE.
מומלץ:
משתמשים בפרמטר של הפניה לנתונים כדי להפנות לטבלת המקור:
discount_pct IN (
SELECT discount_pct FROM
`my_project_id.dim_dataset.dim_currency` AS temp-table
WHERE
temp-table.transaction_timestamp = ${data()}.timestamp
)
השמטת ההפניה לטבלה:
discount_pct IN (
SELECT discount_pct FROM
`another_project.another_dataset.another_table` AS temp-table
WHERE
temp-table.transaction_timestamp = timestamp
לא מומלץ:
אל תשתמשו בהפניה ישירה בטבלה כדי להפנות לעמודות בטבלת המקור:
discount_pct IN (
SELECT discount_pct FROM
`my_project_id.dim_dataset.dim_currency` AS temp-table
WHERE
temp-table.transaction_timestamp = `my_project_id.dim_dataset.dim_currency`.timestamp
)
שימוש תקין בטבלאות שונות:
אפשר להשתמש בהפניה ישירה לטבלה כשמשווים בין עמודות מטבלה אחרת:
discount_pct IN (
SELECT discount_pct FROM
`my_project_id.dim_dataset.dim_currency` AS temp-table
WHERE
temp-table.transaction_timestamp = `another_project.another_dataset.another_table`.timestamp
)
ניפוי באגים בשאילתות
כשיוצרים כלל, אפשר לכלול שאילתת ניפוי באגים שתפעל לצד הכלל. שאילתת ניפוי באגים היא הצהרת SQL שמחזירה עד 10 ערכים סקלריים. הערכים האלה יכולים לעזור לכם לאבחן את הסיבה לכך שהכלל נכשל. אפשר להוסיף לכל כלל שאילתת ניפוי באגים אחת לכל היותר, והאורך שלה לא יכול להיות יותר מ-1,024 תווים.
נניח שיש לכם את כלל טענת הנכוֹנוּת (assertion) הבא ב-SQL בטבלה example_project.example_dataset.table, שבודק אם ההכנסה הממוצעת לפריט גבוהה מ-100:
SELECT
  *
FROM
  `example_project.example_dataset.table`
WHERE
  SUM(revenue) / COUNT(DISTINCT item_id) > 100
אם הכלל הקודם נכשל, אתם יכולים להציג מדדים כמו סך ההכנסות, מספר הפריטים הייחודיים וההכנסה הממוצעת לפריט כדי לאבחן את הבעיה. שאילתת ניפוי הבאגים הבאה מחזירה את המדדים האלה:
SELECT
  SUM(revenue),
  COUNT(DISTINCT item_id),
  SUM(revenue) / COUNT(DISTINCT item_id)
FROM `example_project.example_dataset.table`
הפעלת הכלל
אתם יכולים לתזמן סריקות של איכות הנתונים כך שיפעלו במרווח זמן מסוים, או להריץ סריקה לפי דרישה.
זהות הביצוע
כברירת מחדל, ב-Knowledge Catalog נעשה שימוש בסוכן שירות מרכזי (service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com) כדי להריץ סריקות של איכות הנתונים.
כדי לשנות את זהות ההפעלה שמוגדרת כברירת מחדל, אתם יכולים לציין חשבון שירות בהתאמה אישית או להשתמש בפרטי הכניסה של משתמשי הקצה (EUC). לגישה הזו יש כמה יתרונות:
- העיקרון של הרשאות מינימליות: כדי לצמצם את הגישה המיותרת, נותנים לחשבון שירות ייעודי רק את הרשאות ה-IAM שנדרשות למשימות ספציפיות של איכות הנתונים.
- בקרת גישה ברמת פירוט גבוהה: אפשר להגדיר את היקף ההרשאות למשאבים ספציפיים, וכך לשלב את כללי מדיניות הגישה ברמת השורה וברמת העמודה ב-BigQuery.
- יכולת משופרת לביקורת: אפשר להקצות חשבונות שירות בהתאמה אישית או פרטי כניסה של משתמשים לסריקות ספציפיות, כדי שהמעקב אחרי הפעילויות והרישום שלהן ביומני הביקורת יהיו ברורים יותר.
- איחוד החיובים: כשמשתמשים בזהות מותאמת אישית להרצה, חיובי העיבוד והאחסון מרוכזים ישירות ב-BigQuery (בלי לעבור דרך המק"טים של Knowledge Catalog Premium). כך תוכלו לנצל את ההנחות ואת ההתחייבויות למשבצות של BigQuery Enterprise.
במאמר הגדרת זהות להרצה מוסבר איך מגדירים זהות מותאמת אישית להרצה.
דרישות רשת
כדי להריץ סריקה, צריך להפעיל את גישה פרטית ל-Google ברשת המשנה של ה-VPC שבה משתמשים לסריקה. אם לא מציינים רשת משנה, צריך לוודא שברשת המשנה שמוגדרת כברירת מחדל מופעלת גישה פרטית ל-Google.
כשמריצים סריקה של איכות הנתונים, נוצרת משימה ב-Knowledge Catalog. אם משימה מוגדרת באופן שגוי או פועלת יותר זמן מהצפוי, אפשר לבטל אותה.
במפרט של סריקת איכות הנתונים, אפשר להגדיר את היקף המשימה לאחת מהאפשרויות הבאות:
- טבלה מלאה
- כל משימה מאמתת את הטבלה כולה.
- מצטבר
- כל משימה מאמתת נתונים מצטברים. כדי לקבוע את המרווחים, צריך להוסיף לטבלה עמודה של
Date/Timestampשיכולה לשמש כסמן. בדרך כלל, זו העמודה שלפיה הטבלה מחולקת למחיצות.
סינון נתונים
אתם יכולים לסנן את הנתונים שייסרקו לאיכות הנתונים באמצעות מסנן שורות. יצירת מסנן שורות מאפשרת לכם להתמקד בנתונים בתוך תקופה מסוימת או פלח מסוים, כמו אזור מסוים. שימוש במסננים יכול לקצר את זמן הריצה ולהפחית את העלות. לדוגמה, אפשר לסנן נתונים עם חותמת זמן לפני תאריך מסוים.
נתונים לדוגמה
אתם יכולים לציין אחוז מסוים של רשומות מהנתונים שלכם שיידגמו לצורך הרצת סריקה של איכות הנתונים. יצירת סריקות של איכות הנתונים בדגימה קטנה יותר של נתונים יכולה להפחית את זמן הריצה ואת העלות, בהשוואה לשאילתות על מערך הנתונים כולו.
כללי סינון
כשמריצים סריקה של איכות הנתונים, אפשר להשתמש בתחביר הסינון של AIP-160 כדי להריץ כללים ספציפיים באופן סלקטיבי. Knowledge Catalog מסנן את המטא-נתונים של הכללים שמוגדרים בסריקה או של הכללים שמצורפים לרשומה בקטלוג באמצעות ההיבט data-rules.
תחביר המסנן
תחביר המסנן פועל לפי ההנחיות של AIP-160. אפשר להשתמש באופרטורים סטנדרטיים של AIP-160 (כמו =, !=, >, <, =~) ולשלב כמה תנאים באמצעות AND או OR.
כשמשתמשים במחרוזת סינון של AIP-160, צריך לבצע את הפעולות הבאות:
- ב Google Cloud מסוף: מזינים את המסנן ישירות באמצעות תחביר AIP-160, לדוגמה
name = "critical_check". - בקריאה ל-API: מחרוזת המסנן היא בדרך כלל ערך בתוך מחרוזת ליטרל אחרת ב-JSON. לשם כך, צריך לסמן בתו בריחה (escape) את המירכאות הכפולות במחרוזת AIP-160. לדוגמה,
"filter": "name = \"critical_check\"".
שדות שאפשר לסנן
אפשר לסנן לפי רוב השדות שזמינים בהגדרת הכלל:
-
name: השם המוצג של הכלל. -
dimension: מאפיין איכות הנתונים (לדוגמה,VALIDITY). -
column: שם העמודה שהכלל חל עליה. -
threshold: ערך הסף למעבר של הכלל. -
ignore_null: ערך בוליאני. כאשרtrue,NULLשורות נחשבות כעוברות. -
attributes: צמדים מותאמים אישית של מפתח/ערך שהוקצו לכלל.
הדוגמאות הבאות מציגות דפוסי סינון נפוצים. ערכים מספריים ובוליאניים לא מוקפים במירכאות.
סינון לפי שם
- התאמה מדויקת:
name = "critical_check" - התאמה לתבנית:
name =~ "temp_.*"
סינון לפי מאפיין
- התאמה למאפיין ספציפי:
dimension = "COMPLETENESS" - התאמה של כמה מאפיינים:
dimension = "VALIDITY" OR dimension = "ACCURACY"
סינון לפי עמודה וסף
- התאמה לעמודה ספציפית:
column = "user_id" - התאמה לסף:
threshold > 0.95 - התאמה לטווח:
threshold >= 0.8 AND threshold < 0.9
סינון לפי ignore_null
- ערך בוליאני של התאמה:
ignore_null = true
סינון לפי מאפיינים מותאמים אישית
- בודקים אם המפתח קיים:
attributes:environment - מפתח וערך תואמים:
attributes.environment = "prod" - התאמה באמצעות ביטויים רגולריים:
attributes.tag =~ "prio-.*" - שילובים תואמים:
attributes.environment = "prod" AND attributes.criticality = "high"
תוצאות הסריקה של איכות הנתונים
התוצאות של סריקות איכות הנתונים זמינות ב-Knowledge Catalog וב-BigQuery. אתם יכולים גם לבדוק ולנתח את תוצאות הסריקה בדרכים הבאות:
ייצוא תוצאות ל-BigQuery
אתם יכולים לייצא את תוצאות הסריקה לטבלה ב-BigQuery כדי לנתח אותן לעומק. כדי להתאים אישית את הדיווח, אתם יכולים לקשר את נתוני הטבלה ב-BigQuery למרכז בקרה ב-Looker. כדי ליצור דוח מצטבר, אפשר להשתמש באותה טבלת תוצאות בכמה סריקות.
פרסום התוצאות כמטא-נתונים של Knowledge Catalog
אתם יכולים לפרסם את תוצאות הסריקה של איכות הנתונים כמטא-נתונים של Knowledge Catalog. התוצאות האחרונות נשמרות ברשומה של טבלת המקור ב-Knowledge Catalog, בסוג ההיבט של המערכת
data-quality-scorecard. אתם יכולים לראות את התוצאות בדפים של טבלת המקור ב-BigQuery וב-Knowledge Catalog במסוף Google Cloud , בכרטיסייה איכות הנתונים. אפשר גם לאחזר את התוצאות באמצעות ה-API.למידע נוסף על מטא-נתונים של Knowledge Catalog, קראו את המאמר מידע על ניהול מטא-נתונים ב-Knowledge Catalog.
בדיקת ציוני איכות הנתונים
בכל תוצאת סריקה מוצגים ציוני איכות נתונים שמציינים את אחוז הכללים שעברו את הבדיקה. הציונים מדווחים ברמת המשימה הכוללת, ברמת העמודה (אם הכלל מוערך ביחס לעמודה) וברמת המאפיין. אתם יכולים להשתמש בציוני איכות הנתונים כדי לנרמל את איכות הנתונים בטבלאות או בעמודות, לעקוב אחרי מגמות ולזהות נתונים שלא עומדים בדרישות האיכות.
מידע נוסף זמין במאמר הצגת התוצאות של סריקת איכות הנתונים.
מעקב והתראות
אתם יכולים לעקוב אחרי סריקות של איכות הנתונים ולקבל עליהן התראות בדרכים הבאות:
הגדרת התראות ב-Cloud Logging
אתם יכולים לעקוב אחרי משימות של איכות נתונים באמצעות היומנים
data_scanו-data_quality_scan_rule_resultב-Logs Explorer.לכל משימה של איכות נתונים, היומן של
data_scanעם השדהdata_scan_typeשמוגדר ל-DATA_QUALITYמכיל את הפרטים הבאים:- מקור הנתונים ששימש לסריקת הנתונים.
- פרטי ביצוע המשימה, כמו זמן היצירה, שעת ההתחלה, שעת הסיום ומצב המשימה.
- תוצאת המשימה של בדיקת איכות הנתונים: עבר או נכשל.
- עבר או נכשל ברמת המאפיין.
כל משימה שהושלמה בהצלחה מכילה יומן
data_quality_scan_rule_resultעם הפרטים הבאים לגבי כל כלל במשימה:- פרטי הגדרה, כמו שם הכלל, סוג הכלל, סוג ההערכה והמאפיין.
- מידע על התוצאות, כמו הצלחה או כישלון, מספר השורות הכולל, מספר השורות שעברו את הבדיקה, מספר השורות עם ערכי null ומספר השורות שנבדקו.
המידע ביומנים זמין דרך ה-API ודרך מסוףGoogle Cloud . אתם יכולים להשתמש במידע הזה כדי להגדיר התראות. למידע נוסף, קראו את המאמר הגדרת התראות ב-Logging.
שליחת דוחות של התראות באימייל
אתם יכולים לשלוח דוחות של התראות באימייל כדי לעדכן אנשים לגבי הסטטוס והתוצאות של משימת בקרת איכות הנתונים. אפשר לקבל דוחות על התראות בתרחישים הבאים:
- ציון איכות הנתונים נמוך מציון היעד שצוין
- המשימה נכשלה
- העבודה הסתיימה
אתם מגדירים דוחות התראות כשאתם יוצרים סריקה של איכות הנתונים.
מעקב אחרי עלויות המחשוב של DCU בחיוב ב-Cloud
מחשוב בלי שרת (serverless computing) של סריקת איכות הנתונים לא שולח מדדי סדרת זמנים ל-Cloud Monitoring. כדי לעקוב אחרי עלויות ה-DCU של איכות הנתונים ולשייך אותן לפי פרויקט, מזהה סריקה או טבלה, שולחים שאילתה לייצוא של החיוב ב-Cloud ב-BigQuery באמצעות תוויות המערכת של
goog-dataplex-datascan-*. מידע נוסף זמין במאמר מעקב אחרי עלויות ה-DCU של Dataplex ושיוך שלהן באמצעות ייצוא של החיוב ב-Cloud.
פתרון בעיות שקשורות לאיכות הנתונים
אם הפעלה של כלל נכשלת, Knowledge Catalog מספק שאילתה כדי לקבל את הרשומות שנכשלו. מריצים את השאילתה הזו כדי לראות את הרשומות שלא תואמות לכלל. מידע נוסף זמין במאמר פתרון בעיות שקשורות לכשל באיכות הנתונים.
מגבלות
- אין תמיכה בהמלצות לכללים ב-CLI של gcloud.
- אפשר לבחור רק אחד משבעת המאפיינים המוגדרים מראש.
- מספר הכללים לכל סריקה של איכות הנתונים מוגבל ל-1,000.
- ציוני איכות הנתונים שמדווחים ברמת העמודה נתמכים רק ב-API.
- אפשר להריץ כללים של איכות נתונים רק בטבלאות של BigQuery, של Iceberg REST Catalog, של SAP Business Data Cloud Delta Lake ושל Apache Hive.
תמחור
- למידע נוסף על התמחור, ראו התמחור של Knowledge Catalog.
- כדי לעקוב אחרי השימוש והעלויות של יחידות ה-DCU בסריקות של איכות הנתונים, ולשייך אותם באמצעות ייצוא של נתוני החיוב ב-Cloud ל-BigQuery, קראו את המאמר מעקב אחרי העלויות של יחידות ה-DCU ב-Dataplex ושיוך שלהן באמצעות ייצוא של נתוני החיוב ב-Cloud.
המאמרים הבאים
- איך משתמשים בתכונה "איכות נתונים אוטומטית"
- איך משתמשים מחדש בכללים לאיכות הנתונים
- איך מנהלים את הכללים של איכות הנתונים כקוד
- מדריך ליצירת תהליך עבודה של איכות נתונים באמצעות מדיניות כקוד
- מידע על המשאבים של Terraform שזמינים לפרופיל נתונים. תוכלו לעיין במקורות המידע הבאים:
- משאב סריקת נתונים של Dataplex במרשם של Terraform.
- המסמכים של משאב סריקת הנתונים של Dataplex ב-GitHub, שתומכים בהגדרת כללים שמבוססים על YAML.
- מידע ולמידה על יצירת פרופילים של נתונים
- איך משתמשים ביצירת פרופילים של נתונים