


בעזרת Knowledge Catalog (לשעבר Dataplex Universal Catalog) אתם יכולים לגלות באופן אוטומטי מבנים טכניים, הקשרים עסקיים, מדדים של איכות נתונים וקשרים תפעוליים, ולהוסיף אותם לאינדקס בכל נכסי הנתונים המבוזרים שלכם. ב-Knowledge Catalog, המטא-נתונים האלה מאורגנים במטא-מודל גמיש וניתן להרחבה ובתרשים הקשר פעיל, שעוזרים לכם לנהל את נכסי הנתונים ולבסס סוכני AI גנרטיבי.
המטא-מודל של Knowledge Catalog
מודל המטא-נתונים של Knowledge Catalog מספק ניהול מטא-נתונים מאוחד ומובנה, ויוצר את הבסיס המבני של Active Context Graph ב-Agentic Data Cloud של Google. תרשים ההקשר הזה עוזר לכם ולצוותי הנתונים שלכם לגלות נכסים ולנהל אותם, ומאפשר לסוכני AI גנרטיבי לאחזר הקשר עסקי מבוסס ואמין.
ב-Knowledge Catalog, המטא-נתונים מאורגנים בהיררכיה מודולרית של קונטיינרים, נכסים, סכימות וקשרים:
- מאגרים ונכסים: קבוצות של רשומות מארגנות רשומות שמייצגות נכסי נתונים נפרדים ואת עמודות הסכימה שלהם.
- העשרה מובנית: סוגי ההיבטים מגדירים סכימות להיבטים, שמצרפים מטא-נתונים מובנים לרשומות, לעמודות או לקשרים.
- תקנים ופיקוח: סוגי הרשומות מגדירים תבניות שאוכפות היבטים נדרשים ברשומות.
- קשרים: סוגי קישורי הרשומות מגדירים קשרים (קישורי רשומות) שמחברים בין רשומות קשורות למונחים עסקיים.
בטבלה הבאה מפורטים ההבדלים בין משאבים בניהול המערכת (שמסופקים באופן אוטומטי על ידי Google Cloud) לבין משאבים בהתאמה אישית שמוגדרים על ידי המשתמשים:
| רכיב מטא-מודל | בניהול המערכת (מובנה) | מוגדר על ידי המשתמש (בהתאמה אישית) |
|---|---|---|
| קבוצות של רשומות | מוגדרים מראש לכל פרויקט בשירותי Google Cloud (לדוגמה, @bigquery, @spanner, @pubsub). |
נוצרת על ידי משתמשים כדי לקבץ ולנהל נכסי נתונים בהתאמה אישית והרשאות. |
| רשומות | מאוכלסות באופן אוטומטי ממקורות של Google Cloud (כמו טבלאות ב-BigQuery, תצוגות, מערכי נתונים ומודלים). | נוצרים על ידי משתמשים כדי לייצג מקורות נתונים, קבצים או מסדי נתונים של צד שלישי בהתאמה אישית. |
| סוגי היבטים | תבניות מערכת מוגדרות מראש (לדוגמה, Schema, Overview, Contacts, DataQuality, Lineage). |
נוצר על ידי משתמשים כדי להגדיר סכימות של מטא-נתונים ספציפיים לדומיין (כמו סיווג פרטים אישיים מזהים או שכבות SLA). |
| היבטים | מאוכלס באופן אוטומטי ממערכות מקור, מיומני שאילתות או מסריקות אוטומטיות. | נוצר על ידי משתמשים, צינורות עיבוד נתונים או סוכנים ומצורף לרשומות, לעמודות או לקישורים לרשומות. |
| סוגי רשומות | תבניות מוגדרות מראש שמייצגות Google Cloud סוגי משאבים. | מוגדר על ידי המשתמשים כדי לציין היבטים אופציונליים והיבטי חובה לנכסי נתונים בהתאמה אישית. |
| קישורים לערכים | סוגי קשרים מובנים (כמו synonym, definition, schema-join, related). |
מופעים שנוצרו בין רשומות או עמודות ספציפיות כדי ליצור מודלים של חיבורים בין מערכות. |
בקטעים הבאים מתוארים הרכיבים העיקריים שמרכיבים את המטא-מודל של Knowledge Catalog.
קבוצות של רשומות
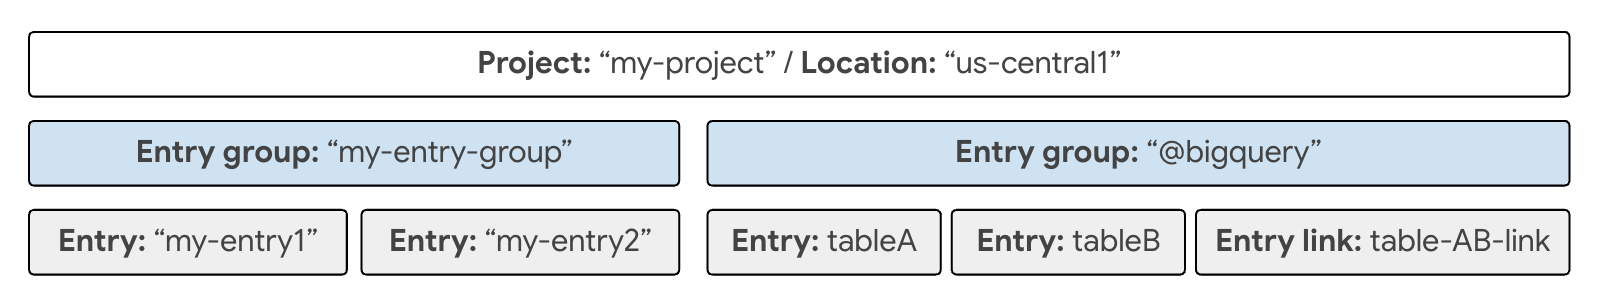
קבוצת רשומות (EntryGroup) היא מאגר אזורי של רשומות וקישורים לרשומות, שמשמש כגבול הניהולי והאבטחתי לניהול המשאבים האלה.
אפשר להשתמש בקבוצות של רשומות כדי להגדיר את הדברים הבאים:
- בקרת גישה באמצעות ניהול זהויות והרשאות גישה (IAM): אתם יכולים לתת הרשאות צפייה או עריכה לצוותים ספציפיים בקבוצת רשומות, בלי לשנות את ההרשאות של כל רשומה בנפרד.
- שיוך למיקום ולפרויקט: קיבוץ נכסים לפי אזור גיאוגרפי ובעלות על פרויקט.
במקורות של Google Cloud , Knowledge Catalog יוצר באופן אוטומטי קבוצות של רשומות מערכת לכל פרויקט (כמו @bigquery או @spanner). במקורות נתונים בהתאמה אישית, אתם יוצרים קבוצות של רשומות בהתאמה אישית.
לדוגמה, מחלקה פיננסית יכולה ליצור קבוצת רשומות בהתאמה אישית בשם production_finance_data כדי לנהל את הרשאות הגישה לכל הרשומות בהתאמה אישית שקשורות לכספים במקום אחד.
מידע נוסף זמין במאמר קבוצות של רשומות.
רשומות ונתיבי סכימה
רשומה (Entry) מייצגת נכס נתונים אחד. רשומה יכולה לייצג טבלה של מסד נתונים מובנה, מודל אנליטי, טבלה של אובייקטים לא מובנים או קבוצת נתונים חיצונית בהתאמה אישית.
הרכיבים העיקריים של רשומה כוללים:
- מזהה הרשומה: שם משאב ייחודי בתוך קבוצת הרשומות הראשית שלו.
- סוג רשומה: התבנית שמגדירה את המבנה של הרשומה ואת ההיבטים הנדרשים.
- היבטים: מאפייני מטא-נתונים מובְנים שמצורפים לרשומה.
- נתיבי סכימה (עמודות): סעיפי משנה או שדות ספציפיים בנכס הנתונים, כמו עמודה בטבלה ב-BigQuery או שדה בסכימת JSON.
עמודות מאפשרות לצרף מטא-נתונים לשדות ספציפיים בנכס. לא מגדירים עמודות באופן ידני, הן מאוכלסות כשמצרפים היבט מסוג schema לרשומה. אפשר להפנות לשדות בתצוגת עץ באמצעות נתיבים בסימון נקודות (לדוגמה, customer.address.postal_code).
לדוגמה, טבלה ב-BigQuery בשם orders_project.sales.customer_orders מיוצגת כרשומה. כדי לתאר את השדה email_address בטבלה הזו כמכיל מידע רגיש, אתם מצרפים היבט סיווג ישירות לנתיב העמודה email_address.
מידע נוסף זמין במאמר רשומות.
סוגי היבטים
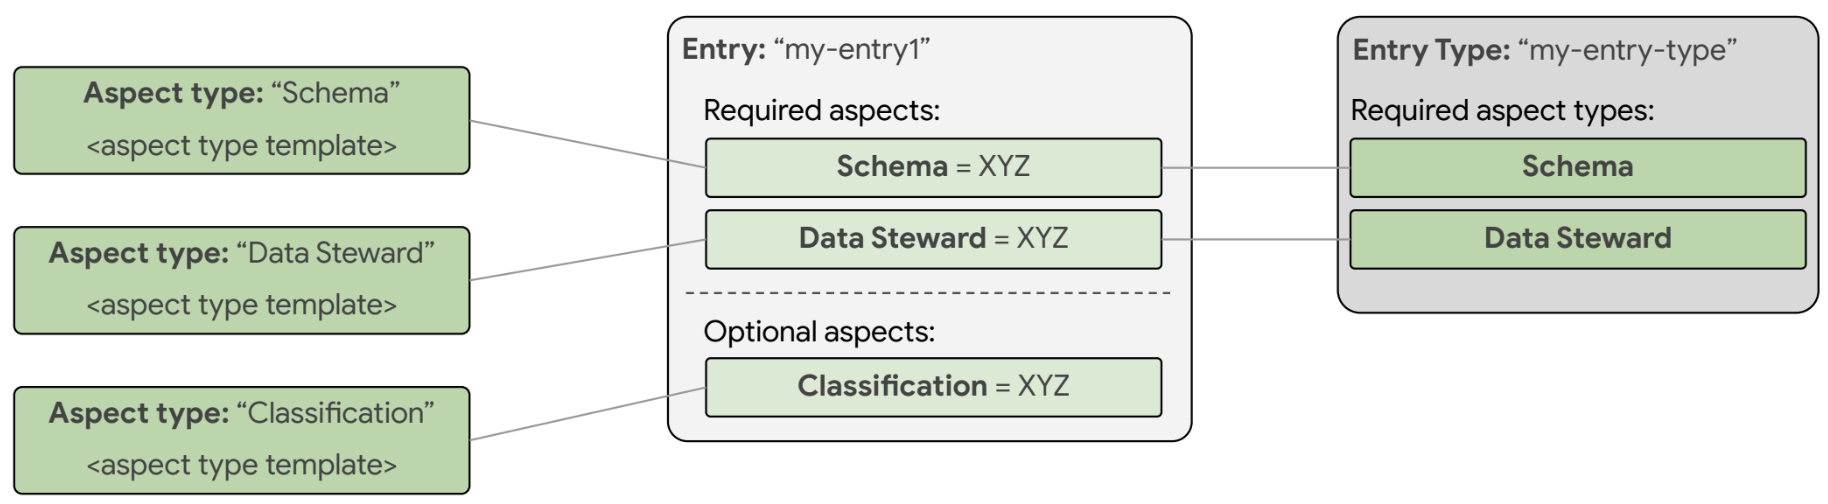
סוג היבט (AspectType) הוא תבנית סכימה לשימוש חוזר שמגדירה את השדות, סוגי הנתונים וכללי האימות של היבט. כל היבט הוא מופע של סוג היבט.
סוגי ההיבטים יכולים להיות מוגדרים על ידי המערכת (מסופקים על ידי Google Cloud) או בהתאמה אישית (נוצרים על ידי הארגון שלכם).
כשמגדירים את metadata_template לסוג היבט בהתאמה אישית, אפשר להשתמש בסוגי הנתונים הנתמכים הבאים:
| סוג הנתונים בשדה | תיאור | תרחיש שימוש לדוגמה |
|---|---|---|
string |
ערך טקסט (UTF-8). | כתובת האימייל של הבעלים, תווית סיווג הנתונים, שם המחלקה. |
integer / number |
ערכים מספריים (מספרים שלמים או מספרים בשיטת נקודה צפה). | מספר הימים לשמירת הנתונים, אחוז היעד של הסכם רמת השירות (SLA), דירוג העדיפות. |
boolean |
דגל True או False. | contains_pii: true, is_certified: false. |
enum |
רשימה מוגדרת מראש של ערכי מחרוזת מותרים. | סביבה: ["DEV", "STAGING", "PROD"]. |
datetime / timestamp |
תאריך ושעה בפורמט ISO 8601. | תאריך האישור האחרון, המועד האחרון לבדיקת התאימות. |
record |
אובייקט מובנה מקונן שמכיל שדות צאצא. | ContactInfo { name: string, email: string, phone: string }. |
array |
רשימה של ערכים חוזרים מכל סוג פרימיטיבי או סוג רשומה. | רשימה של בעלי נתונים משניים: ["user1@example.com", "user2@example.com"]. |
map |
צמדי מחרוזות של מפתח/ערך למאפיינים שניתנים להרחבה. | תגי פריסה בהתאמה אישית: {"cost_center": "1042", "tier": "gold"}. |
לדוגמה, כדי להגדיר תבנית לשימוש חוזר לפרטים ליצירת קשר, אתם יכולים ליצור סוג היבט בשם ContactInfo עם שדות ל-owner_name (string), ל-email (string) ול-support_channel (string).
מידע נוסף זמין במאמר סוגי היבטים.
היבטים
היבט (Aspect) הוא קבוצה של שדות מטא-נתונים קשורים שתואמים לסוג ההיבט. היבטים מצורפים לרשומה, לנתיב של רשומה (עמודה) או לקישור של רשומה כדי לתאר את המשאב הזה.
בניגוד למערכות תיוג מדור קודם, היבטים ב-Knowledge Catalog מוכללים ישירות בתוך רשומות ההורה או הקישורים לרשומות, מה שמאפשר לבצע פעולות קריאה וכתיבה אטומיות.
היבטים משמשים בכמה פונקציות:
- מבנה טכני: ההיבט של
Schemaמתאר את העמודות בטבלה, את סוגי הנתונים ואת התיאורים. - הקשר עסקי: היבטים מותאמים אישית מתארים את הבעלות, התאימות וסטטוס מחזור החיים.
- אמינות תפעולית: היבטים של איכות הנתונים מתעדים את תוצאות הסריקה של הכללים האוטומטיים ואת ציוני האימות.
- תרשימי ישויות לא מובְנים: ההיבט של
GraphProfileמתעד ישויות וקצוות של קשרים שחולצו על ידי AI מקבצים גולמיים.
לדוגמה, אפשר ליצור מופע של סוג ההיבט ContactInfo עם הערכים {"owner_name": "Alex", "email": "alex@example.com"} ולצרף אותו לרשומה customer_orders.
מידע נוסף זמין במאמר היבטים.
סוגי רשומות
סוג רשומה (EntryType) הוא תבנית פיקוח ליצירת רשומות בהתאמה אישית. הוא אוכף את תקני האיכות של המטא-נתונים על ידי קביעת סוגי ההיבטים הנדרשים שצריך לצרף לרשומה מהסוג הזה.
כשיוצרים רשומה מסוג רשומה מסוים, Knowledge Catalog מוודא שכל סוגי ה-aspect שמסומנים כ-required בסוג הרשומה קיימים ותקינים.
לדוגמה, אפשר ליצור סוג רשומה בשם CertifiedDataProduct שמציין שסוגי ההיבטים OwnerInfo ו-DataRetentionPolicy נדרשים. כל רשומה חדשה שנוצרת עם סוג הרשומה הזה חייבת לכלול את ההיבטים האלה כדי שתוכלו לשמור אותה.
מידע נוסף זמין במאמר סוגי רשומות.
קישורי כניסה וסוגים של קישורי כניסה
קישור לרשומה (EntryLink) יוצר קשר סמנטי בין שתי רשומות נתונים או בין עמודות ספציפיות בתוך הרשומות. כל קישור לרשומה הוא מופע של סוג קישור לרשומה (EntryLinkType).
קישורי כניסה יכולים להיות חד-כיווניים או דו-כיווניים:
- סימטרי (לא כיווני): קשרים שבהם שני הצדדים הם עמיתים (לדוגמה,
synonym,relatedאוschema-join). - אסימטרי (כיווני): קשרים עם מקור ויעד מפורשים (לדוגמה,
definition, קישור של מונח במילון המונחים הארגוני לעמודה בטבלה).
אפשר גם לצרף היבטים ישירות לקישורים של רשומות (חוץ מקישורים מסוג schema-join). כך אפשר לתאר את הקשר עצמו, למשל לתעד ציוני מהימנות של צירוף, כללי טרנספורמציה או הערות מיפוי.
ב-Knowledge Catalog יש תמיכה בסוגי הקישורים המובנים הבאים:
-
synonym: מקשר בין מושגים עסקיים מקבילים או מונחים חלופיים. -
related: מקשר בין נכסים בצימוד חלש במערכות שונות. -
definition: מקשר בין ההגדרות של מילון המונחים הארגוני לבין עמודות או רשומות פיזיות. -
schema-join: מחבר טבלאות שאפשר לצרף לפי מפתח זר תואם או נתיבי סכימה תואמים.

מידע נוסף זמין במאמר מקור המידע בנושא EntryLinks REST.
מילוני מונחים ומונחים עסקיים
מילון המונחים הארגוני מאפשר לכם ליצור טקסונומיה עסקית רשמית על ידי הגדרת מילוני מונחים, קטגוריות ומונחים עסקיים.
באמצעות קישורי רשומות מסוג definition או synonym, אתם יכולים למפות מונחים עסקיים ישירות לרשומות פיזיות ולנתיבי עמודות. כשמשתמשים או סוכני AI מחפשים בקטלוג באמצעות שפה טבעית, מנוע החיפוש מפענח את המונחים העסקיים האלה כדי לאתר את נכסי הנתונים הפיזיים הנכונים.
מידע נוסף זמין במאמר ניהול מילוני המונחים הארגוניים.
מקורות Google Cloud נתמכים
Knowledge Catalog מטמיע באופן אוטומטי מטא-נתונים מהמקורות הבאים שלGoogle Cloud . בשירותים מסוימים, כמו AlloyDB ל-PostgreSQL ו-Cloud SQL, צריך להפעיל את השילוב של Knowledge Catalog לפני שאפשר להטמיע מטא-נתונים:
ניתוח נתונים ו-lakehouse
- מערכי נתונים, טבלאות, תצוגות, מודלים, שגרות, חיבורים, מערכי נתונים מקושרים ותרשימים (גרסת טרום-השקה (Preview)) ב-BigQuery
- מאגרי נתונים ורשימות של BigQuery sharing (לשעבר Analytics Hub)
- מאגרים ונכסי קוד של Dataform
- שירותים, מסדי נתונים וטבלאות של Dataproc Metastore
טבלאות של קטלוג REST של Iceberg (כולל Google Cloud Lakehouse קטלוג ייעודי לזמן ריצה IRC, Databricks Unity IRC, AWS Glue Data Catalog IRC ו-Snowflake Horizon IRC)
טבלאות Apache Hive
טבלאות Delta Lake ב-SAP Business Data Cloud (BDC)
טבלאות Apache Iceberg שמנוהלות על ידי הקטלוג הייעודי לזמן ריצה של Lakehouse
AI ולמידת מכונה
- מודלי AI, קבוצות נתונים, קבוצות של מאפיינים, תצוגות של מאפיינים ומכונות של חנויות אונליין ב-Vertex AI
בינה עסקית (BI)
- מכונות של Looker (Google Cloud core), לוחות בקרה, רכיבים בלוחות בקרה, טבלאות Look, לוחות בקרה של LookML, רכיבים בלוחות בקרה של LookML, פרויקטים של LookML, מודלים, חקירות, תצוגות וסוכנים
מסדי נתונים
- מכונות, אשכולות וטבלאות של Bigtable (כולל פרטים של קבוצת עמודות)
- מכונות, מסדי נתונים, טבלאות ותצוגות ב-Spanner
סטרימינג והעברת הודעות
- נושאי Pub/Sub
נתונים לא מובְנים
מסדי נתונים תפעוליים
- אשכולות, מכונות, מסדי נתונים, סכימות, טבלאות ותצוגות של AlloyDB ל-PostgreSQL (תצוגה מקדימה). Knowledge Catalog מאחזר מטא-נתונים רק ממכונות ראשיות של AlloyDB ולא מרפליקות לקריאה בלבד. איך מנהלים את המשאבים של AlloyDB ל-PostgreSQL באמצעות Knowledge Catalog
- מכונות, מסדי נתונים, סכימות, טבלאות ותצוגות של Cloud SQL. Knowledge Catalog מאחזר מטא-נתונים רק ממכונות ראשיות של Cloud SQL ולא מרפליקות לקריאה בלבד. מידע נוסף מופיע במאמר ניהול משאבי Cloud SQL באמצעות Knowledge Catalog.
כדי לייבא מטא-נתונים ממקור של צד שלישי אל Knowledge Catalog, אתם יכולים להשתמש במחברים של Knowledge Catalog או בצינור עיבוד נתונים מנוהל של קישוריות. מידע נוסף זמין במאמרים מידע על מחברים של Knowledge Catalog וסקירה כללית על קישוריות מנוהלת.
אילוצים של פרויקטים ומיקומים
משאבי הקטלוג ב-Knowledge Catalog נמצאים בפרויקטים ובמיקומים גיאוגרפיים ספציפיים ב- Google Cloud . אלה מגבלות ההיקף שחלות:
| משאב | כלל מיקום | כלל פרויקט |
|---|---|---|
| רשומות | המיקום של הרשומה חייב להתאים למיקום של EntryType,
או שהערך של EntryType חייב להיות global. |
יכול להפנות לסוגי רשומות גלובליים או לסוגי רשומות באותו פרויקט. |
| היבטים של רשומות | ה-AspectType של ההיבט צריך להיות מאוחסן באותו מיקום כמו הרשומה, או שה-AspectType צריך להיות global. |
יכול להפנות לסוגי היבטים גלובליים או לסוגי היבטים באותו פרויקט. |
| קישורים לערכים | המיקום של הקישור לרשומה חייב להתאים ל-EntryLinkType שלו, או
שה-EntryLinkType חייב להיות global. |
אפשר לקשר רשומות שנמצאות בפרויקטים שונים באותו ארגון. |
| סוגי רשומות | מורכב מסוגי היבטים שמאוחסנים באותו מיקום כמו סוג הרשומה, או מסוגי היבטים שהם global. |
אם סוג רשומה מפנה לסוגי היבטים בהתאמה אישית, סוגי ההיבטים צריכים להיות באותו פרויקט ובאותו מיקום. |
פידים של שינויים במטא-נתונים
ב-Knowledge Catalog אפשר להעביר אירועים של שינויים במטא-נתונים כמעט בזמן אמת באמצעות פידים של שינויים במטא-נתונים.
פיד של שינויים במטא-נתונים מפרסם התראות על יצירה, עדכון או מחיקה של רשומות בנושא Pub/Sub שאתם מגדירים. לקוחות מנויים יכולים לצרוך את האירועים האלה כדי להפוך תהליכי עבודה תפעוליים לאוטומטיים, כמו הפעלת הערכות של איכות הנתונים כשסכימה משתנה או עדכון של לוחות בקרה לניהול נתונים במורד הזרם.
מידע נוסף זמין במאמר מידע על פידים של שינויים במטא-נתונים.
תמחור
ב-Knowledge Catalog, החיוב על נפח המטא-נתונים שמאוחסנים מתבצע באמצעות המק"ט של אחסון המטא-נתונים. מידע נוסף זמין במאמר התמחור של Knowledge Catalog.
אין חיובים על:
- יצירה וניהול של משאבים במטא-מודל של הקטלוג (סוגי רשומות, סוגי היבטים, קבוצות של רשומות, רשומות וקישורים לרשומות).
- קריאות ל-Search API ושאילתות חיפוש שבוצעו במסוף Google Cloud .
המאמרים הבאים
הוספת מטא-נתונים לטבלה
חיפוש נכסים והוספת מטא-נתונים של היבטים בהתאמה אישית לטבלה ב-BigQuery.
הטמעת מקורות נתונים בהתאמה אישית
להגדיר סוגי רשומות ולהטמיע מטא-נתונים בהתאמה אישית ממסדי נתונים ומצינורות עיבוד נתונים חיצוניים.
ניהול מילוני המונחים הארגוניים
בניית טקסונומיה עסקית ומיפוי מונחים ישירות לטבלאות ולעמודות פיזיות.
חיפוש וגילוי של נכסים
חיפוש משאבים ב-Google Cloud ובמקורות מותאמים אישית באמצעות פרדיקטים של חיפוש.
אחזור הקשר לסוכני AI
אחזור מטא-נתונים שמוכנים ל-LLM והקשר פעיל כדי לבסס סוכני AI גנרטיבי.