


Knowledge Catalog (anteriormente, Dataplex Universal Catalog) te permite definir y medir la calidad de los datos en tus tablas de BigQuery y de Iceberg REST Catalog. Puedes automatizar el análisis de datos, validarlos con reglas definidas y registrar alertas si tus datos no cumplen con los requisitos de calidad. La calidad automática de los datos te permite administrar las reglas de calidad de los datos y las implementaciones como código, lo que mejora la integridad de las canalizaciones de producción de datos.
Para analizar los datos en busca de anomalías, consulta Análisis del perfil de datos de Knowledge Catalog. El análisis puede generar reglas de calidad de los datos. También puedes usar reglas de calidad integradas o crear reglas personalizadas.
Knowledge Catalog proporciona supervisión, solución de problemas y alertas de Cloud Logging que se integran en la calidad de los datos automática.
Modelo conceptual
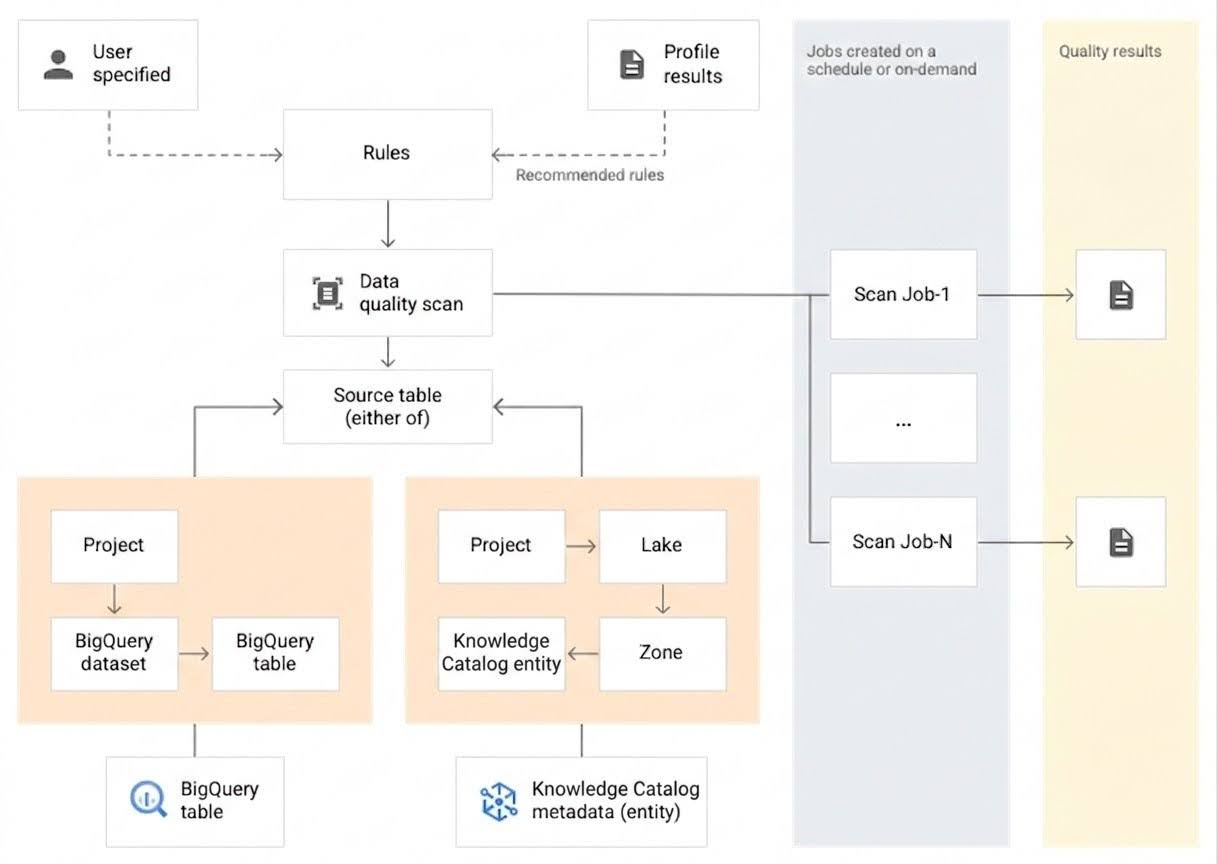
Un análisis de calidad de los datos es un tipo de análisis de datos de Knowledge Catalog que
valida tus datos con un conjunto de reglas integradas. Un análisis de datos es un
trabajo de Knowledge Catalog que toma muestras de datos de BigQuery y
Cloud Storage (a través de tablas externas de BigQuery) y, luego, infiere
varios tipos de metadatos. Para medir la
calidad de una tabla con la calidad de los datos automática, crea un objeto DataScan de
tipo data quality. La exploración se ejecuta en una sola tabla de BigQuery.
El análisis usa recursos en un proyecto de usuario
de Google, por lo que no necesitas configurar
tu propia infraestructura.
La creación y el uso de un análisis de calidad de los datos consta de los siguientes pasos:
- Define reglas de calidad de los datos
- Configura la ejecución de reglas
- Analiza los resultados del análisis de calidad de los datos
- Configura la supervisión y las alertas
- Soluciona problemas relacionados con la calidad de los datos
Definición de la regla
Las reglas de calidad de los datos asociadas con un análisis de calidad de los datos definen las expectativas de los datos. Puedes crear reglas de calidad de los datos de las siguientes maneras:
- Usa las recomendaciones de la creación de perfiles de datos de Knowledge Catalog.
- Usa las reglas integradas o las plantillas de reglas del sistema.
- Crea reglas de SQL personalizadas
- Reutiliza las reglas de calidad de los datos
Reglas integradas
Knowledge Catalog admite las siguientes categorías de reglas integradas:
- A nivel de la fila
En el caso de las reglas de categoría a nivel de fila, la expectativa se aplica a cada fila de datos. Cada fila aprueba o falla la condición de forma independiente. Por ejemplo,
column_A_value < 1.Las verificaciones a nivel de fila requieren que especifiques un umbral de aprobación. Cuando el porcentaje de filas que aprueban la regla es inferior al valor de umbral, la regla falla.
- Agregación
En el caso de las reglas de agregación, la expectativa se aplica a un solo valor agregado en todos los datos. Por ejemplo,
Avg(someCol) >= 10. Para aprobar, la verificación debe evaluarse como el booleanotrue. Las reglas de agregación no proporcionan un recuento independiente de aprobaciones o fallas para cada fila.
Para ambas categorías de reglas, puedes establecer los siguientes parámetros:
- La columna a la que se aplica la regla
- Una dimensión
En la siguiente tabla, se enumeran los tipos de reglas agregadas y a nivel de fila admitidos:
| Tipo de regla (Nombre en la consola de Google Cloud ) |
Regla a nivel de fila o agregada | Descripción | Tipos de columnas admitidos | Parámetros específicos de la regla |
|---|---|---|---|---|
RangeExpectation(Verificación de rango) |
A nivel de la fila | Verifica si el valor se encuentra entre el mínimo y el máximo. | Todas las columnas de tipo numérico, de fecha y de marca de tiempo. | Obligatorio:
|
NonNullExpectation(Verificación de nulos) |
A nivel de la fila | Validar que los valores de las columnas no sean NULL | Todos los tipos de columnas admitidos. | Obligatorio:
|
SetExpectation(Set check) |
A nivel de la fila | Verifica si los valores de una columna son uno de los valores especificados en un conjunto. | Todos los tipos de columnas admitidos, excepto Record y Struct. |
Obligatorio:
|
RegexExpectation(Verificación de expresión regular) |
A nivel de la fila | Verifica los valores con una expresión regular especificada. | String | Obligatorio:
|
Uniqueness(Verificación de unicidad) |
Agregación | Verifica si todos los valores de una columna son únicos. | Todos los tipos de columnas admitidos, excepto Record y Struct. |
Obligatorio:
|
StatisticRangeExpectation(Verificación de estadísticas) |
Agregación | Verifica si la medición estadística proporcionada coincide con el rango esperado. | Todos los tipos de columnas numéricas admitidos. | Obligatorio:
|
Tipos de reglas de SQL personalizadas admitidas
Las reglas de SQL proporcionan flexibilidad para expandir la validación con lógica personalizada. Estas reglas se presentan en los siguientes tipos.
| Tipo de regla | Regla a nivel de fila o agregada | Descripción | Tipos de columnas admitidos | Parámetros específicos de la regla | Ejemplo |
|---|---|---|---|---|---|
| Condición de fila | A nivel de la fila | Especifica una expectativa para cada fila definiendo una expresión de SQL
en una cláusula WHERE. La expresión de SQL debe
evaluarse como true (aprobada) o false (con errores)
por fila.Knowledge Catalog calcula el porcentaje de filas que cumplen con esta expectativa y compara este valor con el porcentaje del umbral de aprobación para determinar el éxito o el fracaso de la regla. La expresión puede incluir una referencia a otra tabla, por ejemplo, para crear verificaciones de integridad referencial. |
Todas las columnas | Obligatorio:
|
grossWeight <= netWeight |
| Condición de la tabla (expresión de SQL agregada) |
Agregación | Estas reglas se ejecutan una vez por tabla. Proporciona una expresión en SQL que
se evalúe como un valor booleano true (aprobado) o false (reprobado).La expresión de SQL puede incluir una referencia a otra tabla con subconsultas de expresión. |
Todas las columnas | Obligatorio:
|
Ejemplo de agregación simple:avg(price) > 100Usa una subconsulta de expresión para comparar valores en una tabla diferente: (SELECT COUNT(*) FROM `example_project.example_dataset.different-table`) < COUNT(*) |
| Aserción de SQL | Agregación | Una regla de aserción usa una consulta de calidad de los datos para encontrar filas que no cumplen
con una o más condiciones especificadas en la consulta. Proporciona una instrucción de SQL
que se evalúe para devolver las filas que coincidan con el estado no válido. Si la
consulta devuelve filas, la regla falla. Omite el punto y coma final de la instrucción de SQL. La instrucción de SQL puede incluir una referencia a otra tabla con subconsultas de expresión. |
Todas las columnas | Obligatorio:
|
Ejemplo de agregación simple para asegurarse de que discount_pct
no sea mayor que 100:SELECT * FROM example_project.example_dataset.table WHERE discount_pct > 100Usa una subconsulta de expresión para comparar valores en una tabla diferente: SELECT * FROM `example_project.example_dataset.different-table` WHERE gross_weight > (SELECT avg(gross_weight) FROM `example_project.example_dataset.different-table`)
|
Para ver reglas de ejemplo, consulta las reglas de ejemplo de calidad de los datos automática.
Para conocer las funciones de SQL compatibles, consulta la referencia de GoogleSQL.
Reutiliza las reglas de calidad de los datos
Puedes reutilizar las reglas de calidad de los datos de Knowledge Catalog para compartir definiciones de reglas empresariales complejas o estandarizadas en varias reglas de calidad de los datos con plantillas de reglas. Por ejemplo, puedes crear una plantilla de regla para una validación de correo electrónico o para la validación de clave externa entre dos tablas y, luego, reutilizar esas plantillas en tus análisis de datos.
La reutilización de reglas proporciona las siguientes funciones clave:
- Plantillas de reglas de calidad de los datos: Crea plantillas de reglas personalizadas para almacenar
definiciones de reglas empresariales complejas o estandarizadas que se puedan compartir en
varias reglas de calidad de los datos. Crea una entrada
data-quality-rule-templatey agrégale un aspectodata-quality-rule-templatepara definir la lógica de la plantilla. - Reglas de datos como metadatos: Declara reglas de calidad de los datos como aspectos en
Knowledge Catalog en entradas como
tablas de BigQuery o términos del glosario empresarial. Usa el tipo de aspecto
data-rulespara adjuntar estas reglas a las entradas. - Plantillas de reglas del sistema: Usa plantillas de reglas del sistema para las reglas de uso frecuente.
Para obtener más información, consulta Reutiliza reglas de calidad de los datos.
Dimensiones
Las dimensiones te permiten agregar los resultados de varias reglas de calidad de los datos para la supervisión y las alertas. Debes asociar cada regla de calidad de los datos con una dimensión. Knowledge Catalog proporciona las siguientes dimensiones:
- Actualidad
- La actualidad mide cuándo se actualizaron los datos por última vez. Tener esta información puede ayudarte a determinar si los datos son lo suficientemente recientes como para ser útiles.
- Volumen
- El volumen mide si todos los datos esperados están presentes.
- Integridad
- La integridad evalúa si los datos contienen toda la información necesaria para el propósito previsto.
- Validez
- La validez evalúa si los datos se ajustan a los estándares integrados para
el formato, los rangos aceptables o cualquier otro criterio. Por ejemplo, si una fecha válida debe
tener el formato
YYYY/mm/dd, entonces 08-12-2019 son datos no válidos. Como otro ejemplo, si un precio de venta válido para un artículo está entre $10 y $20, un precio de venta de $100 son datos no válidos. - Coherencia
- La coherencia se refiere a tener los mismos valores para los datos en varias instancias, como tablas y columnas. La incoherencia en los datos surge cuando, por ejemplo, los ingresos de un producto difieren cuando se leen desde una base de datos de ventas o una base de datos de uso.
- Exactitud
- La exactitud refleja la veracidad de los datos. Ten en cuenta que los datos válidos no son necesariamente precisos. Por ejemplo, un color de cabello válido podría ser castaño, pero si una persona no tiene el cabello castaño, esos son datos inexactos.
- Unicidad
- La unicidad mide si los datos son distintos y no tienen duplicados.
Entrada con tipo en las reglas
Todos los parámetros de valor se pasan como valores de cadena a la API. Knowledge Catalog requiere que las entradas sigan el formato especificado de BigQuery.
Los parámetros de tipo binario se pueden pasar como una cadena codificada en Base64.
| Tipo | Formatos admitidos | Ejemplos |
|---|---|---|
| Objeto binario | Valor codificado en Base64 | YXBwbGU= |
| Marca de tiempo | AAAA-[M]M-[D]D[( |T)[H]H:[M]M:[S]S[.F]] [time_zone] O AAAA-[M]M-[D]D[( |T)[H]H:[M]M:[S]S[.F]][time_zone_offset] |
2014-09-27 12:30:00.45-08 |
| Fecha | AAAA-M[M]-D[D] | 2014-09-27 |
| Hora | [H]H:[M]M:[S]S[.DDDDDD] | 12:30:00.45 |
| DateTime | AAAA-[M]M-[D]D [[H]H:[M]M:[S]S[.DDDDDD]] | 2014-09-27 12:30:00.45 |
Parámetro de referencia de datos
Cuando creas una regla de SQL personalizada, puedes hacer referencia a una tabla de fuente de datos y a todos
sus filtros de condición previa con el parámetro de referencia de datos ${data()} en
la regla, en lugar de mencionar de forma explícita la tabla de origen y sus filtros.
Knowledge Catalog interpreta el parámetro como una referencia a la tabla de origen
y sus filtros. Entre los ejemplos de filtros de condiciones previas, se incluyen los
filtros de filas, los porcentajes de muestreo y los filtros incrementales.
Por ejemplo, supongamos que tienes una tabla de fuente de datos llamada
my_project_id.dim_dataset.dim_currency. Quieres ejecutar un análisis incremental de la calidad de los datos
que solo analice los datos diarios nuevos. En la tabla, se aplica un filtro de fila que filtra las
entradas de hoy, transaction_timestamp >= current_date().
Una regla de SQL personalizada para encontrar filas con discount_pct para hoy se ve de la siguiente manera:
discount_pct IN (SELECT discount_pct FROM my_project_id.dim_dataset.dim_currency WHERE transaction_timestamp >= current_date())
Si usas el parámetro de referencia de datos, puedes simplificar la regla. Reemplaza la
mención de la tabla y sus filtros de condición previa por el parámetro
${data()}:
discount_pct IN (SELECT discount_pct FROM ${data()})
Knowledge Catalog interpreta el parámetro ${data()} como una
referencia a la tabla de la fuente de datos con las entradas de hoy,
my_project_id.dim_dataset.dim_currency WHERE transaction_timestamp >= current_date().
En este ejemplo, el parámetro de referencia de datos solo hace referencia a los datos
incrementales.
El parámetro ${data()} distingue mayúsculas de minúsculas.
Cuando uses un alias dentro de una subconsulta para hacer referencia a columnas de la tabla de origen,
usa el parámetro de referencia de datos para hacer referencia a la tabla de origen o, bien, omite
la referencia de la tabla. No hagas referencia a las columnas de la tabla de origen con una
referencia de tabla directa en la cláusula WHERE.
Recomendado:
Usa el parámetro de referencia de datos para hacer referencia a la tabla de origen:
discount_pct IN (
SELECT discount_pct FROM
`my_project_id.dim_dataset.dim_currency` AS temp-table
WHERE
temp-table.transaction_timestamp = ${data()}.timestamp
)
Omite la referencia a la tabla:
discount_pct IN (
SELECT discount_pct FROM
`another_project.another_dataset.another_table` AS temp-table
WHERE
temp-table.transaction_timestamp = timestamp
No se recomienda:
No uses una referencia directa a la tabla para hacer referencia a las columnas de la tabla de origen:
discount_pct IN (
SELECT discount_pct FROM
`my_project_id.dim_dataset.dim_currency` AS temp-table
WHERE
temp-table.transaction_timestamp = `my_project_id.dim_dataset.dim_currency`.timestamp
)
Uso válido de tablas diferentes:
Puedes usar una referencia de tabla directa cuando compares columnas de una tabla diferente:
discount_pct IN (
SELECT discount_pct FROM
`my_project_id.dim_dataset.dim_currency` AS temp-table
WHERE
temp-table.transaction_timestamp = `another_project.another_dataset.another_table`.timestamp
)
Depura consultas
Cuando creas una regla, puedes incluir de forma opcional una consulta de depuración para que se ejecute junto con la regla. Una consulta de depuración es una instrucción de SQL que devuelve hasta 10 valores escalares. Estos valores pueden ayudar a diagnosticar la causa si la regla falla. Puedes agregar como máximo una consulta de depuración por regla, y no debe superar los 1,024 caracteres de longitud.
Considera la siguiente regla de aserción de SQL en la
tabla example_project.example_dataset.table que verifica si los ingresos promedio
por artículo superan los 100:
SELECT
  *
FROM
  `example_project.example_dataset.table`
WHERE
  SUM(revenue) / COUNT(DISTINCT item_id) > 100
Si la regla anterior falla, puedes ver métricas como los ingresos totales, la cantidad de artículos distintos y los ingresos promedio por artículo para ayudar a diagnosticar el problema. La siguiente consulta de depuración devuelve estas métricas:
SELECT
  SUM(revenue),
  COUNT(DISTINCT item_id),
  SUM(revenue) / COUNT(DISTINCT item_id)
FROM `example_project.example_dataset.table`
Ejecución de reglas
Puedes programar análisis de calidad de los datos para que se ejecuten en un intervalo específico o puedes ejecutar un análisis a pedido.
Identidad de ejecución
De forma predeterminada, Knowledge Catalog usa un agente de servicio centralizado (service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com) para ejecutar análisis de calidad de los datos.
Puedes anular esta identidad de ejecución predeterminada especificando una cuenta de servicio personalizada o usando tus propias credenciales de usuario final (EUC). Esto ofrece varios beneficios:
- Principio de privilegio mínimo: Otorga solo los permisos de IAM exactos necesarios para tareas específicas de calidad de los datos a una cuenta de servicio dedicada, lo que minimiza el acceso con aprovisionamiento excesivo.
- Control de acceso detallado: Define el alcance de los permisos para recursos específicos, lo que permite la integración con las políticas de acceso a nivel de fila y de columna en BigQuery.
- Auditoría mejorada: Asigna cuentas de servicio personalizadas o credenciales de usuario a análisis específicos, lo que hace que el seguimiento y el registro de las actividades sean mucho más claros en los registros de auditoría.
- Unificación de la facturación: Cuando usas una identidad de ejecución personalizada, los cargos de procesamiento y almacenamiento se centralizan directamente en BigQuery (omitiendo los SKU premium de Knowledge Catalog). Esto te permite aprovechar los descuentos empresariales y los compromisos de ranuras de BigQuery.
Para obtener instrucciones sobre cómo configurar una identidad de ejecución personalizada, consulta Configura la identidad de ejecución.
Requisitos de Herramientas de redes
Para ejecutar un análisis, debes habilitar el Acceso privado a Google en la subred de VPC que usas para el análisis. Si no especificas una subred, asegúrate de que la subred predeterminada tenga habilitado el Acceso privado a Google.
Cuando ejecutas un análisis de calidad de los datos, Knowledge Catalog crea un trabajo. Si un trabajo está mal configurado o se ejecuta durante más tiempo del esperado, puedes cancelarlo.
Como parte de la especificación de un análisis de calidad de los datos, puedes especificar el alcance de un trabajo para que sea uno de los siguientes:
- Tabla completa
- Cada trabajo valida la tabla completa.
- Incremental
- Cada trabajo valida los datos incrementales. Para determinar los incrementos, proporciona una columna
DateoTimestampen la tabla que se pueda usar como marcador. Por lo general, esta es la columna en la que se particiona la tabla.
Filtra datos
Puedes filtrar los datos que se analizarán para determinar la calidad de los datos con un filtro de filas. Crear un filtro de fila te permite enfocarte en los datos de un período o un segmento específicos, como una región determinada. El uso de filtros puede reducir el tiempo de ejecución y el costo. Por ejemplo, puedes filtrar los datos con una marca de tiempo anterior a una fecha determinada.
Datos de muestra
Puedes especificar un porcentaje de registros de tus datos para muestrear y ejecutar un análisis de calidad de los datos. Crear análisis de calidad de los datos en una muestra de datos más pequeña puede reducir el tiempo de ejecución y el costo en relación con la consulta de todo el conjunto de datos.
Reglas de filtro
Cuando ejecutas un análisis de calidad de los datos, puedes usar la sintaxis de filtro AIP-160 para ejecutar de forma selectiva reglas específicas. Knowledge Catalog filtra los metadatos de las reglas definidas en el análisis o las reglas adjuntas a la entrada del catálogo a través del aspecto data-rules.
Sintaxis de filtro
La sintaxis del filtro sigue los lineamientos de AIP-160. Puedes usar operadores estándar de AIP-160 (como =, !=, >, <, =~) y combinar varias condiciones con AND o OR.
Cuando uses una cadena de filtro AIP-160, haz lo siguiente:
- En la consola de Google Cloud : ingresa el filtro directamente con la sintaxis de AIP-160, por ejemplo,
name = "critical_check". - En una llamada a la API: La cadena de filtro suele ser un valor dentro de otro literal de cadena JSON. Esto requiere escapar las comillas dobles dentro de la
cadena de AIP-160. Por ejemplo,
"filter": "name = \"critical_check\""
Campos filtrables
Puedes filtrar por la mayoría de los campos disponibles en la definición de la regla:
name: Es el nombre visible de la regla.dimension: Es la dimensión de calidad de los datos (por ejemplo,VALIDITY).column: Es el nombre de la columna a la que se aplica la regla.threshold: Es el umbral de aprobación de la regla.ignore_null: Es un valor booleano. Cuandotrue, se considera queNULLfilas pasan la validación.attributes: Son los pares clave-valor personalizados asignados a la regla.
En los siguientes ejemplos, se muestran patrones de filtro comunes. Los valores numéricos y booleanos no se entrecomillan.
Filtrar por nombre
- Coincidencia exacta:
name = "critical_check" - Coincide con un patrón:
name =~ "temp_.*"
Cómo filtrar por dimensión
- Coincide con una dimensión específica:
dimension = "COMPLETENESS" - Coincidencia con varias dimensiones:
dimension = "VALIDITY" OR dimension = "ACCURACY"
Filtra por columna y umbral
- Coincide con una columna específica:
column = "user_id" - Coincide con un umbral:
threshold > 0.95 - Coincide con un rango:
threshold >= 0.8 AND threshold < 0.9
Filtra por ignore_null
- Valor booleano de coincidencia:
ignore_null = true
Cómo filtrar por atributos personalizados
- Verifica la presencia de la clave:
attributes:environment - Coincidencia de clave y valor:
attributes.environment = "prod" - Coincidencia con expresiones regulares:
attributes.tag =~ "prio-.*" - Combinaciones de coincidencias:
attributes.environment = "prod" AND attributes.criticality = "high"
Resultados del análisis de calidad de los datos
Los resultados de tus análisis de calidad de los datos están disponibles en Knowledge Catalog y BigQuery. También puedes revisar y analizar los resultados del análisis con los siguientes métodos:
Exporta los resultados a BigQuery
Puedes exportar los resultados del análisis a una tabla de BigQuery para analizarlos en detalle. Para personalizar los informes, puedes conectar los datos de la tabla de BigQuery a un panel de Looker. Puedes crear un informe agregado con la misma tabla de resultados en varios análisis.
Publica los resultados como metadatos de Knowledge Catalog
Puedes publicar los resultados del análisis de calidad de los datos como metadatos de Knowledge Catalog. Los resultados más recientes se guardan en la entrada de Knowledge Catalog que representa la tabla de origen, en el tipo de aspecto del sistema
data-quality-scorecard. Puedes ver los resultados en las páginas de BigQuery y Knowledge Catalog de la tabla de origen en la consola de Google Cloud , en la pestaña Calidad de los datos. También puedes recuperar los resultados con la API.Para obtener más información sobre los metadatos de Knowledge Catalog, consulta Acerca de la administración de metadatos en Knowledge Catalog.
Revisa las puntuaciones de calidad de los datos
Cada resultado del análisis proporciona puntuaciones de calidad de los datos que indican el porcentaje de reglas que se aprobaron. Las puntuaciones se informan a nivel general del trabajo, a nivel de la columna (si la regla se evalúa en relación con una columna) y a nivel de la dimensión. Usa las puntuaciones de calidad de los datos para normalizar la calidad de los datos en las tablas o columnas, hacer un seguimiento de las tendencias y, además, identificar los datos que no cumplen con los requisitos de calidad.
Para obtener más información, consulta Visualiza los resultados del análisis de calidad de los datos.
Supervisión y alertas
Puedes supervisar y recibir alertas sobre las verificaciones de calidad de los datos con los siguientes métodos:
Configura alertas en Cloud Logging
Puedes supervisar los trabajos de calidad de los datos con los registros
data_scanydata_quality_scan_rule_resulten el Explorador de registros.Para cada trabajo de calidad de los datos, el registro
data_scancon el campodata_scan_typeestablecido enDATA_QUALITYcontiene la siguiente información:- Es la fuente de datos que se usa para la exploración de datos.
- Detalles de la ejecución del trabajo, como la hora de creación, la hora de inicio, la hora de finalización y el estado del trabajo.
- Es el resultado del trabajo de calidad de los datos: aprobado o reprobado.
- Si se aprueba o no el nivel de dimensión.
Cada trabajo que se completó correctamente contiene un registro
data_quality_scan_rule_resultcon la siguiente información detallada sobre cada regla de ese trabajo:- Información de configuración, como el nombre de la regla, el tipo de regla, el tipo de evaluación y la dimensión.
- Información del resultado, como aprobación o falla, recuento total de filas, recuento de filas aprobadas, recuento de filas nulas y recuento de filas evaluadas.
La información de los registros está disponible a través de la API y la consola deGoogle Cloud . Puedes usar esta información para configurar alertas. Para obtener más información, consulta Configura alertas en Logging.
Cómo enviar informes de notificaciones por correo electrónico
Puedes enviar informes de notificaciones por correo electrónico para alertar a las personas sobre el estado y los resultados de un trabajo de calidad de los datos. Los informes de notificaciones están disponibles para las siguientes situaciones:
- La puntuación de calidad de los datos es inferior a una puntuación objetivo especificada
- Se produjo un error en el trabajo
- El trabajo finalizó.
Configura los informes de notificaciones cuando creas un análisis de calidad de los datos.
Supervisa los costos de procesamiento de DCU en la Facturación de Cloud
La computación sin servidores del análisis de calidad de los datos no emite métricas de series temporales a Cloud Monitoring. Para hacer un seguimiento de los costos de DCU de calidad de los datos y atribuirlos por proyecto, ID de análisis o tabla, consulta la exportación de la Facturación de Cloud en BigQuery con las etiquetas del sistema
goog-dataplex-datascan-*. Para obtener más información, consulta Supervisa y atribuye los costos de DCU de Dataplex con la exportación de Facturación de Cloud.
Soluciona problemas relacionados con la calidad de los datos
Cuando falla la ejecución de una regla, Knowledge Catalog proporciona una consulta para obtener los registros con errores. Ejecuta esta consulta para ver los registros que no coincidieron con tu regla. Para obtener más información, consulta Soluciona problemas de fallas en la calidad de los datos.
Limitaciones
- Las recomendaciones de reglas no se admiten en gcloud CLI.
- La elección de las dimensiones se limita a una de las siete dimensiones predefinidas.
- La cantidad de reglas por análisis de calidad de los datos se limita a 1,000.
- Las puntuaciones de calidad de los datos que se informan a nivel de columna solo se admiten en la API.
- Solo puedes ejecutar reglas de calidad de los datos en tablas de BigQuery, Iceberg REST Catalog, SAP Business Data Cloud Delta Lake y Apache Hive.
Precios
- Para obtener más información sobre los precios, consulta Precios de Knowledge Catalog.
- Para hacer un seguimiento y atribuir el uso y los costos de DCU de los análisis de calidad de los datos con la exportación de Facturación de Cloud a BigQuery, consulta Supervisa y atribuye los costos de DCU de Dataplex con la exportación de Facturación de Cloud.
¿Qué sigue?
- Obtén más información para usar la calidad de los datos automática.
- Obtén información para reutilizar las reglas de calidad de los datos.
- Obtén más información para administrar tus reglas de calidad de los datos como código.
- Sigue un instructivo para crear un flujo de trabajo de calidad de los datos de política como código.
- Obtén información sobre los recursos de Terraform disponibles para la generación de perfiles de datos. Consulta lo siguiente:
- Recurso de análisis de datos de Dataplex en el registro de Terraform.
- La documentación del recurso de análisis de datos de Dataplex en GitHub, que admite la configuración de reglas basada en YAML.
- Obtén más información sobre la generación de perfiles de datos.
- Obtén más información para usar la generación de perfiles de datos.