


Knowledge Catalog (anteriormente, Dataplex Universal Catalog) te permite descubrir e indexar automáticamente estructuras técnicas, contexto empresarial, métricas de calidad de los datos y relaciones operativas en todo tu patrimonio de datos distribuido. Knowledge Catalog organiza estos metadatos en un metamodelo flexible y extensible, y un gráfico de contexto activo que te ayuda a administrar los recursos de datos y fundamentar los agentes de IA generativa.
Metamodelo de Knowledge Catalog
El metamodelo de Knowledge Catalog proporciona una administración de metadatos unificada y estructurada, y establece la base estructural del grafo de contexto activo dentro de la nube de datos con agentes de Google. Este gráfico de contexto te ayuda a ti y a tus equipos de datos a descubrir y administrar recursos, y permite que los agentes de IA generativa recuperen un contexto empresarial confiable y fundamentado.
Knowledge Catalog organiza los metadatos a través de una jerarquía modular de contenedores, recursos, esquemas y relaciones:
- Contenedores y recursos: Los grupos de entradas organizan las entradas, que representan recursos de datos individuales y sus columnas de esquema.
- Enriquecimiento estructurado: Los tipos de aspectos definen esquemas para los aspectos, que adjuntan metadatos estructurados a entradas, columnas o relaciones.
- Estándares y administración: Los tipos de entradas definen plantillas que aplican los aspectos obligatorios en las entradas.
- Relaciones: Los tipos de vínculos de entrada definen las relaciones (vínculos de entrada) que conectan las entradas y los términos empresariales relacionados.
En la siguiente tabla, se resume la distinción entre los recursos administrados por el sistema (proporcionados automáticamente por Google Cloud) y los recursos personalizados definidos por el usuario:
| Elemento de metamodelo | Administrado por el sistema (integrado) | Definida por el usuario (personalizada) |
|---|---|---|
| Grupos de entradas | Predefinido por proyecto para los servicios de Google Cloud (por ejemplo,
@bigquery, @spanner, @pubsub). |
Los crean los usuarios para agrupar y administrar recursos de datos y permisos personalizados. |
| Entradas | Se propagan automáticamente desde fuentes de Google Cloud (como tablas, vistas, conjuntos de datos y modelos de BigQuery). | Los usuarios las crean para representar fuentes de datos, archivos o bases de datos de terceros personalizados. |
| Tipos de aspecto | Plantillas del sistema predefinidas (por ejemplo, Schema, Overview, Contacts, DataQuality y Lineage) |
Los usuarios las crean para definir esquemas de metadatos específicos del dominio (como la clasificación de PII o los niveles de ANS). |
| Aspectos | Se propaga automáticamente desde los sistemas de origen, los registros de consultas o los análisis automatizados. | Los crean los usuarios, las canalizaciones o los agentes, y se adjuntan a las entradas, las columnas o los vínculos de entrada. |
| Tipos de entrada | Plantillas predefinidas que representan tipos de recursos de Google Cloud . | Los usuarios los definen para especificar aspectos obligatorios y opcionales de los recursos de datos personalizados. |
| Vínculos de entrada | Tipos de relaciones integradas (como synonym, definition, schema-join, related) |
Son instancias creadas entre entradas o columnas específicas para modelar conexiones entre sistemas. |
En las siguientes secciones, se describen los componentes principales que conforman el metamodelo de Knowledge Catalog.
Grupos de entrada
Un grupo de entradas (EntryGroup) es un contenedor regional para entradas y vínculos de entrada
que actúa como el límite administrativo y de seguridad para administrar esos
recursos.
Usa grupos de entradas para configurar lo siguiente:
- Control de acceso de Identity and Access Management: Otorga permisos de lectura o edición a equipos específicos en un grupo de entradas sin modificar los permisos de entrada individuales.
- Atribución de ubicación y proyecto: Agrupa los recursos por región geográfica y propiedad del proyecto.
Para las fuentes de Google Cloud , Knowledge Catalog crea
grupos de entradas del sistema por proyecto de forma automática (como @bigquery o
@spanner). Para las fuentes de datos personalizadas, creas grupos de entradas personalizados.
Por ejemplo, un equipo de finanzas puede crear un grupo de entradas personalizado llamado
production_finance_data para administrar los permisos de acceso de todas las entradas personalizadas
relacionadas con las finanzas en una sola ubicación.

Para obtener más información, consulta Grupos de entradas.
Entradas y rutas de acceso de esquemas
Una entrada (Entry) representa un solo recurso de datos. Una entrada puede representar una
tabla de base de datos estructurada, un modelo analítico, una tabla de objetos no estructurada o
un conjunto de datos externo personalizado.
Entre los componentes clave de una entrada, se incluyen los siguientes:
- Identificador de entrada: Es un nombre de recurso único dentro de su grupo de entradas superior.
- Tipo de entrada: Es la plantilla que define la estructura de la entrada y los aspectos obligatorios.
- Aspectos: Son atributos de metadatos estructurados adjuntos a la entrada.
- Rutas de acceso del esquema (columnas): Son subsecciones o campos específicos dentro del recurso de datos, como una columna en una tabla de BigQuery o un campo en un esquema JSON.
Las columnas te permiten adjuntar metadatos a campos individuales dentro de un recurso. No
defines las columnas de forma manual, sino que se propagan cuando adjuntas un aspecto del tipo
schema a una entrada. Puedes hacer referencia a campos anidados con rutas de acceso de notación de puntos
(por ejemplo, customer.address.postal_code).
Por ejemplo, una tabla de BigQuery llamada
orders_project.sales.customer_orders se representa como una entrada. Para describir
que el campo email_address dentro de esa tabla contiene información
sensible, adjunta un aspecto de clasificación directamente a la
ruta de la columna email_address.
Para obtener más información, consulta Entradas.
Tipos de aspecto
Un tipo de aspecto (AspectType) es una plantilla de esquema reutilizable que define los
campos, los tipos de datos y las reglas de validación de un aspecto. Cada aspecto es una
instancia de un tipo de aspecto.
Los tipos de aspectos pueden ser definidos por el sistema (proporcionados por Google Cloud) o personalizados (creados por tu organización).
Cuando defines el metadata_template para un tipo de aspecto personalizado, puedes usar
los siguientes tipos de datos admitidos:
| Tipo de datos del campo | Descripción | Ejemplo de caso de uso |
|---|---|---|
string |
Es el valor de texto (UTF-8). | Correo electrónico del propietario, etiqueta de clasificación de datos y nombre del departamento. |
integer/number |
Valores numéricos (números enteros o de punto flotante) | Días de retención de datos, porcentaje objetivo del ANS y rango de prioridad. |
boolean |
Es una marca de verdadero o falso. | contains_pii: true, is_certified: false. |
enum |
Es una lista predefinida de valores de cadena permitidos. | Entorno: ["DEV", "STAGING", "PROD"]. |
datetime/timestamp |
Es la fecha y hora con formato ISO 8601. | Última fecha de certificación, fecha límite de la revisión de cumplimiento. |
record |
Es un objeto estructurado anidado que contiene campos secundarios. | ContactInfo { name: string, email: string, phone: string } |
array |
Es una lista de valores repetidos de cualquier tipo primitivo o de registro. | Lista de propietarios de datos secundarios: ["user1@example.com", "user2@example.com"]. |
map |
Pares de cadenas clave-valor para atributos extensibles. | Etiquetas de implementación personalizadas: {"cost_center": "1042", "tier": "gold"}. |
Por ejemplo, para definir una plantilla reutilizable para la información de contacto, puedes
crear un tipo de aspecto llamado ContactInfo con campos para owner_name
(string), email (string) y support_channel (string).

Para obtener más información, consulta Tipos de aspectos.
Aspectos
Un aspecto (Aspect) es un conjunto de campos de metadatos relacionados que se ajusta a un
tipo de aspecto. Los aspectos se adjuntan a una entrada, una ruta de acceso de entrada (columna) o un
vínculo de entrada para describir ese recurso.
A diferencia de los sistemas de etiquetado heredados, los aspectos de Knowledge Catalog se encapsulan directamente dentro de sus entradas superiores o vínculos de entrada, lo que te permite realizar operaciones de lectura y escritura atómicas.
Los aspectos se usan en varias funciones:
- Estructura técnica: El aspecto
Schemadescribe las columnas, los tipos de datos y las descripciones de las tablas. - Contexto empresarial: Los aspectos personalizados describen la propiedad, el cumplimiento y el estado del ciclo de vida.
- Confianza operativa: Los aspectos de calidad de los datos registran los resultados del análisis de reglas automatizadas y las puntuaciones de validación.
- Grafos de entidades no estructurados: El aspecto
GraphProfilecaptura las entidades y las aristas de relación extraídas por la IA a partir de archivos sin procesar.
Por ejemplo, puedes crear una instancia del tipo de aspecto ContactInfo con
los valores {"owner_name": "Alex", "email": "alex@example.com"} y adjuntarla a la
entrada customer_orders.
Para obtener más información, consulta Aspectos.
Tipos de entrada
Un tipo de entrada (EntryType) es una plantilla de administración para crear entradas
personalizadas. Aplica estándares de calidad de metadatos estableciendo los tipos de aspectos
obligatorios que se deben adjuntar a una entrada de ese tipo.
Cuando creas una entrada de un tipo de entrada específico,
Knowledge Catalog valida que todos los tipos de aspectos
marcados como required en el tipo de entrada estén presentes y sean válidos.
Por ejemplo, puedes crear un tipo de entrada llamado CertifiedDataProduct
que especifique los tipos de aspecto OwnerInfo y DataRetentionPolicy según
sea necesario. Cualquier entrada nueva que se cree con este tipo de entrada debe incluir estos aspectos
antes de que puedas guardarla.
Para obtener más información, consulta Tipos de entradas.
Vínculos de entrada y tipos de vínculos de entrada
Un vínculo de entrada (EntryLink) establece una relación semántica entre dos entradas de datos
o entre columnas específicas dentro de las entradas. Cada vínculo de entrada es una
instancia de un tipo de vínculo de entrada (EntryLinkType).
Los vínculos de entrada pueden ser direccionales o no direccionales:
- Simétricas (no direccionales): Relaciones en las que ambos lados son pares
(por ejemplo,
synonym,relatedoschema-join). - Asimétricas (direccionales): Relaciones con un origen y un destino explícitos (por ejemplo,
definition, que vincula un término del glosario empresarial con una columna de tabla).
También puedes adjuntar aspectos directamente a los vínculos de entrada (excepto los vínculos
schema-join). Esto te permite describir la relación en sí, como registrar las puntuaciones de confianza de la unión, las reglas de transformación o las notas de asignación.
Knowledge Catalog admite los siguientes tipos de vínculos de entrada integrados:
synonym: Conecta conceptos empresariales equivalentes o términos alternativos.related: Conecta recursos con acoplamiento bajo entre sistemas.definitionConecta las definiciones del glosario empresarial con las columnas o entradas físicas.schema-join: Conecta tablas que se pueden unir a lo largo de rutas de acceso de esquemas o clave externa coincidentes.
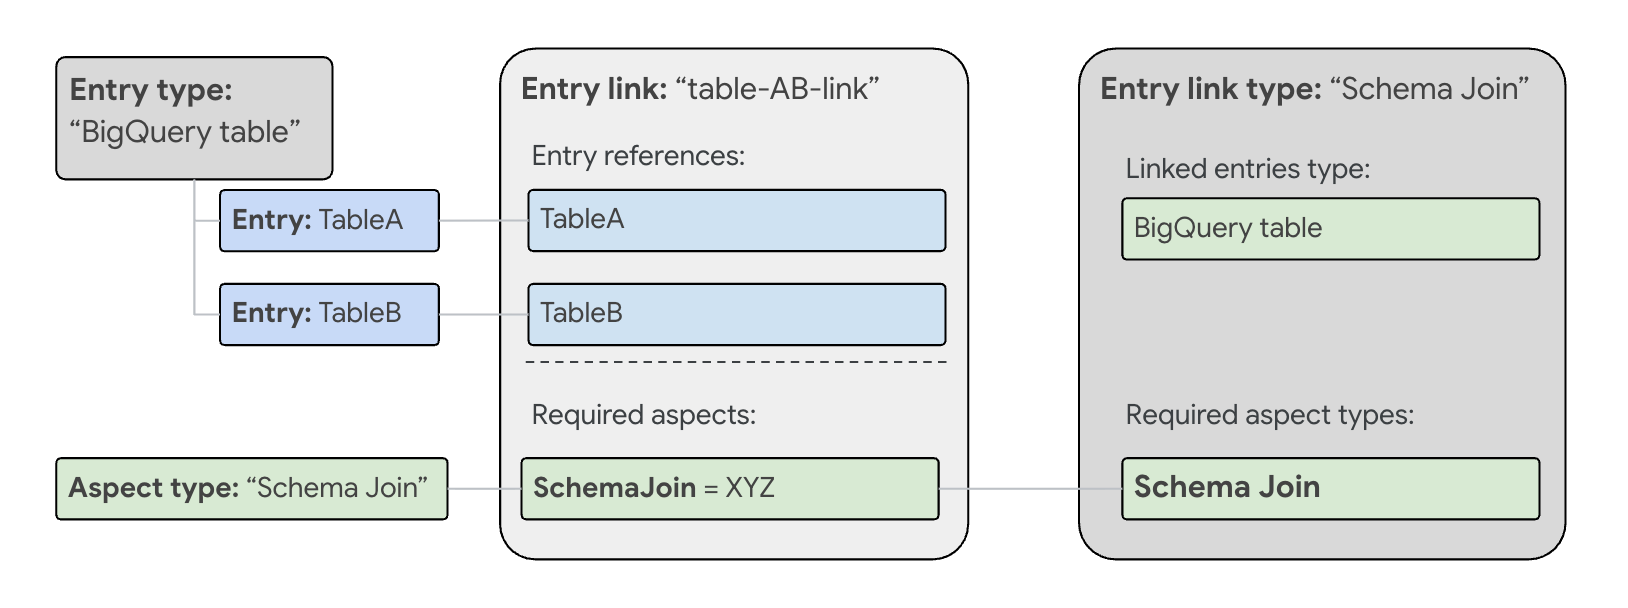
Para obtener más información, consulta la
referencia de REST de EntryLinks.
Glosarios y términos empresariales
Un glosario empresarial te permite establecer una taxonomía empresarial formal definiendo glosarios, categorías y términos empresariales.
Con los vínculos de entrada de tipo definition o synonym, puedes asignar términos empresariales
directamente a entradas físicas y rutas de columnas. Cuando los usuarios o los agentes de IA buscan
en el catálogo con lenguaje natural, el motor de búsqueda resuelve estos términos
empresariales para encontrar los recursos de datos físicos correctos.
Para obtener más información, consulta Administra glosarios empresariales.
Fuentes Google Cloud compatibles
Knowledge Catalog transfiere automáticamente metadatos de las siguientes fuentes deGoogle Cloud . En algunos servicios, como AlloyDB para PostgreSQL y Cloud SQL, primero debes habilitar la integración de Knowledge Catalog para que se puedan transferir los metadatos:
Análisis y lakehouse
- Conjuntos de datos, tablas, vistas, modelos, rutinas, conexiones, conjuntos de datos vinculados y grafos de BigQuery (versión preliminar)
- Intercambios y fichas de BigQuery sharing (anteriormente Analytics Hub)
- Repositorios de Dataform y recursos de código
- Servicios, base de datos y tablas de Dataproc Metastore
Tablas del catálogo de REST de Iceberg (incluidos Google Cloud el catálogo de tiempo de ejecución de Lakehouse, el IRC, el IRC de Databricks Unity, el IRC del catálogo de datos de AWS Glue y el IRC de Snowflake Horizon)
Tablas de Apache Hive
Tablas de Delta Lake de SAP Business Data Cloud (BDC)
Tablas de Apache Iceberg administradas por el catálogo de entornos de ejecución de Lakehouse
IA y aprendizaje automático
- Modelos de IA, conjuntos de datos, grupos de atributos, vistas de atributos e instancias de tienda en línea de Vertex AI
Inteligencia empresarial
- Instancias de Looker (Google Cloud Core), paneles, elementos de paneles, vistas, paneles de LookML, elementos de paneles de LookML, proyectos de LookML, modelos, exploraciones, vistas y agentes
Bases de datos
- Instancias, clústeres y tablas de Bigtable (incluidos los detalles de la familia de columnas)
- Instancias, bases de datos, tablas y vistas de Spanner
Transmisión y mensajería
- Temas de Pub/Sub
Datos no estructurados
Bases de datos operativas
- Clústeres, instancias, bases de datos, esquemas, tablas y vistas de AlloyDB para PostgreSQL (versión preliminar). Knowledge Catalog recupera metadatos solo de instancias principales de AlloyDB y no de réplicas de lectura. Para obtener más información, consulta Administra tus recursos de AlloyDB para PostgreSQL con Knowledge Catalog.
- Instancias, bases de datos, esquemas, tablas y vistas de Cloud SQL Knowledge Catalog recupera metadatos solo de instancias principales de Cloud SQL y no de réplicas de lectura. Para obtener más información, consulta Administra tus recursos de Cloud SQL con Knowledge Catalog.
Para importar metadatos de una fuente de terceros a Knowledge Catalog, puedes usar conectores de Knowledge Catalog o una canalización de conectividad administrada. Para obtener más información, consulta Acerca de los conectores de Knowledge Catalog y Descripción general de la conectividad administrada.
Restricciones de proyectos y ubicaciones
Los recursos de catálogo de Knowledge Catalog se alojan en proyectos y ubicaciones geográficas específicas de Google Cloud . Se aplican las siguientes restricciones de alcance:
| Recurso | Regla de ubicación | Regla del proyecto |
|---|---|---|
| Entradas | La ubicación de la entrada debe coincidir con la ubicación de su EntryType
o el EntryType debe ser global. |
Puede hacer referencia a tipos de entradas globales o del mismo proyecto. |
| Aspectos de las entradas | El AspectType del aspecto debe almacenarse en la misma ubicación
que la entrada, o el AspectType debe ser global. |
Puede hacer referencia a tipos de aspectos globales o del mismo proyecto. |
| Vínculos de entrada | La ubicación del vínculo de entrada debe coincidir con su EntryLinkType, o
el EntryLinkType debe ser global. |
Puede vincular entradas que residen en diferentes proyectos dentro de la misma organización. |
| Tipos de entrada | Se compone de tipos de aspectos almacenados en la misma ubicación que el tipo de entrada
o de tipos de aspectos que son global. |
Si un tipo de entrada hace referencia a tipos de aspectos personalizados, estos deben estar en el mismo proyecto y la misma ubicación. |
Feeds de cambios de metadatos
Knowledge Catalog puede transmitir eventos de cambio de metadatos casi en tiempo real con los feeds de cambios de metadatos.
Un feed de cambios de metadatos publica notificaciones sobre la creación, actualización o eliminación de entradas en un tema de Pub/Sub que configures. Los clientes suscriptores pueden consumir estos eventos para automatizar los flujos de trabajo operativos, como activar evaluaciones de la calidad de los datos cuando cambia un esquema o actualizar los paneles de administración descendentes.
Para obtener más información, consulta Acerca de los feeds de cambios de metadatos.
Precios
Knowledge Catalog usa el SKU de almacenamiento de metadatos para cobrar por el volumen de metadatos almacenados. Para obtener más información, consulta Precios de Knowledge Catalog.
No se aplican cargos por lo siguiente:
- Crear y administrar recursos de metamodelo de catálogo (tipos de entrada, tipos de aspecto, grupos de entrada, entradas y vínculos de entrada).
- Llamadas a la API de Search y búsquedas realizadas en la consola de Google Cloud .
¿Qué sigue?
Agregar metadatos a una tabla
Descubrir recursos y adjuntar metadatos de aspectos personalizados a una tabla de BigQuery
Transferir fuentes de datos personalizadas
Define tipos de entradas y transfiere metadatos personalizados desde bases de datos y canalizaciones externas.
Administrar glosarios empresariales
Crea una taxonomía empresarial y asigna términos directamente a tablas y columnas físicas.
Búsqueda y descubrimiento de recursos
Descubre recursos en Google Cloud y fuentes personalizadas con predicados de búsqueda.
Recupera el contexto para los agentes de IA
Recupera metadatos listos para LLM y contexto activo para fundamentar agentes de IA generativa.