


Knowledge Catalog (precedentemente Dataplex Universal Catalog) ti consente di definire e misurare la qualità dei dati nelle tabelle BigQuery e Iceberg REST Catalog. Puoi automatizzare la scansione dei dati, convalidarli in base a regole definite e registrare avvisi se i dati non soddisfano i requisiti di qualità. La qualità dei dati automatica ti consente di gestire le regole di qualità dei dati e i deployment come codice, migliorando l'integrità delle pipeline di produzione dei dati.
Per eseguire la scansione dei dati alla ricerca di anomalie, consulta Scansione di profilazione dei dati di Knowledge Catalog. La scansione può generare regole di qualità dei dati. Puoi anche utilizzare regole di qualità integrate o creare regole personalizzate.
Knowledge Catalog fornisce monitoraggio, risoluzione dei problemi e avvisi di Cloud Logging integrati con la qualità dei dati automatica.
Modello concettuale
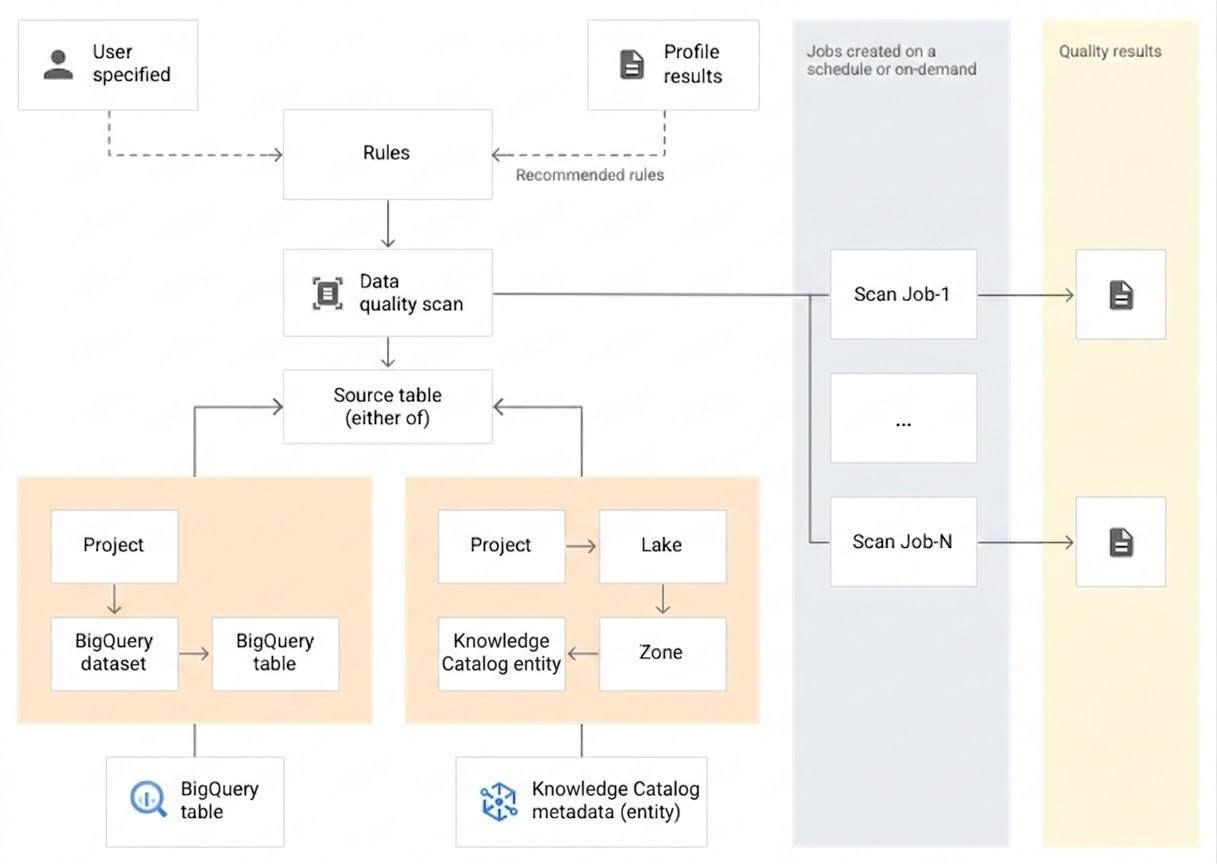
Una scansione della qualità dei dati è un tipo di scansione dei dati di Knowledge Catalog che convalida i dati rispetto a un insieme di regole integrate. Una scansione dei dati è un job di Knowledge Catalog che campiona i dati da BigQuery e Cloud Storage (tramite tabelle esterne di BigQuery) e deduce vari tipi di metadati. Per misurare la qualità di una tabella utilizzando la qualità dei dati automatica, crea un oggetto DataScan di tipo data quality. L'analisi viene eseguita su una sola tabella BigQuery.
L'analisi utilizza le risorse di un progetto tenant di Google, quindi non è necessario configurare la tua infrastruttura.
La creazione e l'utilizzo di un'analisi della qualità dei dati prevede i seguenti passaggi:
- Definisci le regole sulla qualità dei dati
- Configura l'esecuzione delle regole
- Analizza i risultati della scansione della qualità dei dati
- Configura il monitoraggio e gli avvisi
- Risolvi i problemi relativi alla qualità dei dati
Definizione della regola
Le regole sulla qualità dei dati associate a un'analisi della qualità dei dati definiscono le aspettative relative ai dati. Puoi creare regole di qualità dei dati nei seguenti modi:
- Utilizza i suggerimenti della profilazione dei dati di Knowledge Catalog
- Utilizza le regole integrate o i modelli di regole di sistema
- Crea regole SQL personalizzate
- Riutilizza le regole sulla qualità dei dati
Regole integrate
Knowledge Catalog supporta le seguenti categorie di regole integrate:
- A livello di riga
Per le regole di categoria a livello di riga, l'aspettativa viene applicata a ogni riga di dati. Ogni riga supera o non supera la condizione in modo indipendente. Ad esempio,
column_A_value < 1.I controlli a livello di riga richiedono di specificare una soglia di superamento. Quando la percentuale di righe che superano la regola scende al di sotto del valore di soglia, la regola non viene superata.
- Aggregazione
Per le regole aggregate, l'aspettativa viene applicata a un singolo valore aggregato in tutti i dati. Ad esempio,
Avg(someCol) >= 10. Per superare il controllo, il risultato deve essere il valore booleanotrue. Le regole di aggregazione non forniscono un conteggio indipendente di superamento o mancato superamento per ogni riga.
Per entrambe le categorie di regole, puoi impostare i seguenti parametri:
- La colonna a cui si applica la regola
- Una dimensione
La tabella seguente elenca i tipi di regole aggregate e a livello di riga supportati:
| Tipo di regola (nome nella console Google Cloud ) |
Regola a livello di riga o di aggregazione | Descrizione | Tipi di colonne supportati | Parametri specifici della regola |
|---|---|---|---|---|
RangeExpectation(Controllo dell'intervallo) |
A livello di riga | Controlla se il valore è compreso tra il minimo e il massimo. | Tutte le colonne di tipo numerico, data e timestamp. | Obbligatorio:
|
NonNullExpectation(Controllo dei valori null) |
A livello di riga | Convalida che i valori della colonna non siano NULL. | Tutti i tipi di colonne supportati. | Obbligatorio:
|
SetExpectation(Controllo del set) |
A livello di riga | Controlla se i valori di una colonna sono uno dei valori specificati in un insieme. | Tutti i tipi di colonna supportati, ad eccezione di Record e Struct. |
Obbligatorio:
|
RegexExpectation(Controllo delle espressioni regolari) |
A livello di riga | Controlla i valori rispetto a un'espressione regolare specificata. | Stringa | Obbligatorio:
|
Uniqueness(Controllo unicità) |
Aggregazione | Controlla se tutti i valori di una colonna sono univoci. | Tutti i tipi di colonna supportati, ad eccezione di Record e Struct. |
Obbligatorio:
|
StatisticRangeExpectation(Controllo statistico) |
Aggregazione | Controlla se la misura statistica specificata corrisponde all'intervallo previsto. | Tutti i tipi di colonne numeriche supportati. | Obbligatorio:
|
Tipi di regole SQL personalizzate supportate
Le regole SQL offrono la flessibilità di espandere la convalida con una logica personalizzata. Queste regole sono disponibili nei seguenti tipi.
| Tipo di regola | Regola a livello di riga o di aggregazione | Descrizione | Tipi di colonne supportati | Parametri specifici della regola | Esempio |
|---|---|---|---|---|---|
| Condizione di riga | A livello di riga | Specifica un'aspettativa per ogni riga definendo un'espressione SQL in una clausola WHERE. L'espressione SQL deve restituire true (superato) o false (non superato) per riga.Knowledge Catalog calcola la percentuale di righe che soddisfano questa aspettativa e confronta questo valore con la percentuale della soglia di superamento per determinare l'esito positivo o negativo della regola. L'espressione può includere un riferimento a un'altra tabella, ad esempio per creare controlli di integrità referenziale. |
Tutte le colonne | Obbligatorio:
|
grossWeight <= netWeight |
| Condizione della tabella (espressione SQL aggregata) |
Aggregazione | Queste regole vengono eseguite una volta per tabella. Indica un'espressione SQL che restituisce come valore booleano true (pass) o false (fail).L'espressione SQL può includere un riferimento a un'altra tabella utilizzando sottoquery di espressione. |
Tutte le colonne | Obbligatorio:
|
Esempio di aggregazione semplice:avg(price) > 100Utilizzo di una sottoquery di espressione per confrontare i valori di una tabella diversa: (SELECT COUNT(*) FROM `example_project.example_dataset.different-table`) < COUNT(*) |
| Asserzione SQL | Aggregazione | Una regola di asserzione utilizza una query sulla qualità dei dati per trovare le righe che non soddisfano una o più condizioni specificate nella query. Fornisci un'istruzione SQL che viene valutata per restituire le righe che corrispondono allo stato non valido. Se la query restituisce delle righe, la regola non riesce. Ometti il punto e virgola finale dall'istruzione SQL. L'istruzione SQL può includere un riferimento a un'altra tabella utilizzando sottoquery di espressione. |
Tutte le colonne | Obbligatorio:
|
Esempio di aggregazione semplice per assicurarsi che discount_pct non sia maggiore di 100:SELECT * FROM example_project.example_dataset.table WHERE discount_pct > 100Utilizzo di una sottoquery di espressione per confrontare i valori in una tabella diversa: SELECT * FROM `example_project.example_dataset.different-table` WHERE gross_weight > (SELECT avg(gross_weight) FROM `example_project.example_dataset.different-table`)
|
Per esempi di regole, consulta Regole di esempio per la qualità dei dati automatica.
Per le funzioni SQL supportate, consulta il riferimento GoogleSQL.
Riutilizza le regole sulla qualità dei dati
Puoi riutilizzare le regole di qualità dei dati di Knowledge Catalog per condividere definizioni di regole aziendali complesse o standardizzate tra più regole di qualità dei dati utilizzando i modelli di regole. Ad esempio, puoi creare un modello di regola per la convalida di un'email o per la convalida di una chiave esterna tra due tabelle, quindi riutilizzare questi modelli nelle scansioni dei dati.
La riusabilità delle regole offre le seguenti funzionalità principali:
- Modelli di regole per la qualità dei dati: crea modelli di regole personalizzati per archiviare definizioni di regole aziendali complesse o standardizzate che possono essere condivise tra più regole per la qualità dei dati. Crea una voce
data-quality-rule-templatee aggiungi un aspettodata-quality-rule-templateper definire la logica del template. - Regole sui dati come metadati: dichiara le regole sulla qualità dei dati come aspetti in Knowledge Catalog su voci come tabelle BigQuery o termini del glossario aziendale. Utilizza il tipo di aspetto
data-rulesper collegare queste regole alle voci. - Modelli di regole di sistema: utilizza i modelli di regole di sistema per le regole di uso comune.
Per saperne di più, consulta Riutilizza le regole di qualità dei dati.
Dimensioni
Le dimensioni ti consentono di aggregare i risultati di più regole di qualità dei dati per il monitoraggio e gli avvisi. Devi associare ogni regola sulla qualità dei dati a una dimensione. Knowledge Catalog fornisce le seguenti dimensioni:
- Aggiornamento
- La freschezza misura l'ultimo aggiornamento dei dati. Queste informazioni possono aiutarti a determinare se i dati sono abbastanza recenti da essere utili.
- Volume
- Il volume misura se sono presenti tutti i dati previsti.
- Completezza
- La completezza valuta se i dati contengono tutte le informazioni necessarie per lo scopo previsto.
- Validità
- La validità valuta se i dati sono conformi agli standard integrati per il formato, gli intervalli accettabili o altri criteri. Ad esempio, se una data valida deve avere il formato
YYYY/mm/dd, 08-12-2019 è un dato non valido. Un altro esempio: se un prezzo scontato valido per un articolo è compreso tra 10 $e 20 $, un prezzo scontato di 100 $è un dato non valido. - Coerenza
- La coerenza si riferisce alla presenza degli stessi valori per i dati in più istanze, ad esempio tabelle e colonne. L'incoerenza dei dati si verifica quando, ad esempio, le entrate di un prodotto differiscono se vengono lette da un database di vendita o da un database di utilizzo.
- Accuratezza
- L'accuratezza riflette la correttezza dei dati. Tieni presente che i dati validi non sono necessariamente accurati. Ad esempio, un colore di capelli valido potrebbe essere castano, ma se una persona non ha i capelli castani, si tratta di dati imprecisi.
- Unicità
- L'unicità misura se i dati sono distinti e non contengono duplicati.
Input digitato nelle regole
Tutti i parametri dei valori vengono passati all'API come valori di stringa. Knowledge Catalog richiede che gli input seguano il formato specificato di BigQuery.
I parametri di tipo binario possono essere passati come stringa con codifica base64.
| Tipo | Formati supportati | Esempi |
|---|---|---|
| Binario | Valore codificato Base64 | YXBwbGU= |
| Timestamp | YYYY-[M]M-[D]D[( |T)[H]H:[M]M:[S]S[.F]] [time_zone] OPPURE YYYY-[M]M-[D]D[( |T)[H]H:[M]M:[S]S[.F]][time_zone_offset] |
2014-09-27 12:30:00.45-08 |
| Data | YYYY-M[M]-D[D] | 2014-09-27 |
| Ora | [H]H:[M]M:[S]S[.DDDDDD] | 12:30:00.45 |
| DateTime | YYYY-[M]M-[D]D [[H]H:[M]M:[S]S[.DDDDDD]] | 2014-09-27 12:30:00.45 |
Parametro di riferimento dei dati
Quando crei una regola SQL personalizzata, puoi fare riferimento a una tabella dell'origine dati e a tutti i relativi filtri di precondizione utilizzando il parametro di riferimento dei dati ${data()} nella regola, anziché menzionare esplicitamente la tabella di origine e i relativi filtri.
Knowledge Catalog interpreta il parametro come un riferimento alla tabella di origine e ai relativi filtri. Esempi di filtri di precondizione includono filtri di riga, percentuali di campionamento e filtri incrementali.
Ad esempio, supponiamo di avere una tabella dell'origine dati denominata my_project_id.dim_dataset.dim_currency. Vuoi eseguire una scansione incrementale della qualità dei dati che analizzi solo i nuovi dati giornalieri. Alla tabella viene applicato un filtro di riga che filtra le voci di oggi, transaction_timestamp >= current_date().
Una regola SQL personalizzata per trovare le righe con discount_pct per oggi è simile alla seguente:
discount_pct IN (SELECT discount_pct FROM my_project_id.dim_dataset.dim_currency WHERE transaction_timestamp >= current_date())
Se utilizzi il parametro di riferimento dei dati, puoi semplificare la regola. Sostituisci la menzione della tabella e dei relativi filtri di precondizione con il parametro ${data()}:
discount_pct IN (SELECT discount_pct FROM ${data()})
Knowledge Catalog interpreta il parametro ${data()} come riferimento alla tabella dell'origine dati con le voci di oggi, my_project_id.dim_dataset.dim_currency WHERE transaction_timestamp >= current_date().
In questo esempio, il parametro di riferimento dei dati fa riferimento solo ai dati incrementali.
Il parametro ${data()} è sensibile alle maiuscole.
Quando utilizzi un alias all'interno di una sottoquery per fare riferimento alle colonne della tabella di origine, utilizza il parametro di riferimento ai dati per fare riferimento alla tabella di origine oppure ometti il riferimento alla tabella. Non fare riferimento alle colonne della tabella di origine utilizzando un riferimento diretto alla tabella nella clausola WHERE.
Consigliato:
Utilizza il parametro di riferimento dei dati per fare riferimento alla tabella di origine:
discount_pct IN (
SELECT discount_pct FROM
`my_project_id.dim_dataset.dim_currency` AS temp-table
WHERE
temp-table.transaction_timestamp = ${data()}.timestamp
)
Ometti il riferimento della tabella:
discount_pct IN (
SELECT discount_pct FROM
`another_project.another_dataset.another_table` AS temp-table
WHERE
temp-table.transaction_timestamp = timestamp
Non consigliato:
Non utilizzare un riferimento diretto alla tabella per fare riferimento alle colonne della tabella di origine:
discount_pct IN (
SELECT discount_pct FROM
`my_project_id.dim_dataset.dim_currency` AS temp-table
WHERE
temp-table.transaction_timestamp = `my_project_id.dim_dataset.dim_currency`.timestamp
)
Utilizzo valido di tabelle diverse:
Puoi utilizzare un riferimento diretto alla tabella quando confronti le colonne di una tabella diversa:
discount_pct IN (
SELECT discount_pct FROM
`my_project_id.dim_dataset.dim_currency` AS temp-table
WHERE
temp-table.transaction_timestamp = `another_project.another_dataset.another_table`.timestamp
)
Query di debug
Quando crei una regola, puoi facoltativamente includere una query di debug da eseguire insieme alla regola. Una query di debug è un'istruzione SQL che restituisce fino a 10 valori scalari. Questi valori possono aiutare a diagnosticare la causa in caso di errore della regola. Puoi aggiungere al massimo una query di debug per regola, che non deve superare i 1024 caratteri di lunghezza.
Considera la seguente regola di asserzione SQL sulla tabella example_project.example_dataset.table che controlla se le entrate medie per articolo superano 100:
SELECT
  *
FROM
  `example_project.example_dataset.table`
WHERE
  SUM(revenue) / COUNT(DISTINCT item_id) > 100
Se la regola precedente non va a buon fine, puoi visualizzare metriche come le entrate totali, il numero di articoli distinti e le entrate medie per articolo per diagnosticare il problema. La seguente query di debug restituisce queste metriche:
SELECT
  SUM(revenue),
  COUNT(DISTINCT item_id),
  SUM(revenue) / COUNT(DISTINCT item_id)
FROM `example_project.example_dataset.table`
Esecuzione della regola
Puoi pianificare l'esecuzione delle scansioni della qualità dei dati a un intervallo specifico o puoi eseguirle on demand.
Identità di esecuzione
Per impostazione predefinita, Knowledge Catalog utilizza un agente di servizio centralizzato (service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com) per eseguire le scansioni della qualità dei dati.
Puoi eseguire l'override di questa identità di esecuzione predefinita specificando un service account personalizzato o utilizzando le tue credenziali utente finale (EUC). Questo approccio offre diversi vantaggi:
- Principio del privilegio minimo: concedi solo le autorizzazioni IAM esatte richieste per attività specifiche di qualità dei dati a un account di servizio dedicato, riducendo al minimo l'accesso con provisioning eccessivo.
- Controllo granulare dell'controllo dell'accesso: limita le autorizzazioni a risorse specifiche, consentendo l'integrazione con le policy di accesso a livello di riga e di colonna in BigQuery.
- Verificabilità migliorata: assegna service account o credenziali utente personalizzati a scansioni specifiche, rendendo il monitoraggio e la registrazione delle attività molto più chiari nei log di controllo.
- Unificazione della fatturazione: quando utilizzi un'identità di esecuzione personalizzata, i costi di elaborazione e archiviazione vengono centralizzati direttamente in BigQuery (bypassando gli SKU Knowledge Catalog Premium). In questo modo, puoi usufruire degli sconti aziendali e degli impegni di slot di BigQuery.
Per istruzioni su come configurare un'identità di esecuzione personalizzata, consulta Configura l'identità di esecuzione.
Requisiti di networking
Per eseguire un'analisi, devi abilitare l'accesso privato Google nella subnet VPC che utilizzi per l'analisi. Se non specifichi una subnet, assicurati che l'accesso privato Google sia abilitato per la subnet predefinita.
Quando esegui una scansione della qualità dei dati, Knowledge Catalog crea un job. Se un job è configurato in modo errato o richiede più tempo del previsto, puoi annullarlo.
Nell'ambito della specifica di una scansione della qualità dei dati, puoi specificare l'ambito di un job in uno dei seguenti modi:
- Tabella completa
- Ogni job convalida l'intera tabella.
- Incrementale
- Ogni job convalida i dati incrementali. Per determinare gli incrementi, fornisci una colonna
Date/Timestampnella tabella che possa essere utilizzata come indicatore. In genere, si tratta della colonna in base alla quale è partizionata la tabella.
Filtra dati
Puoi filtrare i dati da analizzare per la qualità dei dati utilizzando un filtro di riga. La creazione di un filtro di riga ti consente di concentrarti sui dati relativi a un periodo di tempo specifico o a un segmento specifico, ad esempio una determinata regione. L'utilizzo dei filtri può ridurre il tempo di esecuzione e i costi. Ad esempio, puoi filtrare i dati con un timestamp precedente a una determinata data.
Dati di esempio
Puoi specificare una percentuale di record dei tuoi dati da campionare per eseguire una scansione della qualità dei dati. La creazione di scansioni della qualità dei dati su un campione di dati più piccolo può ridurre il tempo di esecuzione e il costo rispetto all'esecuzione di query sull'intero set di dati.
Filtra regole
Quando esegui una scansione della qualità dei dati, puoi utilizzare la sintassi del filtro AIP-160 per eseguire in modo selettivo regole specifiche. Knowledge Catalog esegue il filtro sui metadati delle regole definite nell'analisi o delle regole associate alla voce del catalogo tramite l'aspetto data-rules.
Sintassi filtro
La sintassi del filtro segue le linee guida AIP-160. Puoi utilizzare gli operatori AIP-160 standard (come =, !=, >, <, =~) e combinare più condizioni utilizzando AND o OR.
Quando utilizzi una stringa di filtro AIP-160, segui questi passaggi:
- Nella console Google Cloud : inserisci il filtro direttamente utilizzando la sintassi AIP-160, ad esempio
name = "critical_check". - In una chiamata API: la stringa di filtro è spesso un valore all'interno di un altro valore letterale stringa JSON. Ciò richiede l'escape delle virgolette doppie all'interno della stringa AIP-160. Ad esempio,
"filter": "name = \"critical_check\"".
Campi filtrabili
Puoi applicare un filtro alla maggior parte dei campi disponibili nella definizione della regola:
name: il nome visualizzato della regola.dimension: la dimensione della qualità dei dati (ad esempioVALIDITY).column: il nome della colonna a cui si applica la regola.threshold: la soglia di superamento della regola.ignore_null: un valore booleano. Quandotrue,NULLrighe sono considerate superate.attributes: coppie chiave-valore personalizzate assegnate alla regola.
Gli esempi riportati di seguito mostrano pattern di filtri comuni. I valori numerici e booleani non sono racchiusi tra virgolette.
Filtra per nome
- Corrispondenza esatta:
name = "critical_check" - Corrispondenza con un pattern:
name =~ "temp_.*"
Filtra per dimensione
- Corrisponde a una dimensione specifica:
dimension = "COMPLETENESS" - Corrispondenza di più dimensioni:
dimension = "VALIDITY" OR dimension = "ACCURACY"
Filtra per colonna e soglia
- Corrispondenza con una colonna specifica:
column = "user_id" - Corrispondenza con una soglia:
threshold > 0.95 - Corrispondenza di un intervallo:
threshold >= 0.8 AND threshold < 0.9
Filtra per ignore_null
- Valore booleano di corrispondenza:
ignore_null = true
Filtra per attributi personalizzati
- Verifica la presenza della chiave:
attributes:environment - Chiave e valore di corrispondenza:
attributes.environment = "prod" - Corrispondenza mediante espressioni regolari:
attributes.tag =~ "prio-.*" - Combinazioni di corrispondenza:
attributes.environment = "prod" AND attributes.criticality = "high"
Risultati dell'analisi della qualità dei dati
I risultati delle scansioni della qualità dei dati sono disponibili in Knowledge Catalog e BigQuery. Puoi anche esaminare e analizzare i risultati della scansione utilizzando i seguenti metodi:
Esporta i risultati in BigQuery
Puoi esportare i risultati della scansione in una tabella BigQuery per un'analisi più approfondita. Per personalizzare i report, puoi collegare i dati della tabella BigQuery a una dashboard di Looker. Puoi creare un report aggregato utilizzando la stessa tabella dei risultati in più analisi.
Pubblica i risultati come metadati di Knowledge Catalog
Puoi pubblicare i risultati della scansione della qualità dei dati come metadati di Knowledge Catalog. I risultati più recenti vengono salvati nella voce Knowledge Catalog che rappresenta la tabella di origine, nel tipo di aspetto di sistema
data-quality-scorecard. Puoi visualizzare i risultati nelle pagine BigQuery e Knowledge Catalog della tabella di origine nella console Google Cloud , nella scheda Qualità dei dati. Puoi anche recuperare i risultati utilizzando l'API.Per saperne di più sui metadati di Knowledge Catalog, consulta Informazioni sulla gestione dei metadati in Knowledge Catalog.
Esamina i punteggi di qualità dei dati
Ogni risultato della scansione fornisce punteggi di qualità dei dati che indicano la percentuale di regole superate. I punteggi vengono riportati a livello di job complessivo, di colonna (se la regola viene valutata rispetto a una colonna) e di dimensione. Utilizza i punteggi di qualità dei dati per normalizzare la qualità dei dati tra tabelle o colonne, monitorare le tendenze e identificare i dati che non soddisfano i requisiti di qualità.
Per saperne di più, consulta Visualizza i risultati della scansione della qualità dei dati.
Monitoraggio e avvisi
Puoi monitorare e ricevere avvisi sulle scansioni della qualità dei dati utilizzando i seguenti metodi:
Imposta gli avvisi in Cloud Logging
Puoi monitorare i job di qualità dei dati utilizzando i log
data_scanedata_quality_scan_rule_resultin Esplora log.Per ogni job di qualità dei dati, il log
data_scancon il campodata_scan_typeimpostato suDATA_QUALITYcontiene le seguenti informazioni:- Origine dati utilizzata per l'analisi dei dati.
- Dettagli dell'esecuzione del job, come ora di creazione, ora di inizio, ora di fine e stato del job.
- Risultato del job di qualità dei dati: superato o non superato.
- Superamento o mancato superamento a livello di dimensione.
Ogni job riuscito contiene un log
data_quality_scan_rule_resultcon le seguenti informazioni dettagliate su ogni regola del job:- Informazioni di configurazione, come nome della regola, tipo di regola, tipo di valutazione e dimensione.
- Informazioni sui risultati, ad esempio superamento o errore, conteggio totale delle righe, conteggio delle righe superate, conteggio delle righe nulle e conteggio delle righe valutate.
Le informazioni nei log sono disponibili tramite l'API e la consoleGoogle Cloud . Puoi utilizzare queste informazioni per configurare gli avvisi. Per saperne di più, consulta Imposta gli avvisi in Logging.
Invia report di notifica via email
Puoi inviare report di notifica via email per avvisare le persone dello stato e dei risultati di un job di qualità dei dati. I report sulle notifiche sono disponibili per i seguenti scenari:
- Il punteggio di qualità dei dati è inferiore a un punteggio target specificato
- Il job non è riuscito
- Il job è terminato
Puoi configurare i report di notifica quando crei una scansione della qualità dei dati.
Monitora i costi di calcolo delle DCU nella fatturazione Cloud
Il computing serverless per la scansione della qualità dei dati non genera metriche delle serie temporali in Cloud Monitoring. Per monitorare e attribuire i costi delle DCU di qualità dei dati per progetto, ID scansione o tabella, esegui una query sull'esportazione della fatturazione Cloud in BigQuery utilizzando le etichette di sistema
goog-dataplex-datascan-*. Per saperne di più, consulta Monitora e attribuisci i costi delle DCU di Dataplex con l'esportazione della fatturazione Cloud.
Risolvi i problemi relativi alla qualità dei dati
Quando l'esecuzione di una regola non va a buon fine, Knowledge Catalog fornisce una query per ottenere i record non riusciti. Esegui questa query per visualizzare i record che non corrispondono alla regola. Per saperne di più, consulta Risolvi un errore di qualità dei dati.
Limitazioni
- I suggerimenti per le regole non sono supportati in gcloud CLI.
- La scelta delle dimensioni è fissa su una delle sette dimensioni predefinite.
- Il numero di regole per scansione della qualità dei dati è limitato a 1000.
- I punteggi di qualità dei dati riportati a livello di colonna sono supportati solo nell'API.
- Puoi eseguire regole di qualità dei dati solo su tabelle BigQuery, tabelle Iceberg REST Catalog, tabelle SAP Business Data Cloud Delta Lake e tabelle Apache Hive.
Prezzi
- Per ulteriori informazioni sui prezzi, consulta Prezzi di Knowledge Catalog.
- Per monitorare e attribuire l'utilizzo e i costi delle DCU per l'analisi della qualità dei dati utilizzando l'esportazione della fatturazione Cloud in BigQuery, consulta Monitora e attribuisci i costi delle DCU di Dataplex con l'esportazione della fatturazione Cloud.
Passaggi successivi
- Scopri come utilizzare la qualità dei dati automatica.
- Scopri come riutilizzare le regole di qualità dei dati.
- Scopri come gestire le regole di qualità dei dati come codice.
- Segui un tutorial per creare un workflow di qualità dei dati basato su policy-as-code.
- Scopri le risorse Terraform disponibili per la profilazione dei dati. Consulta i seguenti articoli:
- Risorsa di analisi dei dati Dataplex nel registry di Terraform.
- La documentazione della risorsa di analisi dei dati di Dataplex su GitHub, che supporta la configurazione delle regole basata su YAML.
- Scopri di più sulla profilazione dei dati.
- Scopri come utilizzare la profilazione dei dati.