


Knowledge Catalog (in precedenza Dataplex Universal Catalog) ti consente di rilevare e indicizzare automaticamente le strutture tecniche, il contesto aziendale, le metriche sulla qualità dei dati e le relazioni operative nel tuo patrimonio di dati distribuito. Knowledge Catalog organizza questi metadati in un metamodello flessibile ed estensibile e in un grafico di contesto attivo che ti aiuta a governare gli asset di dati e a fornire un grounding agli agenti di AI generativa.
Metamodello di Knowledge Catalog
Il metamodello di Knowledge Catalog fornisce una gestione unificata e strutturata dei metadati e stabilisce la base strutturale dell'Active Context Graph all'interno dell'Agentic Data Cloud di Google. Questo grafico di contesto aiuta te e i tuoi team di dati a scoprire e gestire gli asset e consente agli agenti di AI generativa di recuperare un contesto aziendale affidabile e fondato.
Knowledge Catalog organizza i metadati tramite una gerarchia modulare di container, asset, schemi e relazioni:
- Container e asset: i gruppi di voci organizzano le voci, che rappresentano singoli asset di dati e le relative colonne dello schema.
- Arricchimento strutturato: i tipi di aspetto definiscono gli schemi per gli aspetti, che collegano metadati strutturati a voci, colonne o relazioni.
- Standard e governance: i tipi di voci definiscono modelli che applicano gli aspetti obbligatori alle voci.
- Relazioni: i tipi di link alle voci definiscono le relazioni (link alle voci) che collegano le voci e i termini aziendali correlati.
La seguente tabella riassume la distinzione tra le risorse gestite dal sistema (fornite automaticamente da Google Cloud) e le risorse personalizzate definite dall'utente:
| Elemento metamodello | Gestito dal sistema (integrato) | Definito dall'utente (personalizzato) |
|---|---|---|
| Gruppi di voci | Predefinito per progetto per i servizi Google Cloud (ad esempio,@bigquery, @spanner, @pubsub). |
Creato dagli utenti per raggruppare e gestire asset di dati e autorizzazioni personalizzati. |
| Entries | Compilato automaticamente da Google Cloud origini (ad esempio tabelle, viste, set di dati e modelli BigQuery). | Creati dagli utenti per rappresentare origini dati, file o database di terze parti personalizzati. |
| Tipi di aspetto | Modelli di sistema predefiniti (ad esempio, Schema,
Overview, Contacts, DataQuality,
Lineage). |
Creati dagli utenti per definire schemi di metadati specifici del dominio (ad esempio la classificazione delle PII o i livelli di SLA). |
| Aspetti | Compilati automaticamente dai sistemi di origine, dai log delle query o dalle scansioni automatiche. | Creati da utenti, pipeline o agenti e collegati a voci, colonne o link alle voci. |
| Tipi di voci | Modelli predefiniti che rappresentano i tipi di risorse Google Cloud . | Definiti dagli utenti per specificare gli aspetti obbligatori e facoltativi degli asset di dati personalizzati. |
| Link di accesso | Tipi di relazioni integrati (ad esempio synonym,
definition, schema-join,
related). |
Istanze create tra voci o colonne specifiche per modellare le connessioni tra sistemi. |
Le sezioni seguenti descrivono i componenti principali che costituiscono il metamodello di Knowledge Catalog.
Gruppi di voci
Un gruppo di voci (EntryGroup) è un container regionale per voci e link alle voci che funge da confine amministrativo e di sicurezza per la gestione di queste risorse.
Utilizza i gruppi di voci per configurare quanto segue:
- Controllo degli accessi di Identity and Access Management: concedi le autorizzazioni di visualizzazione o modifica a team specifici su un gruppo di voci senza modificare le autorizzazioni delle singole voci.
- Attribuzione di località e progetti: raggruppa gli asset in base alla regione geografica e alla proprietà del progetto.
Per le origini Google Cloud , Knowledge Catalog crea automaticamente gruppi di voci di sistema per progetto (ad esempio @bigquery o @spanner). Per le origini dati personalizzate, crei gruppi di voci personalizzati.
Ad esempio, un team Finance può creare un gruppo di voci personalizzate denominato production_finance_data per gestire le autorizzazioni di accesso per tutte le voci personalizzate relative alla finanza in un'unica posizione.
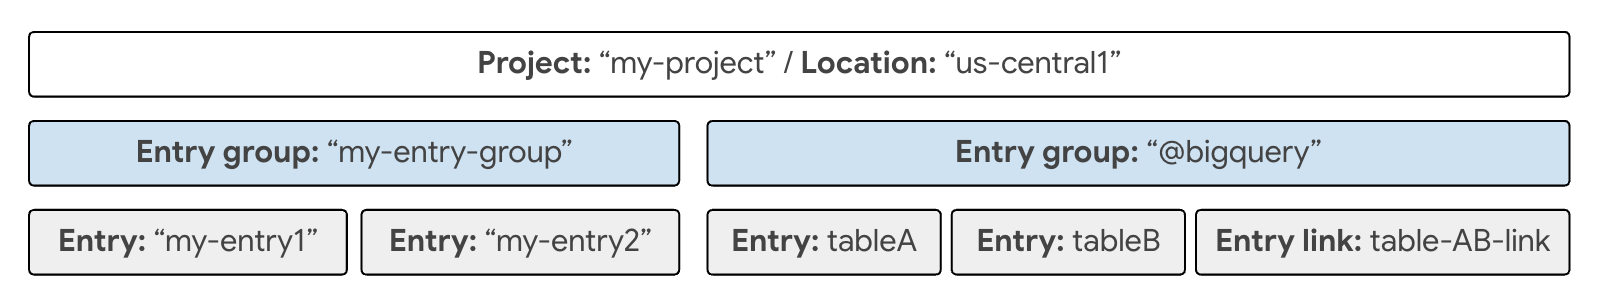
Per saperne di più, consulta Gruppi di voci.
Voci e percorsi degli schemi
Una voce (Entry) rappresenta un singolo asset di dati. Una voce può rappresentare una tabella di database strutturata, un modello analitico, una tabella di oggetti non strutturati o un set di dati esterno personalizzato.
I componenti chiave di una voce includono:
- Identificatore della voce: un nome risorsa univoco all'interno del gruppo di voci principale.
- Tipo di voce: il modello che definisce la struttura della voce e gli aspetti obbligatori.
- Aspetti: attributi dei metadati strutturati collegati alla voce.
- Percorsi dello schema (colonne): sottosezioni o campi specifici all'interno dell'asset di dati, ad esempio una colonna in una tabella BigQuery o un campo in uno schema JSON.
Le colonne consentono di collegare i metadati ai singoli campi di un asset. Non definisci le colonne manualmente, ma vengono compilate quando colleghi un aspetto di tipo schema a una voce. Puoi fare riferimento ai campi nidificati utilizzando i percorsi di notazione con punto (ad esempio, customer.address.postal_code).
Ad esempio, una tabella BigQuery denominata orders_project.sales.customer_orders è rappresentata come una voce. Per descrivere il campo email_address all'interno della tabella come contenente informazioni sensibili, collega un aspetto di classificazione direttamente al percorso della colonna email_address.
Per saperne di più, consulta Voci.
Tipi di aspetto
Un tipo di aspetto (AspectType) è un template di schema riutilizzabile che definisce i campi, i tipi di dati e le regole di convalida per un aspetto. Ogni aspetto è un'istanza di un tipo di aspetto.
I tipi di aspetto possono essere definiti dal sistema (forniti da Google Cloud) o personalizzati (creati dalla tua organizzazione).
Quando definisci metadata_template per un tipo di aspetto personalizzato, puoi utilizzare i seguenti tipi di dati supportati:
| Tipo di dati del campo | Descrizione | Caso d'uso di esempio |
|---|---|---|
string |
Valore di testo (UTF-8). | Email del proprietario, etichetta di classificazione dei dati, nome del reparto. |
integer/number |
Valori numerici (numeri interi o con rappresentazione in virgola mobile). | Giorni di conservazione dei dati, percentuale target dello SLA, ranking di priorità. |
boolean |
Flag true o false. | contains_pii: true, is_certified: false. |
enum |
Un elenco predefinito di valori di stringa consentiti. | Ambiente: ["DEV", "STAGING", "PROD"]. |
datetime/timestamp |
Data e ora nel formato ISO 8601. | Data dell'ultima certificazione, scadenza della revisione della conformità. |
record |
Un oggetto strutturato nidificato contenente campi secondari. | ContactInfo { name: string, email: string, phone: string }. |
array |
Un elenco di valori ripetuti di qualsiasi tipo primitivo o di record. | Elenco dei proprietari dei dati secondari: ["user1@example.com", "user2@example.com"]. |
map |
Coppie di stringhe chiave-valore per gli attributi estensibili. | Tag di deployment personalizzati: {"cost_center": "1042", "tier": "gold"}. |
Ad esempio, per definire un modello riutilizzabile per i dati di contatto, puoi creare un tipo di aspetto denominato ContactInfo con i campi per owner_name (string), email (string) e support_channel (string).

Per saperne di più, consulta Tipi di aspetto.
Aspetti
Un aspetto (Aspect) è un insieme di campi di metadati correlati che è conforme a un tipo di aspetto. Gli aspetti sono collegati a una voce, a un percorso di voce (colonna) o a un link di voce per descrivere la risorsa.
A differenza dei sistemi di tagging precedenti, gli aspetti in Knowledge Catalog sono incapsulati direttamente all'interno delle voci o dei link alle voci principali, il che ti consente di eseguire operazioni di lettura e scrittura atomiche.
Gli aspetti vengono utilizzati in più funzioni:
- Struttura tecnica: l'aspetto
Schemadescrive le colonne della tabella, i tipi di dati e le descrizioni. - Contesto aziendale: gli aspetti personalizzati descrivono la proprietà, la conformità e lo stato del ciclo di vita.
- Affidabilità operativa: gli aspetti della qualità dei dati registrano i risultati della scansione delle regole automatizzate e i punteggi di convalida.
- Grafi di entità non strutturate: l'aspetto
GraphProfileacquisisce le entità estratte dall'AI e gli archi di relazione dai file non elaborati.
Ad esempio, puoi creare un'istanza del tipo di aspetto ContactInfo con i valori {"owner_name": "Alex", "email": "alex@example.com"} e collegarla alla voce customer_orders.
Per saperne di più, consulta Aspetti.
Tipi di voci
Un tipo di voce (EntryType) è un template di governance per la creazione di voci personalizzate. Applica gli standard di qualità dei metadati stabilendo i tipi di aspetto obbligatori che devono essere associati a una voce di quel tipo.
Quando crei una voce di un tipo specifico, Knowledge Catalog verifica che tutti i tipi di aspetto contrassegnati come required nel tipo di voce siano presenti e validi.
Ad esempio, puoi creare un tipo di voce denominato CertifiedDataProduct che specifica i tipi di aspetto OwnerInfo e DataRetentionPolicy come obbligatori. Ogni nuova voce creata con questo tipo di voce deve includere questi aspetti prima di poter essere salvata.
Per saperne di più, consulta Tipi di voci.
Link delle voci e tipi di link delle voci
Un link di voce (EntryLink) stabilisce una relazione semantica tra due voci di dati o tra colonne specifiche all'interno delle voci. Ogni link della voce è un'istanza di un tipo di link della voce (EntryLinkType).
I link di ingresso possono essere direzionali o non direzionali:
- Simmetrica (non direzionale): relazioni in cui entrambe le parti sono peer (ad esempio,
synonym,relatedoschema-join). - Asimmetriche (direzionali): relazioni con un'origine e una destinazione esplicite (ad esempio,
definition, che collega un termine del glossario aziendale a una colonna della tabella).
Puoi anche collegare gli aspetti direttamente ai link delle voci (ad eccezione dei link schema-join). In questo modo puoi descrivere la relazione stessa, ad esempio registrando i punteggi di affidabilità dell'unione, le regole di trasformazione o le note di mappatura.
Knowledge Catalog supporta i seguenti tipi di link di voci integrati:
synonym: collega concetti aziendali equivalenti o termini alternativi.related: collega asset a basso accoppiamento tra i sistemi.definition: collega le definizioni del glossario aziendale a colonne o voci fisiche.schema-join: collega le tabelle che possono essere unite lungo percorsi di chiave esterna o schemi corrispondenti.
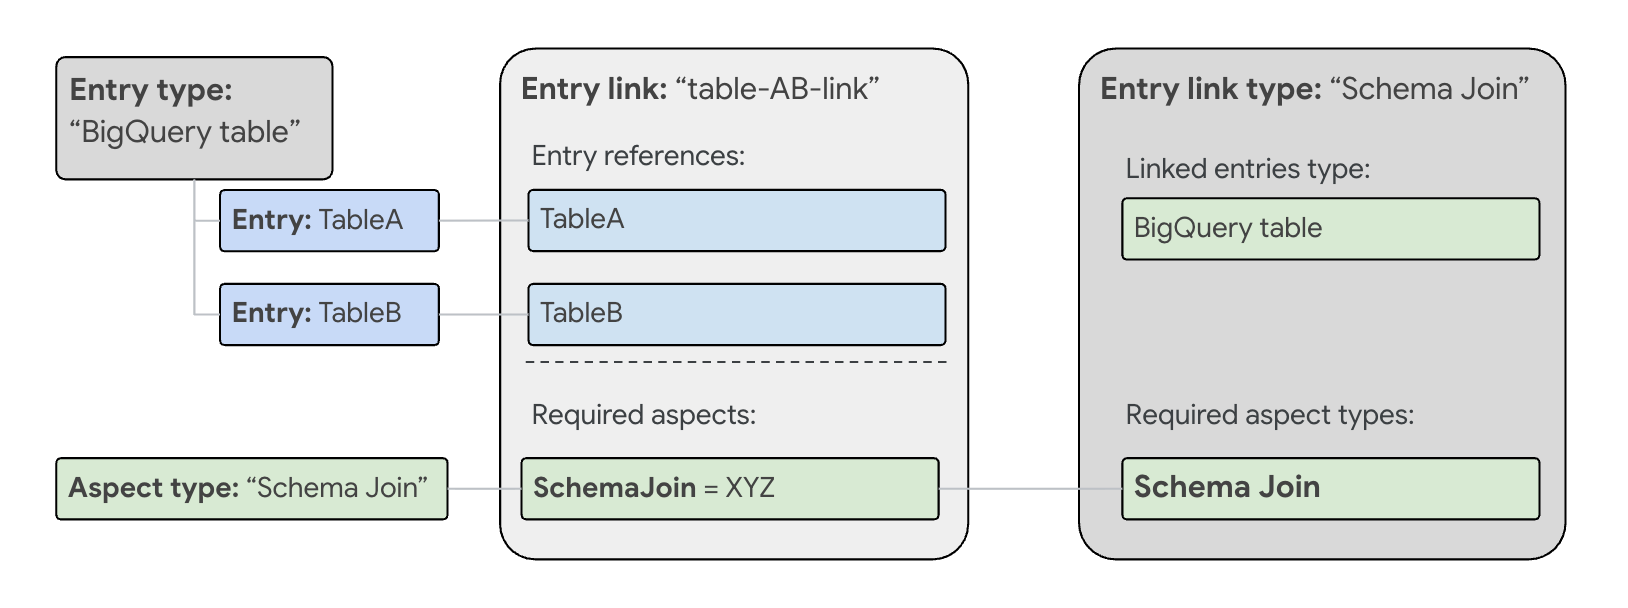
Per saperne di più, consulta il riferimento REST di EntryLinks.
Glossari e termini aziendali
Un glossario aziendale ti consente di stabilire una tassonomia aziendale formale definendo glossari, categorie e termini aziendali.
Utilizzando i link di entrata di tipo definition o synonym, puoi mappare i termini aziendali direttamente alle voci fisiche e ai percorsi delle colonne. Quando gli utenti o gli agenti AI eseguono ricerche nel catalogo utilizzando il linguaggio naturale, il motore di ricerca risolve questi termini aziendali per individuare gli asset di dati fisici corretti.
Per saperne di più, consulta Gestisci i glossari aziendali.
Fonti Google Cloud supportate
Knowledge Catalog importa automaticamente i metadati dalle seguenti originiGoogle Cloud . Per alcuni servizi, come AlloyDB per PostgreSQL e Cloud SQL, devi prima abilitare l'integrazione di Knowledge Catalog prima di poter importare i metadati:
Analisi e lakehouse
- Set di dati, tabelle, viste, modelli, routine, connessioni, set di dati collegati e grafi BigQuery (anteprima)
- Exchange e schede di BigQuery sharing (in precedenza Analytics Hub)
- Repository Dataform e asset di codice
- Servizi, database e tabelle di Dataproc Metastore
Tabelle del catalogo REST Iceberg (tra cui Google Cloud IRC del catalogo di runtime Lakehouse, IRC Databricks Unity, IRC AWS Glue Data Catalog e IRC Snowflake Horizon)
Tabelle Apache Hive
Tabelle Delta Lake di SAP Business Data Cloud (BDC)
Tabelle Apache Iceberg gestite dal catalogo di runtime Lakehouse
AI e machine learning
- Modelli di AI, set di dati, gruppi di caratteristiche, visualizzazioni delle caratteristiche e istanze di negozi online di Vertex AI
Business intelligence
- Istanze di Looker (Google Cloud core), dashboard, elementi della dashboard, Look, dashboard LookML, elementi della dashboard LookML, progetti LookML, modelli, esplorazioni, visualizzazioni e agenti
Database
- Istanze, cluster e tabelle Bigtable (inclusi i dettagli delle famiglie di colonne)
- Istanze, database, tabelle e viste Spanner
Streaming e messaggistica
- Argomenti Pub/Sub
Dati non strutturati
Database operativi
- Cluster, istanze, database, schemi, tabelle e viste di AlloyDB per PostgreSQL (anteprima). Knowledge Catalog recupera i metadati solo dalle istanze principali di AlloyDB e non dalle repliche di lettura. Per saperne di più, consulta Gestisci le risorse AlloyDB per PostgreSQL utilizzando Knowledge Catalog.
- Istanze, database, schemi, tabelle e viste Cloud SQL. Knowledge Catalog recupera i metadati solo dalle istanze principali di Cloud SQL e non dalle repliche di lettura. Per saperne di più, consulta Gestisci le risorse Cloud SQL utilizzando Knowledge Catalog.
Per importare i metadati da un'origine di terze parti in Knowledge Catalog, puoi utilizzare i connettori di Knowledge Catalog o una pipeline di connettività gestita. Per saperini di più, consulta Informazioni sui connettori di Knowledge Catalog e Panoramica della connettività gestita.
Vincoli di progetto e località
Le risorse del catalogo in Knowledge Catalog sono ospitate all'interno di progetti e posizioni geografiche Google Cloud specifici. Si applicano i seguenti vincoli di definizione dell'ambito:
| Risorsa | Regola per le località | Regola del progetto |
|---|---|---|
| Entries | La località della voce deve corrispondere a quella del relativo EntryType oppure il EntryType deve essere global. |
Può fare riferimento a tipi di voci globali o dello stesso progetto. |
| Aspetti delle voci | AspectType dell'aspetto deve essere archiviato nella stessa località della voce oppure AspectType deve essere global. |
Può fare riferimento a tipi di aspetti globali o dello stesso progetto. |
| Link di accesso | La località del link di ingresso deve corrispondere al relativo EntryLinkType oppure
il EntryLinkType deve essere global. |
Può collegare voci che si trovano in progetti diversi all'interno della stessa organizzazione. |
| Tipi di voci | Composto da tipi di aspetto archiviati nella stessa posizione del tipo di voce o da tipi di aspetto global. |
Se un tipo di voce fa riferimento a tipi di aspetto personalizzato, questi devono trovarsi nello stesso progetto e nella stessa località. |
Feed delle modifiche dei metadati
Knowledge Catalog può trasmettere in streaming gli eventi di modifica dei metadati quasi in tempo reale utilizzando i feed di modifica dei metadati.
Un feed delle modifiche dei metadati pubblica notifiche sulla creazione, l'aggiornamento o l'eliminazione di voci in un argomento Pub/Sub configurato da te. I client sottoscrittori possono utilizzare questi eventi per automatizzare i workflow operativi, ad esempio attivando valutazioni della qualità dei dati quando uno schema cambia o aggiornando le dashboard di governance downstream.
Per saperne di più, consulta Informazioni sui feed delle modifiche dei metadati.
Prezzi
Knowledge Catalog utilizza lo SKU di archiviazione dei metadati per addebitare il volume dei metadati archiviati. Per saperne di più, consulta i prezzi di Knowledge Catalog.
Non sono previsti addebiti per:
- Creazione e gestione delle risorse del metamodello del catalogo (tipi di voci, tipi di aspetto, gruppi di voci, voci e link alle voci).
- Chiamate API di ricerca e query di ricerca eseguite nella console Google Cloud .
Passaggi successivi
Aggiungi metadati a una tabella
Scopri gli asset e allega metadati di aspetti personalizzati a una tabella BigQuery.
Importa origini dati personalizzate
Definisci i tipi di voci e importa i metadati personalizzati da database e pipeline esterni.
Gestisci i glossari aziendali
Crea una tassonomia aziendale e mappa i termini direttamente alle tabelle e alle colonne fisiche.
Cerca e scopri gli asset
Scopri le risorse in Google Cloud e nelle origini personalizzate utilizzando i predicati di ricerca.
Recupera il contesto per gli agenti AI
Recupera i metadati pronti per l'LLM e il contesto attivo per basare gli agenti di AI generativa.