


משימות העשרה הן סוכנים אוטונומיים ב-Knowledge Catalog שעוזרים למנהלי מדיניות מידע ארגונית ולמהנדסי פלטפורמות להרחיב את פעולות המטא-נתונים שלהם. משימת העשרה מנתחת באופן רציף את הסכימות של מערכי הנתונים, קוראת את המסמכים של החברה ויוצרת הצעות לתיאורים של נכסי הנתונים. כדי להפיק את המקסימום ממשימות ההעשרה, אתם צריכים להכיר את המושגים העיקריים של Knowledge Catalog ואת ארכיטקטורת הנתונים של הארגון.
משימות ההעשרה יוצרות מטא-נתונים באופן אוטומטי, וכך מפחיתות את הצורך באוצרות ידנית ומוודאות שהקטלוג משקף הקשר מדויק וספציפי לעסק.
למה כדאי להשתמש במשימות העשרה
משימות העשרה עוזרות להתמודד עם האתגר של שמירה על הדיוק והעדכניות של קטלוגים של נתונים בקנה מידה גדול.
| כיוון המדרון | הגישה המקובלת | הגישה של Knowledge Studio |
|---|---|---|
| תהליך | תיאורים בכתב יד. הם בודקים באופן ידני אלפי טבלאות ומראיינים מומחים בתחום. | מבוסס-נציג. סוכן אוטונומי מנתח נתונים וקורא נהלי הפעלה רגילים. |
| מהירות והיקף | איטי וקשה לתחזוקה כשהסכימות משתנות לאורך זמן. | ניתן להתאמה בקלות. הצעות למטא-נתונים באיכות גבוהה נוצרות באופן רציף. |
| מאמץ אנושי | גבוהה. הזנה ידנית נרחבת של נתונים ותחזוקה שוטפת. | נמוכה. מנהלי המידע צריכים רק לבדוק ולאשר את ההצעות שנוצרו. |
תרחישים לדוגמה של משימות העשרה
משימות העשרה עוזרות לארגונים לפתור את האתגרים הנפוצים הבאים שקשורים למטא-נתונים:
שילוב רכישה: חברה רוכשת יחידה עסקית חדשה עם אלפי נכסי נתונים לא מתועדים. מהנדסי מערכות מידע מפנים משימת העשרה לקבוצת הנתונים החדשה, ומשתמשים במילוני הנתונים של החברה שנרכשה כאות ידע. הסוכן מציע תיאורים שמתאימים לעסק לכל מערך הנתונים תוך כמה שעות במקום כמה חודשים.
תיעוד רציף: צוות הנדסת פלטפורמה בונה מאגר נתונים דינמי שבו הסכימות משתנות מדי יום. הם מגדירים משימת העשרה שתפעל לפי לוח זמנים יומי עם פרסום אוטומטי, כדי לוודא שהקטלוג תמיד משקף את השינויים האחרונים בסכימה.
ניהול סמנטי: משרד נתונים מרכזי רוצה ליצור סטנדרטיזציה של המינוחים בכל המחלקות. הם פורסים משימת העשרה שמפנה למילון מונחים שנבחר בקפידה ב-Knowledge Catalog. הנציג מסמן באופן אוטומטי ומציע שינויים לכל תיאורי הטבלאות שמפירים את המונחים שאושרו במילון המונחים של הארגון.
מושגי ליבה
כשמגדירים משימת העשרה, מגדירים את רכיבי הליבה הבאים:
- משימת העשרה
-
ההגדרה שקובעת מה הנציג צריך לעשות. משימה כוללת את קבוצת ההקשרים שבחרתם, משאבי היעד, לוח הזמנים וכל אותות הידע שאתם מספקים.
לדוגמה, משימה שמוגדרת להורות לסוכן לקרוא את המאגרים שלכם ב-GitHub ולהעשיר את קבוצת הנתונים של
financeבכל יום ראשון בחצות. - משימת העשרה
- תהליך התזמור בקצה העורפי ב-Knowledge Studio שמבצע משימת העשרה.
- הרצת העשרה
-
מופע ביצוע יחיד של משימה בנקודת זמן מסוימת. במסוף של Knowledge Studio יש כרטיסייה בשם Jobs שבה מופיעה היסטוריית ההרצות של משימה מסוימת. אפשר לפתוח הרצה ספציפית כדי לבדוק את הצעות המטא-נתונים שנוצרו בה.
לדוגמה, מופע ההפעלה הספציפי שהתרחש ב-24 באוקטובר והוביל ל-15 הצעות לשינויים בעמודות.
- קבוצת הקשרים
-
מאגר מוגבל של נכסי נתונים ומטא-נתונים. כל משימת העשרה חייבת להיות מוגדרת לטירגוט של קבוצת הקשר אחת בדיוק. קבוצת ההקשר יכולה להכיל משאבי יעד, כמו מערך נתונים ב-BigQuery או Lakehouse, אבל אפשר גם ליצור קבוצת הקשר ריקה אם אין קבוצה קיימת.
לדוגמה, קבוצת הקשרים שיווקיים שתוחמת באופן לוגי את טבלאות הקמפיינים, מדדי ההחזר על הוצאות הפרסום ומילוני המונחים שלכם לגבול הקשר אחד של AI.
- אותות של ידע
- חומרים חיצוניים שמעגנים את הנציג במציאות של החברה. כדי לוודא שהסוכן משתמש בלוגיקה העסקית הספציפית שלכם ולא מנחש ניחושים כלליים, אתם יכולים לספק קטגוריות של Cloud Storage שמכילות מילוני נתונים, מילוני מונחים של Knowledge Catalog או כתובות URL של מסמכי תיעוד פנימיים.
- קבוצות הערכה
-
שאלות לבדיקה ושאילתות SQL תואמות (בפורמט
.jsonl) שמשמשות לדירוג הדיוק של הנציג. כשהנציג מציע מטא-נתונים חדשים, הוא מריץ את שאלות הבדיקה האלה על ההצעות כדי לוודא שרמת הדיוק לא יורדת לפני הפרסום.לדוגמה, אפשר להוסיף שאלה לדוגמה כמו "מהו ה-MRR שלנו?" יחד עם שאילתת ה-SQL המדויקת שנדרשת כדי לחשב את ההכנסה החודשית החוזרת (MRR). אם הסוכן מציע מטא-נתונים מבלבלים שגורמים לשאילתת הבדיקה להיכשל, ההצעה מסומנת.
- מקורות ללמידה עצמית
-
יומני שיחות בזמן אמת מאפליקציות Gemini Enterprise או מ-BigQuery Agent Analytics. הנציג קורא את יומני הצ'אטים האלה כדי לזהות מה המשתמשים שואלים, מגלה פערים בידע ויוצר באופן אוטומטי הצעות למטא-נתונים חדשים כדי למלא את הפערים האלה.
לדוגמה, אם ביומני הצ'אט רואים שהמשתמשים שואלים לעיתים קרובות "מה המשמעות של קוד הסטטוס 42?" והנציג לא מצליח לענות, הלמידה העצמית מפעילה הצעה למטא-נתונים כדי לתעד את קוד הסטטוס החסר.
מקורות נתונים ושילובים נתמכים למשימות העשרה
משימות העשרה משתלבות גם עם Google Cloud וגם עם מערכות של צד שלישי.
נכסי נתונים לטירגוט
סוכן ההעשרה יכול להעשיר ולהוסיף ישירות את נכסי נתוני היעד הבאים שלGoogle Cloud לקבוצות ההקשר:
מערכי נתונים, טבלאות ותצוגות ב-BigQuery
אגמים, אזורים ונכסים ב-Lakehouse
באמצעות שילוב עם Lakehouse, Knowledge Studio תומך באופן עקיף בהעשרת מטא-נתונים ממקורות של צד שלישי שמצורפים דרך שילובים עם Iceberg REST Catalog (כמו Databricks Unity, Snowflake Horizon, AWS Glue Data Catalog ו-SAP Business Data Cloud).
אותות של ידע
במהלך הרצת העשרה, הנציג מחלץ כללים סמנטיים, הקשר עסקי וידע בתחום ממקורות לקריאה בלבד הבאים:
Google Cloud:
- קטגוריות של Cloud Storage שמכילות קבצים בפורמטים נתמכים (כמו קובצי PDF, CSV, Markdown, קובצי הגדרות אישיות, מערכי נתונים וקובצי טקסט לא מובנים)
- מילוני מונחים ארגוניים של Knowledge Catalog שנמצאים באותו היקף אזורי
- אפליקציות של Google Workspace, כולל קבצים ב-Google Drive (כמו מסמכים, גיליונות אלקטרוניים, מצגות, קובצי PDF, קבצים ומסמכי טקסט כלליים)
מערכות של צד שלישי (לא Google Cloud):
- קבצים ב-Microsoft SharePoint שקטנים מ-5MB (כמו קובצי PDF, קובצי Office ומסמכי טקסט כלליים, לא כולל פורמטים ישנים או תמונות)
- מאגרים ב-GitHub (כל קובץ שמכיל טקסט קריא)
- גופי דפים ב-Atlassian Confluence
מקורות ללמידה עצמית
כדי לזהות פערים בידע מיומני אינטראקציה אמיתיים, סוכן ההעשרה מחלץ מסלולים מהמקורות הבאים:
- אפליקציות Gemini Enterprise
- טבלאות BigQuery Agent Analytics
- Cloud Logging באמצעות תצוגות יומן מוגדרות היקף
איך פועל סוכן ההעשרה
כשמפעילים משימת העשרה – על פי דרישה או לפי לוח זמנים קבוע – מתחילה הפעלת העשרה. סוכן ההעשרה פועל באופן אסינכרוני ברקע, מנתח את נכסי הנתונים, את מעקבי השאילתות ואת התיעוד, ומפיק הצעות מאומתות למטא-נתונים.
התרשים הבא ממחיש את הארכיטקטורה של תהליך העבודה ברמה גבוהה של סוכן העשרה:
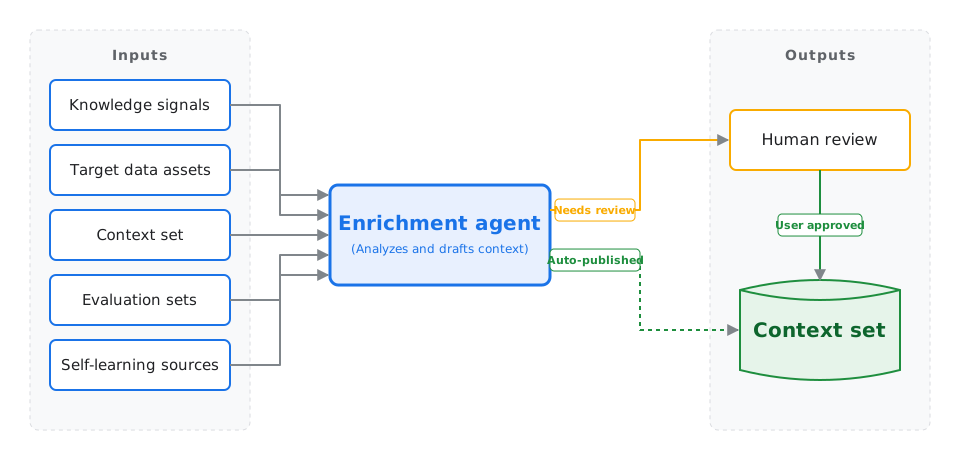
הסוכן אוסף את קבוצת ההקשרים בארבעה שלבים עיקריים:
- ניתוח אותות ותיעוד: הסוכן מחפש ביומני האינטראקציות כדי למצוא את המקומות שבהם סוכני ה-AI במורד הזרם התקשו או נדרשו להפגת עמימות. הוא סורק מסמכים ארגוניים ב-Cloud Storage או באפליקציות מקושרות של צד שלישי, ובודק את היסטוריית השאילתות כדי לגלות צירופי טבלאות בתדירות גבוהה ויחסי תלות במעלה הזרם.
- ניסוח הצעות להקשר: בהתאם ליעד האוצרות, הנציג מנסח הקשר מובנה לנכסי היעד. הם כוללים סקירות כלליות של טבלאות שמתמקדות בעסק, נוסחאות רשמיות של מדדים, תנאי איחוד מאומתים ותבניות של שאילתות SQL שמבוססות על פרמטרים מוזהבים.
- השוואה לאמת מידה ואופטימיזציה: באמצעות שאלות הבדיקה מקבוצת ההערכה, הנציג בודק באופן איטרטיבי את טיוטת המטא-נתונים שלו, ומשפר את התיאורים עד שהדיוק של השאילתות במורד הזרם מגיע למקסימום. לאחר מכן, המערכת מריצה שאילתות בדיקה שהוחזקו בצד כדי לחשב את שיעור השגיאות ברגרסיה. לכל הצעה לתיאור או לכלל של מדד מוקצה ציון מהימנות.
- החלת מדיניות הבדיקה: הצעות שעומדות בסף הסבירות מפעילות את כללי המדיניות. אם הפעלתם פרסום אוטומטי ושיעור השגיאות ברגרסיה הוא בטווח המותר, השינויים ימוזגו באופן אוטומטי. אם שגיאת הרגרסיה חורגת מהסף המותר, הפרסום האוטומטי נפסק מיד, וכל ההצעות נארזות בבקשת שינוי אחת לבדיקה אנושית.
אבטחת מידע ומשילות
משימות ההעשרה של Knowledge Studio משתמשות בבינה מלאכותית כדי לנתח את סכימות הנתונים והתיעוד הפנימי שלכם, ולכן הפלטפורמה מיישמת גבולות מחמירים כדי להגן על המידע הקנייני שלכם.
אימון מודלים בסיסיים: הנתונים שלכם נשארים שלכם. אנחנו אף פעם לא משתמשים בעקבות ביצוע, בסכימות של מסדי נתונים ובאותות ידע שסופקו (כמו מסמכים או מילוני מונחים פנימיים) כדי לאמן את המודלים הבסיסיים של Google.
חיטוי נתונים: לפני שכל מטא-נתונים מוצעים נכתבים בקבוצת הקשר, הנציג מצנזר באופן אוטומטי פרטים אישיים מזהים (PII) מיומני המערכת ומעקבות היצירה.
גבולות הרצה: סוכן ההעשרה פועל בתוך דייר מאובטח בניהול Google. הוא ניגש בצורה מאובטחת למקורות הנתונים הפרטיים באמצעות ממשק Private Service Connect ושרת proxy יוצא בשליטת הלקוח.
סטטוס תאימות: בשלב הנוכחי של גרסת טרום-ההשקה (Preview), משימות העשרה לא תומכות ב-VPC Service Controls (VPC-SC), במפתחות הצפנה בניהול הלקוח (CMEK) או ב-Assured Workloads.
הגדרות מומלצות
ב-Knowledge Catalog יש כמה הגדרות אופציונליות למשימות העשרה. מומלץ להתחיל עם הגדרה בסיסית ולהפעיל בהדרגה תכונות מתקדמות ככל שפעולות המטא-נתונים מתרחבות.
| הגדרות אישיות | רכיבים כלולים | פרסום אוטומטי | למי השיטה מומלצת |
|---|---|---|---|
| Basic | קבוצת הקשרים | מושבת | בדיקת הכלי. מאפשר לראות איך הנציג מסיק מטא-נתונים רק מהסכימה של מערך הנתונים. אתם צריכים לבדוק ידנית את כל ההצעות. |
| מבוסס-עובדות |
|
מושבת | סביבות ייצור. הסוכן מתבסס על הלוגיקה העסקית הספציפית שלכם, ומשתמש בנהלי העבודה הרגילים ובמילוני המונחים שלכם כדי לשפר את הדיוק. |
| אוטומטי |
|
מופעל | הרחבת פעולות של מטא-נתונים. קבוצת ההערכה פועלת כמעקה בטיחות. אם הצעה שנוצרה אוטומטית גורמת לרגרסיה ברמת הדיוק בהמשך, הפרסום נעצר לצורך בדיקה ידנית. |
| למידה עצמית |
|
מופעל | קטלוגים מתקדמים ואוטונומיים. הנציג מנתח אינטראקציות של משתמשים בזמן אמת ויומני צ'אט של נציגים כדי לזהות פערים בידע ולתקן אותם. |
מגבלות וגבולות של גרסת טרום-השקה (Preview)
בגרסת טרום-השקה (Preview), משימות ההעשרה פועלות במסגרת המגבלות הבאות:
ניהול בעיקר באמצעות המסוף: אתם מגדירים ומנהלים משימות רק באמצעות מסוף Google Cloud . בגרסת טרום-השקה (Preview) אי אפשר להשתמש ישירות בממשקי API ציבוריים בארכיטקטורת REST ובפקודות של
gcloudCLI.מכסות ומגבלות: משימות העשרה והרצות של משימות כפופות למכסות של משאבים אזוריים ומכסה לקצב הגשת בקשות לכל פרויקט. מידע נוסף זמין בקטע "משימות העשרה של Knowledge Studio" במאמר מכסות ומגבלות.
מחזור החיים של הפריסה
התהליך של יצירה ופריסה של משימת העשרה כולל את השלבים הבאים:
- הגדרת דרישות מוקדמות: מקצים את התפקידים הנדרשים, מגדירים את חשבונות השירות ומפעילים את יצירת פרופיל הנתונים ואת התובנות מנתונים שמבוססות על AI בטבלאות שנמצאות בשימוש תכוף. מידע נוסף זמין במאמר הגדרת דרישות מוקדמות למשימות העשרה.
- קישור למאגר ידע חיצוני: נותנים למשימה הרשאה לקרוא קבצים מ-Google Drive או ממאגרי Git חיצוניים לצורך ביסוס.
- יצירת המשימה: מגדירים את קבוצת ההקשרים, משאבי היעד, אותות הידע ואסטרטגיית ההערכה.
- בודקים את ההצעות של ה-AI: בודקים את תוצאות הניתוח, עוברים על התיאורים המוצעים ומאשרים את השינויים במטא-נתונים.
המאמרים הבאים
סקירה כללית על קבוצות הקשר
איך המטא-נתונים שנוצרים על ידי משימות העשרה נשמרים בקבוצות הקשר כדי לבסס סוכני AI.
ניהול הפעלות של העשרת נתונים
איך עוקבים אחרי משימות ובודקים או מאשרים באופן ידני הצעות למטא-נתונים.