


Les tâches d'enrichissement sont des agents autonomes de Knowledge Catalog qui aident les intendants des données et les ingénieurs de plate-forme à faire évoluer leurs opérations de métadonnées. Une tâche d'enrichissement analyse en continu les schémas de vos ensembles de données, lit la documentation de votre entreprise et génère des propositions de descriptions pour vos éléments de données. Pour tirer le meilleur parti des tâches d'enrichissement, vous devez connaître les concepts de base de Knowledge Catalog et l'architecture des données de votre organisation.
En automatisant la génération de métadonnées, les tâches d'enrichissement réduisent la charge de travail liée à la curation manuelle tout en garantissant que votre catalogue reflète un contexte précis et spécifique à l'entreprise.
Pourquoi utiliser des tâches d'enrichissement ?
Les tâches d'enrichissement permettent de maintenir l'exactitude et l'actualité des catalogues de données à grande échelle.
| Aspect | Approche conventionnelle | Approche de Knowledge Studio |
|---|---|---|
| Processus | Descriptions manuscrites. Les gestionnaires examinent manuellement des milliers de tables et interrogent des experts du domaine. | Basée sur des agents. Un agent autonome analyse les données et lit les procédures d'exploitation standards. |
| Vitesse et évolutivité | Lenteur et difficulté de maintenance à mesure que les schémas évoluent au fil du temps. | Haute évolutivité. Des propositions de métadonnées de haute qualité sont générées en continu. |
| Effort humain | Élevée. Saisie manuelle de données et maintenance continue importantes. | Faible. Les intendants des données n'ont qu'à examiner et approuver les suggestions générées. |
Cas d'utilisation des tâches d'enrichissement
Les tâches d'enrichissement aident les organisations à résoudre les problèmes de métadonnées courants suivants :
Intégration d'acquisition : une entreprise acquiert une nouvelle unité commerciale avec des milliers d'éléments de données non documentés. Les ingénieurs de données orientent une tâche d'enrichissement vers le nouvel ensemble de données, en utilisant les dictionnaires de données de l'entreprise acquise comme signal de connaissance. L'agent propose des descriptions adaptées à l'entreprise pour l'ensemble de l'ensemble de données en quelques heures au lieu de plusieurs mois.
Documentation continue : une équipe d'ingénierie de plate-forme crée un lakehouse dynamique dont les schémas changent quotidiennement. Il configure une tâche d'enrichissement pour qu'elle s'exécute quotidiennement avec la publication automatique activée, ce qui garantit que le catalogue reflète toujours les dernières modifications de schéma.
Gouvernance sémantique : un bureau de données central souhaite standardiser la terminologie dans tous les services. Ils déploient une tâche d'enrichissement qui fait référence à un glossaire Knowledge Catalog organisé. L'agent signale automatiquement les descriptions de table qui ne respectent pas les termes du glossaire d'entreprise approuvé et propose des remplacements.
Concepts fondamentaux
Lorsque vous configurez une tâche d'enrichissement, vous définissez les composants principaux suivants :
- Tâche d'enrichissement
-
Configuration qui définit ce que l'agent doit faire. Une tâche contient l'ensemble de contextes, les ressources cibles, la planification et les signaux de connaissances que vous fournissez.
Par exemple, une tâche configurée pour demander à l'agent de lire vos dépôts GitHub et d'enrichir votre ensemble de données
financetous les dimanches à minuit. - Job d'enrichissement
- Processus d'orchestration du backend dans Knowledge Studio qui exécute une tâche d'enrichissement.
- Exécution de l'enrichissement
-
Instance d'exécution ponctuelle d'une tâche. La console Knowledge Studio inclut un onglet Jobs qui liste l'historique des exécutions d'une tâche. Vous pouvez ouvrir une exécution spécifique pour examiner les propositions de métadonnées qu'elle a générées.
Par exemple, l'instance d'exécution spécifique qui s'est produite le 24 octobre et qui a entraîné 15 modifications de colonnes proposées.
- Ensemble de contextes
-
Conteneur limité d'éléments de données et de métadonnées cibles. Chaque tâche d'enrichissement doit être configurée pour cibler exactement un ensemble de contextes. L'ensemble de contexte peut contenir des ressources cibles, telles qu'un ensemble de données BigQuery ou un lakehouse, mais vous pouvez également créer un ensemble de contexte vide s'il n'en existe pas.
Par exemple, un ensemble de contextes marketing qui lie logiquement vos tables de campagne, vos métriques de ROAS et vos glossaires de terminologie dans une seule limite de contexte d'IA.
- Signaux de connaissances
- Documents externes qui ancrent l'agent dans la réalité de votre entreprise. En fournissant des buckets Cloud Storage contenant des dictionnaires de données, des glossaires Knowledge Catalog ou des URL de documentation interne, vous vous assurez que l'agent utilise votre logique métier spécifique plutôt que de faire des suppositions génériques.
- Ensembles d'évaluation
-
Questions de test et requêtes SQL correspondantes (fournies au format
.jsonl) utilisées pour évaluer la précision de l'agent. Lorsque l'agent propose de nouvelles métadonnées, il exécute ces questions de test sur les propositions pour s'assurer que la précision ne diminue pas avant la publication.Par exemple, en fournissant une question de test telle que "Quel est notre MRR ?" associée à la requête SQL exacte nécessaire pour calculer le revenu récurrent mensuel. Si l'agent propose des métadonnées confuses qui entraînent l'échec de cette requête de test, la proposition est signalée.
- Sources d'auto-apprentissage
-
Journaux de conversation en direct de vos applications Gemini Enterprise ou de l'analyse des agents BigQuery. L'agent lit ces journaux de chat pour identifier ce que les utilisateurs demandent, découvre les lacunes de connaissances et propose automatiquement de nouvelles métadonnées pour les combler.
Par exemple, si les journaux de chat révèlent que les utilisateurs demandent fréquemment "Que signifie le code d'état 42 ?" et que l'agent ne parvient pas à répondre, l'auto-apprentissage déclenche une proposition de métadonnées pour documenter ce code d'état manquant.
Sources de données et intégrations compatibles pour les tâches d'enrichissement
Les tâches d'enrichissement s'intègrent à la fois à Google Cloud et à des systèmes tiers.
Éléments de données cibles
L'agent d'enrichissement peut enrichir et ajouter directement les éléments de données ciblesGoogle Cloud suivants à vos ensembles de contexte :
Ensembles de données, tables et vues BigQuery
Lacs, zones et éléments Lakehouse
Grâce à l'intégration de Lakehouse, Knowledge Studio permet indirectement d'enrichir les métadonnées de sources tierces associées via des intégrations Iceberg REST Catalog (telles que Databricks Unity, Snowflake Horizon, AWS Glue Data Catalog et SAP Business Data Cloud).
Signaux de connaissances
Lors d'une exécution d'enrichissement, l'agent extrait les règles sémantiques, le contexte métier et les connaissances du domaine des sources en lecture seule suivantes :
Google Cloud :
- Buckets Cloud Storage contenant des formats de fichiers compatibles (tels que des fichiers PDF, CSV, Markdown, de configuration, des ensembles de données et des fichiers texte non structurés)
- Glossaires d'entreprise Knowledge Catalog situés dans le même champ d'application régional
- Applications Google Workspace, y compris les fichiers Google Drive (tels que Documents, Sheets, Slides, PDF, fichiers et documents texte génériques)
Systèmes tiers (non Google Cloud) :
- Fichiers Microsoft SharePoint de moins de 5 Mo (tels que les PDF, les fichiers Office et les documents texte génériques, à l'exclusion des anciens formats ou des images)
- Dépôts GitHub (tout fichier contenant du texte lisible)
- Corps de page Atlassian Confluence
Sources d'auto-apprentissage
Pour identifier les lacunes de connaissances à partir des journaux d'interactions réelles, l'agent d'enrichissement extrait les trajectoires des éléments suivants :
- Applications Gemini Enterprise
- Tables BigQuery Agent Analytics
- Cloud Logging à l'aide de vues de journaux limitées
Fonctionnement de l'agent d'enrichissement
Lorsque vous déclenchez une tâche d'enrichissement, à la demande ou de manière récurrente, une exécution d'enrichissement est lancée. L'agent d'enrichissement s'exécute de manière asynchrone en arrière-plan, en analysant vos éléments de données, vos traces de requêtes et votre documentation pour produire des propositions de métadonnées vérifiées.
Le schéma suivant illustre l'architecture générale du workflow d'un agent d'enrichissement :
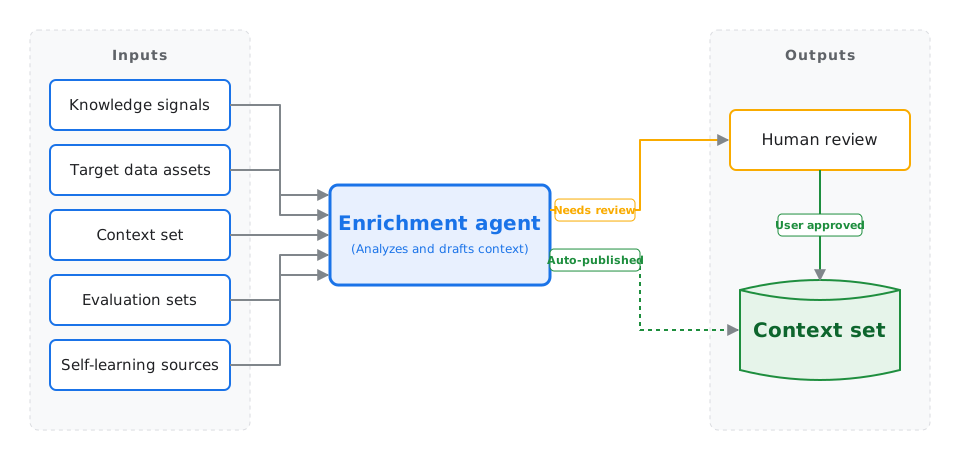
L'agent organise votre ensemble de contexte en quatre phases clés :
- Analyse des signaux et de la documentation : l'agent explore les journaux d'interaction pour identifier les points de blocage des agents IA en aval ou les cas où une désambiguïsation était nécessaire. Il analyse les documents d'entreprise dans Cloud Storage ou les applications tierces associées, et examine l'historique des requêtes pour découvrir les jointures de table à haute fréquence et les dépendances en amont.
- Rédiger des propositions de contexte : guidé par votre objectif de curation, l'agent rédige un contexte structuré pour vos éléments cibles. Cela inclut des présentations de tables orientées métier, des formules de métriques formelles, des conditions de jointure validées et des modèles de requêtes SQL basés sur des paramètres de référence.
- Benchmarking et optimisation : à l'aide des questions de test de votre ensemble d'évaluation, l'agent teste de manière itérative ses propres métadonnées, en affinant les descriptions jusqu'à ce que la précision des requêtes en aval soit maximisée. Il exécute ensuite des requêtes de test d'exclusion pour calculer un taux d'erreur de régression. Un score de confiance est attribué à chaque description ou règle de métrique proposée.
- Application des règles d'examen : les propositions qui atteignent le seuil de confiance déclenchent vos règles. Si vous avez activé la publication automatique et que le taux d'erreur de régression se situe dans la limite autorisée, les modifications sont fusionnées automatiquement. Si l'erreur de régression dépasse le seuil autorisé, la publication automatique est immédiatement arrêtée et toutes les propositions sont regroupées dans une seule demande de modification pour examen manuel.
Sécurité et gouvernance des données
Étant donné que les tâches d'enrichissement de Knowledge Studio utilisent l'intelligence artificielle pour analyser vos schémas de données et votre documentation interne, la plate-forme met en œuvre des limites strictes pour protéger vos informations propriétaires.
Entraînement des modèles de fondation : vos données restent les vôtres. Les traces d'exécution, les schémas de base de données et les signaux de connaissances fournis par le client (tels que des documents ou des glossaires internes) ne sont jamais utilisés pour entraîner les modèles de fondation de Google.
Nettoyage des données : avant que les métadonnées proposées ne soient écrites dans un ensemble de contexte, l'agent masque automatiquement les informations permettant d'identifier personnellement l'utilisateur dans les journaux système et les traces de génération.
Limites d'exécution : l'agent d'enrichissement fonctionne dans un locataire sécurisé géré par Google. Il accède de manière sécurisée à vos sources de données privées à l'aide d'une interface Private Service Connect et d'un proxy de sortie contrôlé par le client.
État de conformité : pendant la phase de preview actuelle, les tâches d'enrichissement ne sont pas compatibles avec VPC Service Controls (VPC-SC), les clés de chiffrement gérées par le client (CMEK) ni Assured Workloads.
Configurations recommandées
Knowledge Catalog fournit plusieurs paramètres facultatifs pour les tâches d'enrichissement. Nous vous recommandons de commencer par une configuration de base et d'activer progressivement les fonctionnalités avancées à mesure que vous faites évoluer vos opérations de métadonnées.
| Configuration | Composants inclus | Publication automatique | Recommandations |
|---|---|---|---|
| Basic | Ensemble de contextes | Désactivé | Tester l'outil. Vous permet de voir comment l'agent déduit les métadonnées strictement à partir du schéma de votre ensemble de données. Vous devez examiner manuellement toutes les propositions. |
| Grounded |
|
Désactivé | Environnements de production. Ancre l'agent dans votre logique métier spécifique, en utilisant vos procédures opérationnelles standards et vos glossaires pour améliorer la précision. |
| Automatique |
|
Activé | Scaling des opérations de métadonnées. L'ensemble d'évaluation agit comme un garde-fou. Si une proposition générée automatiquement entraîne une régression de la précision en aval, la publication est interrompue pour un examen manuel. |
| Auto-apprentissage |
|
Activé | Catalogues avancés et autonomes. L'agent s'adapte en permanence en analysant les interactions des utilisateurs en direct et les journaux de chat des agents pour identifier et combler les lacunes de connaissances. |
Limites et limites de l'aperçu
Pendant la phase Preview, les tâches d'enrichissement fonctionnent dans les limites suivantes :
Gestion axée sur la console : vous configurez et gérez les tâches exclusivement via la console Google Cloud . Les API REST publiques directes et les commandes de la CLI
gcloudne sont pas disponibles en version preview.Quotas et limites : les tâches d'enrichissement et les exécutions de tâches sont soumises à des quotas de ressources et de débit régionaux par projet. Pour en savoir plus, consultez la section "Tâches d'enrichissement Knowledge Studio" de la page Quotas et limites.
Cycle de vie du déploiement
Le processus de création et de déploiement d'une tâche d'enrichissement suit un cycle de vie linéaire :
- Configurer les conditions préalables : accordez les rôles requis, configurez les comptes de service et activez le profilage des données et les insights sur les données d'IA sur les tables fréquemment utilisées. Pour en savoir plus, consultez Configurer les conditions préalables pour les tâches d'enrichissement.
- Associer des connaissances externes : autorisez la tâche à lire des fichiers depuis votre Google Drive ou des dépôts Git externes pour l'ancrage.
- Créer la tâche : définissez l'ensemble de contextes, les ressources cibles, les signaux de connaissances et la stratégie d'évaluation.
- Examinez les propositions de l'IA : vérifiez les diagnostics d'exécution, examinez les descriptions proposées et approuvez les modifications des métadonnées.
Étapes suivantes
Présentation de Knowledge Studio
Découvrez les concepts fondamentaux et l'architecture de Knowledge Studio.
Présentation des ensembles de contextes
Découvrez comment les métadonnées générées par les tâches d'enrichissement sont stockées dans des ensembles de contexte pour ancrer les agents IA.
Configurer les conditions préalables à l'enrichissement
Découvrez comment configurer les rôles et les comptes de service pour exécuter des tâches d'enrichissement.
Créer des tâches d'enrichissement
Découvrez comment générer des métadonnées en exécutant des tâches d'enrichissement automatisées.
Gérer les exécutions d'enrichissement
Découvrez comment surveiller les jobs, et examiner ou approuver manuellement les propositions de métadonnées.
Gérer les tâches d'enrichissement
Découvrez comment modifier, suspendre et supprimer des jobs d'enrichissement planifiés.