


Los conectores obtienen datos de fuentes de datos de Google y de terceros y los llevan a Gemini Enterprise, donde se guardan en almacenes de datos dedicados. En este documento, se proporciona una descripción general de estos conectores. Centralizar tus datos en Gemini Enterprise mejora la accesibilidad de los datos, la funcionalidad de búsqueda y las capacidades analíticas.
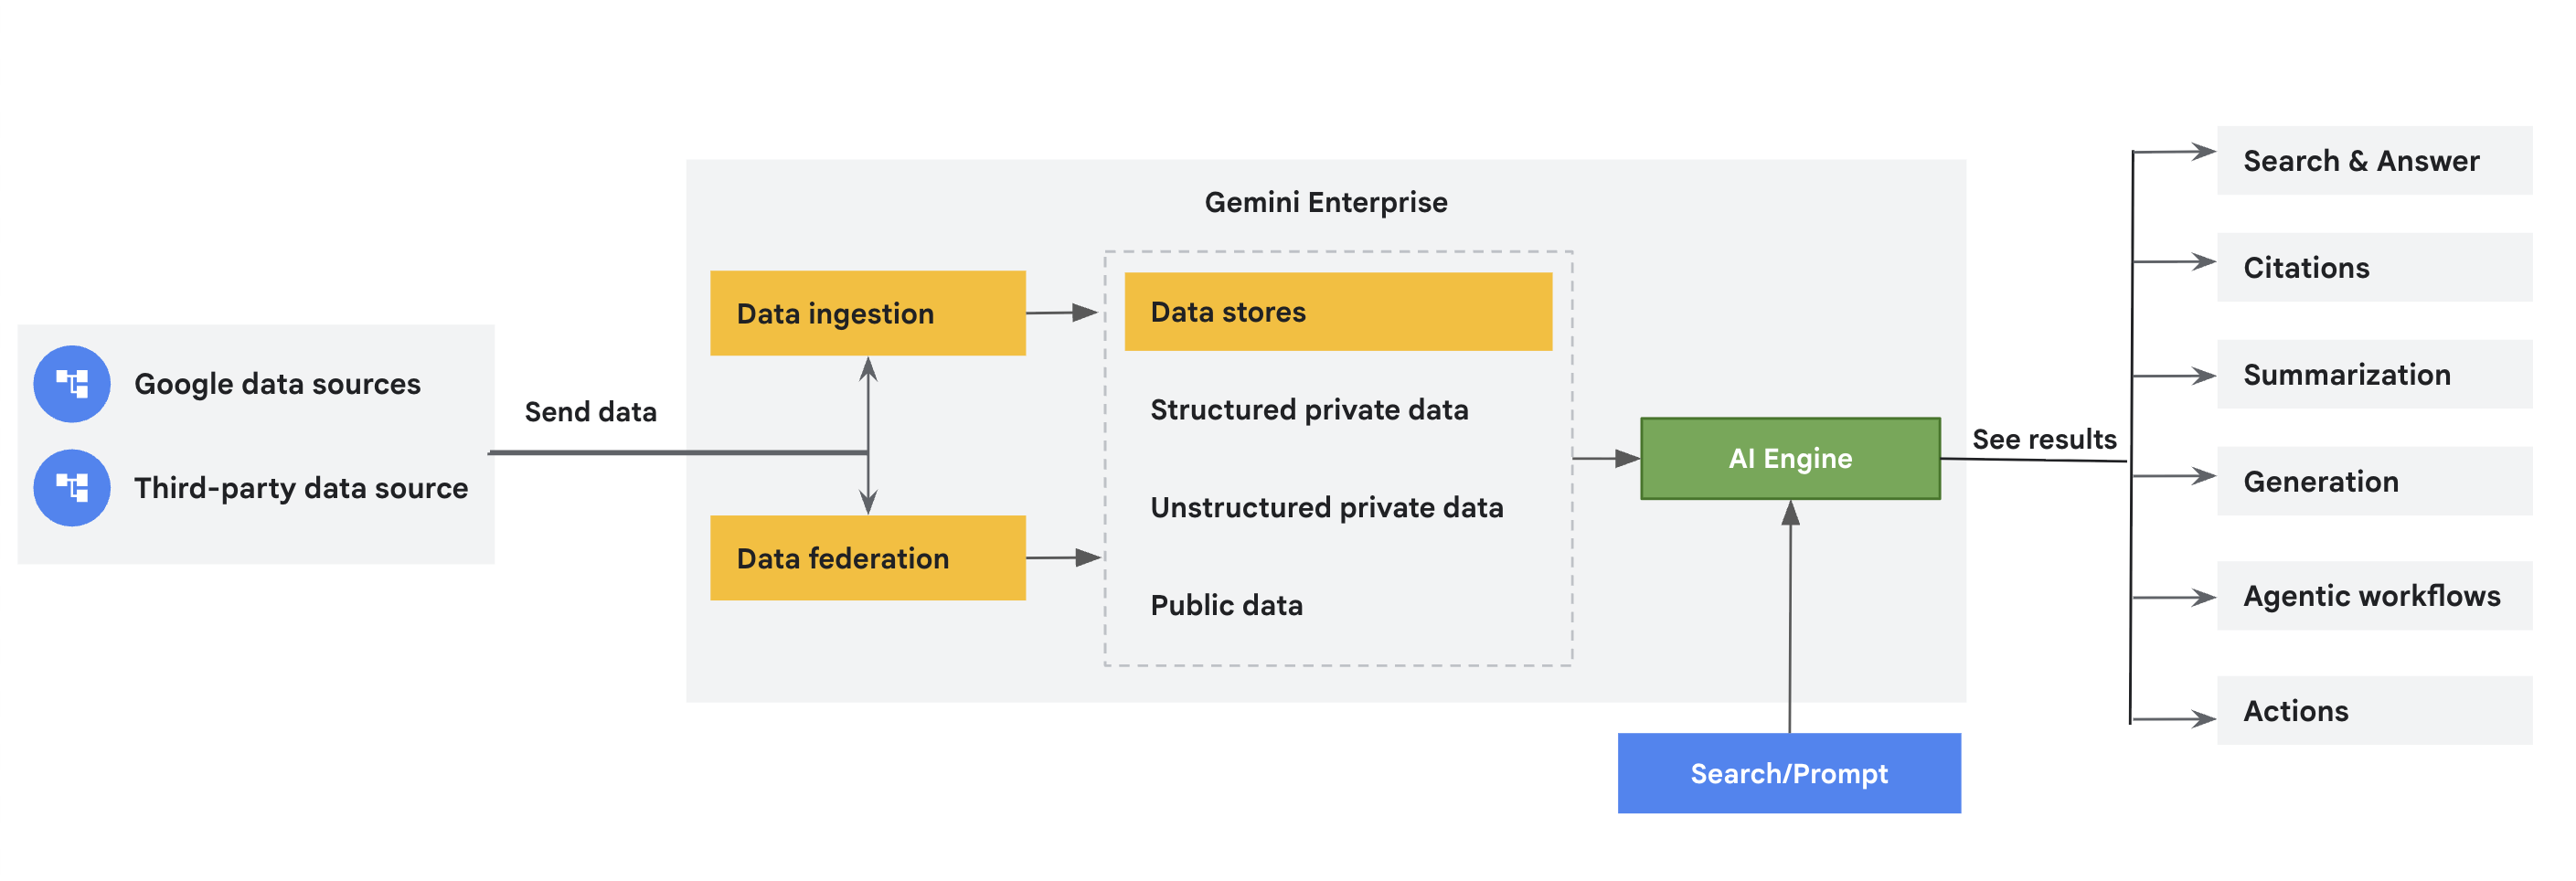
Conceptos de conectores y almacén de datos
Almacenes de datos |
| Cada fuente de datos admite un conjunto de tipos de entidades. Por ejemplo, Jira Cloud tiene entidades, como problemas, archivos adjuntos, comentarios y registros de trabajo, que son únicos para la fuente de datos. Gemini Enterprise crea un almacén de datos independiente para cada entidad. Por lo tanto, cuando creas un almacén de datos con la consola de Google Cloud , obtienes una colección de almacenes de datos que representan estas entidades de datos transferidas. |
Federación de datos frente a transferencia (indexación) |
| La federación de datos recupera directamente
información de la fuente de datos especificada. Como los datos no se copian en el índice de Gemini Enterprise, no tienes que preocuparte por el almacenamiento de datos. Sin embargo, como los datos no están indexados, la calidad de la búsqueda podría ser
menor. La transferencia de datos (indexación) copia los datos en el índice de Gemini Enterprise. Esto puede mejorar la calidad de la búsqueda. Sin embargo, este proceso consume más almacenamiento y tiempo. Si el conector admite tanto la federación como la ingesta de datos, selecciona el método de conexión de datos que prefieras. |
Datos no estructurados |
| El formato de datos admitido es específico de la fuente de datos y el tipo de entidad. Si el contenido de una entidad se almacena en un formato no estructurado, como PDF, HTML, DOCX, PPTX, XLSX y XLSM, Gemini Enterprise crea un almacén de datos no estructurados. Para obtener más información y conocer los tipos de archivos compatibles, consulta Búsqueda no estructurada. |
Datos estructurados |
| El formato de datos admitido es específico de la fuente de datos y el tipo de entidad. Si el contenido de una entidad se almacena en un formato estructurado, Gemini Enterprise crea un almacén de datos estructurados. Para obtener más información, consulta Búsqueda estructurada. |
Esquemas de datos |
| El esquema de datos define la estructura de los datos. Cuando importas datos estructurados con Gemini Enterprise, el sistema detecta automáticamente el esquema. Puedes usar el esquema detectado automáticamente o definirlo con la API. Para obtener más información, consulta Proporciona o detecta automáticamente un esquema. |
Regiones de almacenes de datos |
| Cuando transfieres datos, debes seleccionar la región en la que deseas almacenarlos, como global, EE.UU. o la UE. Para obtener más información, consulta Compromisos de residencia de datos y procesamiento regional de AA. Los datos almacenados en las regiones de EE.UU. o la UE requieren encriptación de datos. La encriptación predeterminada se realiza con Google-owned and Google-managed encryption key, pero, como alternativa, puedes usar claves de encriptación administradas por el cliente. |
Sincronizaciones de datos |
Una sincronización de datos extrae y actualiza los datos de identidad (como roles, permisos y usuarios) y los datos de entidad (como los datos relacionados con una fuente de datos específica) de la fuente de datos original. Para obtener más información, consulta Tipos y programas de sincronización de datos. |
Tipos y programas de sincronización de datos
Una sincronización de datos captura datos de entidades, datos de identidad o ambos, y actualiza el contenido del almacén de datos en Gemini Enterprise.
Tipos de sincronización
Los almacenes de datos de Gemini Enterprise usan dos tipos esenciales de sincronización de datos:
Una sincronización completa captura todo el estado de la app o el servicio de terceros. Esto incluye las adiciones, actualizaciones y eliminaciones. Una sincronización completa reemplaza el contenido existente del almacén de datos.
Una sincronización incremental captura periódicamente los datos de las entidades que se agregaron o actualizaron desde la última sincronización. No sincroniza los datos de identidad ni las eliminaciones de datos de entidad.
Puedes programar una sincronización completa por separado para los siguientes tipos de datos:
Una sincronización de entidades captura datos específicos de la fuente de datos de terceros. Por ejemplo, un almacén de datos para un sistema como Jira puede sincronizar problemas, registros de trabajo, comentarios y archivos adjuntos. Las sincronizaciones de entidades no incluyen información de identidad.
Una sincronización de identidad captura datos sobre las cuentas de usuario asociadas con un grupo de ACL.
Interacción entre la sincronización de identidades y la sincronización completa
Para comprender cómo funciona una ejecución de sincronización de identidades individual con una ejecución de sincronización completa,
considera un ejemplo que incluya dos páginas: page_1, vinculada a un grupo de ACL
group_1, y page_2, vinculada a un grupo de ACL group_2.
Se ejecuta una sincronización de identidad inicial y se recupera información sobre los grupos
group_1ygroup_2.Supón que
group_1contiene al usuariouser_1.Supón que
group_2contiene al usuariouser_2.
Esta sincronización de identidades establece la siguiente asignación:
user_1se asigna agroup_1.user_2se asigna agroup_2.
Junto con la sincronización de identidades, se ejecuta una sincronización completa, que recupera
page_1ypage_2.Esta sincronización completa establece la siguiente asignación:
user_1tiene acceso apage_1(a través degroup_1).user_2tiene acceso apage_2(a través degroup_2).
Sincronizar programas
Para cada almacén de datos, puedes seleccionar una frecuencia para los diferentes tipos de sincronización:
Las sincronizaciones completas de todos los datos de identidad y de entidad se pueden programar simultáneamente cada 3 horas, 6 horas, 12 horas, 1 día o 3 días.
Las sincronizaciones completas independientes de todos los datos de identidad y las sincronizaciones completas independientes de todos los datos de entidad se pueden programar por separado con cualquiera de las siguientes frecuencias de sincronización personalizadas:
Datos de entidad: cada 3 horas, 6 horas, 12 horas, 1 día, 3 días, 5 días y cada 7 días.
Datos de identidad: Cada 30 minutos, 1 hora, 3 horas, 6 horas, 12 horas, 1 día, 3 días, 5 días y cada 7 días.
Las sincronizaciones incrementales de los datos de entidades actualizados o agregados se pueden programar para cada 3 horas, 6 horas, 12 horas, 1 día, 3 días, 5 días o cada 7 días. De forma predeterminada, se realiza una sincronización incremental cada 3 horas.
Recomendaciones de frecuencia
Elige una frecuencia de sincronización de datos que se alinee con el volumen de registros recuperados y las consultas por segundo (QPS) recomendadas.
En la siguiente tabla, se muestra la cantidad típica de registros recuperados para las sincronizaciones de uno, tres, cinco y siete días. La cantidad real de registros puede variar según la fuente de datos y su configuración.
| QPS | Registra el volumen para la sincronización de 1 día | Volumen de registros para la sincronización de 3 días | Registra el volumen para la sincronización de 5 días | Volumen de registros para la sincronización de 7 días |
|---|---|---|---|---|
| 5 | 432,000 | 1.296M | 2.16M | 3 millones |
| 10 | 864,000 | 2.592M | 4.32 millones | 6 millones |
| 20 | 1.7 millones | 5.1 millones | 8.5 millones | 11.9 millones |
| 50 | 4.3 M | 12.9 millones | 21.5 millones | 30.1M |
| 100 | 8.6 millones | 25.8M | 43 M | 60.2 millones |
Cómo pausar y reanudar las sincronizaciones
Puedes pausar y reanudar tanto las sincronizaciones completas como las incrementales:
Cuando detienes un tipo de sincronización, el almacén de datos cancela las sincronizaciones en curso de ese tipo y deja de programar sincronizaciones nuevas de ese tipo.
Cuando reanudas un tipo de sincronización, el almacén de datos programa la nueva sincronización según la última hora de sincronización programada, pero no continúa la sincronización interrumpida anteriormente.
Por ejemplo, si pausas la sincronización completa mientras se está realizando, el almacén de datos cancela esa sincronización. Si más adelante reanudas la sincronización completa, el almacén de datos programa automáticamente una nueva sincronización completa según el programa de sincronización completa.
Fuentes de datos de Google
Puedes conectarte a fuentes de datos de Google, como BigQuery, Spanner y Google Drive.
Lista de tareas para las fuentes de datos de Google
Antes de enviar datos a Gemini Enterprise, revisa la siguiente lista de tareas:
Configura el control de acceso para tu fuente de datos. Para obtener más información, consulta Identidad y permisos.
Decide si los datos deben federarse o transferirse (indexarse).
Decide con qué frecuencia se deben sincronizar los datos.
Si usas claves de encriptación administradas por el cliente (CMEK), crea claves multirregionales. Para obtener más información, consulta Registra claves de una sola región para fuentes de datos de terceros.
Si tienes información de identificación personal (IIP) y quieres usar la función de autocompletar para las sugerencias de consultas, consulta cómo protegerte contra las filtraciones de IIP.
Fuentes de datos de Google compatibles
| Google Drive | Gmail | Calendario de Google | Búsqueda de personas |
|
|
|
|
Fuentes de datos de terceros
Los almacenes de datos de terceros transfieren datos de aplicaciones de terceros a Gemini Enterprise.
Lista de tareas para fuentes de datos de terceros
Antes de conectar una fuente de datos de terceros a Gemini Enterprise, revisa la siguiente lista de tareas:
Se deben configurar permisos y permisos específicos para ciertas fuentes de datos. Un administrador de la aplicación de terceros debe revisar las credenciales necesarias para conectar una fuente de datos y configurar la autenticación y los permisos. Para obtener información sobre los permisos y los permisos específicos, consulta la documentación de la fuente de datos de terceros correspondiente.
Configura el control de acceso para tu almacén de datos. Para obtener más información, consulta Identidad y permisos.
Decide si los datos deben federarse o transferirse (indexarse).
Si se transfieren datos, asegúrate de que los recursos no estén restringidos para la credencial de usuario que usas para transferir datos a la fuente de datos.
Decide con qué frecuencia se deben sincronizar los datos.
Si usas claves de encriptación administradas por el cliente (CMEK), crea claves multirregionales y de una sola región. Para obtener más información, consulta Registra claves de una sola región para almacenes de datos de terceros.
Si tienes información de identificación personal (IIP) y quieres usar la función de autocompletar para las sugerencias de consultas, consulta cómo protegerte contra las filtraciones de IIP.
Si deseas que el tráfico saliente del almacén de datos se origine en un conjunto fijo de direcciones IP (por ejemplo, para incluirlas en la lista de entidades permitidas en el sistema de origen) y si el almacén de datos lo admite, consulta Configura la salida de IP estática.
Fuentes de datos de terceros compatibles
| Microsoft Entra ID | Microsoft OneDrive | Microsoft Outlook | Microsoft SharePoint |

|

|

|

|
| Jira Cloud | Confluence Cloud | ServiceNow | |

|

|

|