


En este documento, se describe cómo crear y optimizar los conjuntos de información contextual que ayudan a lograr una alta precisión de las consultas de QueryData en tus aplicaciones de agentes de datos. El agente de ingeniería de contexto te ayuda a compilar, evaluar y mejorar los conjuntos de información contextual mediante la automatización de su creación y optimización.
Para obtener información sobre los conjuntos de información contextual y QueryData, consulta Descripción general de los conjuntos de información contextual y Descripción general de QueryData.Para compilar aplicaciones de datos de nivel empresarial, la precisión del modelo de texto a consulta suele necesitar alcanzar una calidad cercana al 100%. El SQL generado de forma incorrecta afecta la usabilidad general de la aplicación y la experiencia del usuario. Para obtener respuestas explicables y relevantes para la empresa con alta precisión, se requiere ingeniería de contexto, que es el proceso de crear y optimizar de forma iterativa el contexto para lograr una precisión óptima.
Si proporcionas a QueryData el contexto segmentado para tu aplicación empresarial, le proporcionas las reglas comerciales precisas que el sistema necesita para resolver la intención matizada del usuario.
Agente de ingeniería de contexto
El agente de ingeniería de contexto automatiza este flujo de trabajo de optimización. Puedes conversar con el agente para controlar tareas ad hoc y optimizar tu contexto. En la siguiente lista, se proporcionan ejemplos de instrucciones en lenguaje natural que puedes usar para indicarle al agente qué hacer, junto con una descripción de cómo responde el agente. Usa estos ejemplos para ayudarte a compilar y optimizar tu contexto:
- Ejemplo de instrucción para el análisis de fallas: "Update context so that we correctly identify the airport for queries like 'disney world flights'." El agente analiza la falla, razona sobre la brecha y recomienda agregar un elemento de contexto adecuado, como una consulta de búsqueda de valores.
- Ejemplo de instrucción para sugerencias contextuales: "Read my app code and suggest some context to add." El agente analiza el código, razona sobre el dominio de tu aplicación y sugiere qué elementos de contexto serían relevantes.
- Ejemplo de instrucción para el procesamiento masivo: "Aquí hay 10 ejemplos de preguntas y consultas en SQL. Turn them into templates." El agente procesa tus entradas de forma masiva y actualiza tu conjunto de información contextual.
Importancia del conjunto de datos de referencia
Para optimizar tu contexto, primero debes crear un conjunto de datos que coincida con las entradas de lenguaje natural de tu aplicación. El agente puede ayudarte a compilar este conjunto de datos de referencia, que consta de preguntas de los usuarios y sus consultas de base de datos esperadas. Un conjunto de datos de referencia te permite hacer lo siguiente:
- Establecer una base de referencia para el rendimiento de las consultas
- Validar las actualizaciones con las consultas de base de datos de verdad fundamental
- Medir las mejoras de precisión en las iteraciones
El proceso sistemático de ascenso de colinas
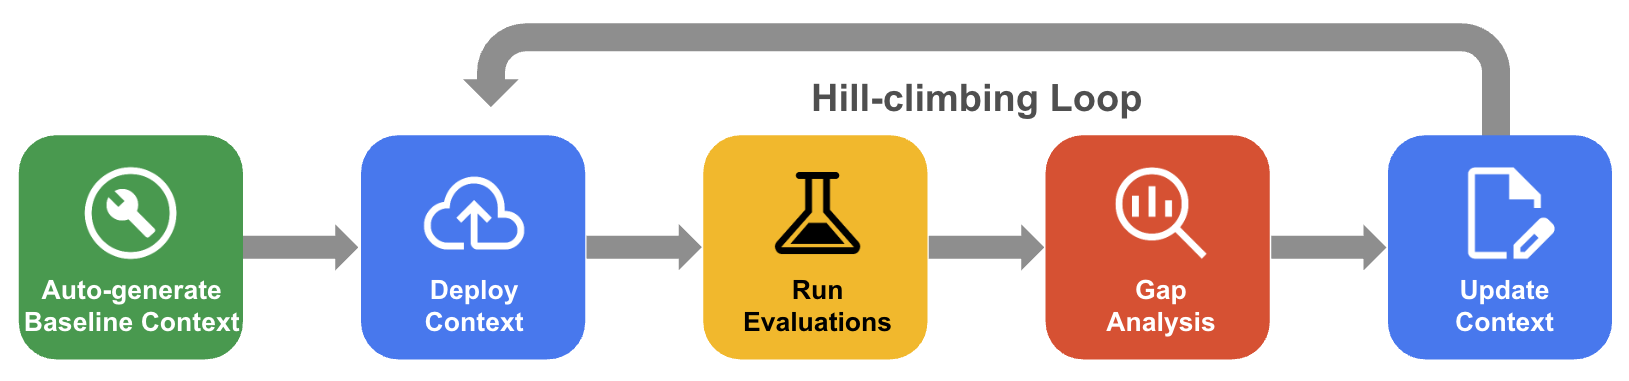
En el ascenso sistemático de colinas, el agente mejora de forma iterativa un conjunto de información contextual mediante la evaluación del conjunto de datos de referencia, el análisis de brechas y las actualizaciones para impulsar la precisión hacia un valor cercano al 100%.
- Generar de forma automática el contexto de referencia: Crea un conjunto de información contextual inicial derivado del esquema de tu base de datos y los artefactos de la aplicación.
- Flujo de trabajo de optimización de ascenso de colinas: Permite que el agente evalúe la precisión de QueryData, realice un análisis de brechas en las fallas y proponga automáticamente mejoras para aumentar la precisión.
En el siguiente diagrama, se muestra el flujo de trabajo sistemático de ascenso de colinas:
Antes de comenzar
Completa los siguientes requisitos previos antes de usar el agente de ingeniería de contexto.
Habilita los servicios obligatorios
Habilita los siguientes servicios para tu proyecto:Prepara una instancia de Spanner
- Asegúrate de que haya una instancia de Spanner disponible. Para obtener más información, consulta Crea una instancia.
- Asegúrate de crear una base de datos en tu instancia en la que crearás las tablas. Para obtener más información, consulta Crea una base de datos en la instancia de Spanner.
En este instructivo, se requiere que tengas una base de datos en tu instancia de Spanner. Para obtener más información, consulta Crea una base de datos.
Roles y permisos requeridos
- Agrega un usuario o una cuenta de servicio de IAM al clúster. Para obtener más información, consulta Aplica roles de IAM.
- Otorga los roles
spanner.databaseReaderygeminidataanalytics.queryDataUseral usuario de IAM a nivel de proyecto. Para obtener más información, consulta Agrega una vinculación de política de IAM para un proyecto. - Para crear, subir y administrar conjuntos de información contextual, otorga el rol de Editor de Dataplex Catalog (
roles/dataplex.catalogEditor) o Administrador de Dataplex Catalog (roles/dataplex.catalogAdmin) al usuario de IAM a nivel de proyecto. Para obtener más información, consulta Permisos de conjuntos de información contextual. - Otorga roles y permisos al usuario de IAM a nivel de proyecto para las bases de datos requeridas.
Prepara el entorno
Puedes compilar archivos de conjuntos de información contextual desde cualquier entorno de desarrollo local o IDE. Para preparar tu entorno, completa los siguientes pasos:
- Instala el agente de ingeniería de contexto.
- Configura la conexión de la base de datos.
Instala el agente de ingeniería de contexto
El agente de ingeniería de contexto ejecuta el servidor del Protocolo de contexto del modelo (MCP) que requiere uv para administrar los paquetes subyacentes de Python.
Para instalar
uv, sigue las instrucciones que se indican en Instalauv.Verifica que
uvesté instalado y que se pueda acceder a él desde la línea de comandos:uv --version
Para preparar tu entorno, instala el agente de ingeniería de contexto en el arnés de agente seleccionado, como la CLI de Antigravity, Claude Code o la CLI de Gemini.
Según el arnés de agente seleccionado, sigue los pasos de instalación correspondientes:
CLI de Antigravity
Para instalar el agente de ingeniería de contexto en la CLI de Antigravity, sigue estos pasos:
- Instala la CLI de Antigravity. Consulta Comienza a usar la CLI de Antigravity.
- Instala el complemento del agente de ingeniería de contexto, que incluye flujos de trabajo para la generación de contexto:
agy plugin install https://github.com/GoogleCloudPlatform/db-context-enrichment/tree/main/plugin
- Inicia la CLI de Antigravity:
agy
Para actualizar el complemento a la versión más reciente, haz lo siguiente:
agy plugin uninstall google-cloud-db-context-engineering
agy plugin install https://github.com/GoogleCloudPlatform/db-context-enrichment/tree/main/plugin
Claude Code
Para instalar el agente de ingeniería de contexto en Claude Code, sigue estos pasos:
- Agrega el marketplace de complementos:
/plugin marketplace add https://github.com/GoogleCloudPlatform/db-context-enrichment.git
- Instala el complemento:
/plugin install db-context-engineering@db-context-enrichment-marketplace
- Vuelve a cargar los complementos para activar los cambios:
/reload-plugins
- Actualiza el complemento:
/plugin update db-context-engineering@db-context-enrichment-marketplace
CLI de Gemini (obsoleta)
Para instalar el agente de ingeniería de contexto en la CLI de Gemini, sigue estos pasos:
- Instala la CLI de Gemini. Consulta Comienza a usar la CLI de Gemini.
- Instala la extensión:
gemini extensions install https://github.com/GoogleCloudPlatform/db-context-enrichment
- Actualiza la extensión:
gemini extensions update mcp-db-context-enrichment
Configura la conexión de la base de datos
El agente requiere una conexión de base de datos para recuperar esquemas y la capacidad de validar la sintaxis del contexto de SQL generado. Para permitir que el agente interactúe con tu base de datos, configura las credenciales de autenticación y define la configuración de conexión de la base de datos.
Configura las credenciales predeterminadas de la aplicación
Configura las credenciales predeterminadas de la aplicación (ADC) para proporcionar credenciales de usuario para acceder a los Google Cloud recursos del agente de ingeniería de contexto:
- Servidor de MCP de Toolbox: Usa credenciales para conectarse a tu base de datos, recuperar esquemas y ejecutar SQL para la validación.
- Evalbench: Usa credenciales para invocar QueryData para la evaluación.
Ejecuta los siguientes comandos en tu terminal para autenticarte:
gcloud auth application-default loginConfigura el archivo de conexión de la base de datos
El agente requiere una conexión de base de datos para la generación de contexto, que el MCP Toolbox admite y define en un archivo de configuración.
El archivo de configuración especifica la fuente de la base de datos y las herramientas necesarias para recuperar esquemas o ejecutar SQL. El agente de ingeniería de contexto incluye Agent Skills preinstaladas para ayudarte a generar la configuración.
Inicia el entorno del agente.
Pídele al agente que te ayude a configurar la conexión de la base de datos. Por ejemplo, ingresa la instrucción "help me set up the database connection". Sigue las instrucciones del agente para crear el archivo de configuración en tu directorio de trabajo actual como
autoctx/tools.yaml.Para aplicar la nueva configuración de
tools.yaml, vuelve a cargar tu conexión:- En la CLI de Antigravity, ejecuta
/mcpy seleccionatoolboxpara reiniciar. - En la CLI de Gemini, ejecuta
/mcp reload. - En Claude Code, ejecuta
/mcp, seleccionatoolboxy, luego,Reconnect.
- En la CLI de Antigravity, ejecuta
Para obtener más información sobre cómo configurar manualmente el archivo de configuración de la base de datos, consulta Configuración de MCP Toolbox.
Genera y optimiza el contexto
El agente de ingeniería de contexto proporciona un conjunto de Agent Skills y herramientas de MCP para mejorar la capacidad de ingeniería de contexto de tu agente de codificación. Puedes usar estas herramientas en conjunto para generar una base de referencia, medir la efectividad y aplicar mejoras de forma iterativa. Sin embargo, puedes comenzar en cualquier etapa del flujo de trabajo:
- Si ya tienes un conjunto de información contextual, puedes continuar directamente con la evaluación.
- Si tienes consultas con errores que deseas corregir, puedes continuar directamente con el análisis de brechas.
Cada capacidad describe las acciones, los casos de uso y los comandos de invocación del agente.
Las instrucciones de ejemplo muestran cómo puedes consultar al agente en lenguaje natural. Si el agente requiere detalles adicionales para completar una solicitud, te pedirá una aclaración.
Compila y expande conjuntos de datos de evaluación
Para mejorar el rendimiento, primero debes medirlo. La ingeniería de contexto sin un conjunto de datos de referencia, que consta de preguntas de los usuarios combinadas con su SQL esperado, carece de verificación sistemática. Con un conjunto de datos de referencia, cada cambio es una mejora medible que puedes validar con la verdad fundamental.
Crear un conjunto de datos de referencia representativo de forma manual lleva mucho tiempo, y los conjuntos de datos pequeños pueden omitir variaciones en la fraseología del usuario. El agente resuelve esto de la siguiente manera:
- Genera pares de pregunta y SQL candidatos en función del esquema de tu base de datos.
- Expande un pequeño conjunto de datos inicial con variaciones de filtros, sinónimos y reformulaciones.
De manera opcional, puedes permitir que el agente ejecute el SQL generado en tu base de datos. Esta verificación confirma que las consultas se ejecutan correctamente antes de agregarlas al conjunto de datos.
El conjunto de datos es un archivo JSON que contiene pares de pregunta y SQL:
[
  {
    "id": "example_001",
    "nlq": "What is the total revenue for the top 5 products?",
    "golden_sql": "SELECT product_id, sum(net_revenue) FROM sales GROUP BY product_id ORDER BY sum(net_revenue) DESC LIMIT 5;"
  }
]
Los pares aprobados propagan el archivo autoctx/golden.json en tu espacio de trabajo, donde están listos para la evaluación. Puedes proporcionar un archivo existente o escribir algunos ejemplos de evaluación intercalados para que el agente los expanda.
Puedes usar las siguientes instrucciones de ejemplo para indicarle al agente qué hacer:
- "Generate an evaluation dataset from my schema."
- "Here's a seed question and SQL. Expand it into a broader dataset and verify the queries run."
Genera un conjunto de información contextual de referencia
Para evitar crear contexto desde cero, puedes permitir que el agente derive un conjunto de información contextual inicial del esquema de tu base de datos y los artefactos de la aplicación, como reglas comerciales, consultas de muestra o archivos README. Aunque este contexto de referencia no es definitivo, proporciona un punto de partida validado basado en tu modelo de base de datos.
Puedes usar las siguientes instrucciones de ejemplo para indicarle al agente qué hacer:
- "Generate a context set from my schema."
- "Generate initial context using these schemas and the business rules in
requirements.md."
El agente te pedirá que le asignes un nombre al experimento, que organiza los artefactos generados, y es posible que te pida que acotes el alcance si el esquema de tu base de datos es grande. Para subir el contexto con Spanner Studio, sigue las instrucciones después de que el agente genere el archivo JSON.
Evalúa la efectividad del contexto
Después de establecer un conjunto de información contextual y un conjunto de datos de referencia, puedes permitir que el agente mida el rendimiento del contexto consultando la API de QueryData de tu agente de datos con cada pregunta de referencia. El agente compara el SQL generado y sus resultados de ejecución con la respuesta esperada usando Evalbench para controlar la comparación.
La ejecución de una evaluación proporciona lo siguiente:
- Métricas cuantitativas, como resultados de aprobación y reprobación, y puntuaciones agregadas, para hacer un seguimiento del progreso en las iteraciones de contexto
- Un resumen de conversación intercalado y informes CSV detallados escritos en el directorio
eval_reports/de tu carpeta de experimento
Para iniciar una evaluación, proporciona la ruta de acceso del conjunto de datos de referencia y el ID del conjunto de información contextual. Para obtener información sobre cómo encontrar el ID del conjunto de información contextual, consulta Encuentra el ID del contexto del agente .
Puedes usar las siguientes instrucciones de ejemplo para indicarle al agente qué hacer:
- "Evaluate my context against
golden.json." - "Re-run the evaluation using the config from my last experiment."
Para volver a ejecutar una configuración de evaluación generada anteriormente sin volver a configurarla, pídele al agente que lo haga o invoca la CLI directamente:
uvx google-evalbench --run_config=autoctx/experiments/my-experiment/eval_configs/run_config.jsonPara obtener detalles sobre el esquema de configuración de la evaluación y cómo personalizar las ejecuciones de evaluación, consulta la documentación de Evalbench.
Realiza un análisis de brechas y propone mejoras
Para resolver las fallas de las consultas, debes identificar sus causas raíz, como columnas incorrectas, uniones de tablas faltantes o términos difusos no resueltos. La identificación manual de estos problemas requiere un análisis exhaustivo de los informes de evaluación.
El agente automatiza este bucle de análisis y corrección:
- Análisis de brechas: El agente lee los resultados de la evaluación y tu conjunto de información contextual para agrupar fallas similares y recomendar adiciones de contexto segmentadas, como plantillas, facetas o búsquedas de valores.
- Correcciones propuestas: El agente propone ediciones concretas y, de manera opcional, prueba el SQL en tu base de datos para verificar la resolución.
- Conservación de la base de referencia: El agente escribe las mejoras en un archivo JSON nuevo junto con tu contexto de referencia, lo que conserva los archivos originales.
Puedes usar las siguientes instrucciones de ejemplo para indicarle al agente qué hacer:
- "Run gap analysis on my last evaluation and propose fixes."
- "Optimize this context set against
golden.json."
Para prepararte para la próxima iteración, sube el contexto mejorado al conjunto de información contextual de destino con Data Agents Studio y sigue las instrucciones.
Crea elementos de contexto específicos a pedido
Si ya conoces el contexto requerido, como una plantilla para una pregunta específica, una faceta para un filtro repetido o una búsqueda de valores para una columna en particular, escribir el JSON de contexto de forma manual puede introducir errores de serialización en los nombres de los parámetros, los metadatos de tipo o la sintaxis de fragmentos. El agente controla el formato JSON para que puedas enfocarte en tu intención comercial.
También puedes usar esta función para actualizaciones ad hoc, como cuando necesitas admitir un nuevo patrón de consulta o abordar un detalle de esquema faltante. Para obtener el JSON, describe el contexto requerido al agente sin ejecutar una evaluación ni configurar un experimento.
Esta también es la capacidad adecuada para usar cuando se te asigna una tarea única: un interesado te da un nuevo par de pregunta y SQL que quiere que se admita, o bien detectas una faceta faltante durante una revisión de código. No necesitas configurar un experimento ni ejecutar una evaluación para corregirlo. Describe lo que quieres y el agente produce el JSON.
Puedes usar las siguientes instrucciones de ejemplo para indicarle al agente qué hacer:
- "Create a template for: 'Which airports are in California?' with SQL:
SELECT name FROM airports WHERE country = 'United States' AND state = 'CA'." - "Create a facet for the filter
departure_time BETWEEN '00:00:00' AND '06:00:00'labeled 'red eye'." - "Create a value search for
airports.iata."
Razona sobre qué selección de tipo de contexto
Seleccionar el tipo de contexto correcto, independientemente de si se trata de una plantilla, una faceta o una búsqueda de valores, ayuda a evitar el aumento del contexto y las regresiones de consultas de bases de datos. Por ejemplo, usar una plantilla en lugar de una faceta puede provocar reglas duplicadas, mientras que las búsquedas de valores introducidas cuando una plantilla es suficiente pueden aumentar la latencia de las consultas. Para encontrar el formato de esquema correcto, pídele al agente que recomiende un tipo en función de la estructura de la consulta o las columnas de la base de datos antes de crear elementos de contexto. El agente explica su razonamiento para ayudarte a comprender las opciones de contexto.
Puedes usar las siguientes instrucciones de ejemplo para indicarle al agente qué hacer:
- "I keep writing the filter
departure_time BETWEEN '00:00:00' AND '06:00:00'across many queries. What's the best way to capture this?" - "Users describe flight status in free text and I want to match them to
flights.status. What kind of value search should I set up?" - "What's the difference between a template and a facet, and when should I use each?"
Aplica operaciones masivas en un conjunto de información contextual
El agente admite actualizaciones masivas para administrar grandes conjuntos de información contextual de manera coherente. Si necesitas actualizar varios elementos de contexto de forma simultánea, como cuando se cambia el nombre de una columna de la base de datos, un valor de código cambia de formato o las plantillas hacen referencia a una tabla obsoleta, el agente puede aplicar el cambio en cada elemento afectado sin alterar las entradas no relacionadas.
Puedes usar las siguientes instrucciones de ejemplo para indicarle al agente qué hacer:
- "Read
golden.txtand turn all the pairs into templates." - "In
context_set.json, replaceairline = 'UA'withairline = 'United Airlines'for any item referencing 'United'. Leave unrelated items alone."
¿Qué sigue?
- Obtén más información sobre los conjuntos de información contextual.
- Obtén información para crear o borrar un conjunto de información contextual en Spanner Studio.
- Obtén información para probar un conjunto de información contextual.