


Um conjunto de contexto é uma coleção de orientações que ajuda ferramentas como o QueryData a gerar consultas precisas em Graph Query Language (GQL) para o gráfico de propriedades no banco de dados do Spanner. O QueryData lê o esquema do gráfico de propriedades diretamente do banco de dados. Um conjunto de contexto adiciona o que o esquema não captura: o significado dos termos de negócios, as consultas verificadas para as perguntas que os usuários fazem com frequência e como os usuários se referem aos valores armazenados no gráfico. Não é necessário redefinir o esquema do gráfico em um conjunto de contexto.
Os seguintes bancos de dados são compatíveis com o QueryData:
- AlloyDB para PostgreSQL
- Cloud SQL para MySQL
- Cloud SQL para PostgreSQL
- Spanner (incluindo o Spanner Graph)
- Firestore com compatibilidade com o MongoDB
Para usar conjuntos de contexto com tabelas relacionais do Spanner em vez do Spanner Graph, consulte Visão geral dos conjuntos de contexto para o Spanner.
O contexto é definido em um arquivo JSON que contém três tipos de objetos: modelos de consulta, aspectos de consulta e pesquisas de valor. É possível criar esse arquivo com a ajuda do agente de engenharia de contexto e, em seguida, fazer upload dele para um conjunto de contexto criado no Spanner Studio. O QueryData usa o conjunto de contexto quando uma solicitação QueryData o referencia no campo agent_context_reference.context_set_id.
É possível criar conjuntos de contexto nas regiões us-central1, us-east1, europe-west4 e asia-southeast1. A região de um conjunto de contexto não precisa corresponder ao local usado nas solicitações QueryData, como locations/global.
Os exemplos neste documento usam o esquema de gráfico de propriedades FinGraph (nós Person e Account conectados por arestas Owns e Transfers). Para configurar o gráfico de propriedades FinGraph no banco de dados do Spanner e inserir dados de amostra, consulte Configurar e consultar o Spanner Graph.
Como o QueryData usa um conjunto de contexto
Um conjunto de contexto pode conter três tipos de contexto. Cada tipo resolve um problema diferente, e o QueryData pode usá-los de forma independente ou em conjunto:
| Tipo de contexto | O que você fornece | Quando usar | Como o QueryData o usa | Exemplo de FinGraph |
|---|---|---|---|---|
| Modelo de consulta | Uma consulta GQL completa e verificada para um tipo de pergunta, com marcadores de posição ? para os valores que mudam. |
Os usuários fazem a mesma pergunta repetidamente com valores de parâmetro diferentes, especialmente quando a consulta é complexa de gerar (como um padrão de caminho de vários saltos). | Reutiliza a consulta sql diretamente para uma correspondência exata ou substitui parâmetros em parameterized_sql quando a pergunta corresponde ao modelo. |
"Algum dinheiro enviado da conta 7 voltou para ela em até 60 dias?" |
| Facetas de consulta | Uma cláusula GQL reutilizável, como um padrão MATCH ou uma condição WHERE, que define um termo ou condição comercial. |
Uma condição ou padrão reutilizável aparece em muitas perguntas diferentes. | Incorpora a cláusula GQL definida ao gerar uma nova consulta GQL. | Uma transferência de alto risco é uma transferência de 200 ou mais para uma conta bloqueada. |
| Pesquisa de valor | Uma consulta que encontra valores de propriedade armazenados que correspondem a uma frase de valor na pergunta do usuário. | Os usuários se referem a valores por nomes ou grafias diferentes de como eles são armazenados no gráfico. | Executa a consulta de pesquisa com a frase de valor antes de gerar a consulta GQL e, em seguida, filtra o valor e a propriedade armazenados resolvidos. | "dia chuvoso" se refere a Rainy Day Fund em Account.nick_name. |
O diagrama a seguir mostra como o QueryData processa uma pergunta usando um conjunto de contexto:
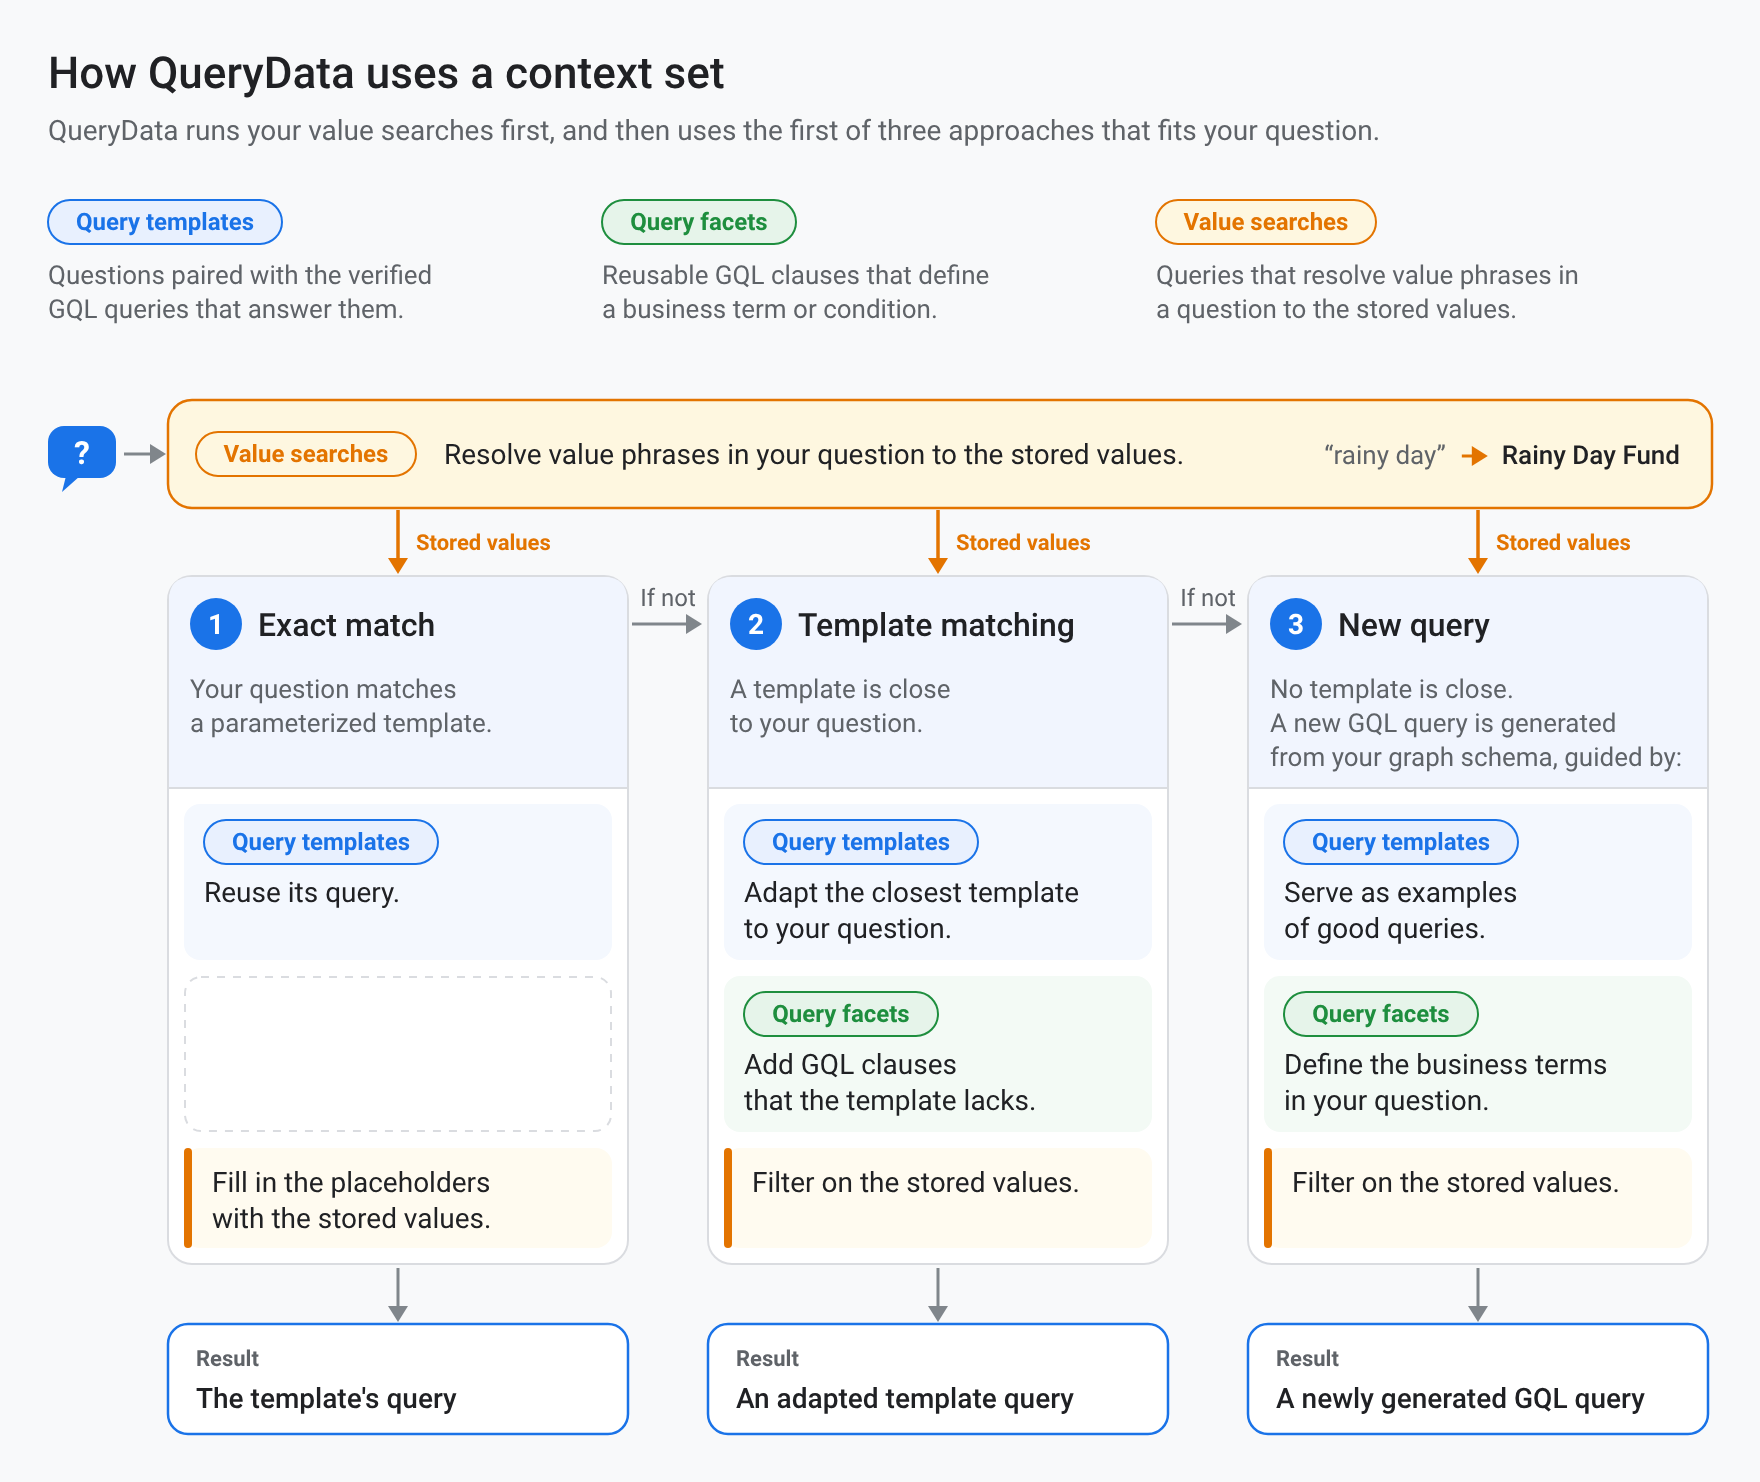
Como mostra o diagrama, quando o QueryData recebe uma pergunta, ele usa o conjunto de contexto na seguinte ordem:
- Recuperar contexto relevante. O QueryData recupera os modelos, os atributos e as pesquisas de valor mais semelhantes à pergunta.
- Executar pesquisas de valor. Para cada frase de valor na pergunta, como um nome ou apelido, o QueryData executa as pesquisas de valor para encontrar os valores armazenados correspondentes. As pesquisas de valor não são executadas para números, datas, horas ou valores de moeda.
- Correspondência com modelos de consulta. Se a pergunta corresponder a um modelo, o QueryData vai usar a consulta GQL verificada do modelo. Para uma correspondência exata com
nl_query, o QueryData executa a consultasqldiretamente. Para uma correspondência com um modelo parametrizado, o QueryData substitui os marcadores de posição?emparameterized_sqlpelos valores da pergunta e executa a consulta resultante. - Gerar uma nova consulta GQL. Caso contrário, o QueryData gera uma nova consulta GQL com base no esquema do gráfico. Ele aplica as facetas relevantes como regras de negócios, usa os modelos relevantes como exemplos e usa os valores armazenados que as pesquisas de valor encontraram.
Formato do arquivo do conjunto de contextos
Um arquivo de conjunto de contexto é um objeto JSON com três campos de matriz (templates, facets e value_searches) para os itens de contexto descritos nas seções a seguir. Um arquivo de conjunto de contexto vazio tem a seguinte estrutura:
{
  "templates": [],
  "facets": [],
  "value_searches": []
}
Use qualquer combinação desses campos e omita os que você não usa. Um bom ponto de partida para o Spanner Graph é criar um modelo para cada pergunta de vários saltos ou com limite de tempo que exija uma estrutura de consulta específica, uma faceta para cada termo de negócios que apareça em várias perguntas e uma pesquisa de valor para cada propriedade de texto que os usuários mencionam pelo nome (como nomes, apelidos ou países).
Ao editar um arquivo de conjunto de contexto, lembre-se das seguintes regras:
- Strings de consulta de linha única. Os valores de
sql,parameterized_sql,sql_snippet,parameterized_sql_snippet,queryenl_querysão strings JSON, então cada consulta é escrita em uma linha. Em uma consulta, use aspas simples (') para literais de string ou use aspas duplas de escape como\". - GQL em campos
sql. Alguns nomes de campo contêmsqlporque o formato é compartilhado por todos os bancos de dados compatíveis com o QueryData. Para o Spanner Graph, forneça consultas ou cláusulas GQL emsql,parameterized_sql,sql_snippeteparameterized_sql_snippet. - Nomes exatos dos campos. Os nomes dos campos precisam corresponder exatamente aos nomes neste documento. Os campos com nomes não reconhecidos são ignorados sem erro.
Modelos de consulta
Um modelo combina uma pergunta feita pelos usuários com a consulta GQL verificada que a responde. Use modelos para perguntas que os usuários fazem repetidamente, especialmente quando a consulta é complexa de gerar (como um padrão de caminho de vários saltos com uma condição de tempo).
Exemplo de modelo
Com o modelo a seguir no arquivo de conjunto de contexto, o QueryData pode responder a perguntas que compartilham a mesma estrutura, como "Algum dinheiro enviado da conta 7 voltou para ela em até 60 dias?" ou "Algum dinheiro enviado da conta 16 voltou para ela em até 30 dias?":
{
  "templates": [
    {
      "nl_query": "Did any money sent from account 7 come back to it within 60 days?",
      "sql": "GRAPH FinGraph MATCH TRAIL (src:Account {id: 7})-[sent:Transfers]->(:Account)-[:Transfers]->{0,2}(:Account)-[returned:Transfers]->(src) WHERE returned.create_time > sent.create_time AND TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) <= 60 RETURN sent.amount AS amount_sent, returned.amount AS amount_returned, TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) AS days_to_return",
      "intent": "Find transfer loops of two to four transfers that start and end at account 7, where the last transfer happens within 60 days after the first transfer.",
      "manifest": "Find transfer loops of two to four transfers that start and end at a given account, where the last transfer happens within a given number of days after the first transfer.",
      "parameterized": {
        "parameterized_intent": "Find transfer loops of two to four transfers that start and end at account ?, where the last transfer happens within ? days after the first transfer.",
        "parameterized_sql": "GRAPH FinGraph MATCH TRAIL (src:Account {id: ?})-[sent:Transfers]->(:Account)-[:Transfers]->{0,2}(:Account)-[returned:Transfers]->(src) WHERE returned.create_time > sent.create_time AND TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) <= ? RETURN sent.amount AS amount_sent, returned.amount AS amount_returned, TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) AS days_to_return"
      }
    }
  ]
}
Quando um usuário pergunta: "Algum dinheiro enviado da conta 7 voltou para ela em até 60 dias?", O QueryData faz a correspondência entre a pergunta e o modelo (ou, para uma pergunta com valores de parâmetro diferentes, como a conta 16 e 30 dias, substitui os dois marcadores de posição ? em parameterized_sql) e executa a seguinte consulta GQL:
GRAPH FinGraph
MATCH TRAIL
  (src:Account {id: 7})-[sent:Transfers]->(:Account)
    -[:Transfers]->{0,2}(:Account)-[returned:Transfers]->(src)
WHERE returned.create_time > sent.create_time
  AND TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) <= 60
RETURN
  sent.amount AS amount_sent,
  returned.amount AS amount_returned,
  TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) AS days_to_return
Usando os dados de amostra FinGraph, essa consulta retorna resultados semelhantes aos seguintes:
+-------------+-----------------+----------------+
| amount_sent | amount_returned | days_to_return |
+-------------+-----------------+----------------+
| 300         | 500             | 36             |
+-------------+-----------------+----------------+
Campos do modelo
Um objeto de modelo contém os seguintes campos:
| Campo | Requisito | Descrição |
|---|---|---|
nl_query |
Obrigatório | Um exemplo de pergunta, formulada da maneira que um usuário faria (por exemplo, "Algum dinheiro enviado da conta 7 voltou para ela em até 60 dias?"). |
sql |
Obrigatório | A consulta GQL completa que responde a nl_query. Inicie a consulta com GRAPH seguido pelo nome de um gráfico de propriedades que você especifica no campo graph_ids das suas solicitações QueryData, como GRAPH FinGraph. |
intent |
Obrigatório | Uma descrição precisa dos resultados retornados por sql. A pergunta de um usuário geralmente deixa as condições não declaradas, e o intent as declara (por exemplo, especificar que o dinheiro "voltou" significa "loops de transferência de duas a quatro transferências que começam e terminam na conta 7, em que a última transferência acontece em até 60 dias após a primeira"). |
manifest |
Obrigatório | Uma versão generalizada de intent que descreve o tipo de pergunta que o modelo responde, sem os valores específicos (por exemplo, "conta 7" se torna "uma determinada conta" e "60 dias" se torna "um determinado número de dias"). O QueryData recupera modelos comparando a pergunta com o manifesto. |
parameterized.parameterized_intent |
Opcional | O intent, com cada valor específico substituído por um marcador de posição ?. |
parameterized.parameterized_sql |
Opcional | A consulta sql, com cada valor específico substituído por um marcador de posição ? na mesma ordem que parameterized_intent. Quando uma pergunta corresponde ao modelo, o QueryData substitui os marcadores de posição pelos valores da pergunta e executa essa consulta. |
Se você escrever o arquivo de conjunto de contexto manualmente, preencha os quatro campos obrigatórios. O upload vai falhar com um erro INVALID_ARGUMENT se algum deles estiver vazio. O agente de engenharia de contexto gera intent, manifest e parameterized com base nos seus pares de nl_query e sql. Revise os valores gerados e edite-os se um valor que deveria permanecer fixo for substituído por um marcador de posição ou se um valor que deveria variar não for substituído.
Facetas de consulta
Uma faceta é uma cláusula GQL reutilizável, como um padrão MATCH ou uma condição WHERE, que define um termo ou condição de negócios. Ao contrário de um modelo, uma faceta é uma consulta parcial, não completa. Por isso, ela não começa com uma cláusula GRAPH e não está vinculada a uma pergunta. Quando o QueryData gera uma nova consulta, ele aplica as facetas relevantes à pergunta.
Exemplo de atributo
Na configuração facets a seguir, a primeira faceta captura o padrão de transferências que envolvem uma conta bloqueada, e a segunda define uma transferência de alto risco como uma transferência de 200 ou mais para uma conta bloqueada:
{
  "facets": [
    {
      "sql_snippet": "MATCH (account:Account)-[transfer:Transfers]-(:Account {is_blocked: true})",
      "intent": "transfers involving a blocked account, in either direction"
    },
    {
      "sql_snippet": "MATCH (account:Account)-[transfer:Transfers]->(blocked_account:Account {is_blocked: true}) WHERE transfer.amount >= 200",
      "intent": "high-risk transfers, which are transfers of 200 or more to a blocked account",
      "manifest": "high-risk transfers, which are transfers of a given amount or more to a blocked account",
      "parameterized": {
        "parameterized_intent": "high-risk transfers, which are transfers of ? or more to a blocked account",
        "parameterized_sql_snippet": "MATCH (account:Account)-[transfer:Transfers]->(blocked_account:Account {is_blocked: true}) WHERE transfer.amount >= ?"
      }
    }
  ]
}
Quando um usuário pergunta "Quantas transferências de alto risco o Alex fez?", nenhum modelo corresponde à pergunta. QueryData gera uma nova consulta GQL e incorpora a segunda faceta para contar transferências de 200 ou mais para uma conta bloqueada:
GRAPH `FinGraph`
MATCH (p:`Person` {`name`: "Alex"})-[:`Owns`]->(src:`Account`)
      -[t:`Transfers`]->(dst:`Account` {`is_blocked`: true})
FILTER t.`amount` >= 200.0
RETURN COUNT(*) AS high_risk_transfer_count
Usando os dados de amostra FinGraph, essa consulta conta a transferência de 300 da conta 7 para a conta bloqueada 16 e retorna resultados semelhantes aos seguintes:
+--------------------------+
| high_risk_transfer_count |
+--------------------------+
| 1                        |
+--------------------------+
Campos de atributo
Um objeto de atributo usa a mesma estrutura de um modelo de consulta, com as seguintes diferenças:
- Nenhum campo
nl_query. As facetas não têm um camponl_query, porque descrevem uma condição que aparece em muitas perguntas, em vez de uma única pergunta. sql_snippetem vez desql(obrigatório). Uma cláusula GQL, como um padrãoMATCHou uma condiçãoWHERE. Para evitar ambiguidade, use rótulos de nó e aresta e nomes de variáveis explícitos, como(account:Account), para que o QueryData possa combinar a cláusula GQL com o restante da consulta.intent(obrigatório),manifest(opcional) eparameterized(opcional). Defina o termo ou condição comercial da mesma forma que os campos de modelo, exceto que o QueryData faz a correspondência das perguntas com ointent(portanto, use uma descrição, e omanifesté opcional), e oparameterizedcontémparameterized_intenteparameterized_sql_snippet.
Consultas de pesquisa de valor
Uma pesquisa de valor é uma consulta, não uma tabela de consulta. Antes de gerar uma consulta GQL, o QueryData executa as pesquisas de valor uma vez para cada frase de valor na pergunta (um valor de texto, como um nome, um apelido ou um país), substituindo a frase por $value. Em seguida, ele usa os valores armazenados mais próximos retornados pelas consultas, junto com a propriedade de origem, ao escrever a consulta GQL. As pesquisas de valor não são executadas para números, datas, horas ou valores de moeda.
Exemplo de pesquisa de valor
Por exemplo, em FinGraph, a conta 20 tem o apelido Rainy Day Fund, e a propriedade Person.country armazena Czech_Republic com um sublinhado. As pesquisas de valor a seguir mapeiam frases de valor como "dia chuvoso" para Rainy Day Fund em Account.nick_name e "República Tcheca" para Czech_Republic em Person.country:
{
  "value_searches": [
    {
      "query": "SELECT value, columns, concept_type, distance, context FROM GRAPH_TABLE(FinGraph MATCH (a:Account) WHERE STRPOS(LOWER(a.nick_name), LOWER($value)) > 0 RETURN DISTINCT a.nick_name AS value, 'FinGraph.Account.nick_name' AS columns, 'Account nickname' AS concept_type, 1 - LENGTH($value) / LENGTH(a.nick_name) AS distance, JSON '{}' AS context)",
      "concept_type": "Account nickname",
      "description": "Case-insensitive partial match on account nicknames. Distance is 0 for an exact match and grows as the phrase covers less of the nickname."
    },
    {
      "query": "SELECT value, columns, concept_type, distance, context FROM GRAPH_TABLE(FinGraph MATCH (p:Person) WHERE LOWER(REPLACE(p.country, '_', ' ')) = LOWER(REPLACE($value, '_', ' ')) RETURN DISTINCT p.country AS value, 'FinGraph.Person.country' AS columns, 'Person country' AS concept_type, 0 AS distance, JSON '{}' AS context)",
      "concept_type": "Person country",
      "description": "Match for country names on Person nodes that ignores case and treats underscores as spaces"
    }
  ]
}
A consulta Account nickname, formatada para facilitar a leitura, é a seguinte:
SELECT value, columns, concept_type, distance, context
FROM GRAPH_TABLE(
  FinGraph
  MATCH (a:Account)
  WHERE STRPOS(LOWER(a.nick_name), LOWER($value)) > 0
  RETURN DISTINCT
    a.nick_name AS value,
    'FinGraph.Account.nick_name' AS columns,
    'Account nickname' AS concept_type,
    1 - LENGTH($value) / LENGTH(a.nick_name) AS distance,
    JSON '{}' AS context
)
Quando um usuário pergunta "Quem é o proprietário da conta de reserva de emergência?", O QueryData executa as pesquisas de valor com $value definido como 'rainy day'. A pesquisa Account nickname calcula distance com base no comprimento da frase em relação ao comprimento do apelido armazenado (enquanto uma frase mais ampla, como "fund", corresponde a Vacation Fund em cerca de 0.69 e Rainy Day Fund em cerca de 0.71, e uma correspondência exata, como "rainy day fund", tem uma distância de 0) e retorna resultados semelhantes aos seguintes:
+----------------+----------------------------+------------------+--------------------+---------+
| value          | columns                    | concept_type     | distance           | context |
+----------------+----------------------------+------------------+--------------------+---------+
| Rainy Day Fund | FinGraph.Account.nick_name | Account nickname | 0.3571428571428571 | {}      |
+----------------+----------------------------+------------------+--------------------+---------+
Em seguida, QueryData gera uma consulta GQL que filtra em {nick_name: 'Rainy Day Fund'} em vez de {nick_name: 'rainy day'}:
GRAPH `FinGraph`
MATCH (p:`Person`)-[:`Owns`]->(a:`Account` {`nick_name`: 'Rainy Day Fund'})
RETURN DISTINCT SAFE_TO_JSON(p) AS person
Usando os dados de amostra FinGraph, essa consulta retorna o nó Person para Dana no formato JSON, semelhante ao seguinte:
{
  "element_definition_name": "Person",
  "identifier": "kQKRBA==",
  "kind": "node",
  "labels": ["Person"],
  "properties": {
    "birthday": "1980-10-31T08:00:00Z",
    "city": "Moravia",
    "country": "Czech_Republic",
    "id": 2,
    "name": "Dana"
  }
}
Campos de pesquisa de valor e colunas SELECT obrigatórias
Um objeto de pesquisa de valor contém os seguintes campos:
| Campo | Requisito | Descrição |
|---|---|---|
query |
Obrigatório | Uma consulta do GoogleSQL que encontra os valores armazenados que correspondem a uma frase de valor. Use $value onde a frase vai. O QueryData substitui $value pela frase como uma string literal entre aspas. Portanto, não coloque $value entre aspas. Você pode usar o $value mais de uma vez. Escreva a consulta como uma instrução SELECT em um operador GRAPH_TABLE que corresponda a um rótulo de nó ou aresta, compare uma propriedade com $value e retorne as cinco colunas na tabela a seguir. |
concept_type |
Obrigatório | Um rótulo para o tipo de valor que a pesquisa encontra, como Account nickname ou Person country. |
description |
Opcional | Uma descrição de como a pesquisa corresponde aos valores. |
Cada pesquisa de valor query precisa retornar as cinco colunas a seguir nesta ordem:
| Coluna de saída | Descrição | Exemplo de FinGraph |
|---|---|---|
value |
O valor da propriedade correspondente, conforme armazenado no banco de dados. | a.nick_name AS value ('Rainy Day Fund') |
columns |
O local da propriedade, no formato GRAPH_NAME.LABEL.PROPERTY. O QueryData transmite esse valor para o modelo como o local do valor. Portanto, use uma forma consistente. |
'FinGraph.Account.nick_name' AS columns |
concept_type |
Um rótulo para o tipo de valor. Use a mesma string do campo concept_type da pesquisa de valor: o campo rotula a pesquisa, e a coluna rotula cada correspondência. |
'Account nickname' AS concept_type |
distance |
A distância entre o valor armazenado e a frase, em uma escala definida por você, em que 0 é uma correspondência exata. Por convenção, use valores de 0 a 1. O QueryData classifica os candidatos de todas as pesquisas de valor por distance e mantém os 10 mais próximos. Ele não aplica um limite, então exclua correspondências fracas na própria consulta, por exemplo, adicionando WHERE distance < 1.0 à instrução SELECT externa. |
1 - LENGTH($value) / LENGTH(a.nick_name) AS distance |
context |
Um valor JSON. O QueryData não usa essa coluna, mas ela precisa estar presente com o mesmo tipo em todas as pesquisas de valor. Retorne o JSON '{}'. |
JSON '{}' AS context |
Como o QueryData faz pesquisas de valor
O QueryData não executa pesquisas de valor uma por uma. Para cada frase de valor em uma pergunta, ela substitui a frase por $value em cada pesquisa de valor, anexa ORDER BY distance LIMIT 10 a cada consulta, combina as consultas com UNION ALL e executa o resultado como uma única instrução do GoogleSQL que mantém as 10 correspondências mais próximas. A consulta combinada é o motivo pelo qual as pesquisas de valor são escritas como instruções SELECT em GRAPH_TABLE, em vez de instruções GQL independentes: GRAPH_TABLE executa o padrão GQL MATCH como uma tabela, e UNION ALL e o ORDER BY distance compartilhado são construções SQL.
Esse modelo de execução tem as seguintes consequências para as consultas que você escreve:
- Não há
ORDER BYouLIMITexternos. Não adicioneORDER BYouLIMITà instruçãoSELECTexterna. O QueryData os anexa, e uma cláusula duplicada faz com que a instrução falhe. - Tipos de coluna compatíveis. Cada pesquisa de valor no arquivo precisa retornar as mesmas cinco colunas, na mesma ordem e com tipos compatíveis. Por exemplo, retorne
JSON '{}'paracontextem todos eles, não'{}'em alguns. - Marcador de posição obrigatório de
$value. A consulta precisa conter$valuepelo menos uma vez. Caso contrário, o upload vai falhar. - Somente valores de texto. As pesquisas de valor são executadas apenas para valores de texto. O QueryData não as executa para números, datas, horas ou valores monetários.
Limitações
Os conjuntos de contexto do Spanner Graph têm as seguintes limitações:
- Os conjuntos de contexto para bancos de dados são compatíveis apenas com modelos de consulta, atributos de consulta e pesquisas de valor.
- Os conjuntos de contexto para bancos de dados são usados apenas pelo endpoint
QueryDatana API Análise conversacional.
A seguir
- Saiba como criar ou excluir um conjunto de contexto no Spanner Studio.
- Saiba como criar conjuntos de contexto usando o agente de engenharia de contexto.