


קבוצת הקשר היא אוסף של הנחיות שעוזרות לכלים כמו QueryData ליצור שאילתות מדויקות ב-Graph Query Language (GQL) בשביל תרשים המאפיינים במסד הנתונים של Spanner. QueryData קורא את סכימת תרשים הנכסים ישירות ממסד הנתונים. קבוצת הקשר מוסיפה את מה שהסכימה לא מתעדת: המשמעות של המונחים העסקיים, שאילתות מאומתות לשאלות שהמשתמשים שואלים לעיתים קרובות, והאופן שבו המשתמשים מתייחסים לערכים שמאוחסנים בתרשים. אין צורך להגדיר מחדש את סכימת התרשים בקבוצת הקשרים.
אלה מסדי הנתונים שנתמכים ב-QueryData:
- AlloyDB ל-PostgreSQL
- Cloud SQL ל-MySQL
- Cloud SQL ל-PostgreSQL
- Spanner (כולל Spanner Graph)
- Firestore עם תאימות ל-MongoDB
כדי להשתמש בקבוצות הקשר עם טבלאות יחסיות של Spanner במקום ב-Spanner Graph, קראו את הסקירה הכללית על קבוצות הקשר ב-Spanner.
אתם מגדירים את ההקשר בקובץ JSON שמכיל שלושה סוגים של אובייקטים: תבניות של שאילתות, מאפייני שאילתות וחיפושי ערכים. אתם יכולים ליצור את הקובץ הזה בעזרת סוכן עם מנוע תלוי הקשר, ואז להעלות אותו לקבוצת הקשר שאתם יוצרים ב-Spanner Studio. הכלי QueryData משתמש בקבוצת ההקשר כשבקשת QueryData מפנה אליה בשדה agent_context_reference.context_set_id.
אפשר ליצור קבוצות הקשר באזורים us-central1, us-east1, europe-west4 ו-asia-southeast1. האזור של קבוצת ההקשר לא צריך להתאים למיקום שבו אתם משתמשים בבקשות של QueryData, כמו locations/global.
הדוגמאות במסמך הזה משתמשות בסכימת תרשים המאפיינים FinGraph (צומתי Person ו-Account שמחוברים באמצעות קצוות Owns ו-Transfers). כדי להגדיר את תרשים המאפיינים FinGraph במסד הנתונים ב-Spanner ולהוסיף נתונים לדוגמה, קראו את המאמר הגדרה והרצת שאילתות ב-Spanner Graph.
איך QueryData משתמש בקבוצת הקשר
קבוצת הקשרים יכולה להכיל שלושה סוגים של הקשרים. כל סוג פותר בעיה אחרת, ו-QueryData יכול להשתמש בהם בנפרד או ביחד:
| סוג הקשר | מה אתם מספקים | מתי כדאי להשתמש בזה? | איך QueryData משתמש בנתונים | FinGraph דוגמה |
|---|---|---|---|---|
| תבנית שאילתה | שאילתת GQL מלאה ומאומתת לסוג אחד של שאלה, עם פלייסהולדרים של ? לערכים שמשתנים. |
המשתמשים שואלים את אותה שאלה שוב ושוב עם ערכי פרמטרים שונים, במיוחד כשהשאילתה מורכבת ליצירה (כמו תבנית נתיב עם כמה דילוגים). | המערכת משתמשת בשאילתה sql ישירות להתאמה מדויקת, או מחליפה פרמטרים ב-parameterized_sql כשהשאלה תואמת לתבנית. |
"האם כסף שנשלח מחשבון 7 חזר אליו תוך 60 יום?" |
| היבט של שאילתה | סעיף GQL שניתן לשימוש חוזר, כמו תבנית MATCH או תנאי WHERE, שמגדיר מונח או תנאי עסקי. |
תנאי או דפוס אחד שניתן לשימוש חוזר מופיע בהרבה שאלות שונות. | משלב את סעיף ה-GQL שהוגדר כשיוצרים שאילתת GQL חדשה. | העברה בסיכון גבוה היא העברה של 200 או יותר לחשבון חסום. |
| חיפוש ערך | שאילתה שמוצאת ערכי מאפיינים שמורים שתואמים לביטוי ערך בשאלה של המשתמש. | המשתמשים מתייחסים לערכים לפי שמות או איותים שונים מהאופן שבו הם מאוחסנים בתרשים. | מריצה את שאילתת החיפוש עם ביטוי הערך לפני יצירת שאילתת ה-GQL, ואז מסננת לפי המאפיין והערך המאוחסן שנמצאו. | "יום גשום" מתייחס לRainy Day Fund בAccount.nick_name. |
התרשים הבא מראה איך QueryData מעבד שאלה באמצעות קבוצת הקשר:
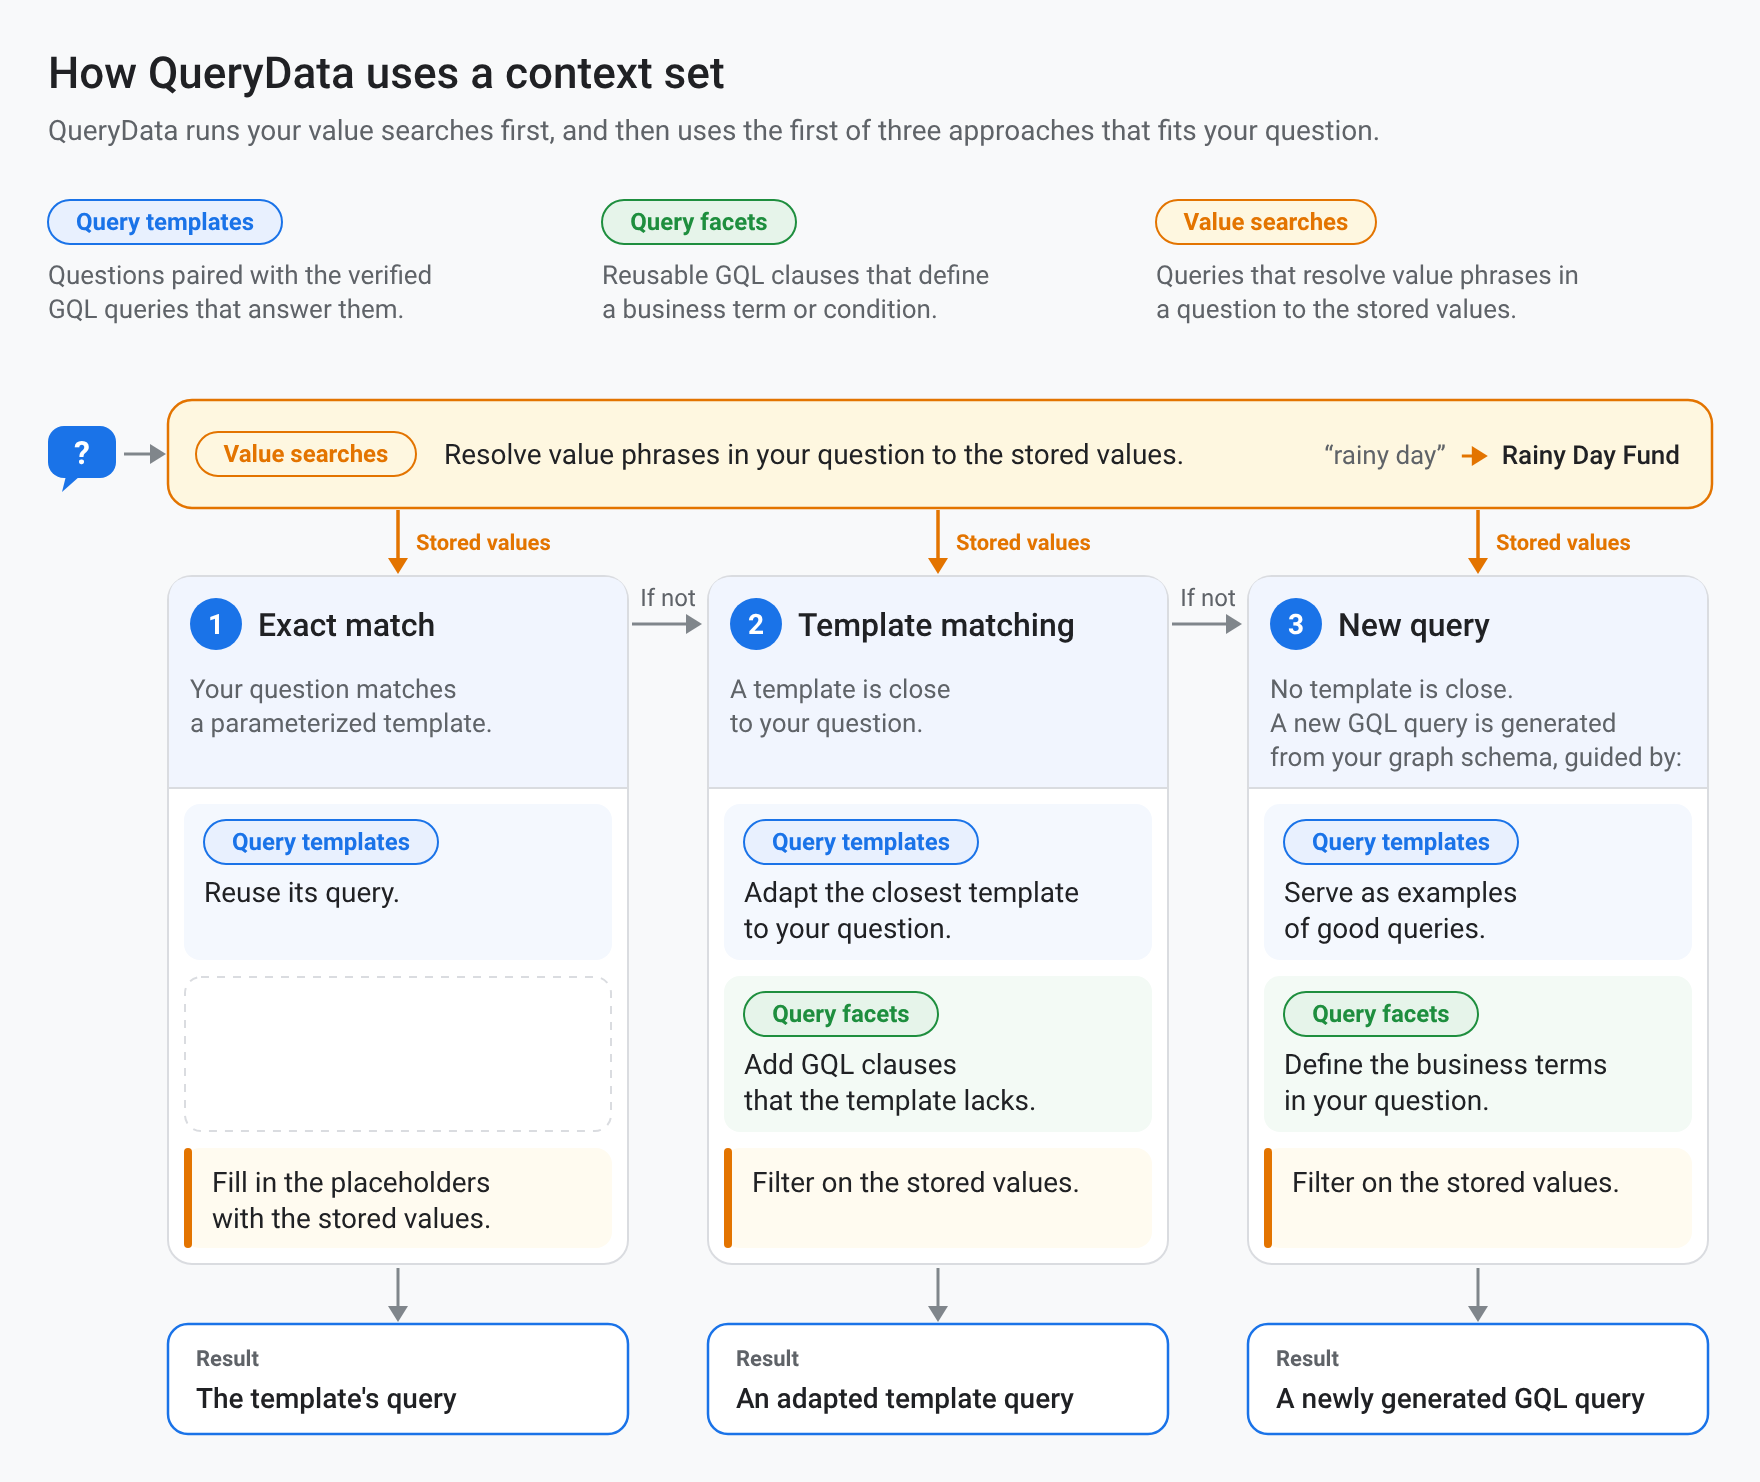
כמו שמוצג בתרשים, כש-QueryData מקבל שאלה, הוא משתמש בקבוצת ההקשר בסדר הבא:
- אחזור הקשר רלוונטי. QueryData מאחזר את התבניות, המאפיינים וחיפושי הערכים שהכי דומים לשאלה.
- חיפוש ערכים. לכל ביטוי ערך בשאלה, כמו שם או כינוי, QueryData מריץ את חיפושי הערכים כדי למצוא את הערכים השמורים התואמים. חיפושי ערכים לא פועלים על מספרים, תאריכים, שעות או סכומי מטבע.
- התאמה לתבניות של שאילתות. אם השאלה תואמת לתבנית, QueryData משתמש בשאילתת ה-GQL המאומתת של התבנית. כדי לקבל התאמה מדויקת ל-
nl_query, QueryData מריץ את השאילתהsqlישירות. אם יש התאמה לתבנית עם פרמטרים, QueryData מחליף את הפלייסהולדרים?ב-parameterized_sqlבערכים מהשאלה ומריץ את השאילתה שנוצרה. - יצירת שאילתת GQL חדשה. אחרת, QueryData יוצר שאילתת GQL חדשה מסכימת התרשים. הוא מחיל את ההיבטים הרלוונטיים ככללים עסקיים, משתמש בתבניות הרלוונטיות כדוגמאות ומשתמש בערכים השמורים שנמצאו בחיפושי הערכים.
פורמט הקובץ של קבוצת ההקשרים
קובץ של קבוצת הקשר הוא אובייקט JSON עם שלושה שדות מערך (templates, facets ו-value_searches) לפריטי ההקשר שמתוארים בקטעים הבאים. קובץ ריק של קבוצת הקשרים נראה ככה:
{
  "templates": [],
  "facets": [],
  "value_searches": []
}
אפשר להשתמש בכל שילוב של השדות האלה ולהשמיט את השדות שלא משתמשים בהם. נקודת התחלה טובה ל-Spanner Graph היא ליצור תבנית לכל שאלה עם כמה דילוגים או שאלה מוגבלת בזמן שדורשת מבנה שאילתה ספציפי, היבט לכל מונח עסקי שמופיע בכמה שאלות, וחיפוש ערכים לכל מאפיין טקסט שהמשתמשים מתייחסים אליו לפי שם (כמו שמות, כינויים או מדינות).
כשעורכים קובץ של קבוצת הקשרים, חשוב לזכור את הכללים הבאים:
- מחרוזות שאילתה בשורה אחת. הערכים של
sql,parameterized_sql,sql_snippet,parameterized_sql_snippet,queryו-nl_queryהם מחרוזות JSON, כך שכל שאילתה נכתבת בשורה אחת. בתוך שאילתה, צריך להשתמש במירכאות בודדות (') למחרוזות מילוליות, או לסמן בתו בריחה (escape) מירכאות כפולות בתור\". - GQL בשדות של
sql. חלק משמות השדות מכילים את הערךsqlכי הפורמט משותף לכל מסדי הנתונים שנתמכים ב-QueryData. ב-Spanner Graph, צריך לספק שאילתות או סעיפים של GQL ב-sql, ב-parameterized_sql, ב-sql_snippetוב-parameterized_sql_snippet. - שמות שדות מדויקים. שמות השדות חייבים להיות זהים בדיוק לשמות שמופיעים במסמך הזה. המערכת מתעלמת משדות עם שמות לא מזוהים בלי להציג שגיאה.
תבניות של שאילתות
תבנית משלבת שאלה שהמשתמשים שואלים עם שאילתת GQL מאומתת שעונה עליה. השתמשו בתבניות לשאלות שמשתמשים שואלים שוב ושוב, במיוחד כשהשאילתה מורכבת ליצירה (כמו תבנית נתיב עם כמה דילוגים ותנאי זמן).
דוגמה לתבנית
אם תוסיפו את התבנית הבאה לקובץ של קבוצת ההקשר, QueryData יוכל לענות על שאלות עם מבנה דומה, כמו "האם כסף שנשלח מחשבון 7 חזר אליו תוך 60 יום?" או "האם כסף שנשלח מחשבון 16 חזר אליו תוך 30 יום?":
{
  "templates": [
    {
      "nl_query": "Did any money sent from account 7 come back to it within 60 days?",
      "sql": "GRAPH FinGraph MATCH TRAIL (src:Account {id: 7})-[sent:Transfers]->(:Account)-[:Transfers]->{0,2}(:Account)-[returned:Transfers]->(src) WHERE returned.create_time > sent.create_time AND TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) <= 60 RETURN sent.amount AS amount_sent, returned.amount AS amount_returned, TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) AS days_to_return",
      "intent": "Find transfer loops of two to four transfers that start and end at account 7, where the last transfer happens within 60 days after the first transfer.",
      "manifest": "Find transfer loops of two to four transfers that start and end at a given account, where the last transfer happens within a given number of days after the first transfer.",
      "parameterized": {
        "parameterized_intent": "Find transfer loops of two to four transfers that start and end at account ?, where the last transfer happens within ? days after the first transfer.",
        "parameterized_sql": "GRAPH FinGraph MATCH TRAIL (src:Account {id: ?})-[sent:Transfers]->(:Account)-[:Transfers]->{0,2}(:Account)-[returned:Transfers]->(src) WHERE returned.create_time > sent.create_time AND TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) <= ? RETURN sent.amount AS amount_sent, returned.amount AS amount_returned, TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) AS days_to_return"
      }
    }
  ]
}
כשמשתמש שואל: "האם כסף שנשלח מחשבון 7 חזר אליו תוך 60 יום?", QueryData מתאימה את השאלה לתבנית (או, בשאלה עם ערכי פרמטרים שונים כמו חשבון 16 ו-30 ימים, מחליפה את שני ה-placeholder ? ב-parameterized_sql) ומריצה את שאילתת ה-GQL הבאה:
GRAPH FinGraph
MATCH TRAIL
  (src:Account {id: 7})-[sent:Transfers]->(:Account)
    -[:Transfers]->{0,2}(:Account)-[returned:Transfers]->(src)
WHERE returned.create_time > sent.create_time
  AND TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) <= 60
RETURN
  sent.amount AS amount_sent,
  returned.amount AS amount_returned,
  TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) AS days_to_return
אם משתמשים בנתונים לדוגמה של FinGraph, השאילתה הזו מחזירה תוצאות שדומות לתוצאות הבאות:
+-------------+-----------------+----------------+
| amount_sent | amount_returned | days_to_return |
+-------------+-----------------+----------------+
| 300         | 500             | 36             |
+-------------+-----------------+----------------+
שדות בתבנית
אובייקט של תבנית מכיל את השדות הבאים:
| שדה | דרישה | תיאור |
|---|---|---|
nl_query |
חובה | שאלה לדוגמה, בניסוח של המשתמש (לדוגמה, "האם כסף שנשלח מחשבון 7 חזר אליו תוך 60 יום?"). |
sql |
חובה | שאילתת GQL מלאה שעונה על nl_query. מתחילים את השאילתה ב-GRAPH ואחריו שם של תרשים מאפיינים שציינתם בשדה graph_ids של בקשות ה-QueryData, למשל GRAPH FinGraph. |
intent |
חובה | תיאור מדויק של התוצאות ש-sql מחזיר. הרבה פעמים, משתמשים לא מציינים תנאים בשאלות שלהם, ו-intent מציין אותם (לדוגמה, אם מציינים שכסף "חזר", הכוונה היא ל"לולאות העברה של שתיים עד ארבע העברות שמתחילות ומסתיימות בחשבון 7, כשההעברה האחרונה מתרחשת תוך 60 יום אחרי ההעברה הראשונה"). |
manifest |
חובה | גרסה כללית של intent שמתארת את סוג השאלה שהתבנית עונה עליה, בלי הערכים הספציפיים (לדוגמה, "חשבון 7" הופך ל "חשבון נתון", ו "60 ימים" הופך ל "מספר נתון של ימים"). QueryData מאחזר תבניות על ידי השוואה בין השאלה למניפסט. |
parameterized.parameterized_intent |
אופציונלי | intent, כשכל ערך ספציפי מוחלף בפלייסהולדר ?. |
parameterized.parameterized_sql |
אופציונלי | השאילתה sql, שבה כל ערך ספציפי מוחלף בפלייסהולדר ? באותו סדר כמו parameterized_intent. כשהשאלה תואמת לתבנית, QueryData מחליף את ה-placeholders בערכים מהשאלה ומריץ את השאילתה הזו. |
אם אתם כותבים את קובץ קבוצת ההקשרים באופן ידני, מלאו את כל ארבעת שדות החובה. אם אחד מהם ריק, ההעלאה תיכשל עם שגיאת INVALID_ARGUMENT. הסוכן עם מנוע תלוי הקשר יוצר את intent, manifest ו-parameterized מהצמדים של nl_query ו-sql. בודקים את הערכים שנוצרו ועורכים אותם אם ערך שצריך להישאר קבוע הוחלף בפלייסהולדר, או אם ערך שצריך להשתנות לא הוחלף.
היבטים של שאילתות
היבט הוא סעיף GQL שניתן לשימוש חוזר, כמו תבנית MATCH או תנאי WHERE, שמגדיר מונח או תנאי עסקי. בניגוד לתבנית, מאפיין הוא שאילתה חלקית ולא שאילתה מלאה, ולכן הוא לא מתחיל בפסוקית GRAPH ולא קשור לשאלה אחת. כשהכלי QueryData יוצר שאילתה חדשה, הוא מחיל את המאפיינים שרלוונטיים לשאלה.
דוגמה למאפיין
בהגדרה הבאה של facets, המאפיין הראשון מתעד את התבנית של העברות שכוללות חשבון חסום, והמאפיין השני מגדיר העברה בסיכון גבוה כהעברה של 200 או יותר לחשבון חסום:
{
  "facets": [
    {
      "sql_snippet": "MATCH (account:Account)-[transfer:Transfers]-(:Account {is_blocked: true})",
      "intent": "transfers involving a blocked account, in either direction"
    },
    {
      "sql_snippet": "MATCH (account:Account)-[transfer:Transfers]->(blocked_account:Account {is_blocked: true}) WHERE transfer.amount >= 200",
      "intent": "high-risk transfers, which are transfers of 200 or more to a blocked account",
      "manifest": "high-risk transfers, which are transfers of a given amount or more to a blocked account",
      "parameterized": {
        "parameterized_intent": "high-risk transfers, which are transfers of ? or more to a blocked account",
        "parameterized_sql_snippet": "MATCH (account:Account)-[transfer:Transfers]->(blocked_account:Account {is_blocked: true}) WHERE transfer.amount >= ?"
      }
    }
  ]
}
כשמשתמש שואל "כמה העברות בסיכון גבוה אלכס ביצע?", אין תבנית שמתאימה לשאלה. הפונקציה QueryData יוצרת שאילתת GQL חדשה ומשלבת את המאפיין השני כדי לספור העברות של 200 או יותר לחשבון חסום:
GRAPH `FinGraph`
MATCH (p:`Person` {`name`: "Alex"})-[:`Owns`]->(src:`Account`)
      -[t:`Transfers`]->(dst:`Account` {`is_blocked`: true})
FILTER t.`amount` >= 200.0
RETURN COUNT(*) AS high_risk_transfer_count
באמצעות הנתונים לדוגמה של FinGraph, השאילתה הזו סופרת את ההעברה של 300 מחשבון 7 לחשבון החסום 16 ומחזירה תוצאות שדומות לתוצאות הבאות:
+--------------------------+
| high_risk_transfer_count |
+--------------------------+
| 1                        |
+--------------------------+
שדות של מאפיינים
אובייקט של מאפיין משתמש באותו מבנה כמו תבנית שאילתה, עם ההבדלים הבאים:
- אין שדה
nl_query. למאפיינים אין שדהnl_query, כי מאפיין מתאר תנאי שמופיע בהרבה שאלות ולא בשאלה אחת. sql_snippetבמקוםsql(חובה). סעיף GQL, כמו תבניתMATCHאו תנאיWHERE. כדי למנוע אי-בהירות, השתמשו בתוויות מפורשות של צמתים וקצוות ובשמות משתנים, כמו(account:Account), כדי ש-QueryData יוכל לשלב את סעיף ה-GQL עם שאר השאילתה.intent(חובה),manifest(אופציונלי) ו-parameterized(אופציונלי). מגדירים את המונח או התנאי העסקי באותו אופן כמו שדות התבנית, אלא ש-QueryData מתאים שאלות ל-intent(לכן צריך להפוך אותו לתיאורי, ו-manifestהוא אופציונלי), ו-parameterizedמכיל אתparameterized_intentו-parameterized_sql_snippet.
שאילתות חיפוש של ערכים
חיפוש ערך הוא שאילתה, לא טבלת מיפוי. לפני ש-QueryData יוצר שאילתת GQL, הוא מריץ את חיפושי הערכים פעם אחת לכל ביטוי ערך בשאלה (ערך טקסט כמו שם, כינוי או מדינה), ומחליף את הביטוי ב-$value. לאחר מכן, המערכת משתמשת בערכים השמורים הקרובים ביותר שהשאילתות מחזירות, יחד עם הנכס שממנו הם מגיעים, כשהיא כותבת את שאילתת ה-GQL. חיפושי ערכים לא פועלים על מספרים, תאריכים, שעות או סכומי מטבע.
דוגמה לחיפוש ערך
לדוגמה, ב-FinGraph, לחשבון 20 יש את הכינוי Rainy Day Fund, והמאפיין Person.country מאחסן את Czech_Republic עם קו תחתון. הערכים הבאים ממפים ביטויים של ערכי מפה כמו "יום גשום" ל-Rainy Day Fund ב-Account.nick_name, ו"צ'כיה" ל-Czech_Republic ב-Person.country:
{
  "value_searches": [
    {
      "query": "SELECT value, columns, concept_type, distance, context FROM GRAPH_TABLE(FinGraph MATCH (a:Account) WHERE STRPOS(LOWER(a.nick_name), LOWER($value)) > 0 RETURN DISTINCT a.nick_name AS value, 'FinGraph.Account.nick_name' AS columns, 'Account nickname' AS concept_type, 1 - LENGTH($value) / LENGTH(a.nick_name) AS distance, JSON '{}' AS context)",
      "concept_type": "Account nickname",
      "description": "Case-insensitive partial match on account nicknames. Distance is 0 for an exact match and grows as the phrase covers less of the nickname."
    },
    {
      "query": "SELECT value, columns, concept_type, distance, context FROM GRAPH_TABLE(FinGraph MATCH (p:Person) WHERE LOWER(REPLACE(p.country, '_', ' ')) = LOWER(REPLACE($value, '_', ' ')) RETURN DISTINCT p.country AS value, 'FinGraph.Person.country' AS columns, 'Person country' AS concept_type, 0 AS distance, JSON '{}' AS context)",
      "concept_type": "Person country",
      "description": "Match for country names on Person nodes that ignores case and treats underscores as spaces"
    }
  ]
}
השאילתה Account nickname, בפורמט שקל לקרוא, נראית כך:
SELECT value, columns, concept_type, distance, context
FROM GRAPH_TABLE(
  FinGraph
  MATCH (a:Account)
  WHERE STRPOS(LOWER(a.nick_name), LOWER($value)) > 0
  RETURN DISTINCT
    a.nick_name AS value,
    'FinGraph.Account.nick_name' AS columns,
    'Account nickname' AS concept_type,
    1 - LENGTH($value) / LENGTH(a.nick_name) AS distance,
    JSON '{}' AS context
)
כשמשתמש שואל "Who owns the rainy day account?", QueryData מריץ את חיפושי הערכים כש-$value מוגדר ל-'rainy day'. החיפוש של Account nickname מחשב את distance לפי אורך הביטוי ביחס לאורך הכינוי השמור (לעומת זאת, ביטוי רחב יותר כמו "fund" תואם ל-Vacation Fund בערך של 0.69 ול-Rainy Day Fund בערך של 0.71, והתאמה מדויקת כמו "rainy day fund" היא במרחק של 0), ומחזיר תוצאות דומות לאלה:
+----------------+----------------------------+------------------+--------------------+---------+
| value          | columns                    | concept_type     | distance           | context |
+----------------+----------------------------+------------------+--------------------+---------+
| Rainy Day Fund | FinGraph.Account.nick_name | Account nickname | 0.3571428571428571 | {}      |
+----------------+----------------------------+------------------+--------------------+---------+
ואז QueryData יוצר שאילתת GQL שמסננת לפי {nick_name: 'Rainy Day Fund'} במקום {nick_name: 'rainy day'}:
GRAPH `FinGraph`
MATCH (p:`Person`)-[:`Owns`]->(a:`Account` {`nick_name`: 'Rainy Day Fund'})
RETURN DISTINCT SAFE_TO_JSON(p) AS person
באמצעות הנתונים לדוגמה של FinGraph, השאילתה הזו מחזירה את הצומת Person של Dana בפורמט JSON, בדומה לזה:
{
  "element_definition_name": "Person",
  "identifier": "kQKRBA==",
  "kind": "node",
  "labels": ["Person"],
  "properties": {
    "birthday": "1980-10-31T08:00:00Z",
    "city": "Moravia",
    "country": "Czech_Republic",
    "id": 2,
    "name": "Dana"
  }
}
שדות חיפוש של ערכים ועמודות SELECT נדרשות
אובייקט של חיפוש ערך מכיל את השדות הבאים:
| שדה | דרישה | תיאור |
|---|---|---|
query |
חובה | שאילתת GoogleSQL שמוצאת את הערכים השמורים שתואמים לביטוי ערך. משתמשים ב-$value במקום שבו הביטוי אמור להופיע. הפונקציה QueryData מחליפה את $value בביטוי כמחרוזת מילולית במירכאות, לכן אל תקיפו את $value במירכאות. אפשר להשתמש ב-$value יותר מפעם אחת. כותבים את השאילתה כהצהרת SELECT על אופרטור GRAPH_TABLE שתואם לתווית של צומת או קצה, משווים מאפיין ל-$value ומחזירים את חמש העמודות בטבלה הבאה. |
concept_type |
חובה | תווית לסוג הערך שהחיפוש מוצא, כמו Account nickname או Person country. |
description |
אופציונלי | תיאור של אופן ההתאמה של החיפוש לערכים. |
כל חיפוש ערכים query חייב להחזיר את חמש העמודות הבאות בסדר הזה:
| עמודת פלט | תיאור | FinGraph דוגמה |
|---|---|---|
value |
ערך המאפיין התואם, כפי שהוא מאוחסן במסד הנתונים. | a.nick_name AS value ('Rainy Day Fund') |
columns |
המיקום של הנכס, בפורמט GRAPH_NAME.LABEL.PROPERTY. הערך הזה מועבר על ידי QueryData למודל כמיקום של הערך, לכן צריך להשתמש בפורמט עקבי. |
'FinGraph.Account.nick_name' AS columns |
concept_type |
תווית לסוג הערך. משתמשים באותה מחרוזת כמו בשדה concept_type של חיפוש הערך: השדה מסמן את החיפוש, והעמודה מסמנת כל התאמה. |
'Account nickname' AS concept_type |
distance |
המרחק בין הערך השמור לבין הביטוי, בסולם שאתם מגדירים, כאשר 0 הוא התאמה מדויקת. מקובל להשתמש בערכים מ-0 עד 1. QueryData ממיין את המועמדים מכל החיפושים לפי ערך לפי distance ושומר את 10 המועמדים הקרובים ביותר. היא לא מחילה סף, ולכן צריך להחריג התאמות חלשות בשאילתה עצמה, למשל על ידי הוספת WHERE distance < 1.0 להצהרת SELECT החיצונית. |
1 - LENGTH($value) / LENGTH(a.nick_name) AS distance |
context |
ערך של JSON. העמודה הזו לא משמשת את QueryData, אבל היא חייבת להופיע עם אותו סוג בכל חיפוש ערכים. החזרה של JSON '{}'. |
JSON '{}' AS context |
איך QueryData מריץ חיפושי ערכים
QueryData לא מריץ חיפושי ערכים אחד אחרי השני. לכל ביטוי ערך בשאלה, הוא מחליף את הביטוי ב-$value בכל חיפוש ערך, מוסיף את ORDER BY distance LIMIT 10 לכל שאילתה, משלב את השאילתות עם UNION ALL ומריץ את התוצאה כהצהרת GoogleSQL אחת ששומרת את 10 ההתאמות הקרובות ביותר. השאילתה המשולבת היא הסיבה לכך שחיפושי ערכים נכתבים כהצהרות SELECT מעל GRAPH_TABLE ולא כהצהרות GQL נפרדות: GRAPH_TABLE מריץ את תבנית ה-GQL MATCH כטבלה, ו-UNION ALL וה-ORDER BY distance המשותף הם מבני SQL.
למודל הביצוע הזה יש את ההשלכות הבאות על השאילתות שאתם כותבים:
- אין תגי
ORDER BYאוLIMITחיצוניים. אל תוסיפו אתORDER BYאו אתLIMITלהצהרתSELECTהחיצונית. הפונקציה QueryData מוסיפה אותם, וסעיף כפול גורם להצהרה להיכשל. - סוגי עמודות תואמים. כל חיפוש ערכים בקובץ חייב להחזיר את אותן חמש עמודות, באותו סדר ועם סוגים תואמים. לדוגמה, להחזיר
JSON '{}'עבורcontextבכולם, ולא'{}'בחלק מהם. - פלייסהולדר
$valueחובה. השאילתה חייבת להכיל את$valueלפחות פעם אחת, אחרת ההעלאה תיכשל. - ערכי טקסט בלבד. חיפושי ערכים פועלים רק על ערכי טקסט. התכונה QueryData לא מפעילה אותם על מספרים, תאריכים, שעות או סכומי מטבע.
מגבלות
לקבוצות הקשר ב-Spanner Graph יש את המגבלות הבאות:
- קבוצות הקשר למסדי נתונים תומכות רק בתבניות של שאילתות, בהיבטים של שאילתות ובחיפושי ערכים.
- קבוצות הקשר למסדי נתונים משמשות רק את נקודת הקצה
QueryDataב-Conversational Analytics API.
המאמרים הבאים
- איך יוצרים או מוחקים קבוצת הקשר ב-Spanner Studio
- איך יוצרים קבוצות הקשר באמצעות סוכן עם מנוע תלוי הקשר