


Un conjunto de información contextual es una colección de orientación que ayuda a herramientas como QueryData a generar consultas precisas de Graph Query Language (GQL) para el grafo de propiedades en tu base de datos de Spanner. QueryData lee el esquema del gráfico de propiedades directamente desde la base de datos. Un conjunto de contexto agrega lo que el esquema no captura: el significado de tus términos comerciales, las consultas verificadas para las preguntas que tus usuarios hacen con frecuencia y cómo los usuarios se refieren a los valores que se almacenan en tu grafo. No es necesario que vuelvas a definir el esquema de tu grafo en un conjunto de contexto.
QueryData admite las siguientes bases de datos:
- AlloyDB para PostgreSQL
- Cloud SQL para MySQL
- Cloud SQL para PostgreSQL
- Spanner (incluido Spanner Graph)
- Firestore compatible con MongoDB
Para usar conjuntos de contexto con tablas relacionales de Spanner en lugar de Spanner Graph, consulta Descripción general de los conjuntos de contexto para Spanner.
El contexto se define en un archivo JSON que contiene tres tipos de objetos: plantillas de consulta, facetas de consulta y búsquedas de valores. Puedes crear este archivo con la ayuda del agente de ingeniería de contexto y, luego, subirlo a un conjunto de información contextual que crees en Spanner Studio. QueryData usa el conjunto de información contextual cuando una solicitud QueryData hace referencia a él en el campo agent_context_reference.context_set_id.
Puedes crear conjuntos de contexto en las regiones us-central1, us-east1, europe-west4 y asia-southeast1. No es necesario que la región de un conjunto de contexto coincida con la ubicación que usas en las solicitudes QueryData, como locations/global.
En los ejemplos de este documento, se usa el esquema de grafo de propiedades FinGraph (nodos Person y Account conectados por bordes Owns y Transfers). Para configurar el grafo de propiedades FinGraph en tu base de datos de Spanner y, luego, insertar datos de muestra, consulta Configura y consulta Spanner Graph.
Cómo QueryData usa un conjunto de contexto
Un conjunto de contextos puede contener tres tipos de contexto. Cada tipo resuelve un problema diferente, y QueryData puede usarlos de forma independiente o en conjunto:
| Tipo de contexto | Qué proporcionas | Cuándo se utiliza | Cómo lo usa QueryData | Ejemplo FinGraph |
|---|---|---|---|---|
| Plantilla de consulta | Una consulta de GQL completa y verificada para un tipo de pregunta, con marcadores de posición ? para los valores que cambian. |
Los usuarios hacen la misma pregunta varias veces con diferentes valores de parámetros, en especial cuando la consulta es compleja de generar (como un patrón de ruta de acceso de varios saltos). | Reutiliza la consulta sql directamente para obtener una coincidencia exacta o sustituye los parámetros en parameterized_sql cuando la pregunta coincide con la plantilla. |
"¿Se devolvió dinero enviado desde la cuenta 7 en un plazo de 60 días?" |
| Facetas de búsqueda | Es una cláusula de GQL reutilizable, como un patrón MATCH o una condición WHERE, que define un término o una condición empresarial. |
Una condición o un patrón reutilizable aparece en muchas preguntas diferentes. | Incorpora la cláusula de GQL definida cuando se genera una nueva consulta de GQL. | Una transferencia de alto riesgo es una transferencia de 200 o más a una cuenta bloqueada. |
| Búsqueda de valores | Es una consulta que busca valores de propiedad almacenados que coincidan con una frase de valor en la pregunta del usuario. | Los usuarios se refieren a los valores por nombres o grafías que difieren de cómo se almacenan en el gráfico. | Ejecuta la consulta de búsqueda con la frase de valor antes de generar la consulta de GQL y, luego, filtra por el valor y la propiedad almacenados resueltos. | "día lluvioso" se refiere a Rainy Day Fund en Account.nick_name. |
En el siguiente diagrama, se muestra cómo QueryData procesa una pregunta con un conjunto de contexto:
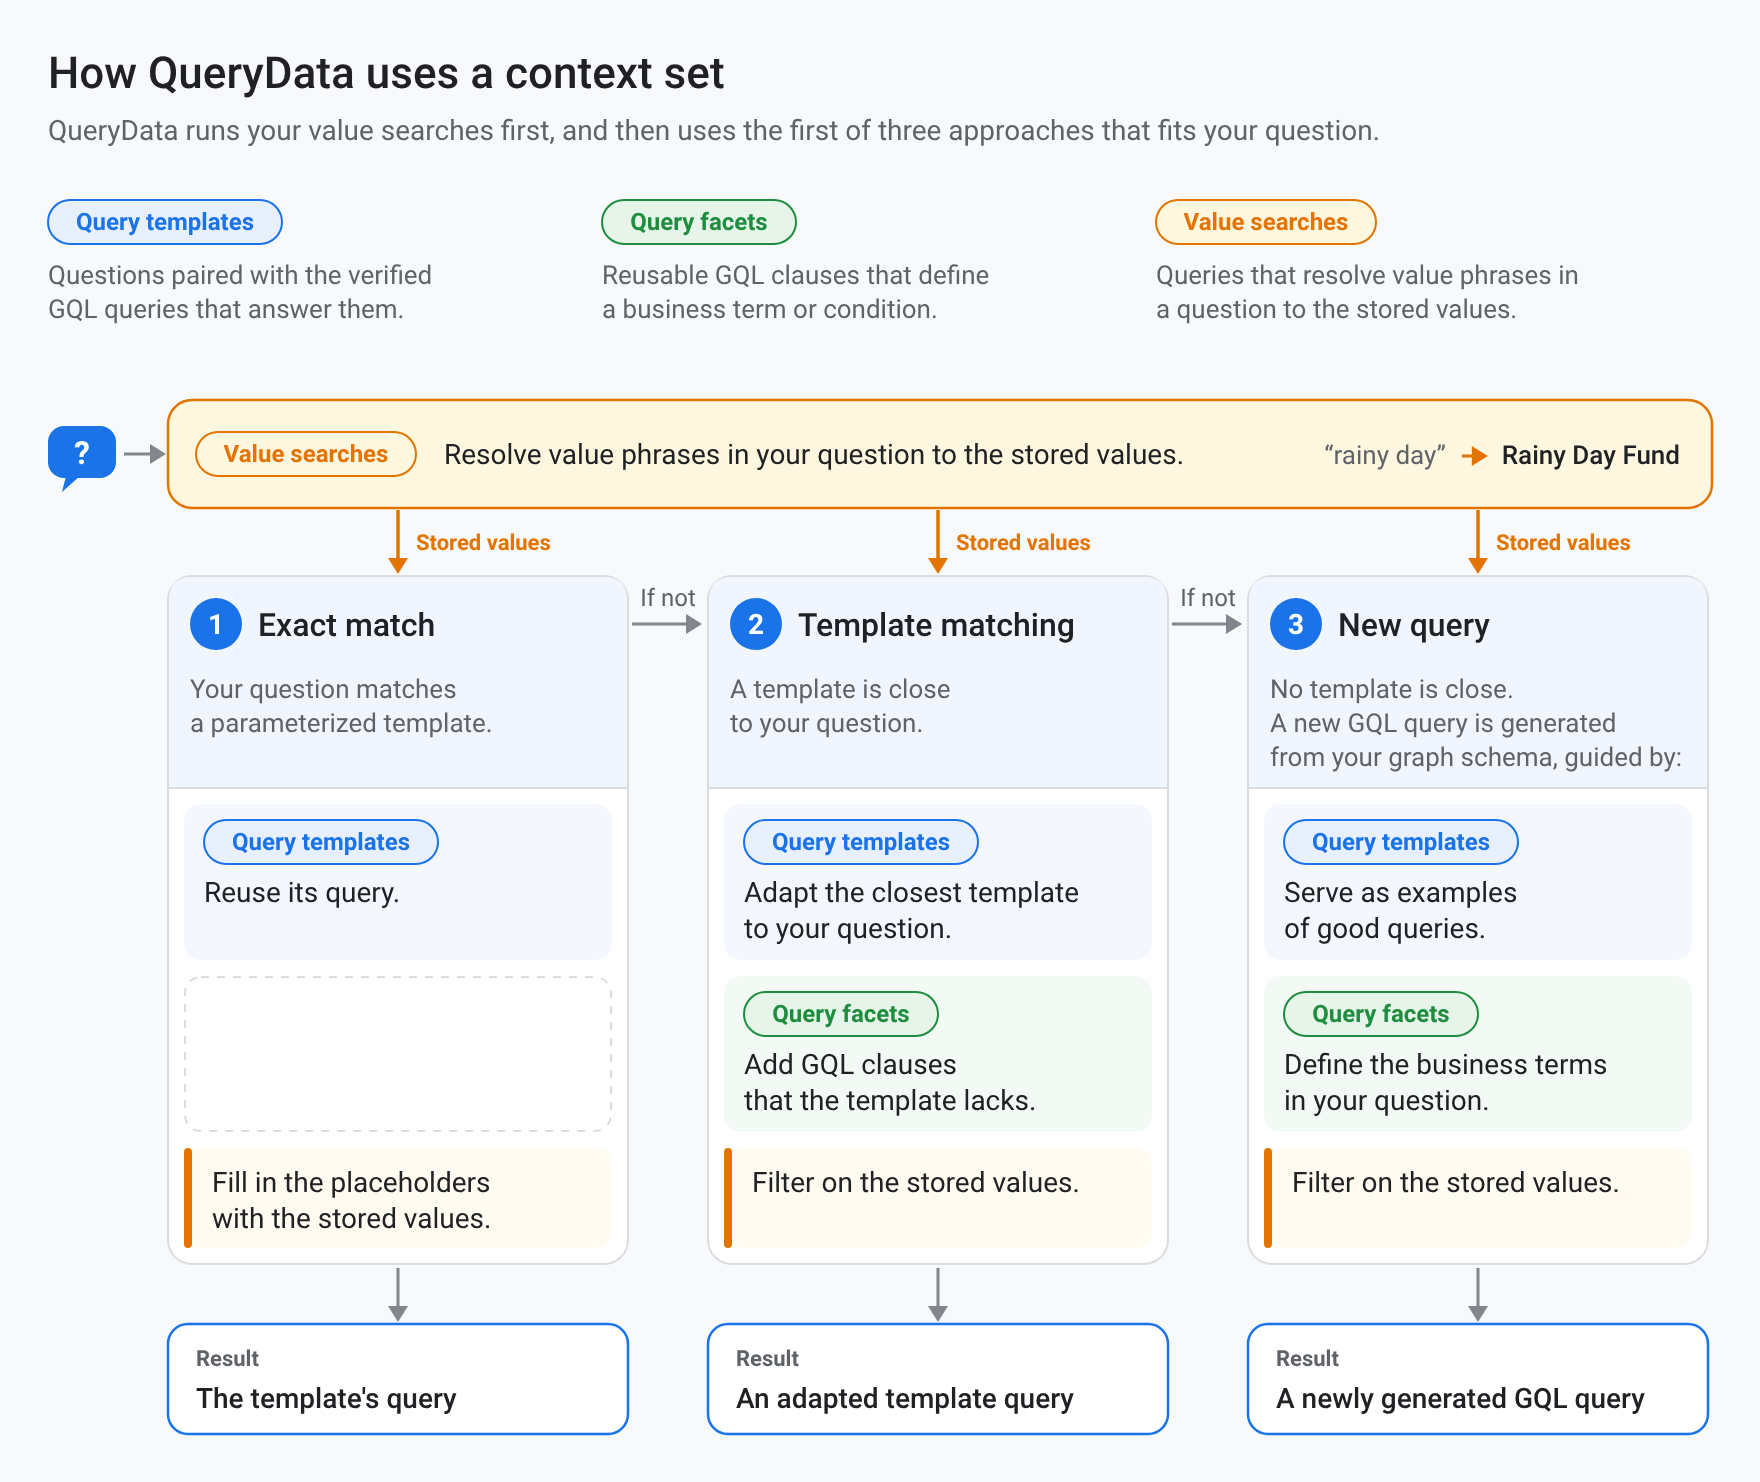
Como se muestra en el diagrama, cuando QueryData recibe una pregunta, usa tu conjunto de información contextual en el siguiente orden:
- Recupera el contexto pertinente. QueryData recupera las plantillas, las facetas y las búsquedas de valores que son más similares a la pregunta.
- Ejecuta búsquedas de valores. Para cada frase de valor de la pregunta, como un nombre o un sobrenombre, QueryData ejecuta tus búsquedas de valores para encontrar los valores almacenados que coincidan. Las búsquedas de valores no se ejecutan para números, fechas, horas ni importes de moneda.
- Coincidencia con plantillas de consulta. Si la pregunta coincide con una plantilla, QueryData usa la consulta de GQL verificada de la plantilla. Para obtener una coincidencia exacta con
nl_query, QueryData ejecuta la consultasqldirectamente. Para una coincidencia con una plantilla parametrizada, QueryData reemplaza los marcadores de posición?enparameterized_sqlpor los valores de la pregunta y ejecuta la consulta resultante. - Genera una nueva consulta en GQL. De lo contrario, QueryData genera una nueva consulta de GQL a partir de tu esquema de grafo. Aplica las facetas pertinentes como reglas de negocio, usa las plantillas pertinentes como ejemplos y usa los valores almacenados que encontraron las búsquedas de valores.
Formato de archivo del conjunto de contexto
Un archivo de conjunto de contexto es un objeto JSON con tres campos de array (templates, facets y value_searches) para los elementos de contexto que se describen en las siguientes secciones. Un archivo de conjunto de contexto vacío tiene la siguiente estructura:
{
  "templates": [],
  "facets": [],
  "value_searches": []
}
Usa cualquier combinación de estos campos y omite los que no uses. Un buen punto de partida para Spanner Graph es crear una plantilla para cada pregunta de varios saltos o con límite de tiempo que requiera una estructura de consulta específica, una faceta para cada término empresarial que aparezca en varias preguntas y una búsqueda de valores para cada propiedad de texto a la que los usuarios se refieran por nombre (como nombres, sobrenombres o países).
Cuando edites un archivo de conjunto de contexto, ten en cuenta las siguientes reglas:
- Cadenas de consulta de una sola línea. Los valores de
sql,parameterized_sql,sql_snippet,parameterized_sql_snippet,queryynl_queryson cadenas JSON, por lo que cada consulta se escribe en una línea. Dentro de una consulta, usa comillas simples (') para los literales de cadena o escapa las comillas dobles como\". - GQL en campos
sql. Algunos nombres de campos contienensqlporque el formato es compartido por todas las bases de datos que admite QueryData. Para Spanner Graph, proporciona consultas o cláusulas de GQL ensql,parameterized_sql,sql_snippetyparameterized_sql_snippet. - Nombres de campo exactos. Los nombres de los campos deben coincidir exactamente con los nombres de este documento. Los campos con nombres no reconocidos se ignoran sin que se produzca un error.
Plantillas de consulta
Una plantilla vincula una pregunta que hacen tus usuarios con la consulta de GQL verificada que la responde. Usa plantillas para las preguntas que los usuarios hacen de forma reiterada, en especial cuando la consulta es compleja de generar (como un patrón de ruta de varios saltos con una condición de tiempo).
Ejemplo de plantilla
Con la siguiente plantilla en tu archivo de conjunto de contexto, QueryData puede responder preguntas que comparten la misma estructura, como "¿Se devolvió dinero enviado desde la cuenta 7 en un plazo de 60 días?" o "¿Se devolvió dinero enviado desde la cuenta 16 en un plazo de 30 días?":
{
  "templates": [
    {
      "nl_query": "Did any money sent from account 7 come back to it within 60 days?",
      "sql": "GRAPH FinGraph MATCH TRAIL (src:Account {id: 7})-[sent:Transfers]->(:Account)-[:Transfers]->{0,2}(:Account)-[returned:Transfers]->(src) WHERE returned.create_time > sent.create_time AND TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) <= 60 RETURN sent.amount AS amount_sent, returned.amount AS amount_returned, TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) AS days_to_return",
      "intent": "Find transfer loops of two to four transfers that start and end at account 7, where the last transfer happens within 60 days after the first transfer.",
      "manifest": "Find transfer loops of two to four transfers that start and end at a given account, where the last transfer happens within a given number of days after the first transfer.",
      "parameterized": {
        "parameterized_intent": "Find transfer loops of two to four transfers that start and end at account ?, where the last transfer happens within ? days after the first transfer.",
        "parameterized_sql": "GRAPH FinGraph MATCH TRAIL (src:Account {id: ?})-[sent:Transfers]->(:Account)-[:Transfers]->{0,2}(:Account)-[returned:Transfers]->(src) WHERE returned.create_time > sent.create_time AND TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) <= ? RETURN sent.amount AS amount_sent, returned.amount AS amount_returned, TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) AS days_to_return"
      }
    }
  ]
}
Cuando un usuario pregunta: "¿Se devolvió dinero enviado desde la cuenta 7 en un plazo de 60 días?", QueryData hace coincidir la pregunta con la plantilla (o, para una pregunta con diferentes valores de parámetros, como la cuenta 16 y 30 días, reemplaza los dos marcadores de posición ? en parameterized_sql) y ejecuta la siguiente consulta de GQL:
GRAPH FinGraph
MATCH TRAIL
  (src:Account {id: 7})-[sent:Transfers]->(:Account)
    -[:Transfers]->{0,2}(:Account)-[returned:Transfers]->(src)
WHERE returned.create_time > sent.create_time
  AND TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) <= 60
RETURN
  sent.amount AS amount_sent,
  returned.amount AS amount_returned,
  TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) AS days_to_return
Con los datos de muestra de FinGraph, esta consulta devuelve resultados similares a los siguientes:
+-------------+-----------------+----------------+
| amount_sent | amount_returned | days_to_return |
+-------------+-----------------+----------------+
| 300         | 500             | 36             |
+-------------+-----------------+----------------+
Campos de plantilla
Un objeto de plantilla contiene los siguientes campos:
| Campo | Requisito | Descripción |
|---|---|---|
nl_query |
Obligatorio | Una pregunta de ejemplo, expresada de la forma en que la haría un usuario (por ejemplo, "¿Se devolvió dinero enviado desde la cuenta 7 en un plazo de 60 días?"). |
sql |
Obligatorio | La consulta de GQL completa que responde nl_query. Inicia la consulta con GRAPH seguido del nombre de un grafo de propiedades que especifiques en el campo graph_ids de tus solicitudes QueryData, como GRAPH FinGraph. |
intent |
Obligatorio | Una descripción precisa de los resultados que devuelve sql. La pregunta de un usuario suele dejar condiciones sin especificar, y intent las especifica (por ejemplo, especificar que el dinero "regresó" significa "bucles de transferencia de dos a cuatro transferencias que comienzan y terminan en la cuenta 7, donde la última transferencia ocurre dentro de los 60 días posteriores a la primera transferencia"). |
manifest |
Obligatorio | Es una versión generalizada de intent que describe el tipo de pregunta que responde la plantilla, sin los valores específicos (por ejemplo, "cuenta 7" se convierte en "una cuenta determinada" y "60 días" se convierte en "una cantidad determinada de días"). QueryData recupera plantillas comparando la pregunta con el manifiesto. |
parameterized.parameterized_intent |
Opcional | La intent, con cada valor específico reemplazado por un marcador de posición ?. |
parameterized.parameterized_sql |
Opcional | La consulta sql, con cada valor específico reemplazado por un marcador de posición ? en el mismo orden que parameterized_intent. Cuando una pregunta coincide con la plantilla, QueryData reemplaza los marcadores de posición por los valores de la pregunta y ejecuta esta consulta. |
Si escribes el archivo de conjunto de contexto a mano, completa los cuatro campos obligatorios. La carga fallará con un error INVALID_ARGUMENT si alguno de ellos está vacío. El agente de ingeniería de contexto genera intent, manifest y parameterized a partir de tus pares de nl_query y sql. Revisa los valores generados y edítalos si un valor que debería permanecer fijo se reemplaza por un marcador de posición o si no se reemplaza un valor que debería variar.
Facetas de consulta
Una faceta es una cláusula de GQL reutilizable, como un patrón MATCH o una condición WHERE, que define un término o una condición empresarial. A diferencia de una plantilla, una faceta es una consulta parcial en lugar de una consulta completa, por lo que no comienza con una cláusula GRAPH y no está vinculada a una pregunta. Cuando QueryData genera una consulta nueva, aplica las facetas que son relevantes para la pregunta.
Ejemplo de faceta
En la siguiente configuración de facets, la primera faceta captura el patrón de las transferencias que involucran una cuenta bloqueada, y la segunda define una transferencia de alto riesgo como una transferencia de 200 o más a una cuenta bloqueada:
{
  "facets": [
    {
      "sql_snippet": "MATCH (account:Account)-[transfer:Transfers]-(:Account {is_blocked: true})",
      "intent": "transfers involving a blocked account, in either direction"
    },
    {
      "sql_snippet": "MATCH (account:Account)-[transfer:Transfers]->(blocked_account:Account {is_blocked: true}) WHERE transfer.amount >= 200",
      "intent": "high-risk transfers, which are transfers of 200 or more to a blocked account",
      "manifest": "high-risk transfers, which are transfers of a given amount or more to a blocked account",
      "parameterized": {
        "parameterized_intent": "high-risk transfers, which are transfers of ? or more to a blocked account",
        "parameterized_sql_snippet": "MATCH (account:Account)-[transfer:Transfers]->(blocked_account:Account {is_blocked: true}) WHERE transfer.amount >= ?"
      }
    }
  ]
}
Cuando un usuario pregunta "¿Cuántas transferencias de alto riesgo realizó Alex?", ninguna plantilla coincide con la pregunta. QueryData genera una nueva consulta de GQL y, además, incorpora la segunda faceta para contar las transferencias de 200 o más a una cuenta bloqueada:
GRAPH `FinGraph`
MATCH (p:`Person` {`name`: "Alex"})-[:`Owns`]->(src:`Account`)
      -[t:`Transfers`]->(dst:`Account` {`is_blocked`: true})
FILTER t.`amount` >= 200.0
RETURN COUNT(*) AS high_risk_transfer_count
Con los datos de muestra de FinGraph, esta consulta cuenta la transferencia de 300 de la cuenta 7 a la cuenta bloqueada 16 y devuelve resultados similares a los siguientes:
+--------------------------+
| high_risk_transfer_count |
+--------------------------+
| 1                        |
+--------------------------+
Campos de facetas
Un objeto de faceta usa la misma estructura que una plantilla de consulta, con las siguientes diferencias:
- No hay campo
nl_query. Las facetas no tienen un camponl_query, ya que describen una condición que aparece en muchas preguntas, en lugar de una sola. sql_snippeten lugar desql(obligatorio). Una cláusula de GQL, como un patrónMATCHo una condiciónWHERE. Para evitar ambigüedades, usa etiquetas de nodos y bordes, y nombres de variables explícitos, como(account:Account), para que QueryData pueda combinar la cláusula de GQL con el resto de la consulta.intent(obligatorio),manifest(opcional) yparameterized(opcional). Define el término o la condición empresarial de la misma manera que los campos de plantilla, excepto que QueryData hace coincidir las preguntas con elintent(por lo que debe ser descriptivo, ymanifestes opcional), yparameterizedcontieneparameterized_intentyparameterized_sql_snippet.
Búsquedas de valor
Una búsqueda de valores es una consulta, no una tabla de búsqueda. Antes de que QueryData genere una consulta de GQL, ejecuta tus búsquedas de valores una vez para cada frase de valor de la pregunta (un valor de texto, como un nombre, un sobrenombre o un país) y sustituye la frase por $value. Luego, usa los valores almacenados más cercanos que devuelven las consultas, junto con la propiedad de la que provienen, cuando escribe la consulta de GQL. Las búsquedas de valores no se ejecutan para números, fechas, horas ni importes de moneda.
Ejemplo de búsqueda de valor
Por ejemplo, en FinGraph, la cuenta 20 tiene el sobrenombre Rainy Day Fund, y la propiedad Person.country almacena Czech_Republic con un guion bajo. Las siguientes búsquedas de valores asignan frases de valor como "día lluvioso" a Rainy Day Fund en Account.nick_name y "República Checa" a Czech_Republic en Person.country:
{
  "value_searches": [
    {
      "query": "SELECT value, columns, concept_type, distance, context FROM GRAPH_TABLE(FinGraph MATCH (a:Account) WHERE STRPOS(LOWER(a.nick_name), LOWER($value)) > 0 RETURN DISTINCT a.nick_name AS value, 'FinGraph.Account.nick_name' AS columns, 'Account nickname' AS concept_type, 1 - LENGTH($value) / LENGTH(a.nick_name) AS distance, JSON '{}' AS context)",
      "concept_type": "Account nickname",
      "description": "Case-insensitive partial match on account nicknames. Distance is 0 for an exact match and grows as the phrase covers less of the nickname."
    },
    {
      "query": "SELECT value, columns, concept_type, distance, context FROM GRAPH_TABLE(FinGraph MATCH (p:Person) WHERE LOWER(REPLACE(p.country, '_', ' ')) = LOWER(REPLACE($value, '_', ' ')) RETURN DISTINCT p.country AS value, 'FinGraph.Person.country' AS columns, 'Person country' AS concept_type, 0 AS distance, JSON '{}' AS context)",
      "concept_type": "Person country",
      "description": "Match for country names on Person nodes that ignores case and treats underscores as spaces"
    }
  ]
}
La consulta Account nickname, con formato para facilitar la lectura, es la siguiente:
SELECT value, columns, concept_type, distance, context
FROM GRAPH_TABLE(
  FinGraph
  MATCH (a:Account)
  WHERE STRPOS(LOWER(a.nick_name), LOWER($value)) > 0
  RETURN DISTINCT
    a.nick_name AS value,
    'FinGraph.Account.nick_name' AS columns,
    'Account nickname' AS concept_type,
    1 - LENGTH($value) / LENGTH(a.nick_name) AS distance,
    JSON '{}' AS context
)
Cuando un usuario pregunta "¿Quién es el propietario de la cuenta de imprevistos?", QueryData ejecuta las búsquedas de valores con $value establecido en 'rainy day'. La búsqueda de Account nickname calcula distance a partir de la longitud de la frase en relación con la longitud del sobrenombre almacenado (mientras que una frase más amplia como "fondo" coincide con Vacation Fund en aproximadamente 0.69 y con Rainy Day Fund en aproximadamente 0.71, y una coincidencia exacta como "fondo para imprevistos" tiene una distancia de 0) y devuelve resultados similares a los siguientes:
+----------------+----------------------------+------------------+--------------------+---------+
| value          | columns                    | concept_type     | distance           | context |
+----------------+----------------------------+------------------+--------------------+---------+
| Rainy Day Fund | FinGraph.Account.nick_name | Account nickname | 0.3571428571428571 | {}      |
+----------------+----------------------------+------------------+--------------------+---------+
Luego, QueryData genera una consulta de GQL que filtra por {nick_name: 'Rainy Day Fund'} en lugar de {nick_name: 'rainy day'}:
GRAPH `FinGraph`
MATCH (p:`Person`)-[:`Owns`]->(a:`Account` {`nick_name`: 'Rainy Day Fund'})
RETURN DISTINCT SAFE_TO_JSON(p) AS person
Con los datos de muestra de FinGraph, esta consulta devuelve el nodo Person para Dana en formato JSON, similar al siguiente:
{
  "element_definition_name": "Person",
  "identifier": "kQKRBA==",
  "kind": "node",
  "labels": ["Person"],
  "properties": {
    "birthday": "1980-10-31T08:00:00Z",
    "city": "Moravia",
    "country": "Czech_Republic",
    "id": 2,
    "name": "Dana"
  }
}
Campos de búsqueda de valores y columnas SELECT obligatorias
Un objeto de búsqueda de valor contiene los siguientes campos:
| Campo | Requisito | Descripción |
|---|---|---|
query |
Obligatorio | Es una consulta de GoogleSQL que encuentra los valores almacenados que coinciden con una frase de valor. Usa $value donde va la frase. QueryData reemplaza $value por la frase como una cadena literal entre comillas, por lo que no debes encerrar $value entre comillas. Puedes usar $value más de una vez. Escribe la consulta como una sentencia SELECT sobre un operador GRAPH_TABLE que coincida con una etiqueta de nodo o de borde, compare una propiedad con $value y devuelva las cinco columnas de la siguiente tabla. |
concept_type |
Obligatorio | Es una etiqueta para el tipo de valor que encuentra la búsqueda, como Account nickname o Person country. |
description |
Opcional | Es una descripción de cómo la búsqueda hace coincidir los valores. |
Cada búsqueda de valor query debe mostrar las siguientes cinco columnas en este orden:
| Columna de salida | Descripción | Ejemplo FinGraph |
|---|---|---|
value |
Es el valor de la propiedad coincidente, tal como se almacena en la base de datos. | a.nick_name AS value ('Rainy Day Fund') |
columns |
Es la ubicación de la propiedad, en el formato GRAPH_NAME.LABEL.PROPERTY. QueryData pasa este valor al modelo como la ubicación del valor, por lo que debes usar un formato coherente. |
'FinGraph.Account.nick_name' AS columns |
concept_type |
Es una etiqueta para el tipo de valor. Usa la misma cadena que el campo concept_type de la búsqueda de valores: el campo etiqueta la búsqueda y la columna etiqueta cada coincidencia. |
'Account nickname' AS concept_type |
distance |
Indica qué tan lejos está el valor almacenado de la frase, en una escala que tú defines, en la que 0 es una coincidencia exacta. Por convención, usa valores de 0 a 1. QueryData ordena los candidatos de todas las búsquedas de valores por distance y conserva los 10 más cercanos. No aplica un umbral, por lo que debes excluir las coincidencias débiles en la consulta, por ejemplo, agregando WHERE distance < 1.0 a la sentencia SELECT externa. |
1 - LENGTH($value) / LENGTH(a.nick_name) AS distance |
context |
Es un valor JSON. QueryData no usa esta columna, pero debe estar presente con el mismo tipo en cada búsqueda de valores. Muestra JSON '{}'. |
JSON '{}' AS context |
Cómo QueryData ejecuta búsquedas de valores
QueryData no ejecuta búsquedas de valores de una en una. Para cada frase de valor en una pregunta, sustituye la frase por $value en cada búsqueda de valor, agrega ORDER BY distance LIMIT 10 a cada consulta, combina las consultas con UNION ALL y ejecuta el resultado como una sola instrucción de GoogleSQL que conserva las 10 coincidencias más cercanas. La consulta combinada es el motivo por el que las búsquedas de valores se escriben como sentencias SELECT sobre GRAPH_TABLE en lugar de sentencias de GQL independientes: GRAPH_TABLE ejecuta tu patrón de GQL MATCH como una tabla, y UNION ALL y el ORDER BY distance compartido son construcciones de SQL.
Este modelo de ejecución tiene las siguientes consecuencias para las consultas que escribes:
- No hay
ORDER BYniLIMITexternos. No agreguesORDER BYniLIMITa la sentenciaSELECTexterna. QueryData las agrega, y una cláusula duplicada hace que la sentencia falle. - Tipos de columnas compatibles. Cada búsqueda de valores en el archivo debe mostrar las mismas cinco columnas, en el mismo orden y con tipos compatibles. Por ejemplo, devuelve
JSON '{}'paracontexten todos ellos, no'{}'en algunos. - Marcador de posición
$valueobligatorio. La consulta debe contener$valueal menos una vez; de lo contrario, la carga fallará. - Solo valores de texto. Las búsquedas de valores solo se ejecutan para los valores de texto. QueryData no las ejecuta para números, fechas, horas ni importes de moneda.
Limitaciones
Los conjuntos de contexto para Spanner Graph tienen las siguientes limitaciones:
- Los conjuntos de contexto para bases de datos solo admiten plantillas de consulta, facetas de consulta y búsquedas de valores.
- Los conjuntos de contexto para bases de datos solo los usa el extremo
QueryDataen la API de Conversational Analytics.
¿Qué sigue?
- Obtén más información para crear o borrar un conjunto de contexto en Spanner Studio.
- Obtén más información para crear conjuntos de información contextual con el agente de ingeniería de contexto.