


En este documento, se describe cómo crear y optimizar los conjuntos de información contextual que ayudan a lograr una alta precisión de QueryData para tus aplicaciones de agentes de datos de Spanner Graph. El agente de ingeniería de contexto te ayuda a compilar, evaluar y mejorar los conjuntos de contexto de Graph Query Language (GQL) automatizando su creación y optimización.
Para obtener información sobre los conjuntos de contexto y QueryData para Spanner Graph, consulta Descripción general de los conjuntos de contexto y Descripción general de QueryData.
Para compilar aplicaciones de datos de grafos empresariales, la exactitud de la traducción de lenguaje natural a GQL suele necesitar alcanzar una calidad cercana al 100%. Los patrones de recorrido de grafos incorrectos o la falta de filtros de bordes afectan la usabilidad de la aplicación y la experiencia del usuario. Para obtener respuestas explicables y relevantes para la empresa con una alta precisión, se requiere la ingeniería de contexto, que es el proceso de crear y optimizar de forma iterativa el conjunto de contexto.
Si proporcionas a QueryData un contexto orientado a tu esquema de Spanner Graph y a tu aplicación empresarial, proporcionas las reglas precisas de recorrido de grafos y las definiciones de dominio que el sistema necesita para resolver la intención del usuario con matices.
En los ejemplos de este documento, se usa el esquema de grafo de propiedades FinGraph y el conjunto de datos de muestra (nodos Person y Account conectados por bordes Owns y Transfers). Para crear el esquema FinGraph y, luego, insertar los datos de muestra, consulta Configura y consulta Spanner Graph.
Agente de ingeniería de contexto
El agente de ingeniería de contexto automatiza el flujo de trabajo de ingeniería de contexto: genera conjuntos de datos de evaluación, inicia un conjunto de contexto y lo mejora de forma iterativa.
En la siguiente lista, se proporcionan ejemplos de instrucciones en lenguaje natural para indicarle al agente qué hacer, junto con una descripción de cómo responde el agente:
- Instrucción de ejemplo para la sugerencia de contexto: "Lee mi documento de aplicación para el grafo de propiedades
FinGraphen mi base de datos de Spanner y sugiere elementos de contexto de GQL para agregar". El agente analiza los documentos de la aplicación del conjunto de datos que proporcionas, asigna reglas empresariales a las etiquetas de nodos y bordes deFinGraph, y sugiere plantillas y facetas de GQL. - Ejemplo de instrucción para el análisis de brechas cuando las preguntas de los usuarios no devuelven los resultados esperados: "Cuando los usuarios preguntan 'transferencias de la cuenta de ahorros', QueryData filtra por
nick_name = 'rainy day account'y no devuelve nada. Actualiza el contexto del grafo de propiedadesFinGraphen mi base de datos de Spanner para que esta pregunta se responda correctamente". El agente inspecciona el esquema, identifica que el sobrenombre se almacena comoRainy Day Fundy recomienda una búsqueda de valores enAccount.nick_name(o una plantilla o faceta si el patrón es el problema). Instrucción de ejemplo para el procesamiento masivo: "Aquí tienes preguntas en lenguaje natural y consultas en GQL para el grafo de propiedades
FinGraphen mi base de datos de Spanner. Conviértelos en plantillas:- Encuentra a todas las personas a las que Dana les transfirió dinero, con los importes:
GRAPH FinGraph MATCH (:Person {name: 'Dana'})-[:Owns]->(:Account)-[transfer:Transfers]->(:Account)<-[:Owns]-(to_person:Person) RETURN to_person.name AS recipient, transfer.amount AS amount - ¿Qué transferencias de alto riesgo realizó Alex?
GRAPH FinGraph MATCH (:Person {name: 'Alex'})-[:Owns]->(src:Account)-[t:Transfers]->(dst:Account {is_blocked: true}) WHERE t.amount >= 200 RETURN dst.id AS destination_account_id, t.amount AS transfer_amount"
El agente procesa tus entradas de forma masiva, reemplaza los valores literales por marcadores de posición
?y actualiza el archivo de conjunto de contexto.- Encuentra a todas las personas a las que Dana les transfirió dinero, con los importes:
Importancia del conjunto de datos de referencia
Para optimizar tu contexto, primero debes crear un conjunto de datos de referencia que coincida con las entradas de lenguaje natural de tu aplicación. El agente puede ayudarte a crear este conjunto de datos de referencia, que consiste en preguntas de los usuarios vinculadas con sus consultas de GQL esperadas. Un conjunto de datos de referencia te permite hacer lo siguiente:
- Establece un modelo de referencia para el rendimiento de las consultas de lenguaje natural a GQL.
- Valida las actualizaciones de contexto con las consultas de GQL de verdad fundamental.
- Mide las mejoras de precisión en las iteraciones de optimización.
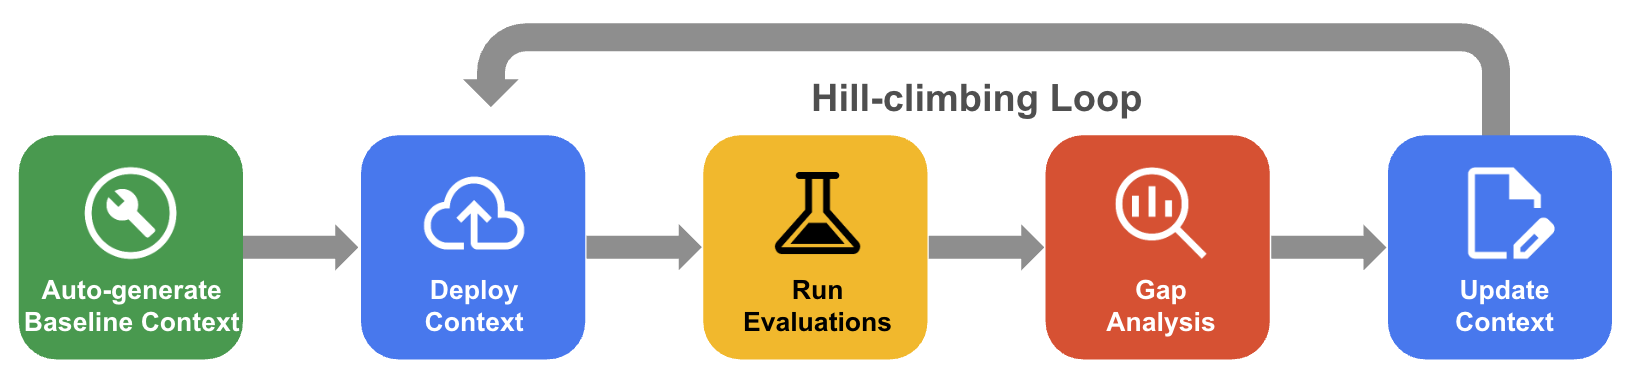
El proceso sistemático de ascenso de colinas
En la escalada sistemática, el agente mejora de forma iterativa un conjunto de contexto a través de la evaluación del conjunto de datos de referencia, el análisis de brechas y la actualización del contexto de GQL orientada para aumentar la exactitud a casi el 100%:
- Genera automáticamente el contexto de referencia: Crea un conjunto de contexto de GQL inicial derivado del esquema de grafo de propiedades de Spanner Graph y los artefactos de la aplicación.
- Flujo de trabajo de optimización de ascenso de colinas: Permite que el agente evalúe la exactitud de tus QueryData con
graph_idsconfigurado, realice un análisis de brechas en las consultas de GQL con errores y proponga mejoras automáticamente para aumentar la exactitud.
En el siguiente diagrama, se muestra el flujo de trabajo sistemático de ascenso de colinas:
Antes de comenzar
Completa los siguientes requisitos previos antes de usar el agente de ingeniería de contexto:
Habilita los servicios obligatorios
Habilita los siguientes servicios para tu proyecto:Prepara una instancia de Spanner
- Asegúrate de que haya una instancia de Spanner disponible. Para obtener más información, consulta Crea una instancia.
- Asegúrate de crear una base de datos en tu instancia en la que crearás las tablas. Para obtener más información, consulta Crea una base de datos en la instancia de Spanner.
Roles y permisos requeridos
- Agrega un usuario o una cuenta de servicio de IAM a la instancia. Para obtener más información, consulta Aplica roles de IAM.
- Otorga los roles
roles/spanner.databaseReader,roles/serviceusage.serviceUsageConsumeryroles/geminidataanalytics.queryDataUseral usuario de IAM a nivel del proyecto. Para obtener más información, consulta Agrega una vinculación de política de IAM para un proyecto. - Para crear, subir y administrar conjuntos de contexto, otorga el rol de editor de Dataplex Catalog (
roles/dataplex.catalogEditor) o de administrador de Dataplex Catalog (roles/dataplex.catalogAdmin) al usuario de IAM a nivel del proyecto. Para obtener más información, consulta El contexto establece permisos. - Otorga roles y permisos al usuario de IAM a nivel de proyecto para las bases de datos requeridas.
Para configurar el esquema del grafo de propiedades FinGraph y, luego, insertar los datos del grafo de muestra que se usan en esta guía, sigue los pasos que se indican en Configura y consulta Spanner Graph.
Prepara el entorno
Puedes compilar archivos de conjuntos de contexto desde cualquier entorno de desarrollo o IDE local. Para preparar tu entorno, completa los siguientes pasos:
- Instala el agente de ingeniería de contexto.
- Configura la conexión de la base de datos a Spanner Graph.
Instala el agente de ingeniería de contexto
El agente de ingeniería de contexto ejecuta un servidor del Protocolo de contexto del modelo (MCP) que requiere uv para administrar los paquetes de Python subyacentes.
- Instala
uvsiguiendo las instrucciones que se indican en Instalauv. Verifica que
uvesté instalado y que se pueda acceder a él desde la línea de comandos:uv --version
Para preparar tu entorno, instala el agente de ingeniería de contexto en el arnés de agentes que elijas, como la CLI de Antigravity, Claude Code o la CLI de Gemini.
Según el arnés de agentes que hayas seleccionado, sigue los pasos de instalación correspondientes:
CLI de Antigravity
Para instalar el agente de ingeniería de contexto en la CLI de Antigravity, sigue estos pasos:
- Instala la CLI de Antigravity. Consulta Comienza a usar la CLI de Antigravity.
- Instala el complemento del agente de ingeniería de contexto, que incluye flujos de trabajo para la generación de contexto:
agy plugin install https://github.com/GoogleCloudPlatform/db-context-enrichment/tree/main/plugin
- Inicia la CLI de Antigravity:
agy
- Actualiza el complemento:
agy plugin uninstall google-cloud-db-context-engineering
agy plugin install https://github.com/GoogleCloudPlatform/db-context-enrichment/tree/main/plugin
Claude Code
Para instalar el agente de ingeniería de contexto en Claude Code, sigue estos pasos:
- Agrega el mercado de complementos:
/plugin marketplace add https://github.com/GoogleCloudPlatform/db-context-enrichment.git
- Instala el complemento:
/plugin install db-context-engineering@db-context-enrichment-marketplace
- Vuelve a cargar los complementos para activar los cambios:
/reload-plugins
- Actualiza el complemento:
/plugin update db-context-engineering@db-context-enrichment-marketplace
Gemini CLI (obsoleto)
Para instalar el agente de ingeniería de contexto en la CLI de Gemini, sigue estos pasos:
- Instalar la CLI de Gemini Consulta Comienza a usar Gemini CLI.
- Instala la extensión:
gemini extensions install https://github.com/GoogleCloudPlatform/db-context-enrichment
- Actualiza la extensión:
gemini extensions update mcp-db-context-enrichment
Configura la conexión de la base de datos
El agente requiere una conexión de base de datos para recuperar esquemas de grafos de propiedades (spanner-list-graphs), inspeccionar tablas subyacentes (spanner-list-tables) y validar la sintaxis de las consultas de GQL y SQL generadas (spanner-execute-sql). Para permitir que el agente interactúe con el grafo de propiedades en tu base de datos de Spanner, configura las credenciales de autenticación y define la configuración de la conexión de la base de datos.
Configura las credenciales predeterminadas de la aplicación
Configura las credenciales predeterminadas de la aplicación (ADC) para proporcionar credenciales de usuario que permitan acceder a los recursos de Google Cloud desde el agente de ingeniería de contexto:
- Servidor de MCP de Toolbox: Usa credenciales para conectarse a tu base de datos de Spanner, recuperar esquemas de grafos de propiedades y ejecutar consultas de GQL para la validación.
- Evalbench: Usa credenciales para llamar a la API de REST de
QueryDatacongraph_idsy ejecutar el evaluador de LLM en Vertex AI durante la evaluación.
Ejecuta el siguiente comando en la terminal para autenticarte:
gcloud auth application-default loginConfigura el archivo de conexión de la base de datos
El agente requiere una conexión de base de datos para la generación de contexto, que MCP Toolbox admite y define dentro de un archivo de configuración (autoctx/tools.yaml), junto con un rastreador de estado (autoctx/state.md) que registra los nombres de los grafos de propiedades activos (como FinGraph).
- Inicia el entorno de tu agente.
Pídele al agente que configure la conexión de la base de datos para tu base de datos de Spanner y especifica el nombre del grafo de propiedades. Por ejemplo, ingresa la siguiente instrucción:
Help me set up the database connection for my Spanner database with the FinGraph property graph.Sigue las instrucciones del agente para proporcionar el ID del proyecto, el ID de la instancia de Spanner, el ID de la base de datos y el nombre del grafo de propiedades (
FinGraph). El agente creaautoctx/tools.yaml(con las herramientasspanner-list-graphs,spanner-list-tablesyspanner-execute-sql) yautoctx/state.md.Abre
autoctx/state.mdy verifica que la sección## Active Databaseincluya tu grafo de propiedades en el siguiente formato:- **Graph Ids**: ["FinGraph"]El flujo de trabajo de evaluación lee los IDs de los grafos de propiedades solo de esta línea. Si falta la línea, está vacía (
[]) o no tiene este formato, la evaluación llama a QueryData singraph_ids, y QueryData genera SQL relacional en lugar de GQL.Para aplicar la nueva configuración de
tools.yaml, vuelve a cargar la conexión:- En la CLI de Antigravity, ejecuta
/mcpy seleccionatoolboxpara reiniciar. - En Gemini CLI, ejecuta
/mcp reload. - En Claude Code, ejecuta
/mcp, seleccionatoolboxy, luego,Reconnect.
- En la CLI de Antigravity, ejecuta
Para obtener más información sobre cómo configurar manualmente el archivo de configuración de la base de datos, consulta Configuración de MCP Toolbox.
Genera y optimiza el contexto
El agente de ingeniería de contexto proporciona un conjunto de habilidades de agente y herramientas de MCP para generar un conjunto de contexto de GQL de referencia, medir la eficacia en comparación con un conjunto de datos de GQL de referencia y aplicar mejoras de forma iterativa. Puedes comenzar en cualquier etapa del flujo de trabajo:
- Si ya tienes un conjunto de contexto, puedes continuar directamente con la evaluación.
- Si tienes consultas de GQL con errores que quieres corregir, puedes continuar directamente con el análisis de brechas.
En cualquier etapa, recuérdale al agente que el destino es un grafo de propiedades en tu base de datos de Spanner y asígnale un nombre (como FinGraph) para que permanezca en el flujo de trabajo específico de GQL.
Crea y expande conjuntos de datos de evaluación
Para mejorar el rendimiento, primero debes medirlo. Un conjunto de datos de referencia es un conjunto de preguntas de los usuarios vinculadas con sus consultas de GQL esperadas. Sin uno, la ingeniería de contexto carece de verificación sistemática; con uno, cada cambio de contexto es una mejora medible que puedes validar con respecto a la verdad fundamental.
Crear un conjunto de datos de referencia representativo de forma manual lleva mucho tiempo, y es posible que los conjuntos de datos pequeños no incluyan variaciones en las frases de los usuarios. El agente resuelve este problema de la siguiente manera:
- Generar pares de preguntas en lenguaje natural y consultas de GQL candidatos en función del esquema de tu grafo de propiedades
- Expandir un conjunto de datos de origen con variaciones de filtros, sinónimos y reformulaciones de rutas de acceso de varios saltos.
- Ejecutar las consultas de GQL generadas en tu base de datos de Spanner para confirmar que cada consulta se ejecute sin problemas y devuelva resultados válidos.
Según las consultas de FinGraph en la descripción general de las consultas de Spanner Graph, el conjunto de datos de referencia (autoctx/golden.json) es un archivo JSON que contiene pares de preguntas en lenguaje natural y GQL, como los siguientes:
[
  {
    "id": "fingraph_001",
    "database": "example-db",
    "nlq": "Find everyone that Dana transferred money to, along with the account IDs and transfer amounts.",
    "golden_sql": "GRAPH FinGraph MATCH (from_person:Person {name: 'Dana'})-[:Owns]->(from_account:Account)-[transfer:Transfers]->(to_account:Account)<-[:Owns]-(to_person:Person) RETURN to_person.name AS to_account_owner, to_account.id AS to_account_id, transfer.amount AS amount;"
  },
  {
    "id": "fingraph_002",
    "database": "example-db",
    "nlq": "Find all money transfers involving a blocked account.",
    "golden_sql": "GRAPH FinGraph MATCH (account:Account)-[transfer:Transfers]-(:Account {is_blocked: true}) RETURN transfer.order_number, transfer.amount;"
  },
  {
    "id": "fingraph_003",
    "database": "example-db",
    "nlq": "Find destination accounts that are 1 to 3 transfers away from account 7, and show the path length.",
    "golden_sql": "GRAPH FinGraph MATCH (src:Account {id: 7})-[e:Transfers]->{1, 3}(dst:Account) WHERE src != dst RETURN dst.id AS dst_account_id, ARRAY_LENGTH(e) AS path_length;"
  },
  {
    "id": "fingraph_004",
    "database": "example-db",
    "nlq": "Find all high-risk transfers initiated by Alex.",
    "golden_sql": "GRAPH FinGraph MATCH (p:Person {name: 'Alex'})-[:Owns]->(src:Account)-[t:Transfers]->(dst:Account {is_blocked: true}) WHERE t.amount >= 200 RETURN dst.id AS destination_account_id, t.amount AS transfer_amount ORDER BY t.amount DESC;"
  }
]
Los pares aprobados se propagan en el archivo autoctx/golden.json de tu espacio de trabajo, donde están listos para la evaluación. En cada entrada, database debe coincidir con el ID de tu base de datos de Spanner (como example-db).
Puedes usar los siguientes ejemplos de instrucciones para indicarle al agente, especificando que FinGraph es un grafo de propiedades en tu base de datos de Spanner:
- "Genera un conjunto de datos de evaluación de GQL a partir del grafo de propiedades
FinGraphen mi base de datos de Spanner". - "Aquí tienes una pregunta inicial y una consulta de GQL para el grafo de propiedades
FinGraphen mi base de datos de Spanner. Expándelo a un conjunto de datos de evaluación de GQL más amplio y verifica que las consultas se ejecuten".
Genera un conjunto de información contextual de referencia
Para evitar crear el contexto desde cero, puedes permitir que el agente derive un conjunto de contexto de GQL inicial (bootstrap_context.json) a partir del esquema de grafo de propiedades y los artefactos de la aplicación, como las reglas empresariales, las consultas de GQL de muestra o los documentos de diseño. Debido a que tu conjunto de datos es un grafo de propiedades en tu base de datos de Spanner, el agente prefiere los patrones de GQL (GRAPH FinGraph MATCH ...) en lugar de las uniones de SQL relacionales cuando genera plantillas y facetas.
Puedes usar los siguientes ejemplos de instrucciones para indicarle al agente lo que debe hacer:
- "Genera un conjunto de contexto de GQL de referencia a partir del grafo de propiedades
FinGraphen mi base de datos de Spanner". - "Genera el contexto inicial de GQL para el grafo de propiedades
FinGraphen mi base de datos de Spanner con el esquema del grafo de propiedades y las reglas empresariales derequirements.md".
El agente te solicita que asignes un nombre al experimento (por ejemplo, fingraph_tuning), que organiza los artefactos generados en autoctx/experiments/fingraph_tuning/. Después de que el agente genere bootstrap_context.json, sigue las instrucciones que se indican en Administra conjuntos de contexto en Spanner Studio para subir el archivo del conjunto de contexto.
Evalúa la eficacia del contexto
Después de establecer un conjunto de contexto y un conjunto de datos de referencia, puedes permitir que el agente mida el rendimiento del contexto consultando la API de QueryData con cada pregunta de referencia. El agente compara el GQL generado y los resultados de la ejecución con las respuestas de referencia esperadas usando Evalbench.
Para Spanner Graph, la evaluación llama directamente a la API de REST de QueryData para que cada solicitud pueda incluir graph_ids.
Cuando autoctx/state.md contiene - **Graph Ids**: ["FinGraph"], el agente genera un archivo de configuración del modelo de Evalbench (autoctx/experiments/fingraph_tuning/eval_configs/model_config.yaml) que usa la API de REST y que incluye graph_ids en spanner_reference.database_reference, similar a lo siguiente:
generator: query_data_api
project_id: PROJECT_ID
location: global
use_rest_api: true
context:
  datasource_references:
    spanner_reference:
      database_reference:
        engine: GOOGLE_SQL
        project_id: PROJECT_ID
        instance_id: INSTANCE_ID
        database_id: DATABASE_ID
        graph_ids:
        - FinGraph
      agent_context_reference:
        context_set_id: projects/PROJECT_ID/locations/REGION/contextSets/CONTEXT_SET_ID
Antes de ejecutar una evaluación, abre model_config.yaml y verifica que use_rest_api sea true y que graph_ids enumere tu grafo de propiedades.
La ejecución de una evaluación proporciona lo siguiente:
- Métricas cuantitativas, como los resultados de aprobación y reprobación, y las puntuaciones agregadas, para hacer un seguimiento del progreso en las iteraciones de contexto de GQL
- Un resumen de la conversación intercalado y los informes detallados en formato CSV escritos en el directorio
eval_reports/de la carpeta del experimento.
Para iniciar una evaluación, proporciona la ruta del conjunto de datos de referencia (autoctx/golden.json) y el ID del conjunto de contexto. Para obtener información sobre cómo encontrar el ID del conjunto de contexto, consulta Cómo encontrar el ID del conjunto de contexto.
Puedes usar los siguientes ejemplos de instrucciones para indicarle al agente lo que debe hacer:
- "Evalúa mi contexto para el grafo de propiedades FinGraph en mi base de datos de Spanner en relación con
autoctx/golden.json. Llama a la API de REST de QueryData congraph_idsestablecido enFinGraph." - "Vuelve a ejecutar la evaluación del grafo de propiedades FinGraph en mi base de datos de Spanner con la configuración de mi último experimento".
Para volver a ejecutar una configuración de evaluación generada anteriormente directamente desde la raíz de tu espacio de trabajo, ejecuta el siguiente comando:
uvx google-evalbench --experiment_config=autoctx/experiments/fingraph_tuning/eval_configs/run_config.yamlPara obtener detalles sobre el esquema de configuración de la evaluación y cómo personalizar las ejecuciones de evaluación, consulta la documentación de Evalbench.
Realizar un análisis de brechas y proponer mejoras
Para resolver las fallas de las consultas de GQL, identifica sus causas raíz, como las siguientes:
- Direcciones de aristas invertidas (
-[:Owns]->en comparación con<-[:Owns]-) - Faltan límites de ruta cuantificados (
->{1, 3}) - Definiciones de empresas sin asignar (como
high-risk transfers) - Valores de propiedad sin resolver
Para ver la sintaxis de las consultas, consulta Descripción general de las consultas de Spanner Graph y la referencia de GQL.
El agente automatiza este bucle de análisis y corrección para el grafo de propiedades en tu base de datos de Spanner:
- Análisis de brechas: El agente lee los resultados de la evaluación y tu conjunto de contexto para agrupar fallas similares de GQL y recomendar adiciones específicas, como plantillas de GQL, facetas o búsquedas de valores de
GRAPH_TABLEen propiedades de nodos y bordes. - Correcciones propuestas: El agente propone ediciones concretas del contexto de GQL y prueba el GQL generado en tu base de datos de Spanner con
spanner-execute-sqlpara verificar la resolución. - Conservación del modelo de referencia: El agente escribe las mejoras en un archivo JSON nuevo (
improved_context_v1.json) junto con el contexto del modelo de referencia, lo que conserva los archivos originales.
Puedes usar las siguientes instrucciones de ejemplo para indicarle al agente, especificando que el conjunto de datos es un grafo de propiedades en tu base de datos de Spanner, que active el flujo de trabajo de ingeniería de contexto específico de GQL:
- "Ejecuta un análisis de brechas en mi última evaluación del grafo de propiedades de FinGraph en mi base de datos de Spanner y propón correcciones de contexto de GQL".
- "Optimiza este conjunto de contexto para el grafo de propiedades de FinGraph en mi base de datos de Spanner en función de
autoctx/golden.json".
Para prepararte para la próxima iteración, sube el archivo de conjunto de contexto mejorado (improved_context_v1.json) al conjunto de contexto de destino en Spanner Studio siguiendo las instrucciones que se indican en Edita un conjunto de contexto.
Crea elementos de contexto específicos a pedido
Si ya conoces el elemento de contexto que necesitas (como una plantilla de GQL para un recorrido de grafo específico, una faceta para un filtro de aristas repetidas o una búsqueda de valor GRAPH_TABLE en una propiedad de nodo o arista), el agente puede generar el objeto JSON con los parámetros adecuados a pedido sin ejecutar una evaluación completa.
Puedes usar las siguientes instrucciones de ejemplo para indicarle al agente que cree el grafo de propiedades en tu base de datos de Spanner:
- "Para el grafo de propiedades FinGraph en mi base de datos de Spanner, crea una plantilla para: 'Encuentra todas las transferencias de alto riesgo iniciadas por Alex' con la consulta de GQL:
GRAPH FinGraph MATCH (p:Person {name: 'Alex'})-[:Owns]->(src:Account)-[t:Transfers]->(dst:Account {is_blocked: true}) WHERE t.amount >= 200 RETURN dst.id AS destination_account_id, t.amount AS transfer_amount ORDER BY t.amount DESC;". - "Para el grafo de propiedades FinGraph en mi base de datos de Spanner, crea una faceta para la cláusula de GQL
MATCH (account:Account)-[transfer:Transfers]-(:Account {is_blocked: true})etiquetada como 'transferencias que involucran una cuenta bloqueada'". - "Para el grafo de propiedades FinGraph en mi base de datos de Spanner, crea una búsqueda de valores de
GRAPH_TABLEen la propiedadnick_namede los nodosAccountcon el tipo de concepto 'Alias de la cuenta' que coincida con los alias sin distinguir mayúsculas de minúsculas".
Razona sobre la selección del tipo de contexto
Seleccionar el tipo de contexto adecuado (una plantilla de GQL, una faceta o una búsqueda de valores) ayuda a evitar el exceso de contexto y las regresiones de consultas. Puedes pedirle al agente que recomiende el tipo de contexto adecuado según tus patrones de consulta:
- "En el grafo de propiedades de FinGraph de mi base de datos de Spanner, sigo filtrando las transferencias que involucran cuentas bloqueadas con
MATCH (account:Account)-[transfer:Transfers]-(:Account {is_blocked: true})en muchas consultas de GQL. ¿Cuál es la mejor manera de capturar esto?" - "Los usuarios se refieren a las cuentas en el grafo de propiedades FinGraph de mi base de datos de Spanner con sobrenombres como 'Fondo de vacaciones' o 'Fondo de emergencia'. ¿Qué tipo de búsqueda de valor de
GRAPH_TABLEdebo configurar enAccount.nick_name?" - "¿Cuál es la diferencia entre una plantilla de GQL y una faceta en un conjunto de contexto para Spanner Graph, y cuándo debo usar cada una?"
Aplicar operaciones masivas en un conjunto de contextos
El agente admite actualizaciones masivas para administrar conjuntos de contexto de GQL grandes de manera coherente, como cuando se actualiza una etiqueta de grafo de propiedades o cambia un umbral empresarial en varias plantillas y facetas:
- "Lee
golden.jsonpara el grafo de propiedades de FinGraph en mi base de datos de Spanner y convierte todos los pares de pregunta y GQL en plantillas". - "En
context_set.jsonpara el grafo de propiedades FinGraph en mi base de datos de Spanner, reemplazat.amount >= 200port.amount >= 300para cualquier elemento de GQL que haga referencia a 'transferencias de alto riesgo'. No toques los elementos no relacionados".
¿Qué sigue?
- Obtén más información sobre los conjuntos de contexto.
- Obtén más información para crear o borrar un conjunto de contexto en Spanner Studio.
- Aprende a probar QueryData para Spanner Graph.
- Sigue el instructivo de extremo a extremo para integrar QueryData en una aplicación.