


Ein Kontextset ist eine Sammlung von Anleitungen, mit denen Tools wie QueryData genaue GQL-Abfragen (Graph Query Language) für den Eigenschaftsgraphen in Ihrer Spanner-Datenbank generieren können. QueryData liest Ihr Eigenschaftsgrafikschema direkt aus der Datenbank. Ein Kontextset fügt hinzu, was das Schema nicht erfasst: die Bedeutung Ihrer Geschäftsbegriffe, verifizierte Abfragen für die Fragen, die Ihre Nutzer häufig stellen, und wie Nutzer auf die Werte verweisen, die in Ihrem Graphen gespeichert sind. Sie müssen Ihr Graphschema nicht in einem Kontextset neu definieren.
Die folgenden Datenbanken werden von QueryData unterstützt:
- AlloyDB for PostgreSQL
- Cloud SQL for MySQL
- Cloud SQL for PostgreSQL
- Spanner (einschließlich Spanner Graph)
- Firestore mit MongoDB-Kompatibilität
Informationen zur Verwendung von Kontextgruppen mit relationalen Spanner-Tabellen anstelle von Spanner Graph finden Sie unter Kontextgruppen für Spanner – Übersicht.
Sie definieren den Kontext in einer JSON-Datei, die drei Arten von Objekten enthält: Abfragevorlagen, Abfrageattribute und Wertsuchen. Sie können diese Datei mithilfe des Kontext-Engineering-Agenten erstellen und dann in ein Kontextset hochladen, das Sie in Spanner Studio erstellen. QueryData verwendet das Kontextset, wenn eine QueryData-Anfrage im Feld agent_context_reference.context_set_id darauf verweist.
Sie können Kontextgruppen in den Regionen us-central1, us-east1, europe-west4 und asia-southeast1 erstellen. Die Region eines Kontextsets muss nicht mit dem Standort übereinstimmen, den Sie in QueryData-Anfragen verwenden, z. B. locations/global.
In den Beispielen in diesem Dokument wird das Eigenschaftsgrafikschema FinGraph verwendet (Person- und Account-Knoten, die durch Owns- und Transfers-Kanten verbunden sind). Informationen zum Einrichten des FinGraph-Property-Graphen in Ihrer Spanner-Datenbank und zum Einfügen von Beispieldaten finden Sie unter Spanner Graph einrichten und abfragen.
So verwendet QueryData ein Kontextset
Ein Kontextset kann drei Arten von Kontext enthalten. Jeder Typ löst ein anderes Problem und QueryData kann sie unabhängig voneinander oder zusammen verwenden:
| Kontexttyp | Ihr Beitrag | Verwendung | Verwendung durch QueryData | FinGraph-Beispiel |
|---|---|---|---|---|
| Abfragevorlage | Eine vollständige, verifizierte GQL-Abfrage für einen Fragetyp mit ?-Platzhaltern für die Werte, die sich ändern. |
Nutzer stellen dieselbe Frage wiederholt mit unterschiedlichen Parameterwerten, insbesondere wenn die Abfrage komplex zu generieren ist (z. B. ein Pfadmuster mit mehreren Hops). | Die sql-Abfrage wird direkt für eine genaue Übereinstimmung wiederverwendet oder Parameter werden in parameterized_sql ersetzt, wenn die Frage mit der Vorlage übereinstimmt. |
„Wurde Geld, das von Konto 7 gesendet wurde, innerhalb von 60 Tagen zurückgebucht?“ |
| Abfrage-Facet | Eine wiederverwendbare GQL-Klausel, z. B. ein MATCH-Muster oder eine WHERE-Bedingung, die einen geschäftlichen Begriff oder eine geschäftliche Bedingung definiert. |
Eine wiederverwendbare Bedingung oder ein wiederverwendbares Muster wird in vielen verschiedenen Fragen verwendet. | Die definierte GQL-Klausel wird beim Generieren einer neuen GQL-Abfrage einbezogen. | Eine Überweisung mit hohem Risiko ist eine Überweisung von mindestens 200 auf ein gesperrtes Konto. |
| Wertsuche | Eine Abfrage, die gespeicherte Attributwerte findet, die mit einer Wortgruppe in der Frage des Nutzers übereinstimmen. | Nutzer beziehen sich auf Werte mit Namen oder Schreibweisen, die sich von der Speicherung im Graphen unterscheiden. | Führt die Suchanfrage mit der Wertphrase aus, bevor die GQL-Abfrage generiert wird, und filtert dann nach dem aufgelösten gespeicherten Wert und der Property. | „Regentag“ bezieht sich auf Rainy Day Fund in Account.nick_name. |
Das folgende Diagramm zeigt, wie QueryData eine Frage mithilfe eines Kontextsets verarbeitet:
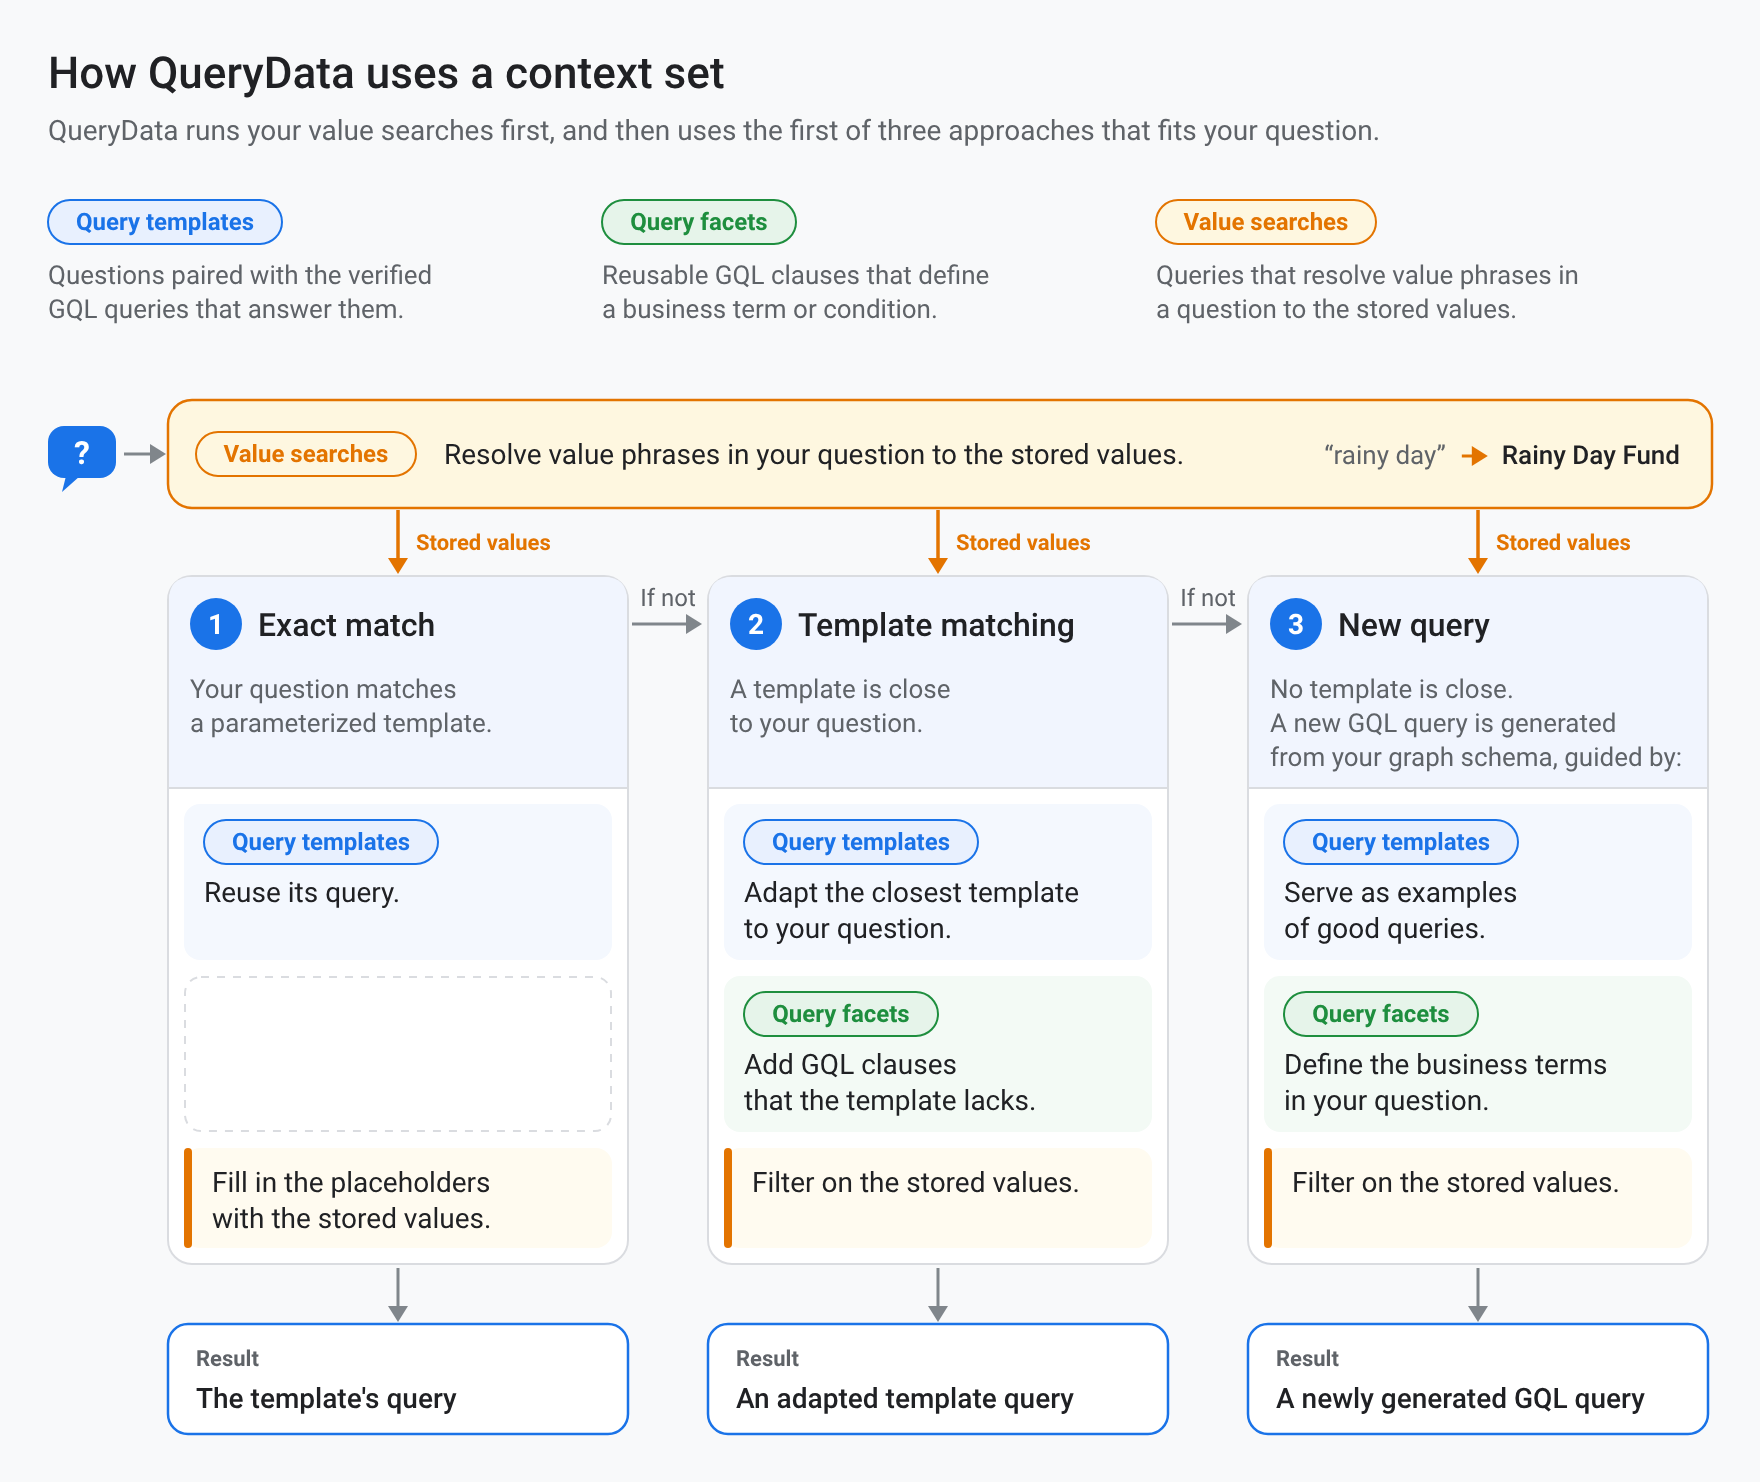
Wie im Diagramm dargestellt, verwendet QueryData Ihr Kontextset in der folgenden Reihenfolge, wenn eine Frage eingeht:
- Relevanter Kontext wird abgerufen. QueryData ruft die Vorlagen, Facetten und Wertesuchen ab, die der Frage am ähnlichsten sind.
- Wertsuche ausführen Für jede Wortgruppe mit einem Wert in der Frage, z. B. einen Namen oder Spitznamen, führt QueryData Ihre Wertesuchen aus, um die übereinstimmenden gespeicherten Werte zu finden. Die Suche nach Werten funktioniert nicht für Zahlen, Datumsangaben, Uhrzeiten oder Währungsbeträge.
- Mit Abfragevorlagen abgleichen Wenn die Frage mit einer Vorlage übereinstimmt, verwendet QueryData die verifizierte GQL-Abfrage der Vorlage. Bei einer genauen Übereinstimmung mit
nl_queryführt QueryData die Abfragesqldirekt aus. Bei einer Übereinstimmung mit einer parametrisierten Vorlage ersetzt QueryData die?-Platzhalter inparameterized_sqldurch die Werte aus der Frage und führt die resultierende Abfrage aus. - Neue GQL-Abfrage generieren Andernfalls generiert QueryData eine neue GQL-Abfrage aus Ihrem Graphschema. Die relevanten Facetten werden als Geschäftsregeln angewendet, die relevanten Vorlagen als Beispiele verwendet und die gespeicherten Werte, die bei der Wertsuche gefunden wurden, werden verwendet.
Dateiformat des Kontextsets
Eine Datei mit einem Kontextset ist ein JSON-Objekt mit drei Array-Feldern (templates, facets und value_searches) für die in den folgenden Abschnitten beschriebenen Kontextelemente. Eine leere Kontextsatzdatei hat die folgende Struktur:
{
  "templates": [],
  "facets": [],
  "value_searches": []
}
Sie können eine beliebige Kombination dieser Felder verwenden und die Felder weglassen, die Sie nicht verwenden. Ein guter Ausgangspunkt für Spanner Graph ist es, eine Vorlage für jede Multi-Hop- oder zeitlich begrenzte Frage zu erstellen, die eine bestimmte Abfragestruktur erfordert, eine Facette für jeden Geschäftsbegriff, der in mehreren Fragen vorkommt, und eine Wertsuche für jede Texteigenschaft, auf die Nutzer namentlich verweisen (z. B. Namen, Spitznamen oder Länder).
Beachten Sie beim Bearbeiten einer Kontextsatzdatei die folgenden Regeln:
- Einzeilige Abfragestrings. Die Werte von
sql,parameterized_sql,sql_snippet,parameterized_sql_snippet,queryundnl_querysind JSON-Strings, sodass jede Abfrage in einer Zeile geschrieben wird. Verwenden Sie in einer Abfrage einfache Anführungszeichen (') für Stringliterale oder maskieren Sie doppelte Anführungszeichen als\". - GQL in
sql-Feldern. Einige Feldnamen enthaltensql, da das Format von allen Datenbanken verwendet wird, die von QueryData unterstützt werden. Geben Sie für Cloud Spanner Graph GQL-Abfragen oder -Klauseln insql,parameterized_sql,sql_snippetundparameterized_sql_snippetan. - Genaue Feldnamen. Die Feldnamen müssen genau mit den Namen in diesem Dokument übereinstimmen. Felder mit nicht erkannten Namen werden ohne Fehlermeldung ignoriert.
Abfragevorlagen
In einer Vorlage wird eine Frage, die Ihre Nutzer stellen, mit der verifizierten GQL-Abfrage verknüpft, die sie beantwortet. Verwenden Sie Vorlagen für Fragen, die Nutzer wiederholt stellen, insbesondere wenn die Abfrage komplex zu generieren ist (z. B. ein Multi-Hop-Pfadmuster mit einer Zeitbedingung).
Beispiel für eine Vorlage
Mit der folgenden Vorlage in Ihrer Kontextdatei kann QueryData Fragen mit derselben Struktur beantworten, z. B. „Kam Geld, das von Konto 7 gesendet wurde, innerhalb von 60 Tagen zurück?“ oder „Kam Geld, das von Konto 16 gesendet wurde, innerhalb von 30 Tagen zurück?“:
{
  "templates": [
    {
      "nl_query": "Did any money sent from account 7 come back to it within 60 days?",
      "sql": "GRAPH FinGraph MATCH TRAIL (src:Account {id: 7})-[sent:Transfers]->(:Account)-[:Transfers]->{0,2}(:Account)-[returned:Transfers]->(src) WHERE returned.create_time > sent.create_time AND TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) <= 60 RETURN sent.amount AS amount_sent, returned.amount AS amount_returned, TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) AS days_to_return",
      "intent": "Find transfer loops of two to four transfers that start and end at account 7, where the last transfer happens within 60 days after the first transfer.",
      "manifest": "Find transfer loops of two to four transfers that start and end at a given account, where the last transfer happens within a given number of days after the first transfer.",
      "parameterized": {
        "parameterized_intent": "Find transfer loops of two to four transfers that start and end at account ?, where the last transfer happens within ? days after the first transfer.",
        "parameterized_sql": "GRAPH FinGraph MATCH TRAIL (src:Account {id: ?})-[sent:Transfers]->(:Account)-[:Transfers]->{0,2}(:Account)-[returned:Transfers]->(src) WHERE returned.create_time > sent.create_time AND TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) <= ? RETURN sent.amount AS amount_sent, returned.amount AS amount_returned, TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) AS days_to_return"
      }
    }
  ]
}
Wenn ein Nutzer fragt: „Wurde Geld, das von Konto 7 gesendet wurde, innerhalb von 60 Tagen zurückgebucht?“, QueryData gleicht die Frage mit der Vorlage ab (oder ersetzt bei einer Frage mit anderen Parameterwerten wie Konto 16 und 30 Tage die beiden ?-Platzhalter in parameterized_sql) und führt die folgende GQL-Abfrage aus:
GRAPH FinGraph
MATCH TRAIL
  (src:Account {id: 7})-[sent:Transfers]->(:Account)
    -[:Transfers]->{0,2}(:Account)-[returned:Transfers]->(src)
WHERE returned.create_time > sent.create_time
  AND TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) <= 60
RETURN
  sent.amount AS amount_sent,
  returned.amount AS amount_returned,
  TIMESTAMP_DIFF(returned.create_time, sent.create_time, DAY) AS days_to_return
Mit den Beispieldaten FinGraph gibt diese Abfrage Ergebnisse ähnlich den folgenden zurück:
+-------------+-----------------+----------------+
| amount_sent | amount_returned | days_to_return |
+-------------+-----------------+----------------+
| 300         | 500             | 36             |
+-------------+-----------------+----------------+
Vorlagenfelder
Ein Vorlagenobjekt enthält die folgenden Felder:
| Feld | Anforderung | Beschreibung |
|---|---|---|
nl_query |
Erforderlich | Eine Beispielfrage, die so formuliert ist, wie ein Nutzer sie stellen würde (z. B. „Wurde Geld, das von Konto 7 gesendet wurde, innerhalb von 60 Tagen zurückgezahlt?“). |
sql |
Erforderlich | Die vollständige GQL-Abfrage, die nl_query beantwortet. Beginnen Sie die Abfrage mit GRAPH, gefolgt vom Namen eines Property Graphs, den Sie im Feld graph_ids Ihrer QueryData-Anfragen angeben, z. B. GRAPH FinGraph. |
intent |
Erforderlich | Eine genaue Beschreibung der Ergebnisse, die sql zurückgibt. In der Frage eines Nutzers werden Bedingungen oft nicht genannt, aber intent gibt sie an (z. B. bedeutet die Angabe, dass Geld „zurückgekommen“ ist, „Überweisungsschleifen von zwei bis vier Überweisungen, die bei Konto 7 beginnen und enden, wobei die letzte Überweisung innerhalb von 60 Tagen nach der ersten Überweisung erfolgt“). |
manifest |
Erforderlich | Eine verallgemeinerte Version von intent, die die Art der Frage beschreibt, die die Vorlage beantwortet, ohne die spezifischen Werte (z. B. wird „Konto 7“ zu „ein bestimmtes Konto“ und „60 Tage“ zu „eine bestimmte Anzahl von Tagen“). QueryData ruft Vorlagen ab, indem die Frage mit dem Manifest verglichen wird. |
parameterized.parameterized_intent |
Optional | Die intent, wobei jeder spezifische Wert durch einen ?-Platzhalter ersetzt wird. |
parameterized.parameterized_sql |
Optional | Die Abfrage sql, wobei jeder spezifische Wert durch einen ?-Platzhalter in derselben Reihenfolge wie parameterized_intent ersetzt wird. Wenn eine Frage mit der Vorlage übereinstimmt, ersetzt QueryData die Platzhalter durch die Werte aus der Frage und führt diese Abfrage aus. |
Wenn Sie die Datei mit dem Kontextset manuell erstellen, füllen Sie alle vier Pflichtfelder aus. Der Upload schlägt mit dem Fehler INVALID_ARGUMENT fehl, wenn eines der Felder leer ist. Der Kontext-Engineering-Agent generiert intent, manifest und parameterized aus Ihren nl_query- und sql-Paaren. Prüfen Sie die generierten Werte und bearbeiten Sie sie, wenn ein Wert, der unverändert bleiben soll, durch einen Platzhalter ersetzt wird oder wenn ein Wert, der variieren soll, nicht ersetzt wird.
Abfragefacetten
Eine Facette ist eine wiederverwendbare GQL-Klausel, z. B. ein MATCH-Muster oder eine WHERE-Bedingung, die einen geschäftlichen Begriff oder eine geschäftliche Bedingung definiert. Im Gegensatz zu einer Vorlage ist eine Facette eine Teilabfrage und keine vollständige Abfrage. Sie beginnt also nicht mit einer GRAPH-Klausel und ist nicht an eine Frage gebunden. Wenn QueryData eine neue Abfrage generiert, werden die Facetten angewendet, die für die Frage relevant sind.
Beispiel für eine Facette
In der folgenden facets-Konfiguration erfasst die erste Facette das Muster für Überweisungen, die ein gesperrtes Konto betreffen, und die zweite definiert eine Überweisung mit hohem Risiko als Überweisung von 200 oder mehr auf ein gesperrtes Konto:
{
  "facets": [
    {
      "sql_snippet": "MATCH (account:Account)-[transfer:Transfers]-(:Account {is_blocked: true})",
      "intent": "transfers involving a blocked account, in either direction"
    },
    {
      "sql_snippet": "MATCH (account:Account)-[transfer:Transfers]->(blocked_account:Account {is_blocked: true}) WHERE transfer.amount >= 200",
      "intent": "high-risk transfers, which are transfers of 200 or more to a blocked account",
      "manifest": "high-risk transfers, which are transfers of a given amount or more to a blocked account",
      "parameterized": {
        "parameterized_intent": "high-risk transfers, which are transfers of ? or more to a blocked account",
        "parameterized_sql_snippet": "MATCH (account:Account)-[transfer:Transfers]->(blocked_account:Account {is_blocked: true}) WHERE transfer.amount >= ?"
      }
    }
  ]
}
Wenn ein Nutzer fragt: „Wie viele Überweisungen mit hohem Risiko hat Alex vorgenommen?“, passt keine Vorlage zur Frage. QueryData generiert eine neue GQL-Abfrage und bezieht die zweite Facette ein, um Überweisungen von 200 oder mehr auf ein gesperrtes Konto zu zählen:
GRAPH `FinGraph`
MATCH (p:`Person` {`name`: "Alex"})-[:`Owns`]->(src:`Account`)
      -[t:`Transfers`]->(dst:`Account` {`is_blocked`: true})
FILTER t.`amount` >= 200.0
RETURN COUNT(*) AS high_risk_transfer_count
In dieser Abfrage werden die Beispieldaten FinGraph verwendet, um die Übertragung von 300 von Konto 7 an das blockierte Konto 16 zu zählen. Die Ergebnisse sehen in etwa so aus:
+--------------------------+
| high_risk_transfer_count |
+--------------------------+
| 1                        |
+--------------------------+
Attributfelder
Ein Facettenobjekt hat dieselbe Struktur wie eine Abfragevorlage, mit folgenden Unterschieden:
- Kein
nl_query-Feld. Facetten haben keinnl_query-Feld, da eine Facette eine Bedingung beschreibt, die in vielen Fragen und nicht nur in einer einzelnen Frage vorkommt. sql_snippetanstelle vonsql(erforderlich). Eine GQL-Klausel, z. B. einMATCH-Muster oder eineWHERE-Bedingung. Verwenden Sie explizite Knoten- und Kantenlabels sowie Variablennamen wie(account:Account), um Mehrdeutigkeiten zu vermeiden, damit QueryData die GQL-Klausel mit dem Rest der Abfrage kombinieren kann.intent(erforderlich),manifest(optional) undparameterized(optional). Definieren Sie den Geschäftsbegriff oder die Geschäftsbedingung auf dieselbe Weise wie Vorlagenfelder. Der einzige Unterschied besteht darin, dass QueryData Fragen mitintentabgleicht (daher sollte der Name beschreibend sein,manifestist optional) undparameterizeddie Werteparameterized_intentundparameterized_sql_snippetenthält.
Suchanfragen mit Wert
Eine Wertsuche ist eine Abfrage, keine Suchtabelle. Bevor QueryData eine GQL-Abfrage generiert, werden Ihre Wertsuchen einmal für jede Wertphrase in der Frage (ein Textwert wie ein Name, ein Spitzname oder ein Land) ausgeführt. Dabei wird die Phrase durch $value ersetzt. Anschließend werden die nächstgelegenen gespeicherten Werte, die von den Abfragen zurückgegeben werden, zusammen mit der Property, aus der sie stammen, beim Schreiben der GQL-Abfrage verwendet. Die Suche nach Werten funktioniert nicht für Zahlen, Datumsangaben, Uhrzeiten oder Währungsbeträge.
Beispiel für eine Wertsuche
In FinGraph hat das Konto 20 beispielsweise den Alias Rainy Day Fund und im Attribut Person.country wird Czech_Republic mit einem Unterstrich gespeichert. Bei den folgenden Wertsuchen werden Wertphrasen wie „Regentag“ dem Wert Rainy Day Fund in Account.nick_name und „Tschechien“ dem Wert Czech_Republic in Person.country zugeordnet:
{
  "value_searches": [
    {
      "query": "SELECT value, columns, concept_type, distance, context FROM GRAPH_TABLE(FinGraph MATCH (a:Account) WHERE STRPOS(LOWER(a.nick_name), LOWER($value)) > 0 RETURN DISTINCT a.nick_name AS value, 'FinGraph.Account.nick_name' AS columns, 'Account nickname' AS concept_type, 1 - LENGTH($value) / LENGTH(a.nick_name) AS distance, JSON '{}' AS context)",
      "concept_type": "Account nickname",
      "description": "Case-insensitive partial match on account nicknames. Distance is 0 for an exact match and grows as the phrase covers less of the nickname."
    },
    {
      "query": "SELECT value, columns, concept_type, distance, context FROM GRAPH_TABLE(FinGraph MATCH (p:Person) WHERE LOWER(REPLACE(p.country, '_', ' ')) = LOWER(REPLACE($value, '_', ' ')) RETURN DISTINCT p.country AS value, 'FinGraph.Person.country' AS columns, 'Person country' AS concept_type, 0 AS distance, JSON '{}' AS context)",
      "concept_type": "Person country",
      "description": "Match for country names on Person nodes that ignores case and treats underscores as spaces"
    }
  ]
}
Die Account nickname-Abfrage sieht so aus (zur besseren Lesbarkeit formatiert):
SELECT value, columns, concept_type, distance, context
FROM GRAPH_TABLE(
  FinGraph
  MATCH (a:Account)
  WHERE STRPOS(LOWER(a.nick_name), LOWER($value)) > 0
  RETURN DISTINCT
    a.nick_name AS value,
    'FinGraph.Account.nick_name' AS columns,
    'Account nickname' AS concept_type,
    1 - LENGTH($value) / LENGTH(a.nick_name) AS distance,
    JSON '{}' AS context
)
Wenn ein Nutzer fragt: „Wem gehört das Konto für schlechte Zeiten?“, QueryData führt die Wertesuchen mit $value auf 'rainy day' gesetzt aus. Bei der Suche nach Account nickname wird distance aus der Länge der Wortgruppe im Verhältnis zur Länge des gespeicherten Spitznamens berechnet. Eine allgemeinere Wortgruppe wie „fund“ entspricht Vacation Fund bei etwa 0.69 und Rainy Day Fund bei etwa 0.71, während eine genau passende Übereinstimmung wie „rainy day fund“ eine Distanz von 0 hat. Die Ergebnisse sehen in etwa so aus:
+----------------+----------------------------+------------------+--------------------+---------+
| value          | columns                    | concept_type     | distance           | context |
+----------------+----------------------------+------------------+--------------------+---------+
| Rainy Day Fund | FinGraph.Account.nick_name | Account nickname | 0.3571428571428571 | {}      |
+----------------+----------------------------+------------------+--------------------+---------+
QueryData generiert dann eine GQL-Abfrage, die nach {nick_name: 'Rainy Day Fund'} statt nach {nick_name: 'rainy day'} filtert:
GRAPH `FinGraph`
MATCH (p:`Person`)-[:`Owns`]->(a:`Account` {`nick_name`: 'Rainy Day Fund'})
RETURN DISTINCT SAFE_TO_JSON(p) AS person
Mit den Beispieldaten FinGraph gibt diese Abfrage den Knoten Person für Dana im JSON-Format zurück, ähnlich wie im folgenden Beispiel:
{
  "element_definition_name": "Person",
  "identifier": "kQKRBA==",
  "kind": "node",
  "labels": ["Person"],
  "properties": {
    "birthday": "1980-10-31T08:00:00Z",
    "city": "Moravia",
    "country": "Czech_Republic",
    "id": 2,
    "name": "Dana"
  }
}
Suchfelder für Werte und erforderliche SELECT-Spalten
Ein Wertsuchobjekt enthält die folgenden Felder:
| Feld | Anforderung | Beschreibung |
|---|---|---|
query |
Erforderlich | Eine GoogleSQL-Abfrage, die die gespeicherten Werte findet, die mit einer Wertphrase übereinstimmen. Verwenden Sie $value an der Stelle, an der die Wortgruppe stehen soll. QueryData ersetzt $value durch die Wortgruppe als Stringliteral in Anführungszeichen. Setzen Sie $value daher nicht in Anführungszeichen. Sie können $value mehrmals verwenden. Schreiben Sie die Abfrage als SELECT-Anweisung über einen GRAPH_TABLE-Operator, der mit einem Knoten- oder Kantenlabel übereinstimmt, eine Property mit $value vergleicht und die fünf Spalten in der folgenden Tabelle zurückgibt. |
concept_type |
Erforderlich | Ein Label für die Art des Werts, der bei der Suche gefunden wird, z. B. Account nickname oder Person country. |
description |
Optional | Eine Beschreibung, wie die Suche Werte abgleicht. |
Jede Wertsuche query muss die folgenden fünf Spalten in dieser Reihenfolge zurückgeben:
| Ausgabespalte | Beschreibung | FinGraph-Beispiel |
|---|---|---|
value |
Der übereinstimmende Attributwert, wie er in der Datenbank gespeichert ist. | a.nick_name AS value ('Rainy Day Fund') |
columns |
Der Standort der Unterkunft im Format GRAPH_NAME.LABEL.PROPERTY. QueryData übergibt diesen Wert als Speicherort des Werts an das Modell. Verwenden Sie daher ein einheitliches Format. |
'FinGraph.Account.nick_name' AS columns |
concept_type |
Ein Label für die Art des Werts. Verwenden Sie denselben String wie im Feld concept_type der Wertsuche: Das Feld kennzeichnet die Suche und die Spalte kennzeichnet jede Übereinstimmung. |
'Account nickname' AS concept_type |
distance |
Wie weit der gespeicherte Wert von der Wortgruppe entfernt ist, auf einer von Ihnen definierten Skala, wobei 0 eine genaue Übereinstimmung ist. Verwenden Sie gemäß Konvention Werte von 0 bis 1. QueryData sortiert die Kandidaten aus allen Wertesuchen nach distance und behält die 10 besten bei. Es wird kein Schwellenwert angewendet. Schließen Sie daher schwache Übereinstimmungen in der Abfrage selbst aus, z. B. indem Sie der äußeren SELECT-Anweisung WHERE distance < 1.0 hinzufügen. |
1 - LENGTH($value) / LENGTH(a.nick_name) AS distance |
context |
Ein JSON-Wert. QueryData verwendet diese Spalte nicht, aber sie muss in jeder Wertsuche mit demselben Typ vorhanden sein. Geben Sie JSON '{}' zurück. |
JSON '{}' AS context |
So führt QueryData Wertesuchen aus
QueryData führt keine einzelnen Wertesuchen nacheinander aus. Für jede Wertphrase in einer Frage wird die Phrase in jeder Wertsuche durch $value ersetzt, ORDER BY distance LIMIT 10 an jede Abfrage angehängt, die Abfragen mit UNION ALL kombiniert und das Ergebnis als einzelne GoogleSQL-Anweisung ausgeführt, die die 10 besten Übereinstimmungen beibehält. Aufgrund der kombinierten Abfrage werden Wertesuchen als SELECT-Anweisungen über GRAPH_TABLE und nicht als eigenständige GQL-Anweisungen geschrieben: GRAPH_TABLE führt Ihr GQL-MATCH-Muster als Tabelle aus und UNION ALL und das freigegebene ORDER BY distance sind SQL-Konstrukte.
Dieses Ausführungsmodell hat die folgenden Auswirkungen auf die von Ihnen geschriebenen Abfragen:
- Keine äußeren
ORDER BYoderLIMIT. Fügen Sie der äußerenSELECT-Anweisung wederORDER BYnochLIMIThinzu. QueryData hängt sie an und eine doppelte Klausel führt dazu, dass die Anweisung fehlschlägt. - Kompatible Spaltentypen Jede Wertsuche in der Datei muss dieselben fünf Spalten in derselben Reihenfolge und mit kompatiblen Typen zurückgeben. Geben Sie beispielsweise für
contextin allenJSON '{}'zurück, nicht in einigen'{}'. - Erforderlicher Platzhalter
$value. Die Abfrage muss mindestens einmal$valueenthalten, sonst schlägt der Upload fehl. - Nur Textwerte. Wertsuchvorgänge werden nur für Textwerte ausgeführt. QueryData führt sie nicht für Zahlen, Datumsangaben, Uhrzeiten oder Währungsbeträge aus.
Beschränkungen
Für Kontextgruppen für Spanner Graph gelten die folgenden Einschränkungen:
- Kontextsätze für Datenbanken unterstützen nur Abfragevorlagen, Abfragefacetten und Wertesuchen.
- Kontextsätze für Datenbanken werden nur vom Endpunkt
QueryDatain der API für konversationelle Analyse verwendet.
Nächste Schritte
- Kontextsatz in Spanner Studio erstellen oder löschen
- Kontextsets mit dem Context-Engineering-Agenten erstellen