


Questo documento descrive come creare e ottimizzare i set di contesti che consentono di ottenere un'elevata accuratezza di QueryData per le applicazioni degli agenti per i dati di Spanner Graph. L'agente di context engineering ti aiuta a creare, valutare e migliorare i set di contesto Graph Query Language (GQL) automatizzandone la creazione e l'ottimizzazione.
Per scoprire di più sui set di contesto e su QueryData per Spanner Graph, consulta Panoramica dei set di contesto e Panoramica di QueryData.
Per creare applicazioni di dati di grafi aziendali, l'accuratezza della traduzione dal linguaggio naturale a GQL deve in genere raggiungere una qualità vicina al 100%. Pattern di attraversamento del grafo errati o filtri degli archi mancanti influiscono sull'usabilità dell'applicazione e sull'esperienza utente. Per ottenere risposte spiegabili e pertinenti per l'attività con un'elevata accuratezza, è necessario il context engineering, ovvero il processo di creazione e ottimizzazione iterativa del set di contesto.
Fornendo a QueryData un targeting contestuale mirato allo schema Spanner Graph e all'applicazione aziendale, fornisci le regole di attraversamento del grafo e le definizioni di dominio precise di cui il sistema ha bisogno per risolvere lo user intent sfumato.
Gli esempi in questo documento utilizzano lo schema del grafo delle proprietà FinGraph e il set di dati di esempio (nodi Person e Account collegati da archi Owns e Transfers). Per creare lo schema FinGraph e inserire i dati campionati, consulta Configura ed esegui query su Spanner Graph.
Agente di context engineering
L'agente di context engineering automatizza il workflow di context engineering: genera set di dati di valutazione, esegue il bootstrap di un set di contesto e lo migliora in modo iterativo.
Il seguente elenco fornisce esempi di prompt in linguaggio naturale per istruire l'agente, insieme a una descrizione di come risponde l'agente:
- Esempio di prompt per il suggerimento di contesto: "Leggi il mio documento di applicazione per il grafo delle proprietà
FinGraphnel mio database Spanner e suggerisci gli elementi di contesto GQL da aggiungere." L'agente analizza i documenti dell'applicazione del set di dati che fornisci, mappa le regole aziendali alle etichette dei nodi e degli archiFinGraphe suggerisce modelli e aspetti GQL. - Esempio di prompt per l'analisi dei gap quando le domande degli utenti non restituiscono i risultati previsti: "Quando gli utenti chiedono 'trasferimenti dal conto per le emergenze', QueryData filtra in base a
nick_name = 'rainy day account'e non restituisce nulla. Aggiorna il contesto del grafico delle proprietàFinGraphnel mio database Spanner in modo che questa domanda riceva una risposta corretta." L'agente esamina lo schema, identifica che il nickname è archiviato comeRainy Day Funde consiglia una ricerca del valore suAccount.nick_name(o un template o un facet se il problema è il pattern). Esempio di prompt per l'elaborazione collettiva: "Ecco le domande in linguaggio naturale e le query GQL per il grafico delle proprietà
FinGraphnel mio database Spanner. Trasformali in modelli:- Trova tutte le persone a cui Dana ha trasferito denaro, con gli importi:
GRAPH FinGraph MATCH (:Person {name: 'Dana'})-[:Owns]->(:Account)-[transfer:Transfers]->(:Account)<-[:Owns]-(to_person:Person) RETURN to_person.name AS recipient, transfer.amount AS amount - Quali trasferimenti ad alto rischio ha effettuato Alex?
GRAPH FinGraph MATCH (:Person {name: 'Alex'})-[:Owns]->(src:Account)-[t:Transfers]->(dst:Account {is_blocked: true}) WHERE t.amount >= 200 RETURN dst.id AS destination_account_id, t.amount AS transfer_amount"
L'agente elabora collettivamente gli input, sostituisce i valori letterali con i segnaposto
?e aggiorna il file del set di contesto.- Trova tutte le persone a cui Dana ha trasferito denaro, con gli importi:
Importanza del set di dati finale
Per ottimizzare il contesto, devi prima creare un set di dati "golden" che corrisponda agli input in linguaggio naturale della tua applicazione. L'agente può aiutarti a creare questo set di dati di riferimento, che consiste in domande degli utenti abbinate alle query GQL previste. Un set di dati d'oro ti consente di:
- Stabilisci una base di riferimento per le prestazioni delle query da linguaggio naturale a GQL.
- Convalida gli aggiornamenti del contesto rispetto alle query GQL basate su dati di fatto.
- Misura i miglioramenti dell'accuratezza nelle iterazioni di ottimizzazione.
Il processo sistematico di hill climbing
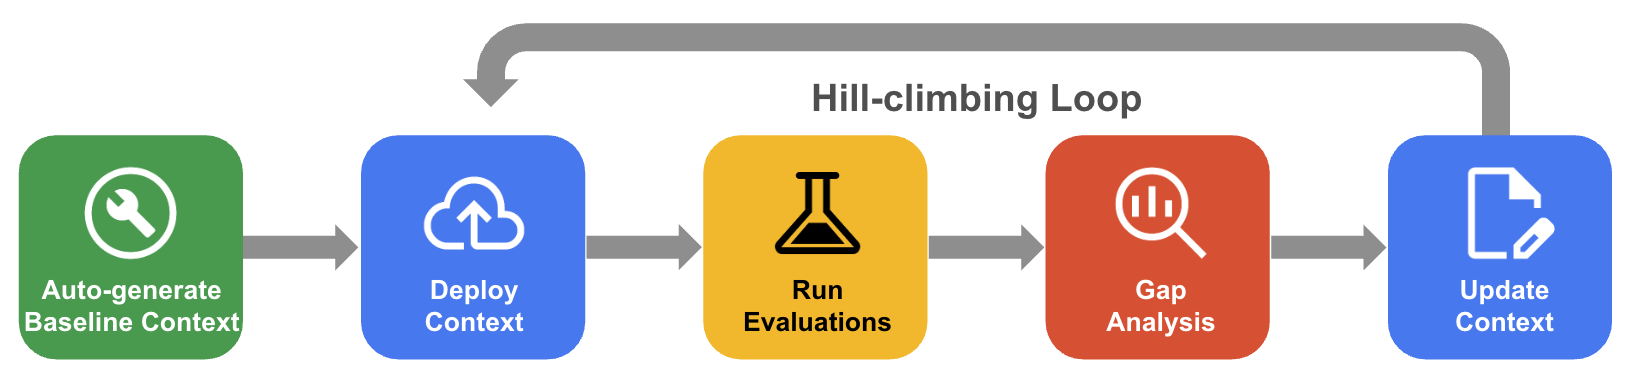
Nell'hill climbing sistematico, l'agente migliora in modo iterativo un set di contesto tramite la valutazione del set di dati di riferimento, l'analisi dei gap e l'aggiornamento mirato del contesto GQL per aumentare l'accuratezza fino a quasi il 100%:
- Genera automaticamente il contesto di base: crea un set di contesto GQL di partenza derivato dallo schema del grafo delle proprietà di Spanner Graph e dagli artefatti dell'applicazione.
- Workflow di ottimizzazione hill climbing: consenti all'agente di valutare l'accuratezza di QueryData con
graph_idsconfigurato, eseguire l'analisi dei gap sulle query GQL non riuscite e proporre automaticamente miglioramenti per aumentare l'accuratezza.
Il seguente diagramma mostra il workflow sistematico di hill climbing:
Prima di iniziare
Prima di utilizzare l'agente di progettazione del contesto, completa i seguenti prerequisiti:
Abilita i servizi richiesti
Abilita i seguenti servizi per il tuo progetto:Prepara un'istanza Spanner
- Assicurati che sia disponibile un'istanza Spanner. Per saperne di più, consulta Crea un'istanza.
- Assicurati di creare un database nell'istanza in cui creerai le tabelle. Per saperne di più, consulta Crea un database nell'istanza Spanner.
Ruoli e autorizzazioni richiesti
- Aggiungi un utente o un account di servizio IAM all'istanza. Per saperne di più, consulta Applica i ruoli IAM.
- Concedi i ruoli
roles/spanner.databaseReader,roles/serviceusage.serviceUsageConsumereroles/geminidataanalytics.queryDataUserall'utente IAM a livello di progetto. Per saperne di più, consulta Aggiungi l'associazione delle policy IAM per un progetto. - Per creare, caricare e gestire i set di contesto, concedi il ruolo Dataplex Catalog Editor (
roles/dataplex.catalogEditor) o Dataplex Catalog Admin (roles/dataplex.catalogAdmin) all'utente IAM a livello di progetto. Per saperne di più, consulta Autorizzazioni per i set di contesti. - Concedi ruoli e autorizzazioni all'utente IAM a livello di progetto per i database richiesti.
Per configurare lo schema del grafico delle proprietà FinGraph e inserire i dati del grafico di esempio utilizzati in questa guida, segui i passaggi descritti in Configura ed esegui query su Spanner Graph.
prepara l'ambiente
Puoi creare file di set di contesto da qualsiasi ambiente di sviluppo locale o IDE. Per preparare l'ambiente, completa i seguenti passaggi:
- Installa l'agente del motore contestuale.
- Configura la connessione al database per Spanner Graph.
Installa l'agente di progettazione del contesto
L'agente di progettazione del contesto esegue un server Model Context Protocol (MCP) che richiede uv per gestire i pacchetti Python sottostanti.
- Installa
uvseguendo le istruzioni riportate in Installauv. Verifica che
uvsia installato e accessibile dalla riga di comando:uv --version
Per preparare l'ambiente, installa l'agente di context engineering nell'harness dell'agente selezionato, ad esempio l'interfaccia a riga di comando di Antigravity, Claude Code o l'interfaccia a riga di comando di Gemini.
A seconda dell'infrastruttura agentica selezionata, segui i passaggi di installazione corrispondenti:
Antigravity CLI
Per installare l'agente di context engineering nell'interfaccia a riga di comando di Antigravity, segui questi passaggi:
- Installa Antigravity CLI. Consulta Introduzione ad Antigravity CLI.
- Installa il plugin agenti di context engineering, che include workflow per la generazione del contesto:
agy plugin install https://github.com/GoogleCloudPlatform/db-context-enrichment/tree/main/plugin
- Avvia Antigravity CLI:
agy
- Aggiorna il plug-in:
agy plugin uninstall google-cloud-db-context-engineering
agy plugin install https://github.com/GoogleCloudPlatform/db-context-enrichment/tree/main/plugin
Claude Code
Per installare l'agente di context engineering in Claude Code, segui questi passaggi:
- Aggiungi il marketplace dei plug-in:
/plugin marketplace add https://github.com/GoogleCloudPlatform/db-context-enrichment.git
- Installa il plug-in:
/plugin install db-context-engineering@db-context-enrichment-marketplace
- Ricarica i plug-in per attivare le modifiche:
/reload-plugins
- Aggiorna il plug-in:
/plugin update db-context-engineering@db-context-enrichment-marketplace
Gemini CLI (deprecato)
Per installare l'agente di context engineering nell'interfaccia a riga di comando di Gemini, segui questi passaggi:
- Installa Gemini CLI. Consulta Inizia a utilizzare Gemini CLI.
- Installa l'estensione:
gemini extensions install https://github.com/GoogleCloudPlatform/db-context-enrichment
- Aggiorna l'estensione:
gemini extensions update mcp-db-context-enrichment
Configura la connessione al database
L'agente richiede una connessione al database per recuperare gli schemi dei grafi delle proprietà (spanner-list-graphs), ispezionare le tabelle sottostanti (spanner-list-tables) e convalidare la sintassi delle query GQL e SQL generate (spanner-execute-sql). Per consentire all'agente di interagire con il grafo delle proprietà nel database Spanner, configura le credenziali di autenticazione e definisci la configurazione della connessione al database.
Configura le Credenziali predefinite dell'applicazione
Configura le Credenziali predefinite dell'applicazione (ADC) per fornire le credenziali utente per accedere alle risorse Google Cloud dall'agente di motore contestuale:
- Server MCP Toolbox: utilizza le credenziali per connettersi al database Spanner, recuperare gli schemi dei grafi delle proprietà ed eseguire query GQL per la convalida.
- Evalbench: utilizza le credenziali per chiamare l'API REST
QueryDatacongraph_idsed eseguire il valutatore LLM su Vertex AI durante la valutazione.
Esegui questo comando nel terminale per eseguire l'autenticazione:
gcloud auth application-default loginConfigura il file di connessione al database
L'agente richiede una connessione al database per la generazione del contesto, che MCP Toolbox supporta e definisce all'interno di un file di configurazione (autoctx/tools.yaml), insieme a un tracker di stato (autoctx/state.md) che registra i nomi dei grafi delle proprietà attivi (come FinGraph).
- Avvia l'ambiente dell'agente.
Chiedi all'agente di configurare la connessione al database Spanner e specifica il nome del grafo delle proprietà. Ad esempio, inserisci il seguente prompt:
Help me set up the database connection for my Spanner database with the FinGraph property graph.Segui le istruzioni dell'agente per fornire l'ID progetto, l'ID istanza Spanner, l'ID database e il nome del grafo delle proprietà (
FinGraph). L'agente creaautoctx/tools.yaml(con gli strumentispanner-list-graphs,spanner-list-tablesespanner-execute-sql) eautoctx/state.md.Apri
autoctx/state.mde verifica che nella sezione## Active Databasesia elencato il grafico della proprietà nel seguente formato:- **Graph Ids**: ["FinGraph"]Il workflow di valutazione legge gli ID dei grafici delle proprietà solo da questa riga. Se la riga non è presente, è vuota (
[]) o non è in questo formato, la valutazione chiama QueryData senzagraph_idse QueryData genera SQL relazionale anziché GQL.Per applicare la nuova configurazione di
tools.yaml, ricarica la connessione:- Nella CLI di Antigravity, esegui
/mcpe selezionatoolboxper riavviare. - In Gemini CLI, esegui
/mcp reload. - In Claude Code, esegui
/mcp, selezionatoolboxe selezionaReconnect.
- Nella CLI di Antigravity, esegui
Per saperne di più sulla configurazione manuale del file di configurazione del database, consulta Configurazione di MCP Toolbox.
Genera e ottimizza il contesto
L'agente di context engineering fornisce un insieme di competenze dell'agente e strumenti MCP per generare un insieme di contesti GQL di riferimento, misurare l'efficacia rispetto a un set di dati GQL di riferimento e applicare i miglioramenti in modo iterativo. Puoi iniziare in qualsiasi fase del workflow:
- Se hai già un set di contesto, puoi procedere direttamente alla valutazione.
- Se hai query GQL con errori che vuoi correggere, puoi procedere direttamente all'analisi del gap.
In qualsiasi fase, ricorda all'agente che il target è un grafico delle proprietà nel tuo database Spanner e assegna un nome al grafico (ad esempio FinGraph), in modo che rimanga nel workflow specifico di GQL.
Crea ed espandi i set di dati di valutazione
Per migliorare il rendimento, devi prima misurarlo. Un set di dati di riferimento è un insieme di domande degli utenti abbinate alle query GQL previste. Senza un set di dati di valutazione, l'ingegneria del contesto manca di una verifica sistematica; con un set di dati di valutazione, ogni modifica del contesto è un miglioramento misurabile che puoi convalidare rispetto ai dati di fatto.
La creazione manuale di un set di dati golden rappresentativo richiede tempo e i set di dati di piccole dimensioni potrebbero non includere variazioni nella formulazione degli utenti. L'agente risolve il problema:
- Generazione di coppie di domande in linguaggio naturale e query GQL candidate in base allo schema del grafico delle proprietà.
- Espansione di un set di dati di seed utilizzando varianti di filtri, sinonimi e riformulazioni di percorsi multi-hop.
- Esecuzione delle query GQL generate sul database Spanner per confermare che ogni query venga eseguita correttamente e restituisca risultati validi.
In base alle query FinGraph in Panoramica delle query Spanner Graph, il set di dati golden (autoctx/golden.json) è un file JSON contenente coppie di domande in linguaggio naturale e GQL come le seguenti:
[
  {
    "id": "fingraph_001",
    "database": "example-db",
    "nlq": "Find everyone that Dana transferred money to, along with the account IDs and transfer amounts.",
    "golden_sql": "GRAPH FinGraph MATCH (from_person:Person {name: 'Dana'})-[:Owns]->(from_account:Account)-[transfer:Transfers]->(to_account:Account)<-[:Owns]-(to_person:Person) RETURN to_person.name AS to_account_owner, to_account.id AS to_account_id, transfer.amount AS amount;"
  },
  {
    "id": "fingraph_002",
    "database": "example-db",
    "nlq": "Find all money transfers involving a blocked account.",
    "golden_sql": "GRAPH FinGraph MATCH (account:Account)-[transfer:Transfers]-(:Account {is_blocked: true}) RETURN transfer.order_number, transfer.amount;"
  },
  {
    "id": "fingraph_003",
    "database": "example-db",
    "nlq": "Find destination accounts that are 1 to 3 transfers away from account 7, and show the path length.",
    "golden_sql": "GRAPH FinGraph MATCH (src:Account {id: 7})-[e:Transfers]->{1, 3}(dst:Account) WHERE src != dst RETURN dst.id AS dst_account_id, ARRAY_LENGTH(e) AS path_length;"
  },
  {
    "id": "fingraph_004",
    "database": "example-db",
    "nlq": "Find all high-risk transfers initiated by Alex.",
    "golden_sql": "GRAPH FinGraph MATCH (p:Person {name: 'Alex'})-[:Owns]->(src:Account)-[t:Transfers]->(dst:Account {is_blocked: true}) WHERE t.amount >= 200 RETURN dst.id AS destination_account_id, t.amount AS transfer_amount ORDER BY t.amount DESC;"
  }
]
Le coppie approvate vengono inserite nel file autoctx/golden.json nel tuo workspace, dove sono pronte per la valutazione. In ogni voce, database deve corrispondere all'ID del database Spanner (ad esempio example-db).
Puoi utilizzare i seguenti prompt di esempio per istruire l'agente, specificando che FinGraph è un grafico delle proprietà nel tuo database Spanner:
- "Genera un set di dati di valutazione GQL dal grafo delle proprietà
FinGraphnel mio database Spanner." - "Ecco una domanda di partenza e una query GQL per il graph di proprietà
FinGraphnel mio database Spanner. Espandilo in un set di dati di valutazione GQL più ampio e verifica che le query vengano eseguite."
Genera un set di contesti di riferimento
Per evitare di creare il contesto da zero, puoi consentire all'agente di derivare un set di contesto GQL iniziale (bootstrap_context.json) dallo schema del grafico delle proprietà e dagli artefatti dell'applicazione, come regole aziendali, query GQL di esempio o documenti di progettazione. Poiché il tuo set di dati è un grafo di proprietà nel tuo database Spanner, l'agente preferisce i pattern GQL (GRAPH FinGraph MATCH ...) rispetto ai join SQL relazionali durante la generazione di modelli e facet.
Puoi utilizzare i seguenti prompt di esempio per istruire l'agente:
- "Genera un set di contesti GQL di riferimento dal grafico delle proprietà
FinGraphnel mio database Spanner." - "Genera il contesto GQL iniziale per il grafico delle proprietà
FinGraphnel mio database Spanner utilizzando lo schema del grafico delle proprietà e le regole aziendali inrequirements.md."
L'agente ti chiede di assegnare un nome all'esperimento (ad esempio, fingraph_tuning), che organizza gli artefatti generati in autoctx/experiments/fingraph_tuning/. Dopo che l'agente ha generato bootstrap_context.json, segui le istruzioni riportate in Gestisci i set di contesto in Spanner Studio per caricare il file del set di contesto.
Valuta l'efficacia del contesto
Dopo aver stabilito un set di contesto e un set di dati golden, puoi consentire all'agente di misurare le prestazioni del contesto eseguendo una query sull'API QueryData con ogni domanda golden. L'agente confronta il GQL generato e i risultati dell'esecuzione con le risposte golden previste utilizzando Evalbench.
Per Spanner Graph, la valutazione chiama direttamente l'API REST QueryData in modo che ogni richiesta possa includere graph_ids.
Quando autoctx/state.md contiene - **Graph Ids**: ["FinGraph"], l'agente genera un file di configurazione del modello Evalbench (autoctx/experiments/fingraph_tuning/eval_configs/model_config.yaml) che utilizza l'API REST e include graph_ids in spanner_reference.database_reference, simile al seguente:
generator: query_data_api
project_id: PROJECT_ID
location: global
use_rest_api: true
context:
  datasource_references:
    spanner_reference:
      database_reference:
        engine: GOOGLE_SQL
        project_id: PROJECT_ID
        instance_id: INSTANCE_ID
        database_id: DATABASE_ID
        graph_ids:
        - FinGraph
      agent_context_reference:
        context_set_id: projects/PROJECT_ID/locations/REGION/contextSets/CONTEXT_SET_ID
Prima di eseguire una valutazione, apri model_config.yaml e verifica che use_rest_api sia true e che graph_ids elenchi il tuo grafico delle proprietà.
L'esecuzione di una valutazione fornisce quanto segue:
- Metriche quantitative, come i risultati di superamento e fallimento e i punteggi aggregati, per monitorare i progressi nelle iterazioni del contesto GQL.
- Un riepilogo della conversazione in linea e report CSV dettagliati scritti nella directory
eval_reports/della cartella dell'esperimento.
Per avviare una valutazione, fornisci il percorso del set di dati golden (autoctx/golden.json) e l'ID del set di contesto. Per scoprire come trovare l'ID del set di contesto, consulta Trova l'ID del set di contesto.
Puoi utilizzare i seguenti prompt di esempio per istruire l'agente:
- "Valuta il mio contesto per il grafico delle proprietà FinGraph nel mio database Spanner rispetto a
autoctx/golden.json. Chiama l'API REST QueryData congraph_idsimpostato suFinGraph." - "Esegui nuovamente la valutazione per il grafico delle proprietà FinGraph nel mio database Spanner utilizzando la configurazione del mio ultimo esperimento."
Per eseguire nuovamente una configurazione di valutazione generata in precedenza direttamente dalla directory principale del workspace, esegui questo comando:
uvx google-evalbench --experiment_config=autoctx/experiments/fingraph_tuning/eval_configs/run_config.yamlPer informazioni dettagliate sullo schema di configurazione della valutazione e su come personalizzare le esecuzioni della valutazione, consulta la documentazione di Evalbench.
Eseguire l'analisi delle lacune e proporre miglioramenti
Per risolvere gli errori delle query GQL, identifica le cause principali, ad esempio:
- Direzioni dei bordi invertite (
-[:Owns]->rispetto a<-[:Owns]-) - Limiti del percorso quantificato mancanti (
->{1, 3}) - Definizioni di attività non mappate (ad esempio
high-risk transfers) - Valori delle proprietà non risolti
Per la sintassi delle query, consulta la panoramica delle query Spanner Graph e il riferimento GQL.
L'agente automatizza questo ciclo di analisi e correzione per il grafico delle proprietà nel database Spanner:
- Analisi dei gap: l'agente legge i risultati della valutazione e il set di contesto per raggruppare errori GQL simili e consigliare aggiunte mirate, come modelli GQL, facet o ricerche di valori
GRAPH_TABLEsu proprietà di nodi e archi. - Correzioni proposte: l'agente propone modifiche concrete al contesto GQL e testa il GQL generato sul tuo database Spanner utilizzando
spanner-execute-sqlper verificare la risoluzione. - Conservazione della base di riferimento: l'agente scrive i miglioramenti in un nuovo file JSON (
improved_context_v1.json) insieme al contesto di base, conservando i file originali.
Puoi utilizzare i seguenti prompt di esempio per istruire l'agente, specificando che il set di dati è un grafo delle proprietà nel tuo database Spanner per attivare il workflow di context engineering specifico per GQL:
- "Esegui l'analisi dei gap sulla mia ultima valutazione per il grafico delle proprietà FinGraph nel mio database Spanner e proponi correzioni del contesto GQL."
- "Ottimizza questo set di contesti per il grafico delle proprietà FinGraph nel mio database Spanner rispetto a
autoctx/golden.json."
Per prepararti all'iterazione successiva, carica il file del set di contesto migliorato (improved_context_v1.json) nel set di contesto di destinazione in Spanner Studio seguendo le istruzioni riportate in Modifica un set di contesto.
Crea elementi di contesto specifici on demand
Se conosci già l'elemento di contesto di cui hai bisogno (ad esempio un template GQL per un attraversamento specifico del grafo, un facet per un filtro di arco ripetuto o una ricerca di valore GRAPH_TABLE su una proprietà di nodo o arco), l'agente può generare l'oggetto JSON con i parametri corretti on demand senza eseguire una valutazione completa.
Puoi utilizzare i seguenti prompt di esempio per istruire l'agente per il grafico delle proprietà nel tuo database Spanner:
- "Per il grafico delle proprietà FinGraph nel mio database Spanner, crea un template per: 'Trova tutti i trasferimenti ad alto rischio avviati da Alex' con la query GQL:
GRAPH FinGraph MATCH (p:Person {name: 'Alex'})-[:Owns]->(src:Account)-[t:Transfers]->(dst:Account {is_blocked: true}) WHERE t.amount >= 200 RETURN dst.id AS destination_account_id, t.amount AS transfer_amount ORDER BY t.amount DESC;." - "Per il grafico delle proprietà FinGraph nel mio database Spanner, crea un facet per la clausola GQL
MATCH (account:Account)-[transfer:Transfers]-(:Account {is_blocked: true})con l'etichetta 'trasferimenti che coinvolgono un account bloccato'." - "Per il grafico delle proprietà FinGraph nel mio database Spanner, crea una ricerca di valori
GRAPH_TABLEsulla proprietànick_namedei nodiAccountcon tipo di concetto 'Nickname account' che corrisponde ai nickname senza distinzione tra maiuscole e minuscole."
Motivo della selezione del tipo di contesto
La selezione del tipo di contesto appropriato (un template GQL, un facet o una ricerca di valori) aiuta a evitare il sovraccarico del contesto e le regressioni delle query. Puoi chiedere all'agente di consigliarti il tipo di contesto giusto in base ai tuoi pattern di query:
- "Nel grafico delle proprietà FinGraph del mio database Spanner, continuo a filtrare i trasferimenti che coinvolgono account bloccati con
MATCH (account:Account)-[transfer:Transfers]-(:Account {is_blocked: true})in molte query GQL. Qual è il modo migliore per acquisirlo?" - "Gli utenti fanno riferimento agli account nel grafico delle proprietà FinGraph nel mio database Spanner con nickname come 'Fondo vacanze' o 'Fondo per le emergenze'. Che tipo di ricerca del valore
GRAPH_TABLEdevo configurare suAccount.nick_name?" - "Qual è la differenza tra un template GQL e un facet in un set di contesti per Spanner Graph e quando devo utilizzarli?"
Applica operazioni collettive a un set di contesti
L'agente supporta gli aggiornamenti collettivi per gestire in modo coerente set di contesti GQL di grandi dimensioni, ad esempio quando viene aggiornata un'etichetta di un grafico delle proprietà o cambia una soglia aziendale in più modelli e aspetti:
- "Leggi
golden.jsonper il grafico delle proprietà FinGraph nel mio database Spanner e trasforma tutte le coppie domanda-GQL in modelli." - "In
context_set.jsonper il grafico delle proprietà FinGraph nel mio database Spanner, sostituiscit.amount >= 200cont.amount >= 300per qualsiasi elemento GQL che fa riferimento a 'trasferimenti ad alto rischio'. Lascia stare gli elementi non correlati."
Passaggi successivi
- Scopri di più sui set di contesti.
- Scopri come creare o eliminare un set di contesto in Spanner Studio.
- Scopri come testare QueryData per Spanner Graph.
- Segui il tutorial end-to-end per integrare QueryData con un'applicazione.