


Agent Platform Memory Bank を使用すると、ユーザーとエージェントの会話に基づいて長期記憶を動的に生成できます。これらの記憶は、複数のセッションにわたって保持されるパーソナライズされた情報です。これにより、エージェントはコンテキストと継続性に応じて回答を適応させ、パーソナライズできます。
機能
Memory Bank を使用すると、記憶を管理して、エージェントがユーザーとやり取りする方法をパーソナライズし、コンテキスト ウィンドウを管理できます。メモリバンクは、スコープごとに独立したメモリーのコレクションを保持します。各メモリは、エージェントが使用できるコンテキストを拡張するために使用できる、独立した自己完結型の情報です。次に例を示します。
{
  "name": "projects/.../locations/.../reasoningEngines/.../memories/...",
  "scope": {
    "agent_name": "My agent",
    "user": "my user ID"
  },
  "fact": "I use Memory Bank to manage my memories."
}
Memory Bank には次の機能が含まれています。
メモリーの生成: 大規模言語モデル(LLM)を使用してメモリーを作成、改良、管理します。
記憶の抽出: ソースデータから最も意味のある情報のみを抽出し、記憶として保持します。
メモリの統合: 新しく抽出された情報を既存のメモリと統合し、新しい情報が取り込まれるにつれてメモリが進化できるようにします。また、事前に抽出されたメモリ(エージェントや人間参加型が意味があると考える情報など)を既存のメモリと統合することもできます。
非同期生成: バックグラウンドでメモリを生成します。これにより、エージェントはメモリ生成の完了を待つ必要がなくなります。
継続的なイベント取り込み: イベント取り込みを使用して会話イベントをストリーミングして管理します。これにより、構成したバッチ処理ルールに基づいてメモリ生成が自動的にトリガーされます。
カスタマイズ可能な抽出: 特定のトピックと少数ショットの例を指定して、Memory Bank が意味があると考える情報を構成します。
マルチモーダル理解: マルチモーダル情報を処理して、テキスト分析情報を生成して保持します。
マネージド ストレージと取得: フルマネージドで永続的、アクセス可能なメモリストアを利用できます。
ID 間のデータ分離: メモリの統合と取得は、特定の ID に分離されます。
永続的でアクセス可能なストレージ: Agent Runtime、ローカル環境、その他のデプロイ オプションなど、複数の環境からアクセスできる記憶を保存します。
類似性検索: 特定の ID にスコープ設定された類似性検索を使用してメモリを取得します。
自動有効期限: メモリに有効期間(TTL)を設定して、古い情報が自動的に削除されるようにします。挿入または生成された記憶に TTL が自動的に適用されるように、Memory Bank インスタンスを構成します。
メモリ リビジョン: メモリ リビジョンを自動的に作成して維持します。これにより、新しい情報が取り込まれるときにメモリがどのように変換されるかを検査できます。
制限付きの権限: IAM 条件を使用して、特定のスコープのメモリを読み取りまたは書き込みできるプリンシパルを制限します。
エージェントの統合: Memory Bank をエージェントに接続して、記憶の生成と取得の呼び出しをオーケストレートできるようにします。
Agent Development Kit(ADK)の統合: 組み込みの ADK ツールと
VertexAiMemoryBankServiceを使用して、ADK ベースのエージェントからの呼び出しをオーケストレートし、Memory Bank の読み取りと書き込みを行います。その他のフレームワーク: Memory Bank コードをツールとコールバックでラップして、メモリの生成と取得をオーケストレートします。
ユースケース
メモリバンクを使用すると、ステートレスなエージェント インタラクションを、エージェントが時間の経過とともに記憶、学習、適応するステートフルなコンテキスト エクスペリエンスに変換できます。Memory Bank は、次のものを必要とするアプリケーションに最適です。
長期的なパーソナライズ: 個々のユーザーに合わせてカスタマイズされたエクスペリエンスを構築します。Memory Bank は、記憶を特定の ID にスコープ設定します。これにより、エージェントは複数のセッションにわたってユーザーの好み、履歴、重要な詳細を記憶できます。
- 例: カスタマー サービス エージェントが、ユーザーの過去のサポート チケットやプロダクトの設定から重要な情報を記憶し、再度質問する必要がない。
LLM 駆動のナレッジ抽出: 会話やマルチモーダル コンテンツから最も重要な情報を手動で介入することなく自動的に識別して保持する必要がある場合に使用します。
- 例: 一連の技術論文を読み、主な調査結果、手法、結論を統合したメモリを構築する調査エージェント。
動的で進化するコンテキスト: 静的でないナレッジソースが必要な場合は、Memory Bank を使用します。Memory Bank は、エージェントから新しい情報を継続的に統合し、新しいデータが利用可能になると、保存されたメモリを改良して更新するように設計されています。これにより、エージェントが依存するコンテキストが常に最新かつ正確になります。RAG には静的な外部ナレッジベースがありますが、Memory Bank はエージェントから提供されたコンテキストに基づいて進化できます。
使用例
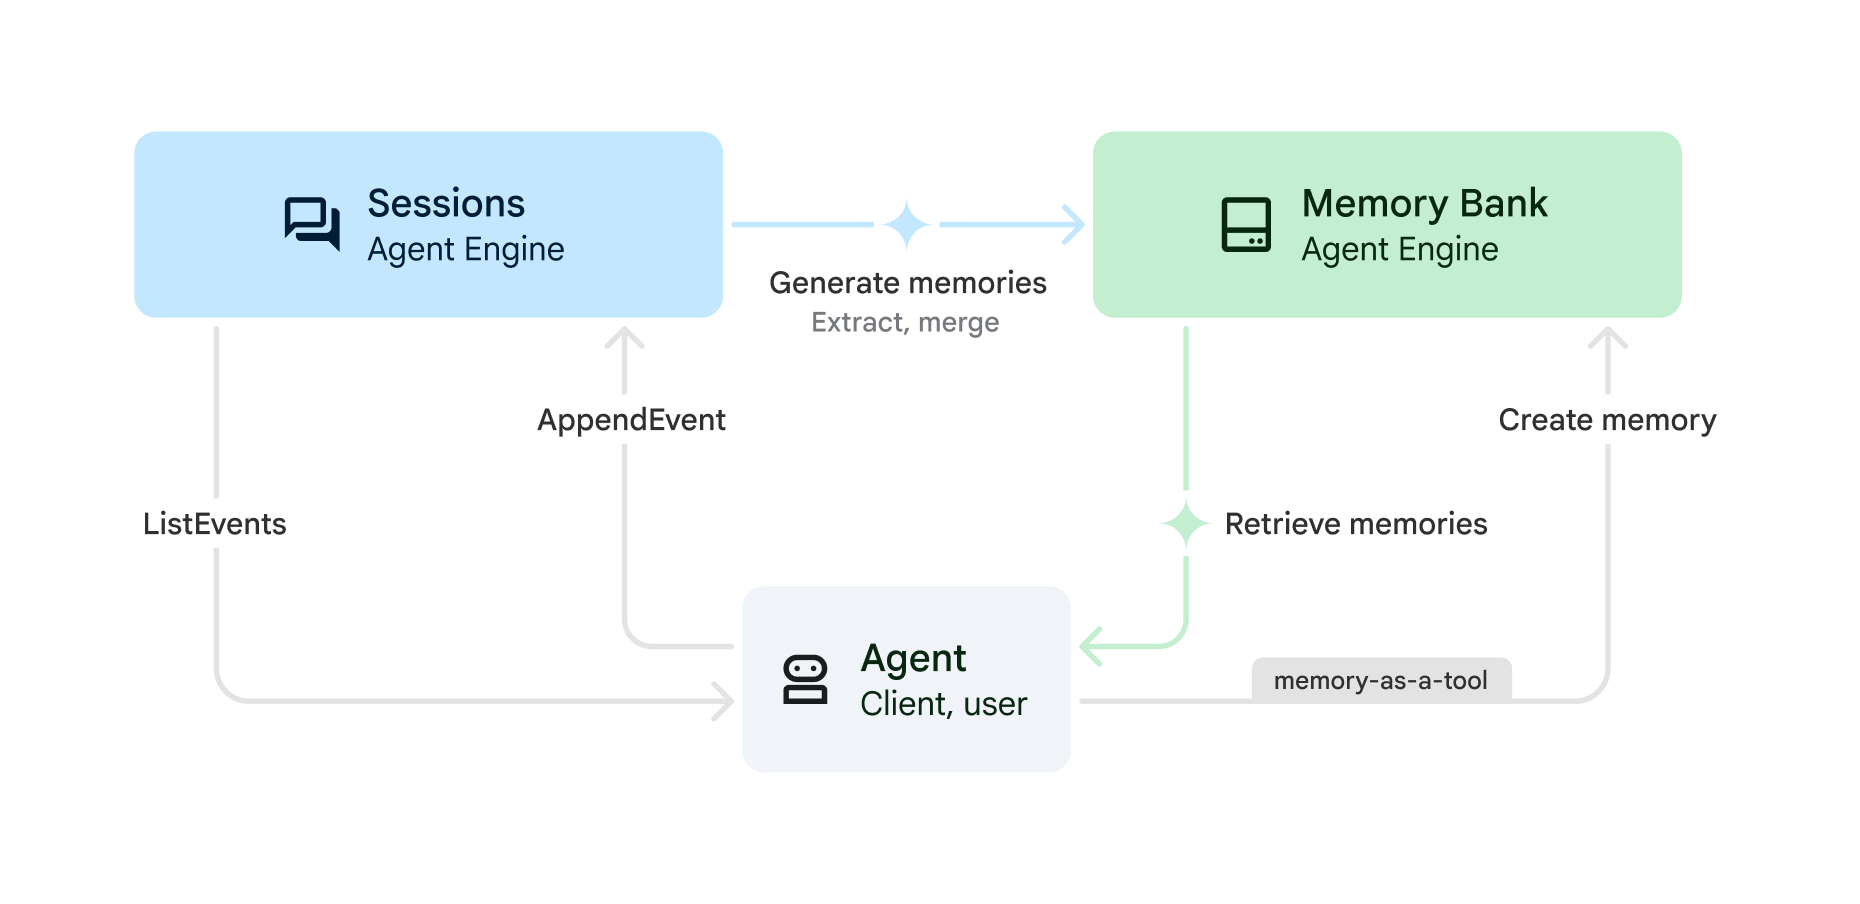
Memory Bank を Agent Platform Sessions とともに使用すると、次のプロセスで保存されたセッションから記憶を生成できます。
(セッション)
CreateSession: 会話の開始時に新しいセッションを作成します。エージェントが使用する会話履歴は、このセッションに限定されます。セッションには、ユーザーとエージェント間のやり取りのメッセージとアクション(SessionEvents)の時系列順のシーケンスが含まれます。すべてのセッションにユーザー ID が必要です。このセッションで抽出されたメモリ(GenerateMemoriesを参照)はこのユーザーにマッピングされます。(セッション)
AppendEvent: ユーザーがエージェントとやり取りすると、イベント(ユーザー メッセージ、エージェントの応答、ツール アクションなど)がセッションにアップロードされます。イベントは会話履歴を保持し、記憶の生成に使用できる会話の記録を作成します。(セッション)
ListEvents: ユーザーがエージェントとやり取りすると、エージェントは会話履歴を取得します。(メモリーバンク)記憶を生成または作成する:
GenerateMemories: エージェントは会話履歴を使用してメモリを生成するトリガーを、指定された間隔(セッションの終了時やターンの終了時など)で起動できます。ユーザーに関する事実が会話履歴から自動的に抽出され、現在または将来のセッションで使用できるようになります。CreateMemory: エージェントはメモリを Memory Bank に直接書き込むことができます。たとえば、エージェントはメモリを書き込むタイミングや保存する情報を決定できます(メモリをツールとして使用)。エージェントが抽出するファクトをより詳細に制御する場合は、CreateMemoryを使用します。
(Memory Bank)
RetrieveMemories: ユーザーがエージェントとやり取りすると、エージェントはそのユーザーについて保存された記憶を取得できます。すべての記憶を取得することも(単純な取得)、現在の会話に最も関連性の高い記憶のみを取得することもできます(類似性検索による取得)。その後、取得した思い出をプロンプトに挿入できます。
クイックスタート
次のクイックスタートを使用して Memory Bank を使ってみましょう。
REST API を使用したクイックスタート: REST API クイックスタートに沿って、セッションとメモリバンクに API 呼び出しを直接行います。
ADK を使用したクイックスタート: ADK エージェントに Sessions と Memory Bank への呼び出しをオーケストレートする場合は、ADK のクイックスタートに沿って操作します。
Memory Bank のガバナンス
このセクションでは、セキュリティ責任やデータ所在地など、Memory Bank を使用する際のデータ ガバナンスに関する考慮事項について説明します。
プロンプト インジェクションのセキュリティ リスク
Agent Platform の責任の共有で説明されているセキュリティ上の責任に加えて、長期記憶を使用する際にエージェントに影響を与える可能性のあるプロンプト インジェクションとメモリ ポイズニングのリスクを考慮してください。メモリ ポイズニングは、誤った情報がメモリバンクに保存されたときに発生します。エージェントは、その後のセッションでこの誤った情報や悪意のある情報に基づいて動作する可能性があります。
メモリ ポイズニングのリスクを軽減するには、次の手順を実施します。
Model Armor: Model Armor を使用して、Memory Bank に送信されるプロンプトやエージェントから送信されるプロンプトを検査します。
敵対的テスト: 攻撃をシミュレートして、プロンプト インジェクションの脆弱性について LLM アプリケーションを事前にテストします。これは一般に「レッドチーム」と呼ばれます。
サンドボックス実行: エージェントが外部システムや重要なシステムを実行または操作できる場合、これらのアクションは厳格なアクセス制御と人間によるレビューが行われるサンドボックス環境で実行する必要があります。
詳細については、Google のセキュア AI エージェントに対するアプローチをご覧ください。
データ所在地
一般データ保護規則(GDPR)やリージョンのデータ主権要件などの規制の枠組みに準拠するには、Memory Bank で生成および保存されるメモリが、厳格なデータ所在地と分離の境界に準拠していることを確認する必要があります。
Memory Bank は、インスタンス内の ID 間でスコープベースのデータ分離を提供しますが、ロールベース アクセス制御(RBAC)と Identity and Access Management ポリシーを適用して、リージョン境界を適用し、異なるリージョン インスタンス間のメモリ汚染を防ぐ必要があります。
リージョン インスタンスのデプロイとデータ所在地
Memory Bank インスタンスを作成するときに、リージョンまたはマルチリージョンのロケーション(欧州連合の場合は eu、米国の場合は us など)を選択して、保存データがその特定の地理的境界内に留まるようにします。
ML 処理のロケーションは、基盤となるモデルのリージョンでの可用性によって異なります。選択したモデルまたはロケーション(Gemini 3 モデルやアジアの単一リージョンなど)でリージョン エンドポイントを使用できない場合は、ML 処理にグローバル Gemini エンドポイントが使用されます。詳細については、データ所在地とマルチリージョン エンドポイントとグローバル エンドポイントをご覧ください。
境界を越えたメモリ汚染の防止
境界を越えたデータ汚染は、ある管轄区域(米国など)で動作する Agent Runtime、Agent Identity、サービス アカウント、またはアプリケーションが、別の管轄区域(EU など)にあるメモリバンク インスタンスにメモリを書き込んだり、メモリを取得したりするときに発生します。
境界を越えたデータ汚染を防ぎ、規制遵守を維持するには、次の IAM コントロールを構成します。
専用のリージョン エージェント ID またはサービス アカウント: 管轄区域ごとに個別のリージョン固有のエージェント ID またはサービス アカウントを作成します(米国のワークロードには
agent-us@PROJECT_ID.iam.gserviceaccount.com、EU のワークロードにはagent-eu@PROJECT_ID.iam.gserviceaccount.comなど)。リージョン エージェント ID とサービス アカウントに、同じ地理的管轄区域にある Memory Bank インスタンスの IAM ロールのみが付与されるようにします。これにより、リージョン ランタイムが国境を越えたインスタンスにアクセスすることを防止します。- 最小権限の特殊なロール: ワークロードに必要な特定の Memory Bank ロール(読み取り専用取得用の
roles/aiplatform.memoryViewer、書き込みと生成アクセス用のroles/aiplatform.memoryEditorなど)のみを、適切なリージョン リソースにバインドしてプリンシパルに付与します。使用可能なロールの詳細については、Specialized Memory Bank の IAM ロールをご覧ください。
- 最小権限の特殊なロール: ワークロードに必要な特定の Memory Bank ロール(読み取り専用取得用の
組織のポリシー:
gcp.resourceLocations組織のポリシー制約を使用して、組織、フォルダ、プロジェクト レベルでロケーション制限を適用します。これにより、Memory Bank リソースの作成と使用が、承認されたコンプライアンスに準拠したリージョンに制限され、不正なグローバル エンドポイントの使用が防止されます。
条件付きアクセス ポリシーの実装の詳細については、IAM 条件を使用して Agent Platform Memory Bank へのアクセスを制御するをご覧ください。