


Nesta página, fornecemos orientações de arquitetura e estratégias de emulação para migrar cargas de trabalho legadas de mainframe (como IBM z/OS ou IBM i) para o Google Cloud com o mínimo de modificações no código.
Se você é arquiteto de nuvem, engenheiro de mainframe ou especialista em infraestrutura, use as informações desta página para avaliar ambientes de execução de emulação, replataformar cargas de trabalho de mainframe para o Compute Engine, reduzir os custos de licenciamento de MIPS de mainframe e transmitir dados em lote para o BigQuery usando o Mainframe Connector.
Antes de ler esta página, é preciso entender o consumo de MIPS da carga de trabalho do mainframe, as dependências do aplicativo e os requisitos do ambiente de execução de emulação de destino.
Arquitetura de migração lift-and-shift de mainframe
Uma migração lift-and-shift de mainframe substitui o hardware físico do mainframe por uma infraestrutura virtual em nuvem, executando programas legados COBOL ou PL/I em um ambiente de execução de emulação no Compute Engine.
Além da emulação de computação, é possível usar o Mainframe Connector para descarregar cargas de trabalho de relatórios com uso intensivo de CPU e reduzir o consumo de MIPS do mainframe. O Mainframe Connector permite que você conclua as seguintes tarefas:
- Transcodifique conjuntos de dados EBCDIC (QSAM e VSAM) para os formatos ORC, JSON ou CSV.
- Mover dados para o Cloud Storage e o BigQuery.
- Envie jobs do BigQuery diretamente da linguagem de controle de jobs (JCL, na sigla em inglês).
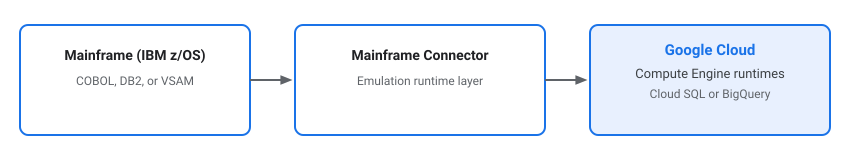
O diagrama a seguir ilustra a arquitetura de migração lift-and-shift do mainframe:
Principais componentes
Uma arquitetura de migração lift-and-shift de mainframe inclui os seguintes componentes:
- Ambientes de execução de emulação de computação: implante mecanismos de emulação de parceiros, como Micro Focus, NTT DATA ou LzLabs, no Compute Engine para executar binários COBOL ou CICS sem reescrever a lógica de negócios.
- Transcodificação de conjuntos de dados: transcodifique conjuntos de dados EBCDIC em formatos ORC, JSON ou CSV e faça a ingestão de arquivos em lote de mainframe de alto volume diretamente no BigQuery ou no Cloud Storage usando o conector de mainframe.
- Emulação de banco de dados: replataformar dados do DB2 ou IMS para bancos de dados relacionais de nuvem gerenciados, como o Cloud SQL ou o Spanner.
A seguir
- Documentação do Mainframe Connector
- Documentação da Mainframe Assessment Tool
- Documentação do Dual Run
- Documentação do Compute Engine