


Cette page fournit des conseils d'architecture et des stratégies d'émulation pour migrer des charges de travail d'anciens systèmes mainframe (tels qu'IBM z/OS ou IBM i) versGoogle Cloud avec un minimum de modifications de code.
Si vous êtes architecte cloud, ingénieur mainframe ou spécialiste des infrastructures, utilisez les informations de cette page pour évaluer les environnements d'exécution d'émulation, replatformer les charges de travail mainframe vers Compute Engine, réduire les coûts de licence MIPS mainframe et diffuser des données par lot vers BigQuery à l'aide de Mainframe Connector.
Avant de lire cette page, vous devez comprendre la consommation de MIPS de votre charge de travail de mainframe, les dépendances de l'application et les exigences d'exécution de l'émulation cible.
Architecture de migration Lift and Shift de mainframe
Une migration lift-and-shift de mainframe remplace le matériel physique du mainframe par une infrastructure virtuelle cloud, en exécutant des anciens programmes COBOL ou PL/I dans un environnement d'exécution d'émulation sur Compute Engine.
En plus de l'émulation de calcul, vous pouvez utiliser Mainframe Connector pour décharger les charges de travail de reporting gourmandes en ressources CPU et réduire la consommation de MIPS du mainframe. Mainframe Connector vous permet d'effectuer les tâches suivantes :
- Transcodez des ensembles de données EBCDIC (QSAM et VSAM) aux formats ORC, JSON ou CSV.
- Déplacez des données vers Cloud Storage et BigQuery.
- Envoyez des jobs BigQuery directement depuis le langage JCL (Job Control Language).
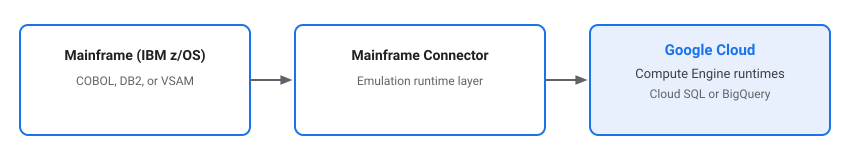
Le schéma suivant illustre l'architecture de migration lift-and-shift du mainframe :
Composants clés
Une architecture de migration lift-and-shift de mainframe comprend les composants suivants :
- Environnements d'exécution d'émulation Compute : déployez des moteurs d'émulation partenaires, tels que Micro Focus, NTT DATA ou LzLabs, sur Compute Engine pour exécuter des binaires COBOL ou CICS sans réécrire la logique métier.
- Transcodage d'ensembles de données : transcodez des ensembles de données EBCDIC aux formats ORC, JSON ou CSV, et ingérez des fichiers de mainframe volumineux directement dans BigQuery ou Cloud Storage à l'aide du connecteur de mainframe.
- Émulation de base de données : replatformez les données DB2 ou IMS vers des bases de données relationnelles cloud gérées telles que Cloud SQL ou Spanner.
Étapes suivantes
- Documentation Mainframe Connector
- Documentation de Mainframe Assessment Tool
- Documentation Dual Run
- Documentation Compute Engine